Alarmes et notifications CloudWatch

Supervision et dépannage sur AWS

John Q. Martin

Principal Consultant

Qu'est-ce qu'une alarme CloudWatch
 

Concepts clés

  • Surveille une métrique unique sur une période
  • Déclenche des actions quand la métrique dépasse un seuil


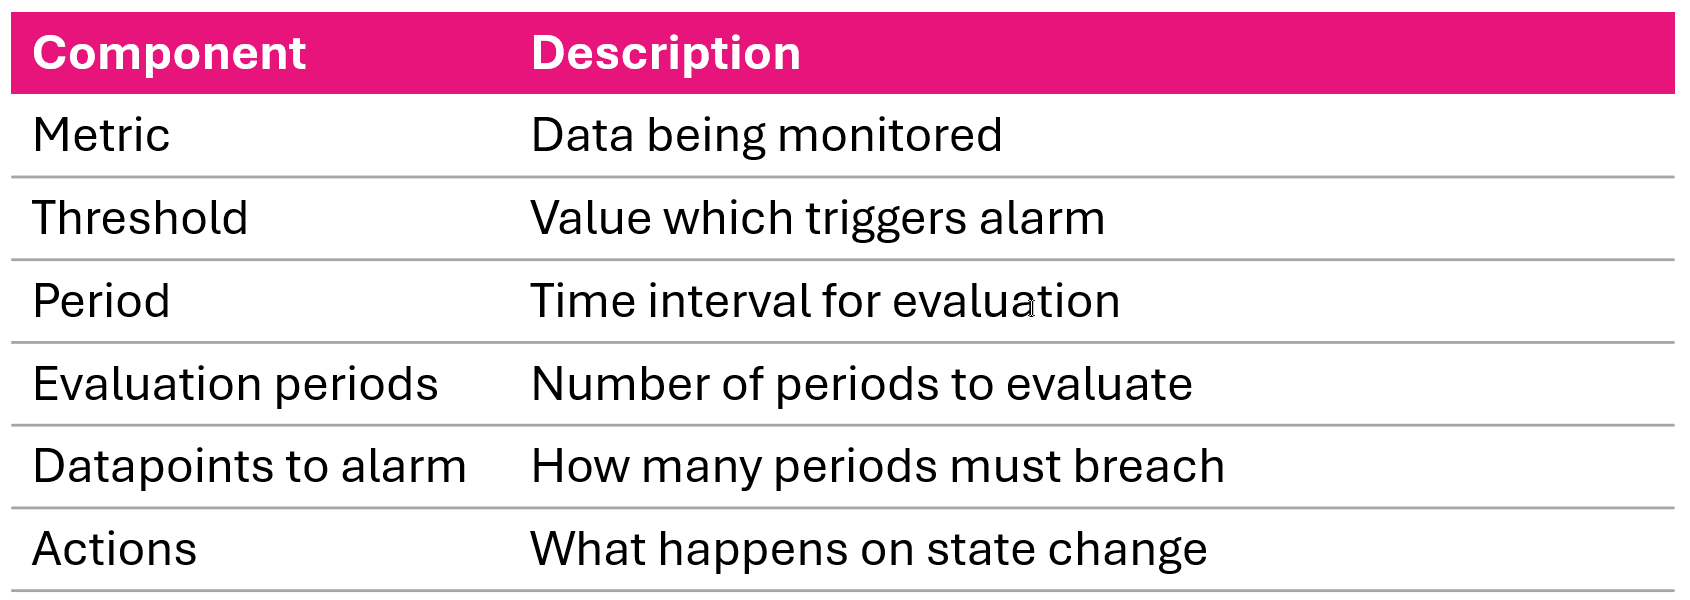
Six composants principaux d'une alarme CloudWatch : metric, threshold, period, evaluation periods, datapoints to alarm et actions

Supervision et dépannage sur AWS

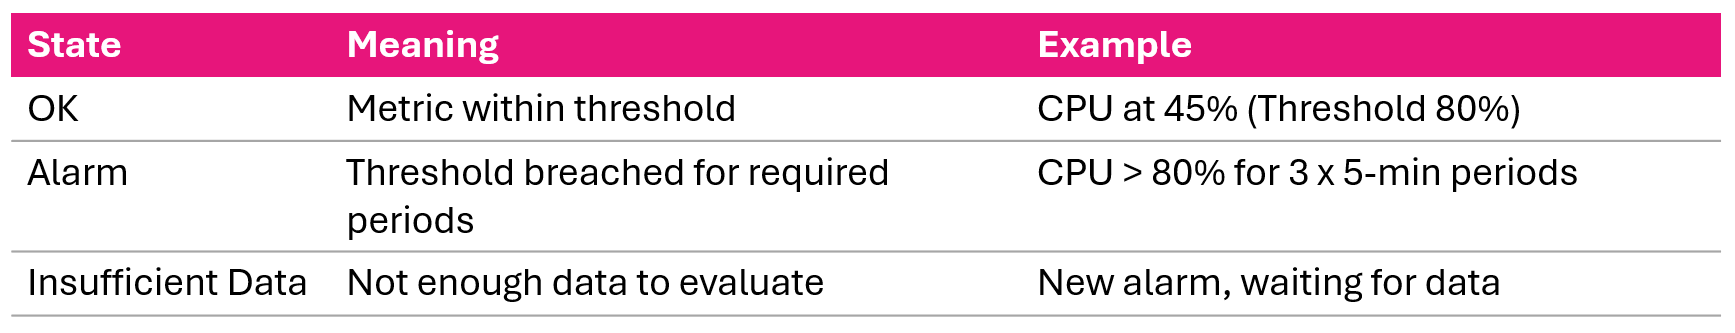
États d'alarme

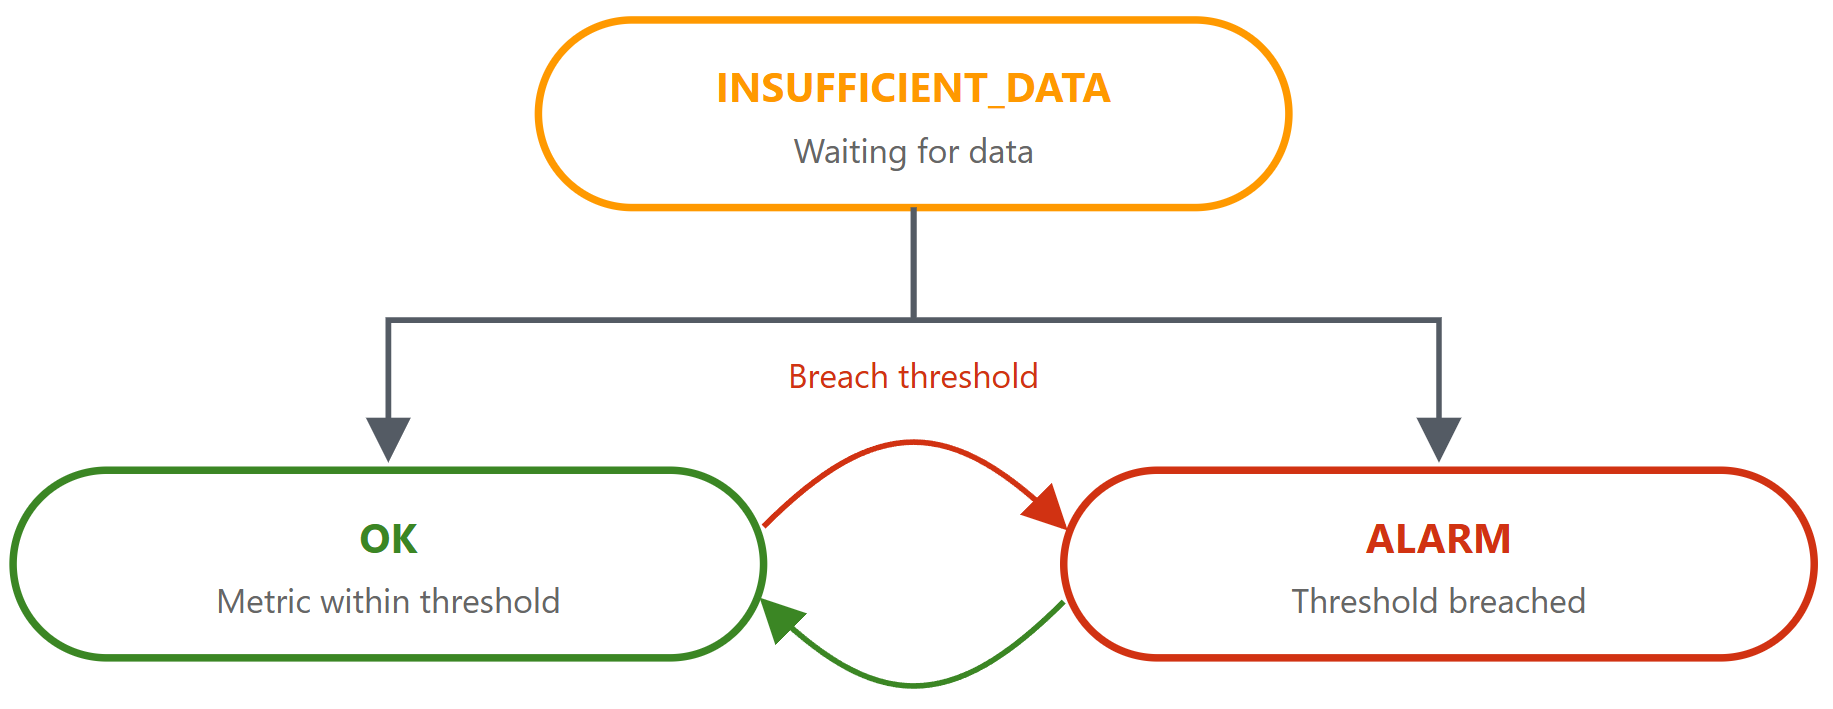
Les trois états d'une alarme CloudWatch : OK, ALARM et INSUFFICIENT_DATA

Diagramme : transitions d'état d'une alarme CloudWatch à l'arrivée des données de métrique

Supervision et dépannage sur AWS

Évaluation d'une alarme


  1. Collecte des points de données à intervalles définis
  2. Application d'une statistique (Average, Sum, Max, Min) sur la période
  3. Comparaison du résultat au seuil
  4. Comptage des périodes d'évaluation en dépassement
  5. Changement d'état si le seuil de datapoints-to-alarm est atteint


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Supervision et dépannage sur AWS

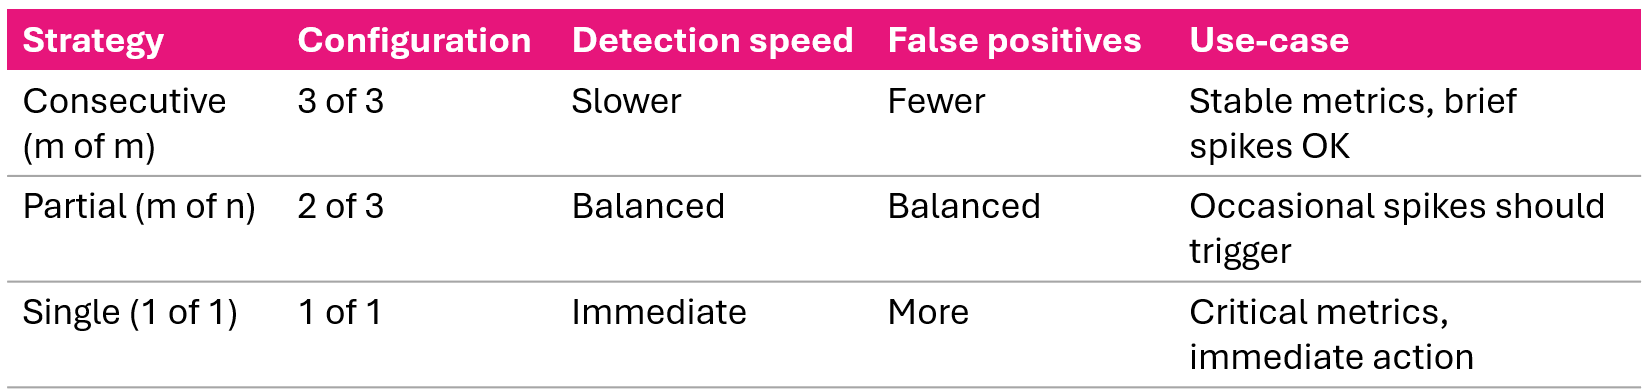
Stratégies d'évaluation


Trois stratégies d'évaluation : consécutive, partielle et simple dépassement, avec leurs sensibilités

Supervision et dépannage sur AWS

Types d'action et déclencheurs d'alarme


Déclencheurs d'action

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Types d'action

  • Notification SNS
  • Auto Scaling
  • Action EC2 (stop/terminate/reboot/recover)
  • Systems Manager
Supervision et dépannage sur AWS

Comportement en cas de données manquantes
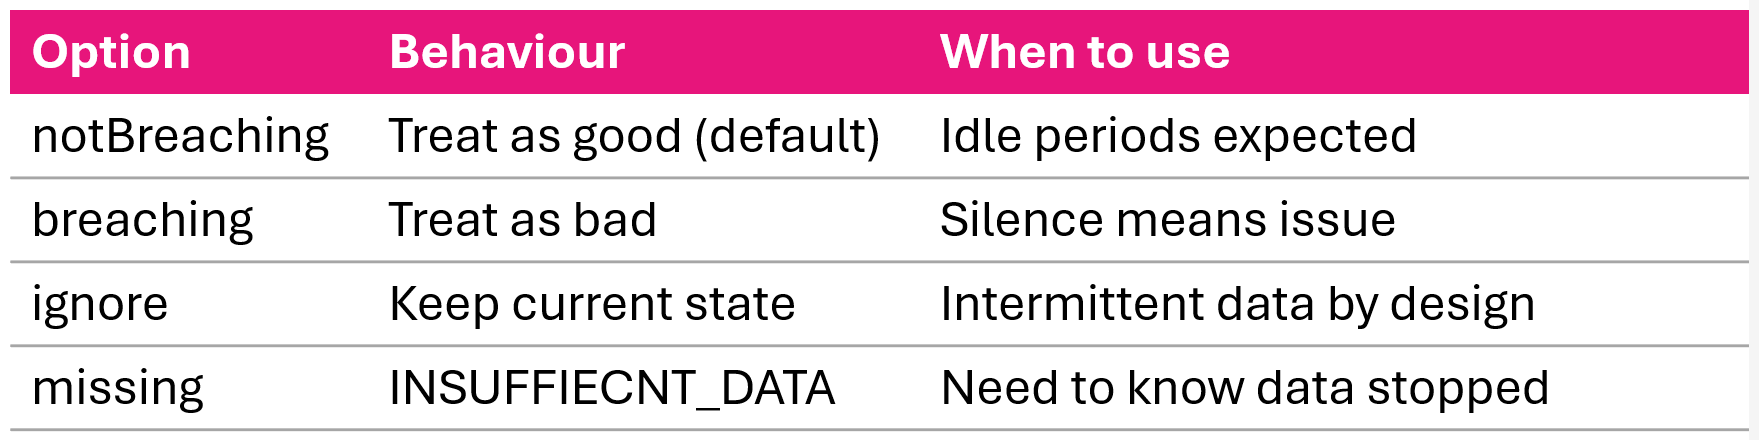
 

Options de comportement en cas de données manquantes : notBreaching, breaching, ignore et missing

Supervision et dépannage sur AWS

Créer une alarme standard : AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Supervision et dépannage sur AWS

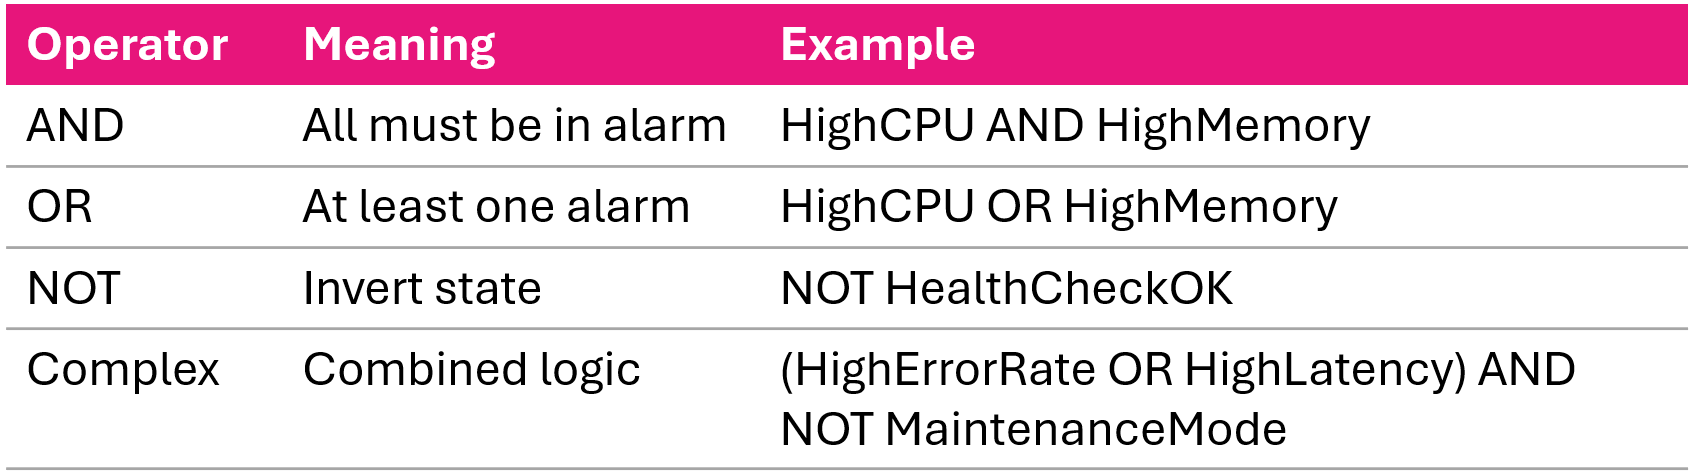
Alarmes composites : quoi et pourquoi
Problème

  • Plusieurs alarmes liées se déclenchent séparément = surcharge d'alertes

Solution

  • Combiner les alarmes avec des opérateurs logiques

Logique d'alarme composite combinant des alarmes enfants avec les opérateurs AND, OR et NOT

Supervision et dépannage sur AWS

Créer une alarme composite : AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Exemple de règle complexe
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Supervision et dépannage sur AWS

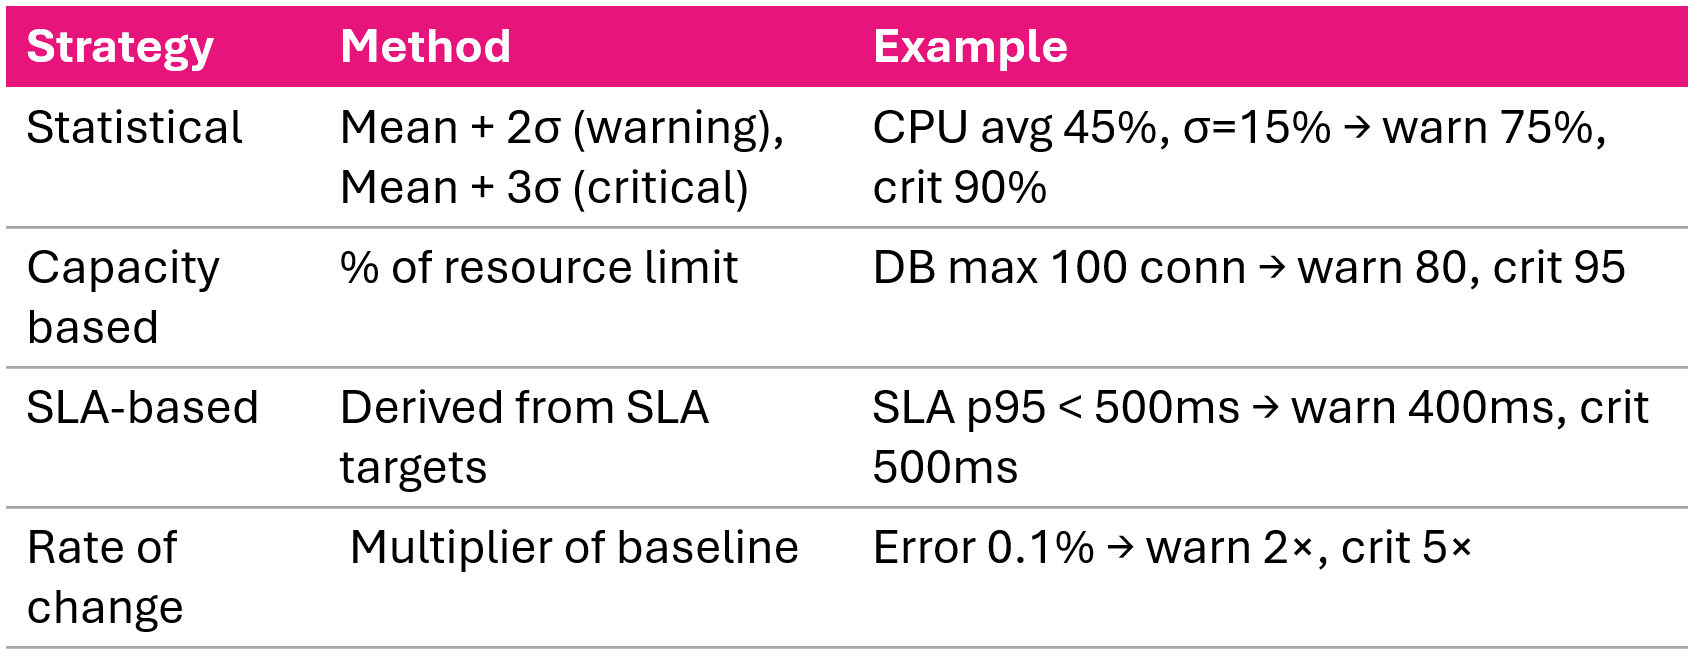
Stratégie de sélection des seuils

Quatre stratégies de choix de seuil : baseline, écart, limites de capacité, objectifs de SLA et taux de variation

Supervision et dépannage sur AWS

Stratégie d'alarme multi-niveaux


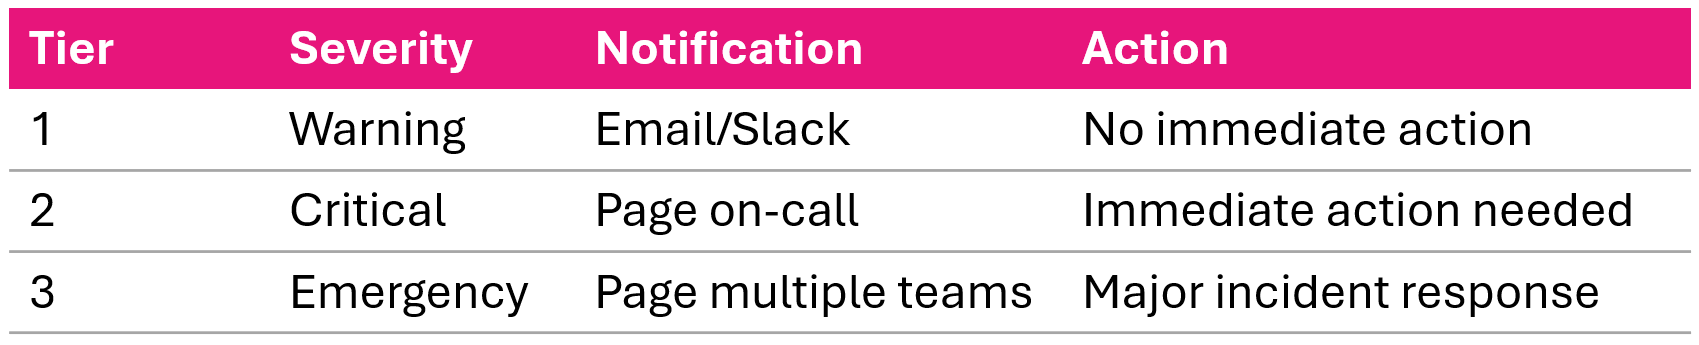
Réponse d'alarme multi-niveaux : avertissement, critique et urgence, routés vers des sujets SNS distincts

Exemple : avertissement CPU à 75 %, critique à 90 %, chacun avec des sujets SNS différents

Supervision et dépannage sur AWS

Alarmes de détection d'anomalies

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • Le modèle de Machine Learning apprend le comportement normal de la métrique
  • Crée une bande de seuil dynamique (paramétrable)
  • S'adapte aux rythmes quotidiens/hebdomadaires
  • Réduit le réglage manuel des seuils
Supervision et dépannage sur AWS

Alarmes par ressource : Lambda et ALB

Alarmes Lambda
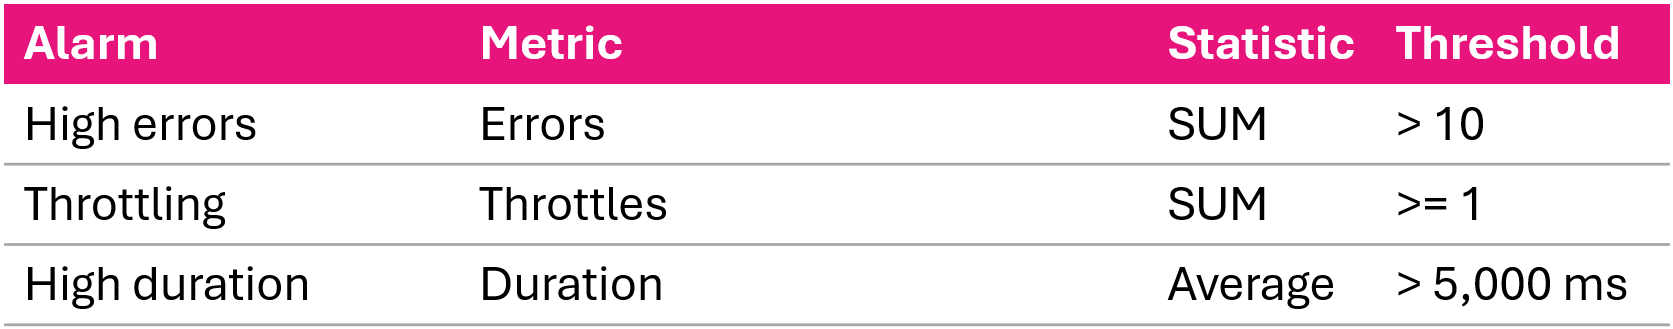
Alarmes Lambda recommandées : erreurs, throttles et durée élevée proche du délai d'expiration

Alarmes ALB

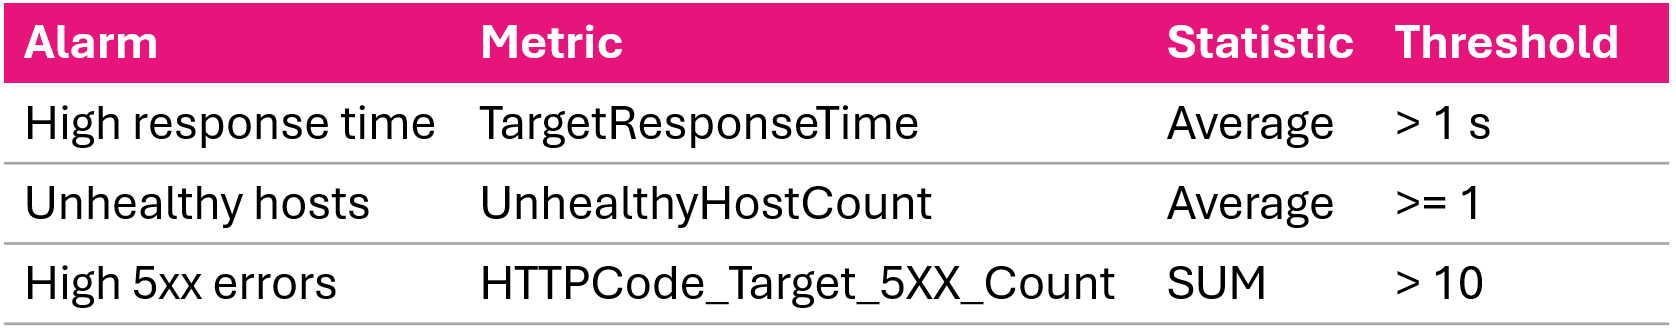
Alarmes ALB recommandées : temps de réponse des cibles, hôtes non sains et nombre d'erreurs 5xx

Supervision et dépannage sur AWS

Bonnes pratiques de gestion des alarmes

  • Nommage : <Service>-<Metric>-<Resource>-<Severity>
  • Descriptions : ce qui est surveillé, seuil, pistes de dépannage, liens de runbook
  • Tags : Environnement, Équipe, Sévérité
  • Revue mensuelle : ajuster les seuils, retirer l'obsolète, mettre à jour les actions
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Supervision et dépannage sur AWS

Résumé de la vidéo

  • Trois états d'alarme : OK, ALARM, INSUFFICIENT_DATA
  • Stratégies d'évaluation : consécutive, partielle, simple dépassement
  • Alarmes composites : combinaison avec AND, OR, NOT
  • Quatre stratégies de seuil : statistique, capacité, SLA, taux de variation
  • Alerte multi-niveaux : avertissement → critique → urgence
  • Alarmes par ressource pour Lambda (erreurs, throttles, durée) et ALB (5xx, latence)
Supervision et dépannage sur AWS

Passons à la pratique !

Supervision et dépannage sur AWS

Preparing Video For Download...