Dasbor kesehatan aplikasi

Pemantauan dan Pemecahan Masalah AWS

John Q. Martin

Principal Consultant

Desain dasbor: hierarki informasi
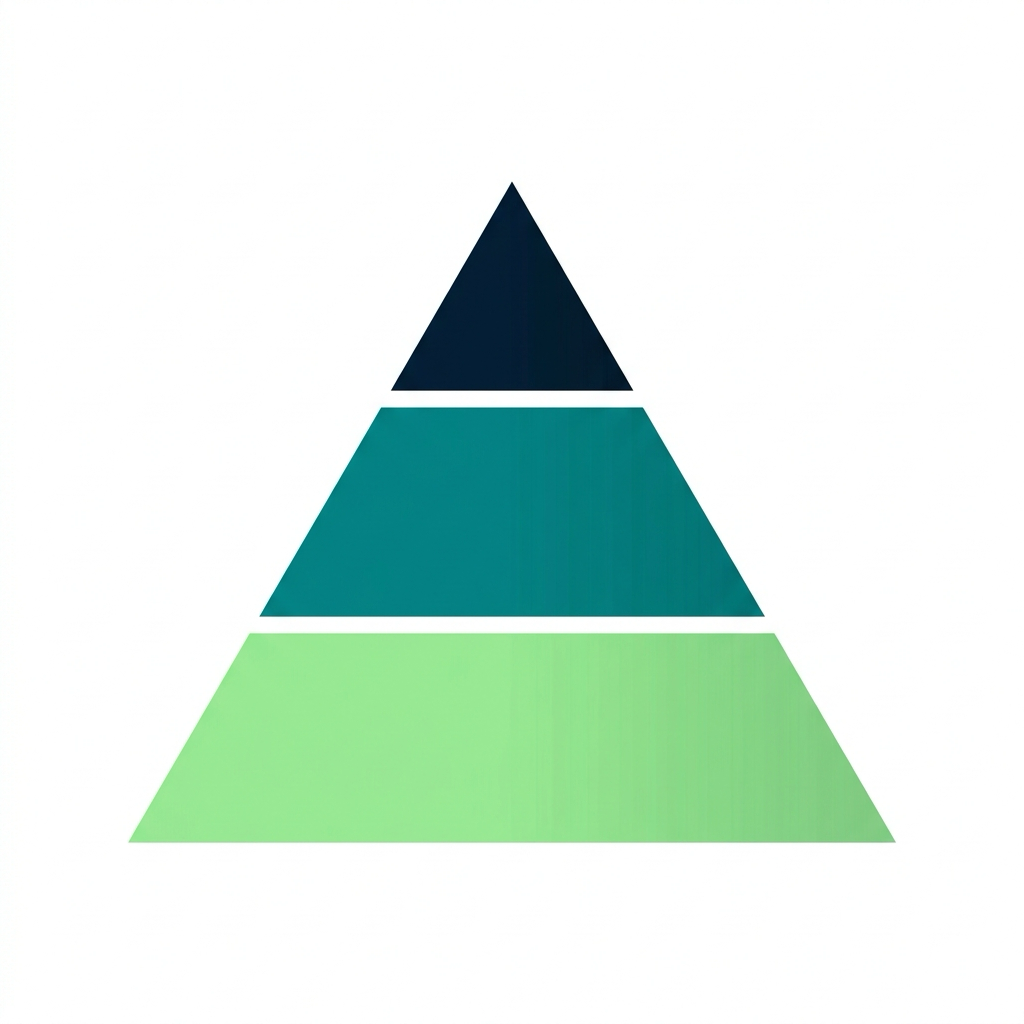
 

Piramida tiga tingkat: bagian atas gelap yang sempit, bagian tengah teal lebih lebar, dan bagian bawah hijau paling lebar

"Seperti rumah sakit: resepsionis → bangsal → konsultan"


Atas - Ringkasan Eksekutif

  • Kesehatan sistem keseluruhan
  • Metrik bisnis utama, SLA, insiden saat ini

Tengah - Kesehatan Layanan

  • Tingkat error, persentil latensi, throughput

Bawah - Diagnostik Terperinci

  • Trace, log, pemakaian sumber daya, kesehatan dependensi
Pemantauan dan Pemecahan Masalah AWS

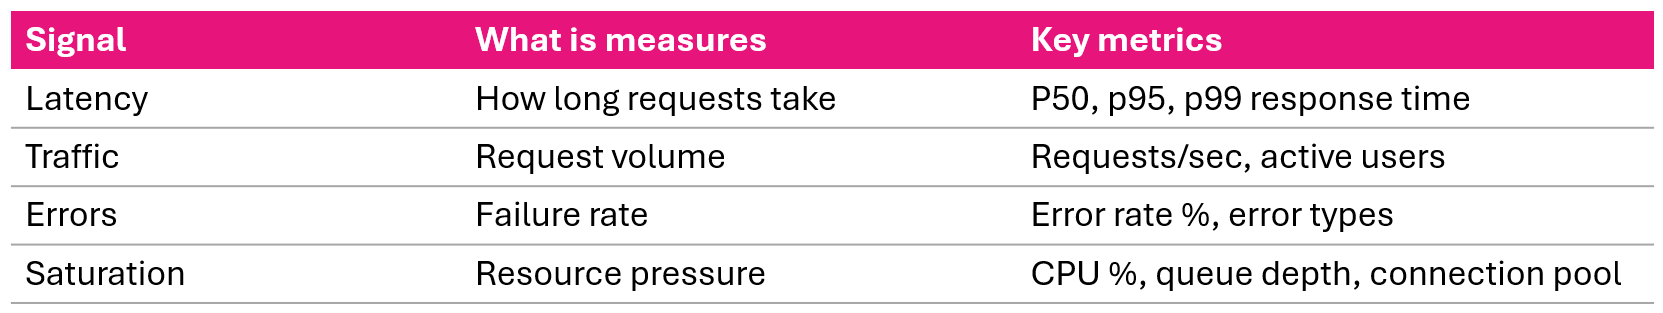
Empat sinyal emas


Empat sinyal emas untuk pemantauan: latensi, trafik, error, dan kejenuhan

Cakup keempat ini dan Anda mencakup mayoritas besar masalah yang akan Anda temui.

Pemantauan dan Pemecahan Masalah AWS

Metode RED


RED untuk layanan berbasis permintaan:
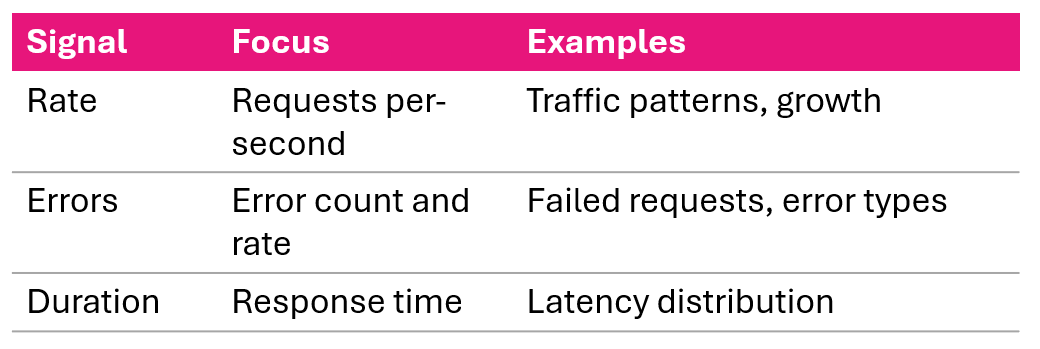
Pola metode RED menampilkan rate, errors, dan duration untuk layanan berbasis permintaan


Keterkaitan dengan sinyal emas:

  • RED adalah subset terfokus dari empat sinyal emas
  • Dirancang untuk layanan yang menangani permintaan pengguna
  • Saturation (sinyal emas ke-4) ditambahkan untuk pemantauan infrastruktur

Gunakan RED sebagai titik awal, tambah saturation untuk diagnostik lebih dalam.

Pemantauan dan Pemecahan Masalah AWS

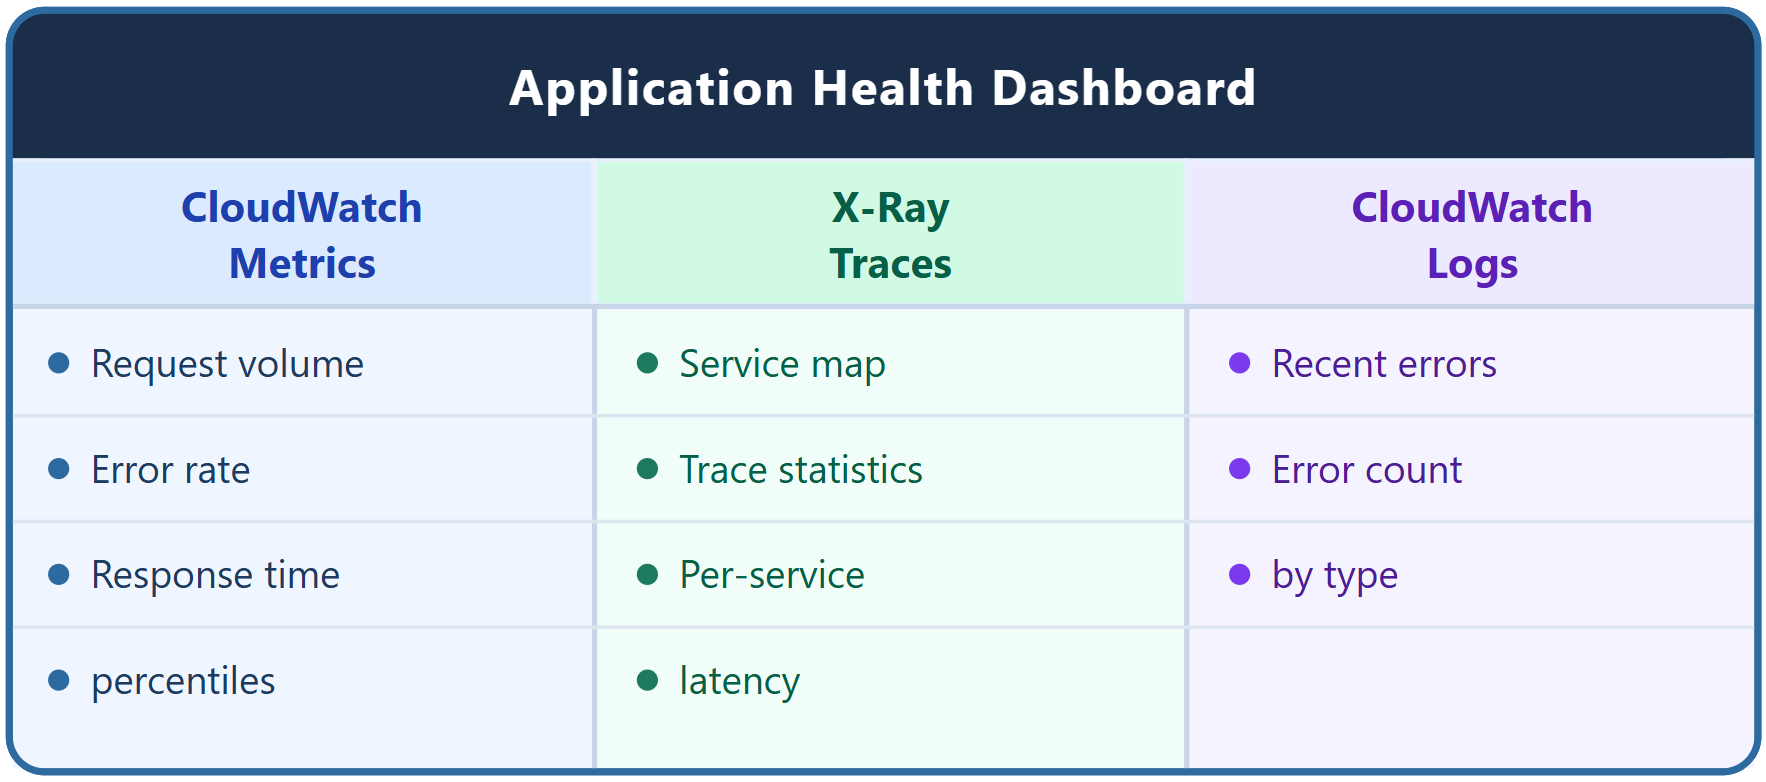
Tiga sumber data


Diagram tiga sumber data dasbor: metrik CloudWatch, trace X-Ray, dan CloudWatch Logs

Pemantauan dan Pemecahan Masalah AWS

Widget metrik CloudWatch

Volume permintaan:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

Tingkat error (metric math):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

Persentil waktu respons:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • Volume permintaan dari ALB RequestCount
  • Tingkat error memakai metric math - errors / invocations x 100
  • Waktu respons sebagai persentil p50, p95, p99
Pemantauan dan Pemecahan Masalah AWS

Widget X-Ray dan log


Widget X-Ray:

  • Service map - topologi aplikasi dengan indikator kesehatan
  • Trace statistics - waktu respons rata-rata, tingkat error, tingkat fault
  • Service latency - perbandingan waktu respons per layanan


Widget CloudWatch Logs:

Kueri error terbaru:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

Jumlah error per tipe:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
Pemantauan dan Pemecahan Masalah AWS

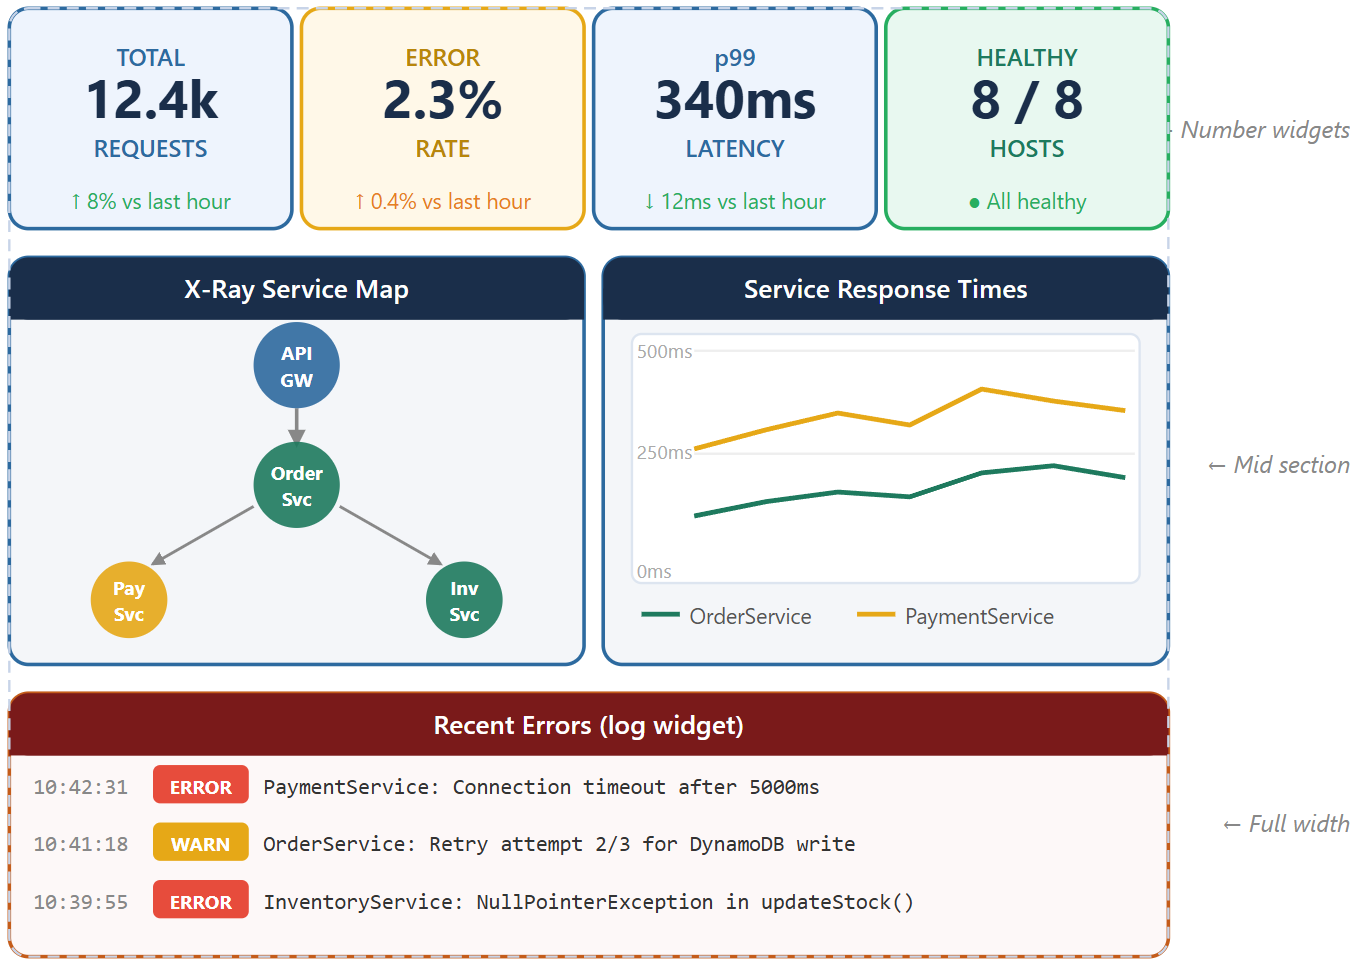
Tata letak dasbor lengkap


Tata letak dasbor kesehatan dengan widget ringkasan di atas, peta layanan di tengah, dan log error di bawah

Pemantauan dan Pemecahan Masalah AWS

Alur kerja penanganan insiden


Papan triase ruang gawat darurat dengan pita prioritas berwarna dan stetoskop

"Seperti triase UGD: stabilkan → diagnosis → terapi → verifikasi"

  1. Identifikasi - indikator merah/kuning, lonjakan error
  2. Tentukan lingkup - layanan mana? kapan? memburuk?
  3. Korelasikan - error + latensi, trafik + sumber daya
  4. Telusuri - peta layanan → trace → log
  5. Akar masalah - dependensi, DB, memori, konfigurasi
  6. Perbaiki - circuit breaker, skala, rollback, failover
  7. Verifikasi - tingkat error normal, peta hijau, alarm bersih
Pemantauan dan Pemecahan Masalah AWS

Skenario 1: lonjakan trafik mendadak

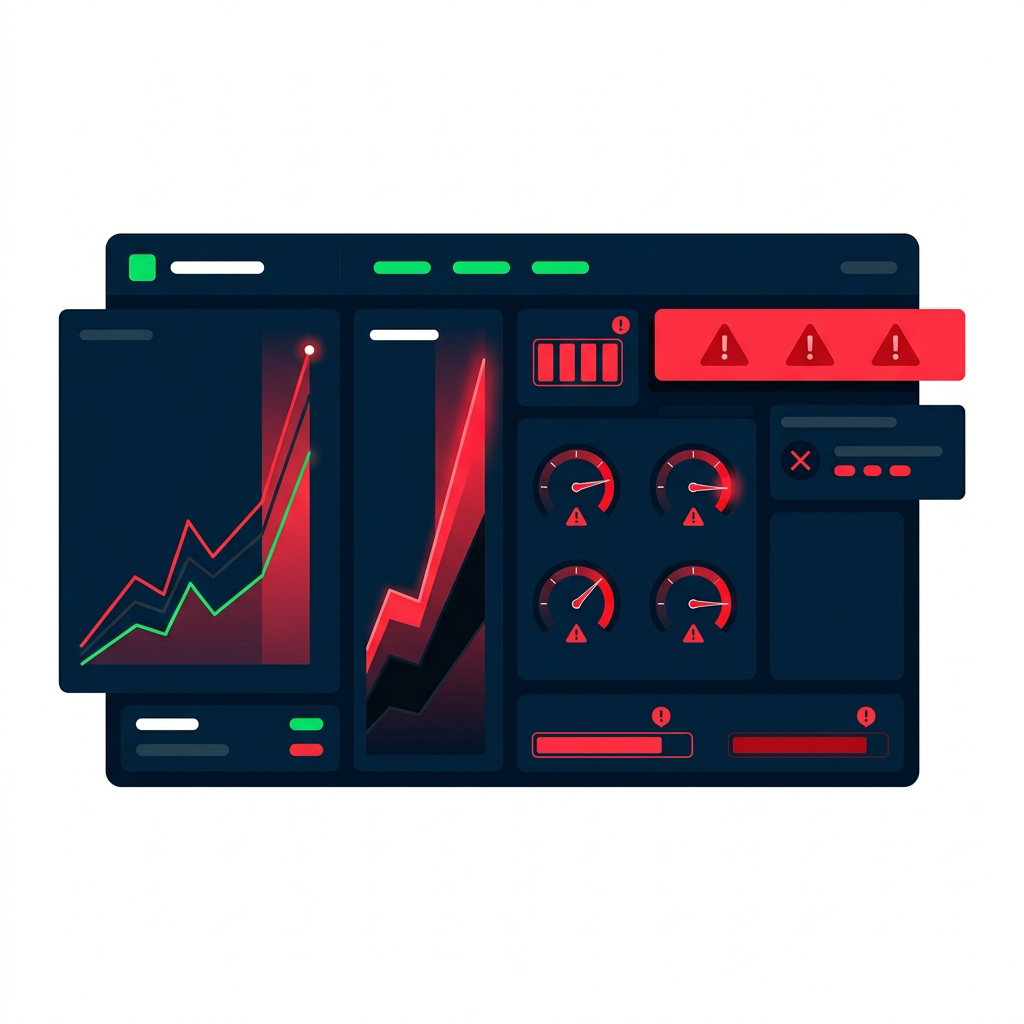
Dasbor pemantauan saat lonjakan trafik: grafik garis melonjak naik, pengukur mentok di zona merah, banner peringatan merah

Yang Anda lihat di dasbor:

  • Volume permintaan 10× normal
  • Tingkat error 25%
  • Latensi 3000ms
  • CPU 95%

Analisis: Sumber daya kewalahan oleh lonjakan trafik


Aksi:

  • Segera scale out
  • Aktifkan auto-scaling
  • Terapkan rate limiting
  • Tambahkan caching untuk mengurangi beban backend
Pemantauan dan Pemecahan Masalah AWS

Skenario 2: bottleneck database

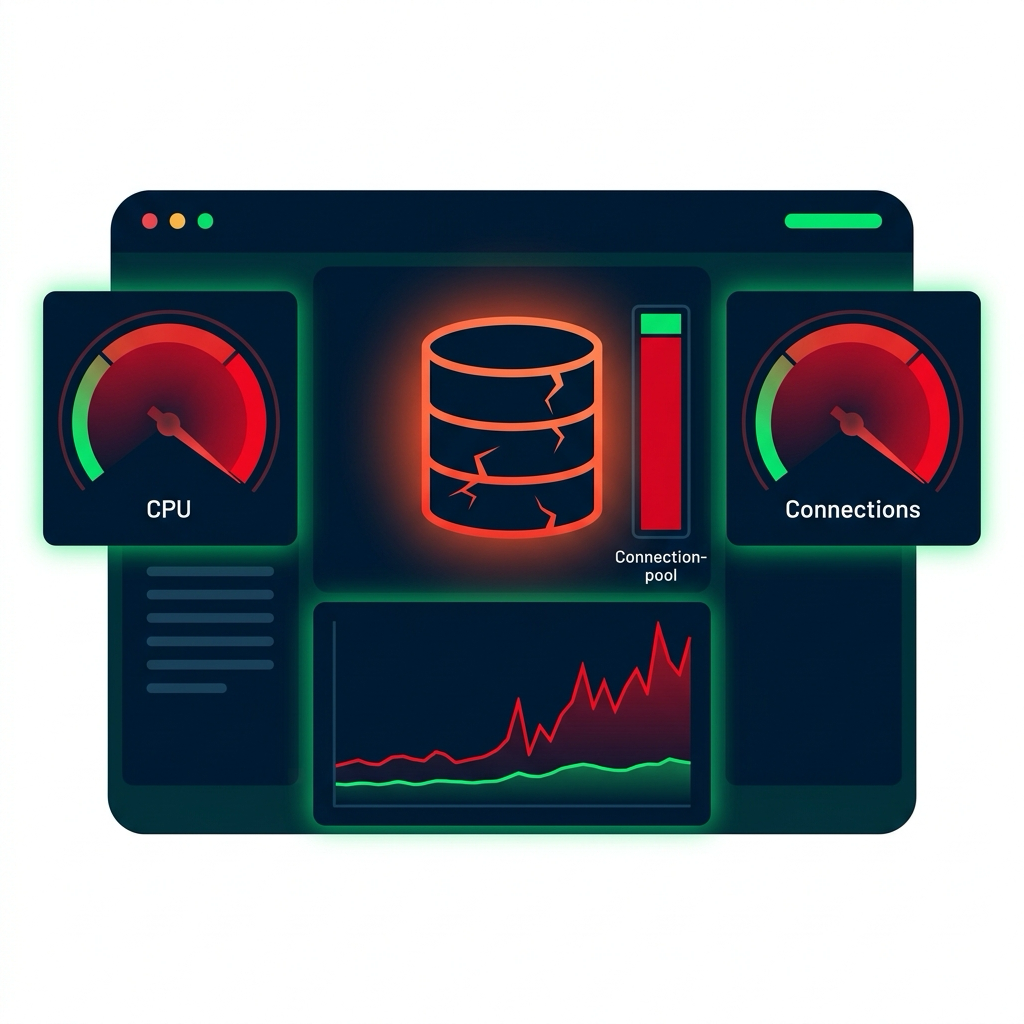
Dasbor pemantauan menampilkan bottleneck database: ikon database merah retak, pengukur CPU dan koneksi maksimum merah, grafik latensi kueri menanjak tajam, bilah connection pool hampir penuh

Yang Anda lihat di dasbor:

  • CPU DB 95%
  • Koneksi DB 95/100
  • Latensi kueri 5000ms
  • Latensi aplikasi 5500ms

Analisis: Database menjadi bottleneck, kueri lambat menguras connection pool


Aksi:

  • Identifikasi kueri lambat di log
  • Tambah indeks, optimalkan kueri
  • Perbesar ukuran connection pool
  • Skala database
Pemantauan dan Pemecahan Masalah AWS

Skenario 3: kegagalan berantai


Yang Anda lihat di service map:
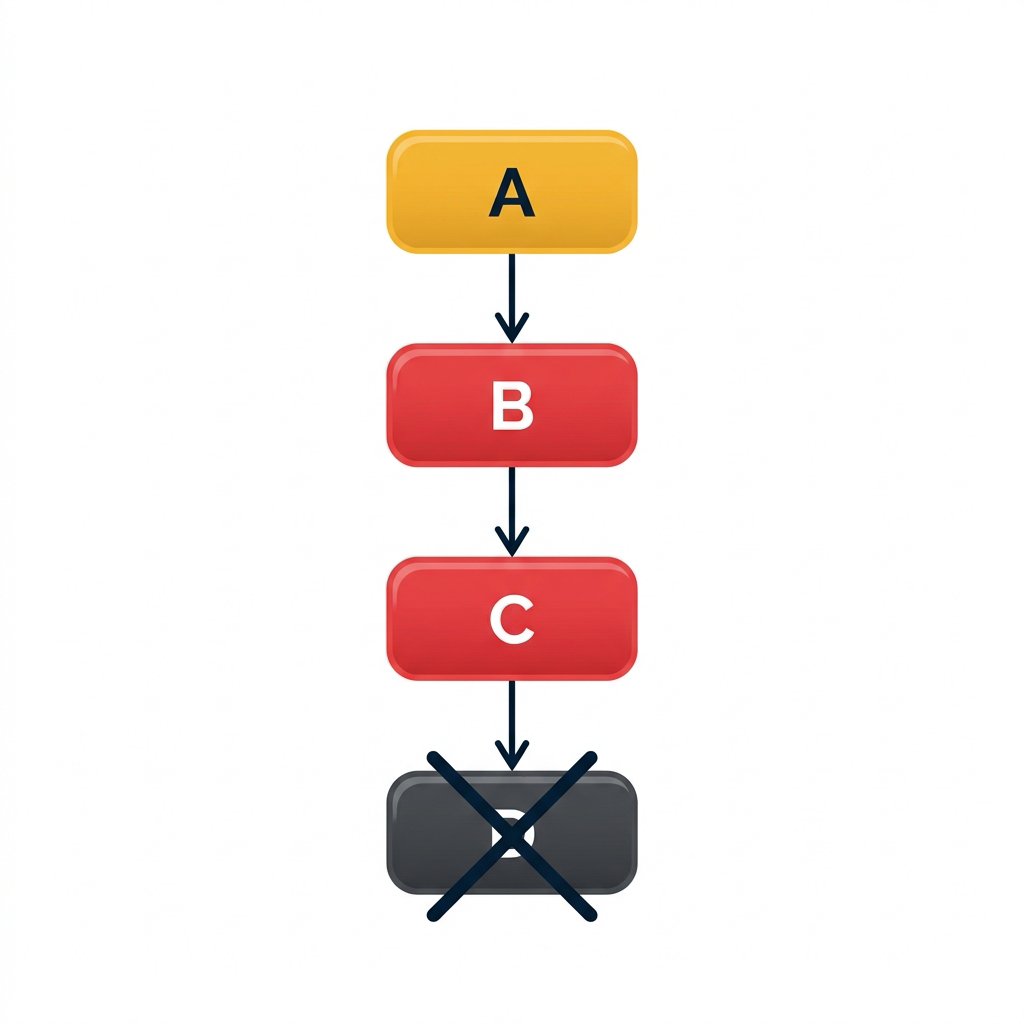
Rangkaian service map: node A kuning dengan error klien, B dan C merah dengan fault server, D gelap dan sepenuhnya down, panah mengalir menurun di rantai


Analisis:

Masalah kecil di Layanan A menjalar melalui rantai dependensi

Aksi:

  • Circuit breaker untuk menghentikan penjalaran
  • Timeout di setiap tingkat layanan
  • Mekanisme fallback untuk dependensi yang gagal
  • Perbaiki akar masalah di Layanan A
Pemantauan dan Pemecahan Masalah AWS

Praktik terbaik dasbor


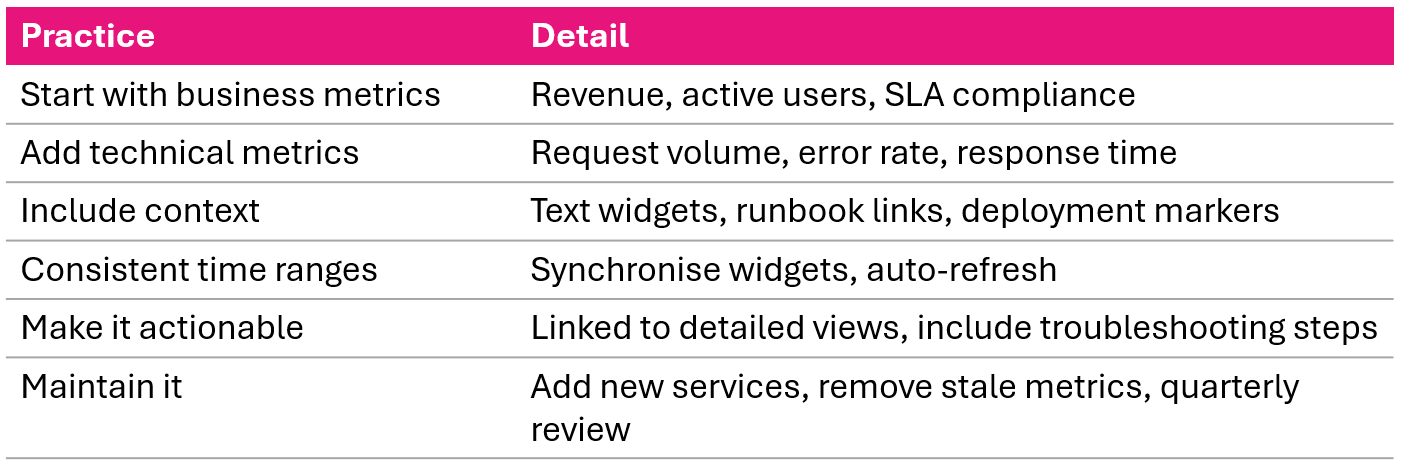
Enam praktik terbaik dasbor yang direkomendasikan untuk pemantauan kesehatan aplikasi

Pemantauan dan Pemecahan Masalah AWS

Ringkasan video dan penyelesaian kursus

  • Rancang dengan hierarki informasi dan empat sinyal emas
  • Gabungkan metrik CloudWatch, trace X-Ray, dan log dalam satu tampilan
  • Alur insiden 7 langkah: identifikasi → lingkup → korelasikan → telusuri → akar masalah → perbaiki → verifikasi

Kini Anda dapat:

  • Memantau dengan metrik, log, dan dasbor CloudWatch
  • Mengonfigurasi alarm dan notifikasi dengan SNS dan SQS
  • Menerapkan distributed tracing dengan X-Ray
  • Membangun dasbor kesehatan aplikasi untuk keunggulan operasional
Pemantauan dan Pemecahan Masalah AWS

Dasbor kesehatan aplikasi

Pemantauan dan Pemecahan Masalah AWS

Preparing Video For Download...