Paneles de salud de aplicaciones
Supervisión y resolución de problemas en AWS

John Q. Martin
Principal Consultant
Diseño de panel: jerarquía de información
Como un hospital: admisión → planta → especialista
Las cuatro señales doradas
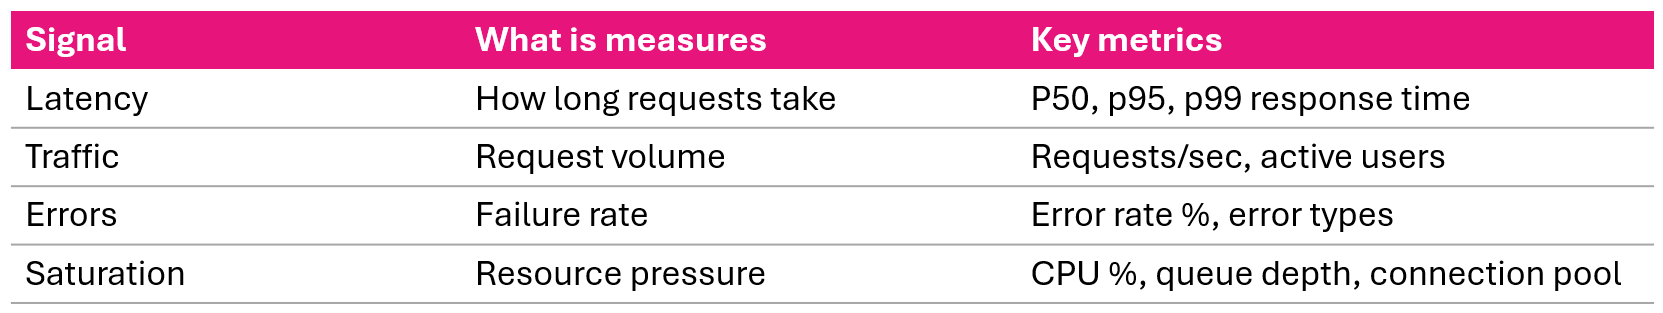
Si cubres estas cuatro, cubrirás la gran mayoría de problemas que te encontrarás.
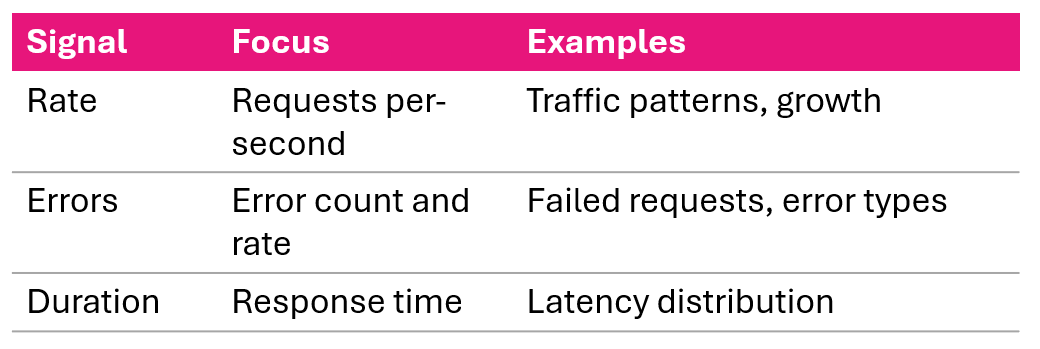
El método RED
RED para servicios orientados a solicitudes:
Tres orígenes de datos
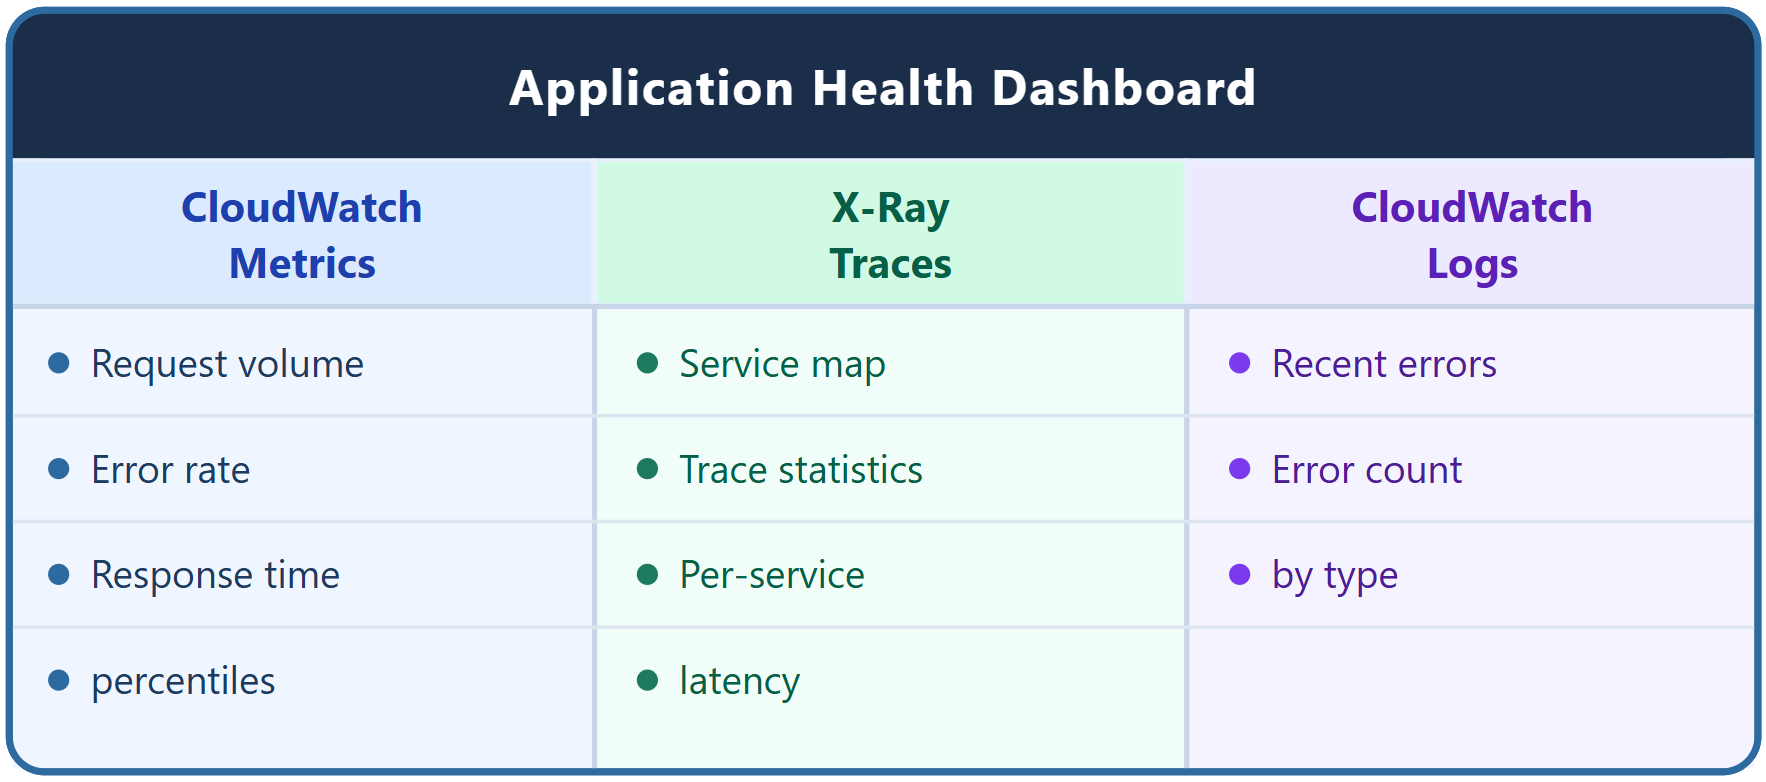
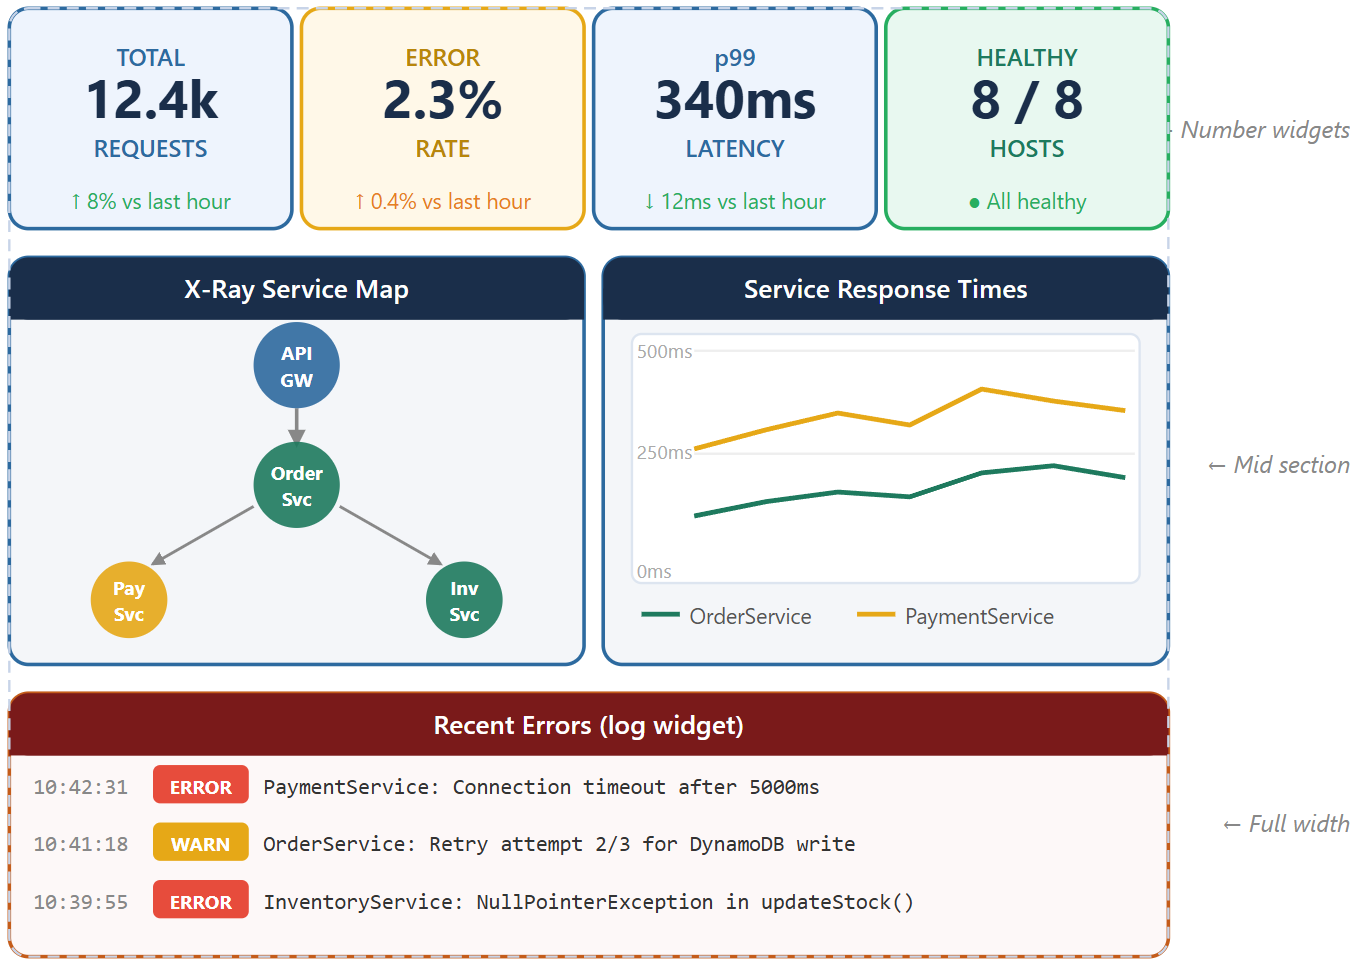
Diseño completo del panel
Flujo para resolver incidencias
Como el triaje de urgencias: estabilizar → diagnosticar → tratar → verificar
Escenario 1: pico de tráfico repentino
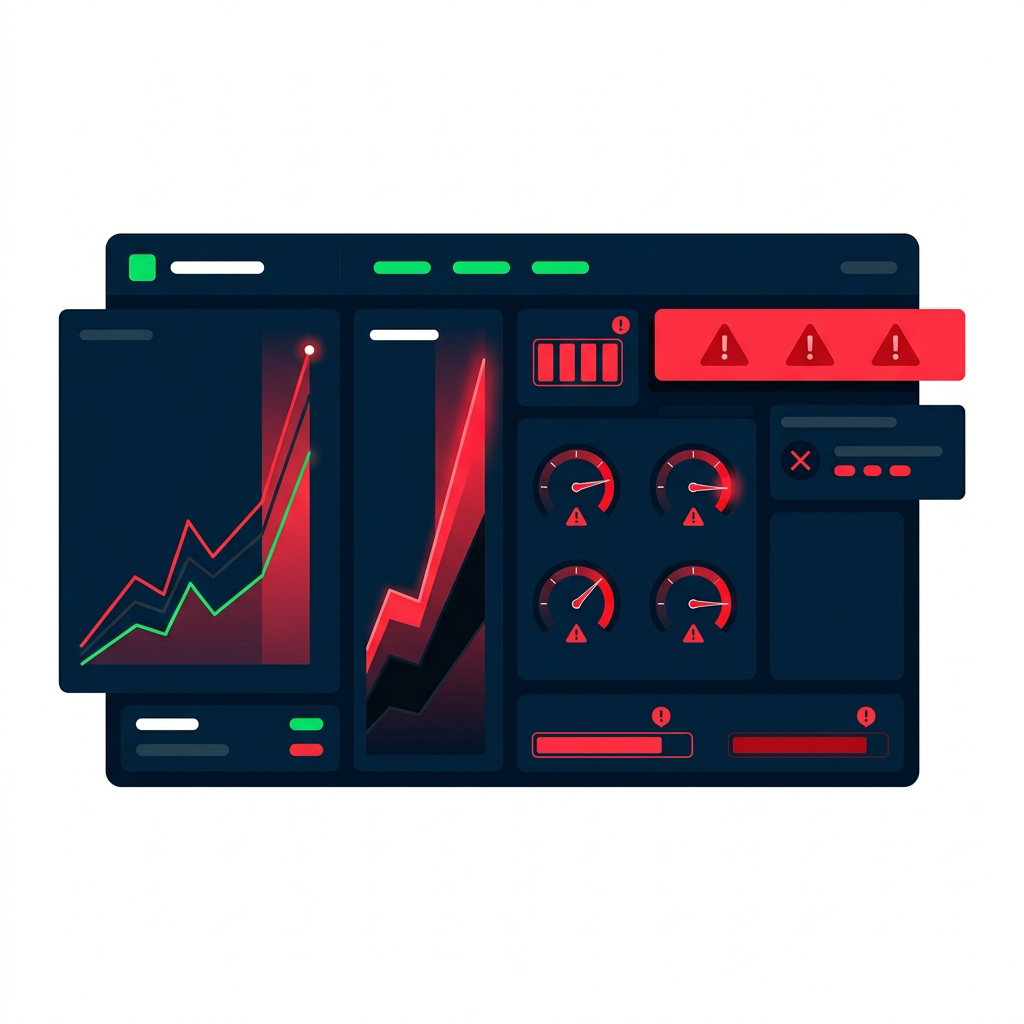
Lo que ves en el panel:
- Volumen de solicitudes 10× lo normal
- Tasa de error 25 %
- Latencia 3000 ms
- CPU 95 %
Análisis: Recursos saturados por un pico de tráfico
Escenario 2: cuello de botella en la base de datos
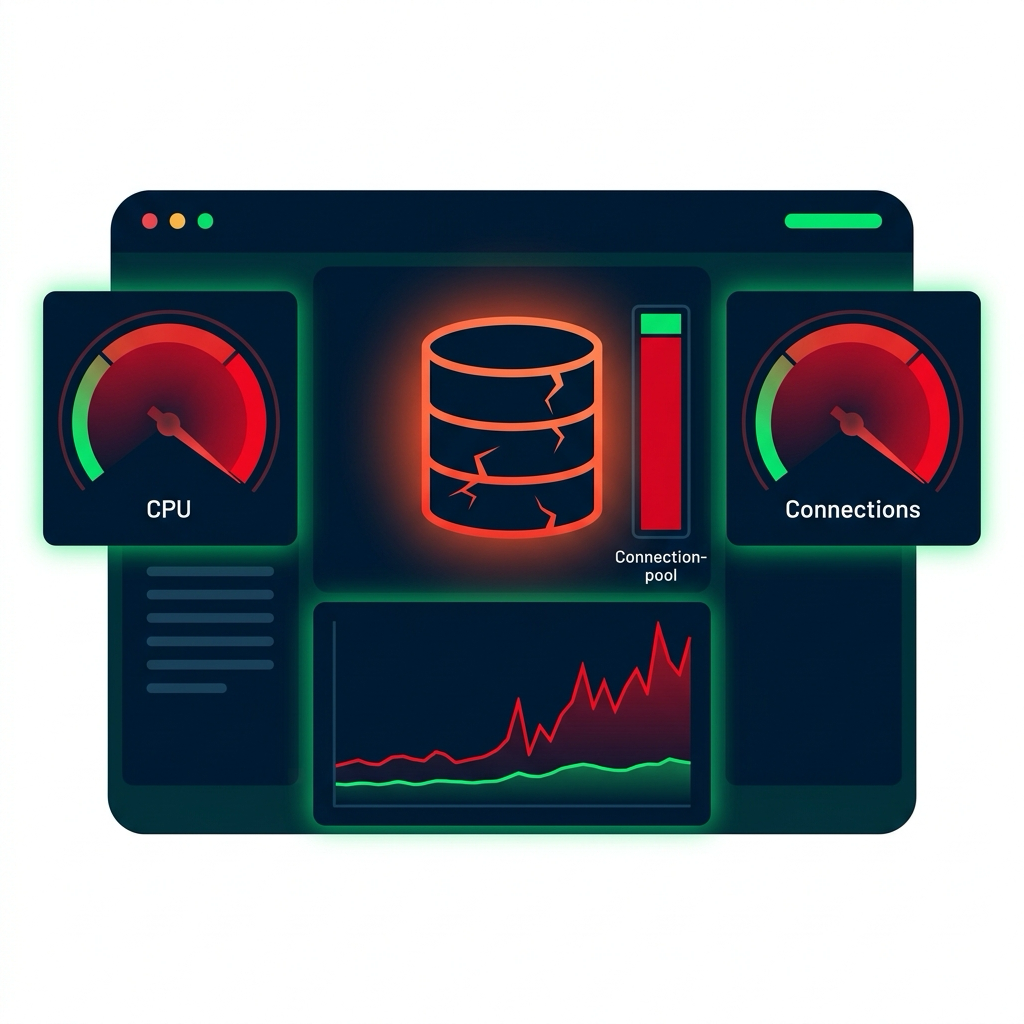
Lo que ves en el panel:
- CPU de BD 95 %
- Conexiones de BD 95/100
- Latencia de consultas 5000 ms
- Latencia de la app 5500 ms
Análisis: La base de datos es el cuello de botella; consultas lentas agotan el pool de conexiones
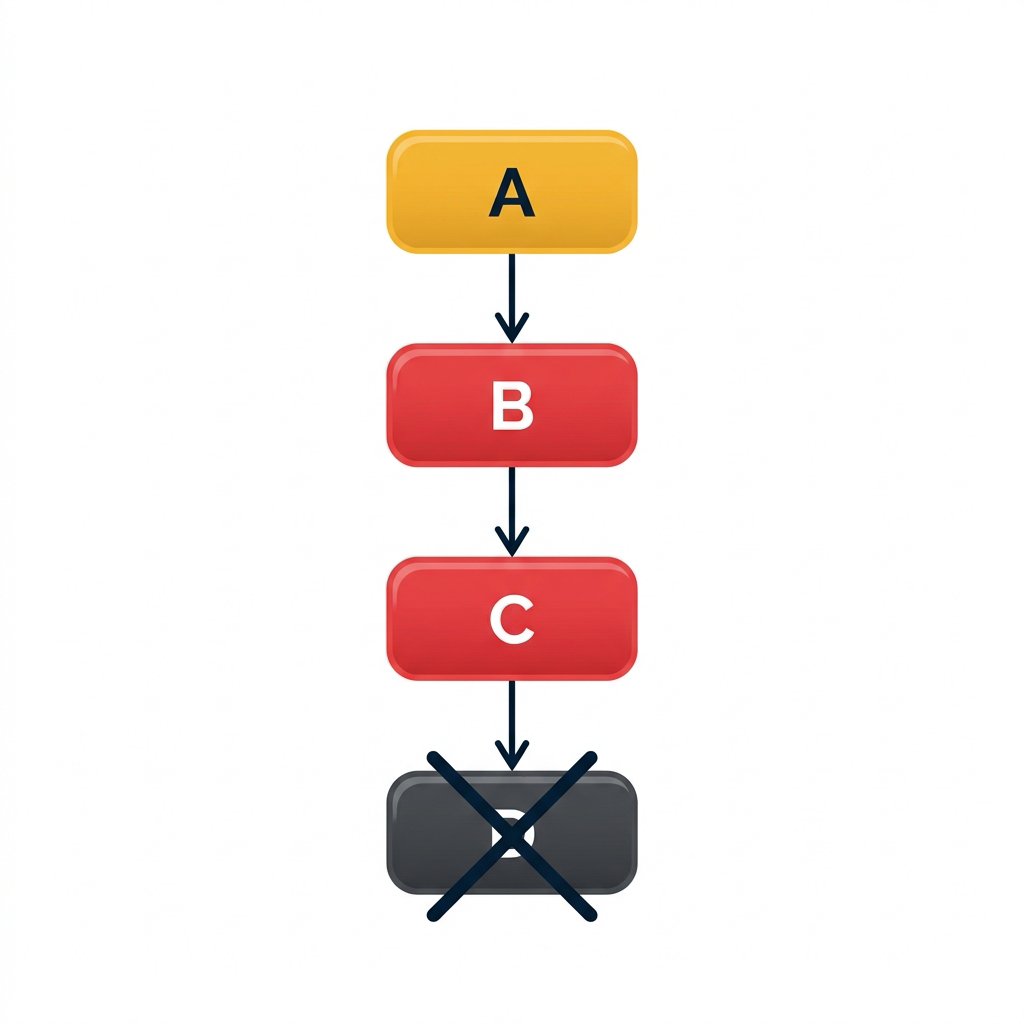
Escenario 3: fallo en cascada
Lo que ves en el mapa de servicios:
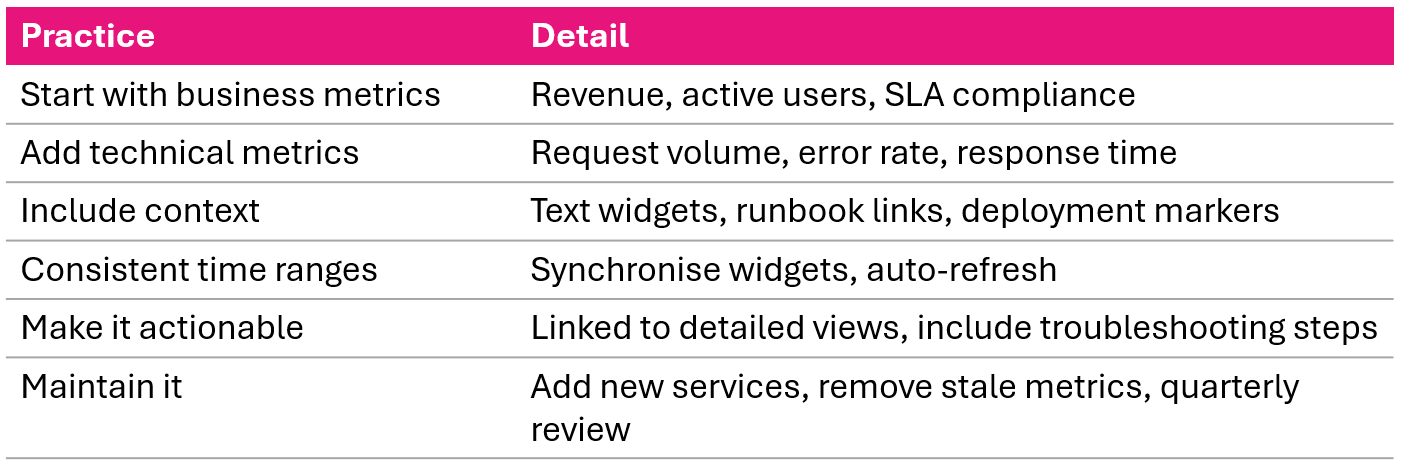
Buenas prácticas de paneles