Análisis de trazas y mapas de servicios

Supervisión y resolución de problemas en AWS

John Q. Martin

Principal Consultant

¿Qué es un mapa de servicios?


Generado automáticamente a partir de tus trazas: sin configuración manual
Panel de salidas de tren con filas de servicios, cada una con una luz de estado de color: verde puntual, ámbar con retraso, rojo detenido

De un vistazo: verde = puntual · ámbar = con retraso · rojo = detenido


Acceso:

  • Consola X-Ray → Service map
  • Aplica filtros
  • Haz clic en un nodo → desglose detallado
Supervisión y resolución de problemas en AWS

Codificación por colores del mapa de servicios
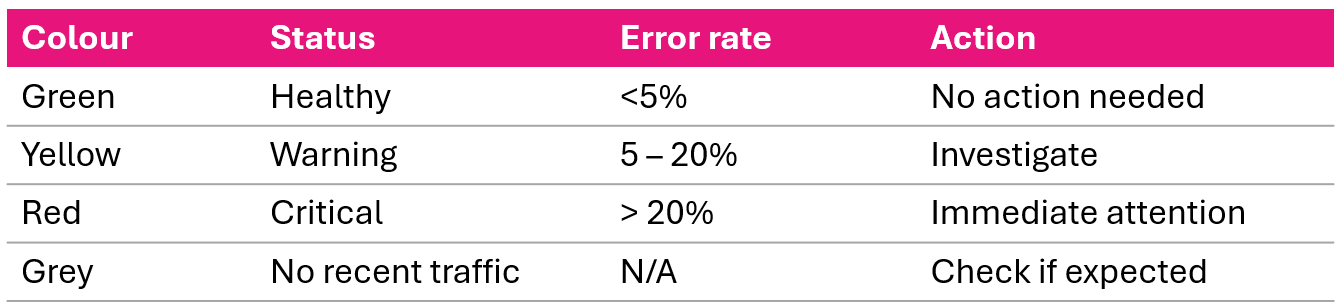
 

Leyenda de colores del mapa de servicios: verde llamadas correctas, amarillo errores de cliente, rojo fallos del servidor, morado limitación de velocidad, gris sin tráfico

Al abrir un mapa de servicios, ve directo a lo que no esté en verde.

Haz clic en cualquier nodo para ver: distribución de tiempos de respuesta, desglose de estados HTTP, tipos de error.

Supervisión y resolución de problemas en AWS

Cómo leer un mapa de servicios


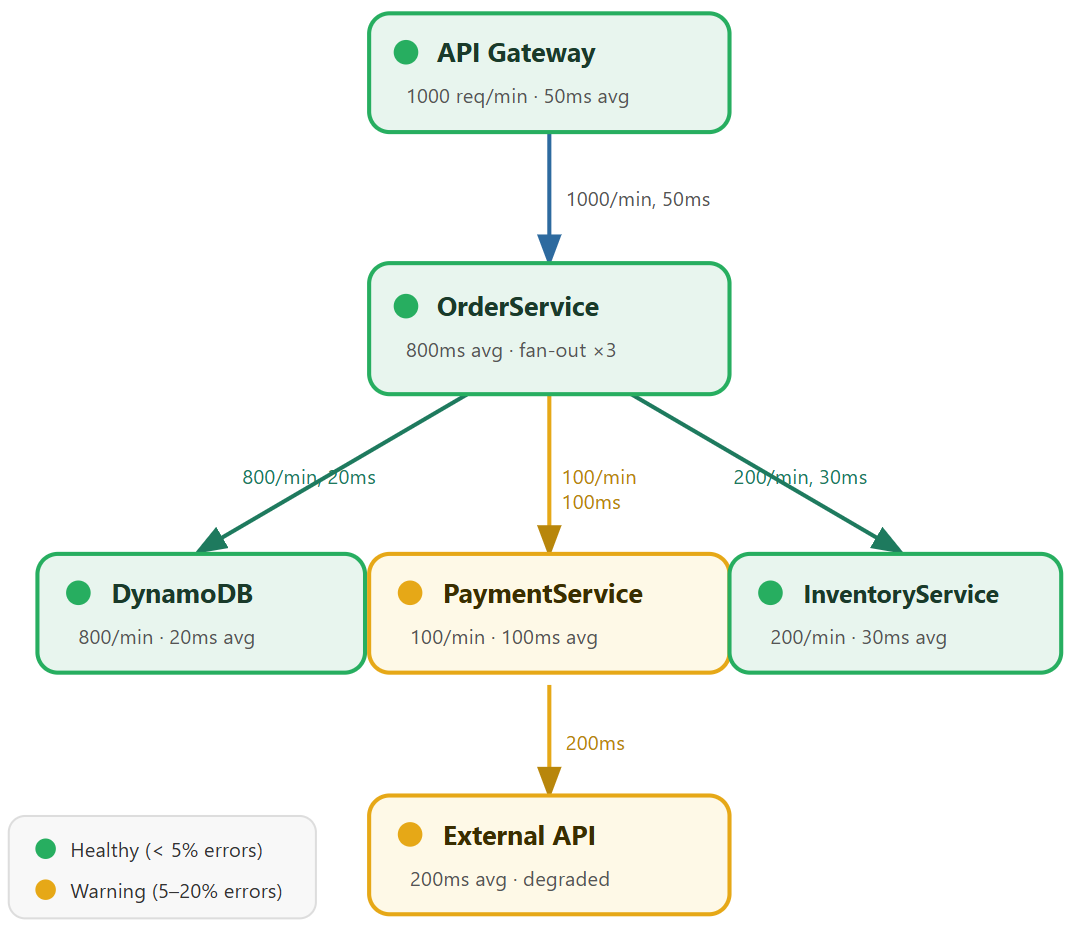
Mapa de servicios con API Gateway y OrderService desplegándose hacia DynamoDB Inventory y un servicio Payment en amarillo

Supervisión y resolución de problemas en AWS

Análisis de la ruta crítica


Ruta crítica = cadena más larga de llamadas de servicio

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Total: 400ms

External API = 50% de la latencia total


Qué hacer con esto:

  • External API es tu objetivo de optimización
  • Opciones: añadir caché, implementar timeout + fallback, negociar SLAs

Compara ruta alternativa:

OrderService -> DynamoDB
Total: 120ms (rápida)
Supervisión y resolución de problemas en AWS

Riesgos de dependencias


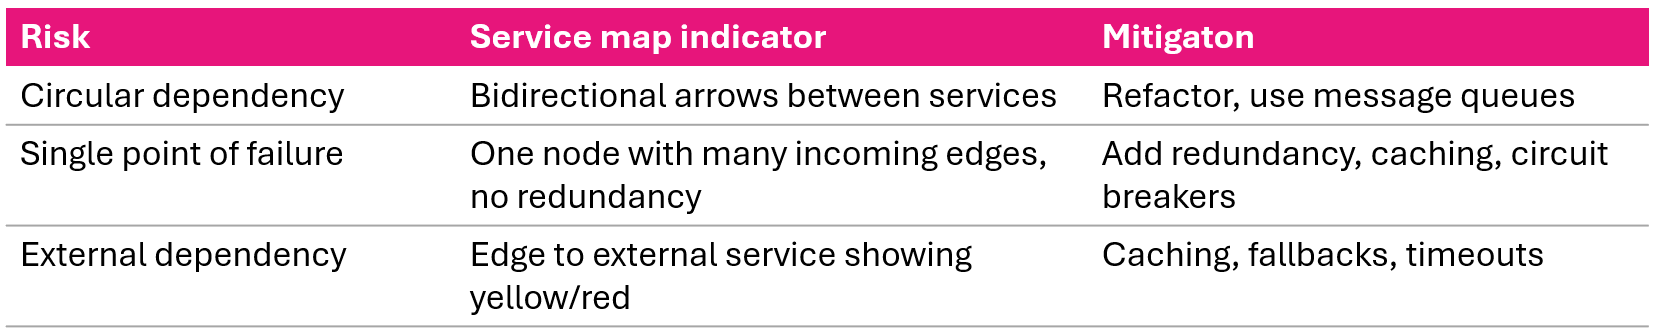
Riesgos de dependencias en el mapa de servicios: dependencias circulares, puntos únicos de fallo y dependencias externas de riesgo

Supervisión y resolución de problemas en AWS

Cómo entender las cronologías de trazas
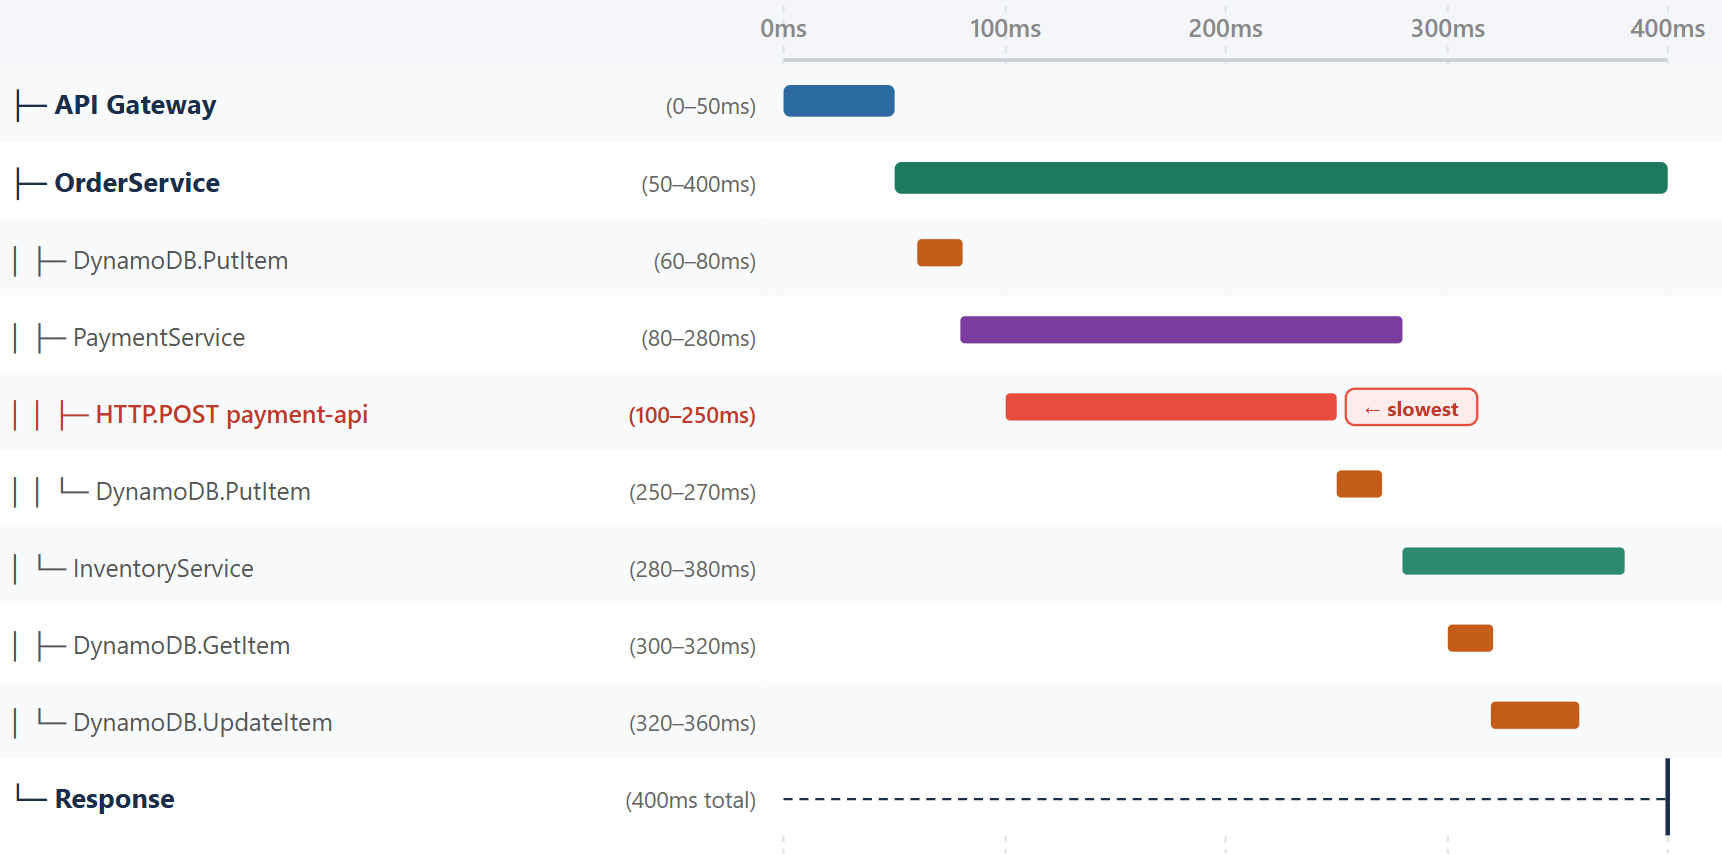
 

Cronología de trazas con subsegmentos a lo largo del tiempo mostrando una llamada a payment-api como la operación más larga


  • Eje horizontal tiempo: cuándo empezaron las operaciones y cuánto duraron
  • Eje vertical jerarquía de servicios: subsegmentos sangrados bajo sus padres
  • HTTP.POST a payment-api (100-250ms) = la operación más larga
Supervisión y resolución de problemas en AWS

Patrón 1: Cuellos de botella secuenciales


Antes (secuencial - 80ms):

Consulta 1 (10-30ms)
         -> Consulta 2 (30-50ms)
                  -> Consulta 3 (50-70ms)
                           -> Consulta 4 (70-90ms)


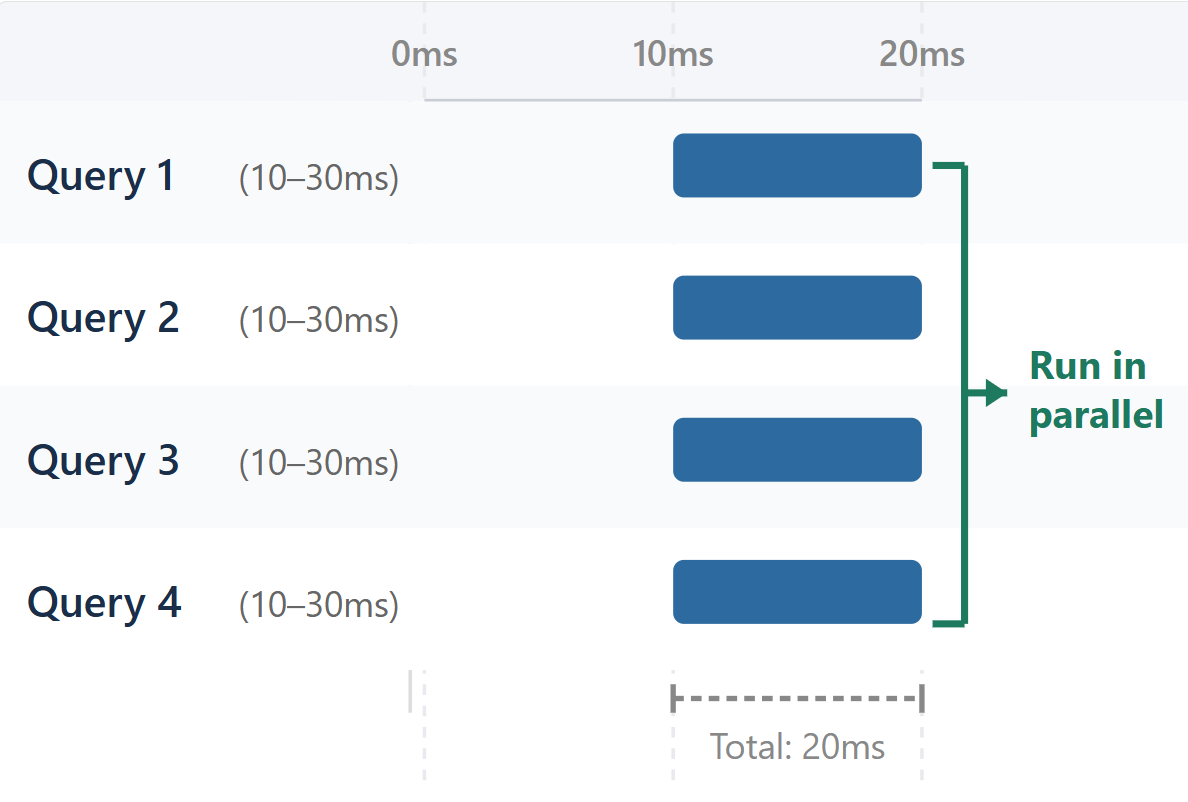
Después (paralelo - 20ms):

Cronología de cuatro consultas ejecutándose en paralelo y solapándose hasta terminar en 20ms

Supervisión y resolución de problemas en AWS

Patrón 2: Consultas N+1 y servicios parlanchines


Problema de consultas N+1:

Obtener lista de usuarios       (10-20ms)
Obtener detalles del usuario 1  (20-30ms)
Obtener detalles del usuario 2  (30-40ms)
... ×100 consultas secuenciales

Solución: consultas por lotes, eager loading


Servicios parlanchines:

  • 50 llamadas pequeñas entre dos servicios en vez de 1 por lotes
  • Cada llamada: establecimiento de conexión + serialización + ida y vuelta
  • 50× la sobrecarga

Solución: peticiones por lotes, colas de mensajes, caché

Supervisión y resolución de problemas en AWS

Patrón 3: Arranques en frío y fallos en cascada
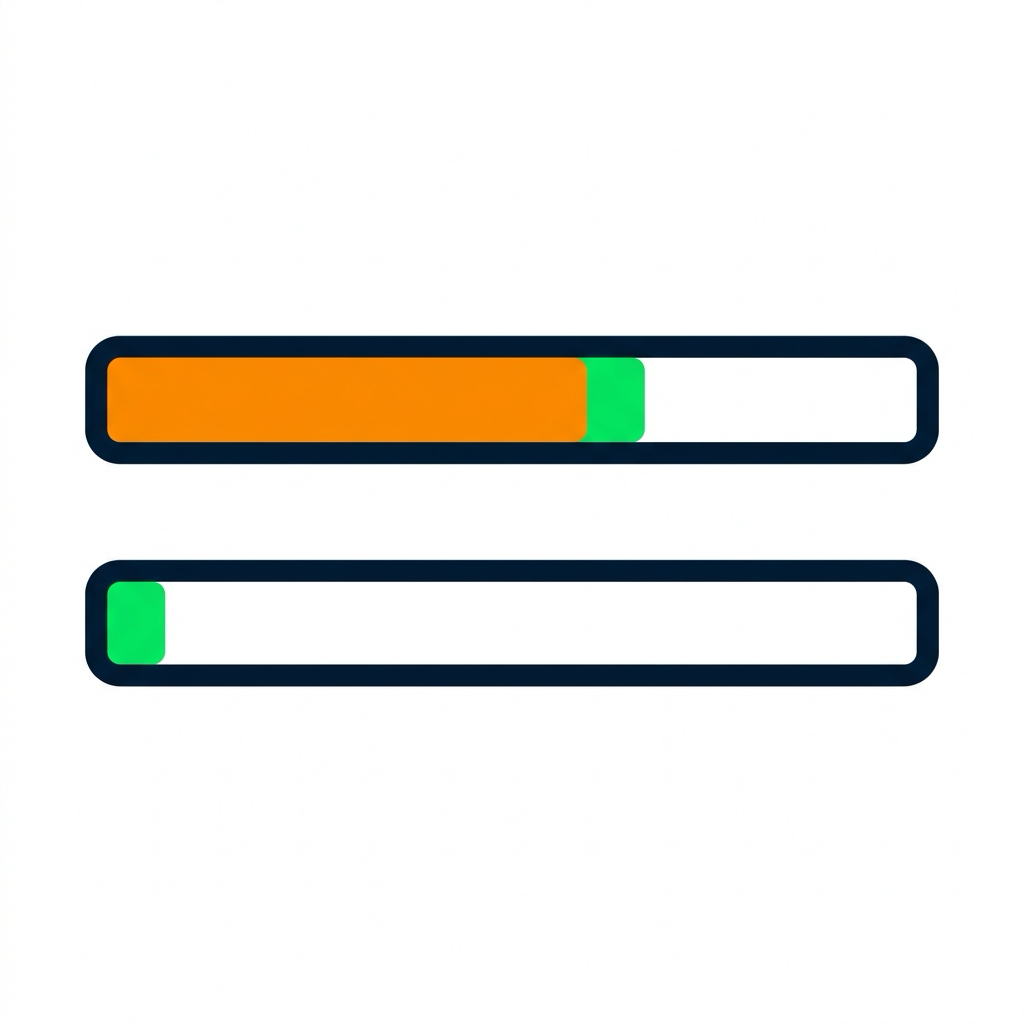
 

Dos barras temporales: un arranque en frío tiene un gran bloque naranja de inicialización y luego un pequeño manejador verde; un arranque en caliente es solo el pequeño manejador verde

Arranque en frío de Lambda:

  • En frío: 3000ms (2500ms init + 500ms handler)
  • En caliente: 500ms (solo handler)
  • Visible como un gran segmento de init en la primera invocación

Solución: provisioned concurrency, optimizar la inicialización


Fallo en cascada:

Servicio A [Error]
  -> Servicio B [Timeout 5s]
    -> Servicio C [Timeout 5s]
      -> Base de datos [Timeout 5s]

Bloques de timeout coincidentes apilados por la jerarquía de la traza

Solución: timeouts, circuit breakers, fallbacks

Supervisión y resolución de problemas en AWS

Filtrar trazas con anotaciones

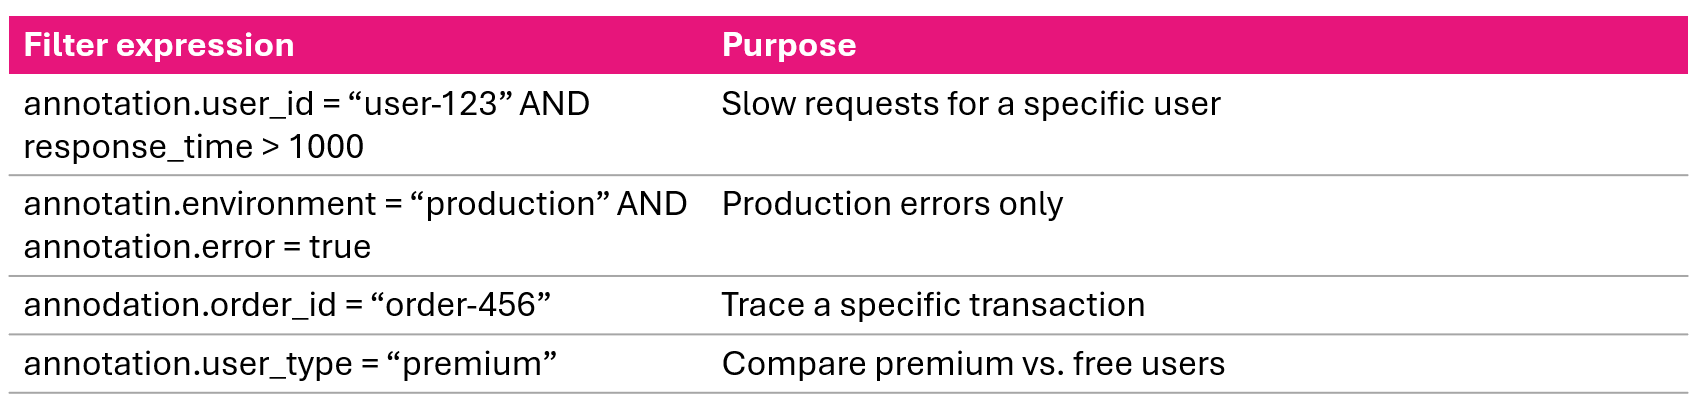
Consola X-Ray filtrando trazas por pares clave-valor de anotaciones

Compara grupos:

  • Usuarios premium media 200ms vs. usuarios free media 150ms → las funciones premium añaden latencia
  • EU West 3× más lento que US East → problema de acceso a datos entre regiones
Supervisión y resolución de problemas en AWS

Flujo de análisis de trazas


  1. Identificar: filtra response_time > 1000ms, ordena por duración
  2. Analizar: busca operaciones más largas, cuellos secuenciales, oportunidades en paralelo
  3. Anotar: revisa anotaciones con contexto de negocio: ID de usuario, ID de pedido, entorno
  4. Revisar: examina metadatos: detalles de petición, mensajes de error
  5. Correlacionar: contrasta con CloudWatch Logs
  6. Diagnosticar: causa raíz: consulta lenta, timeout, algoritmo, agotamiento de recursos
  7. Corregir: optimiza código, añade caché, paraleliza, escala
  8. Verificar: compara trazas antes/después, monitoriza latencia y tasas de error
Supervisión y resolución de problemas en AWS

Creación de alertas a partir de datos de X-Ray


# Alarma de alta latencia
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# Alarma de alto número de errores
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
Supervisión y resolución de problemas en AWS

Resumen del vídeo


  • Mapas de servicios: diagramas de arquitectura auto-generados: nodos (servicios), aristas (conexiones), estado por color
  • Colores: verde (éxito), amarillo (4xx), rojo (fallos 5xx), morado (429), gris (sin tráfico)
  • Ruta crítica: cadena de llamadas más larga, identifica tu objetivo de optimización
  • Cronologías de trazas: revelan cuellos secuenciales, consultas N+1, arranques en frío, fallos en cascada
  • Anotaciones: filtra y agrupa trazas por contexto de negocio
  • Flujo de trabajo: ocho pasos: identificar → analizar → anotar → revisar → correlacionar → diagnosticar → corregir → verificar
Supervisión y resolución de problemas en AWS

Análisis de trazas y mapas de servicios

Supervisión y resolución de problemas en AWS

Preparing Video For Download...