Alarmas y notificaciones de CloudWatch

Supervisión y resolución de problemas en AWS

John Q. Martin

Principal Consultant

¿Qué son las alarmas de CloudWatch?
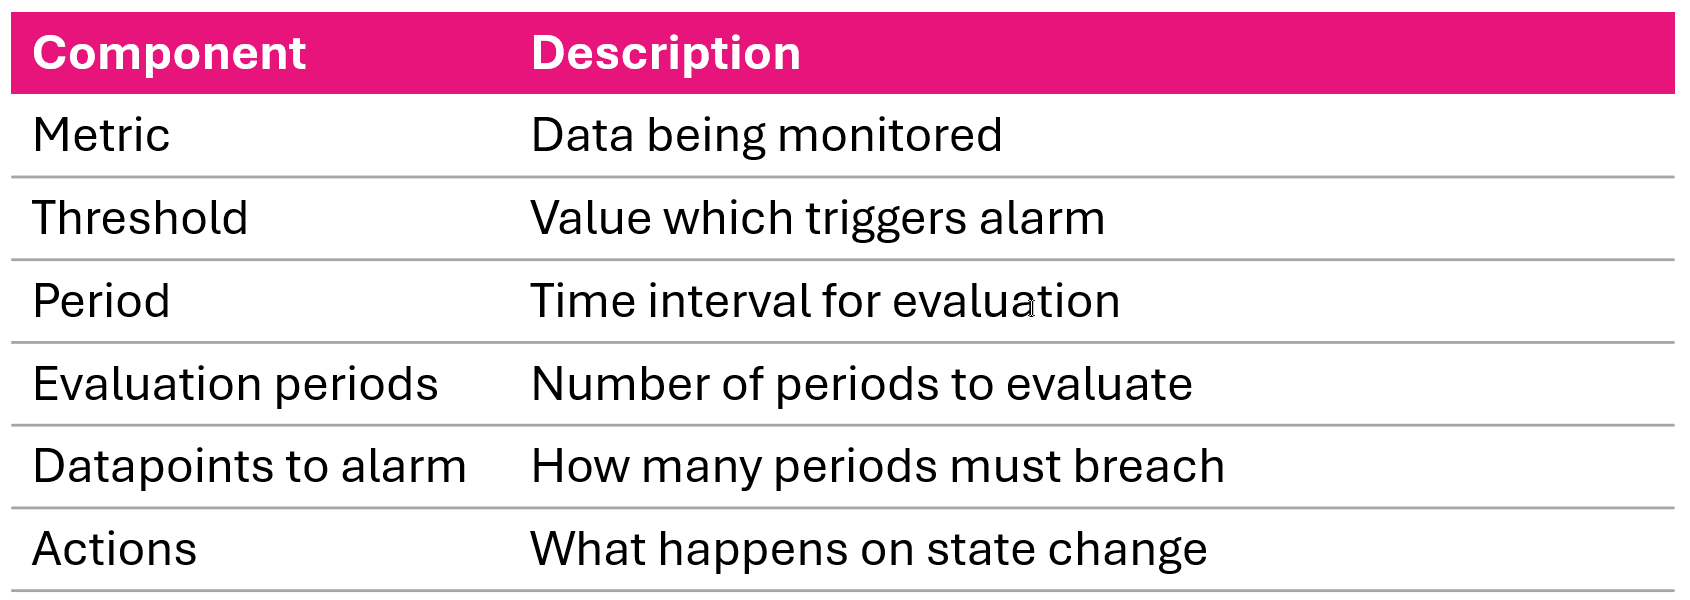
 

Conceptos clave

  • Supervisa una métrica durante un periodo
  • Ejecuta acciones si la métrica cruza un umbral


Seis componentes básicos de una alarma de CloudWatch: metric, threshold, period, evaluation periods, datapoints to alarm y actions

Supervisión y resolución de problemas en AWS

Estados de alarma

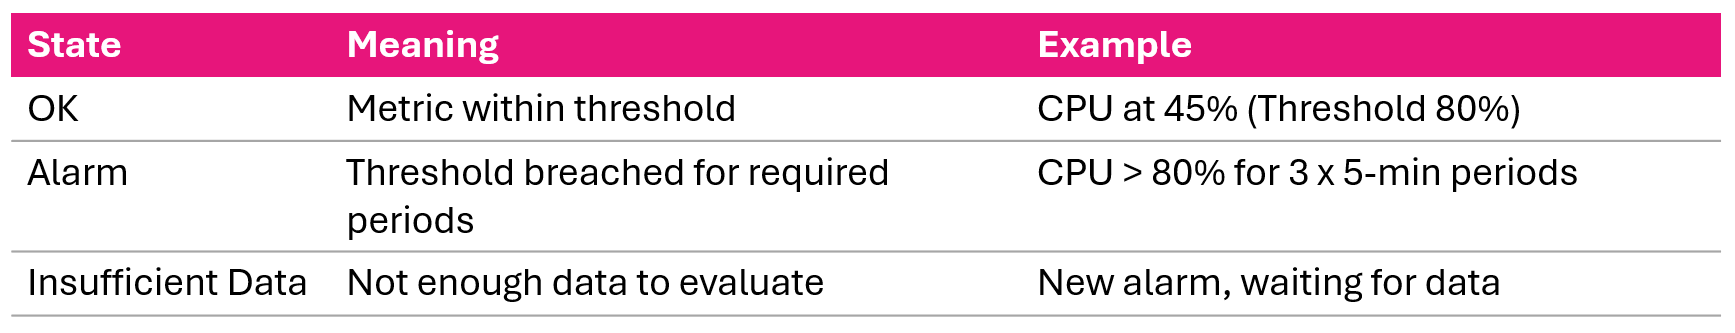
Los tres estados de una alarma de CloudWatch: OK, ALARM e INSUFFICIENT_DATA

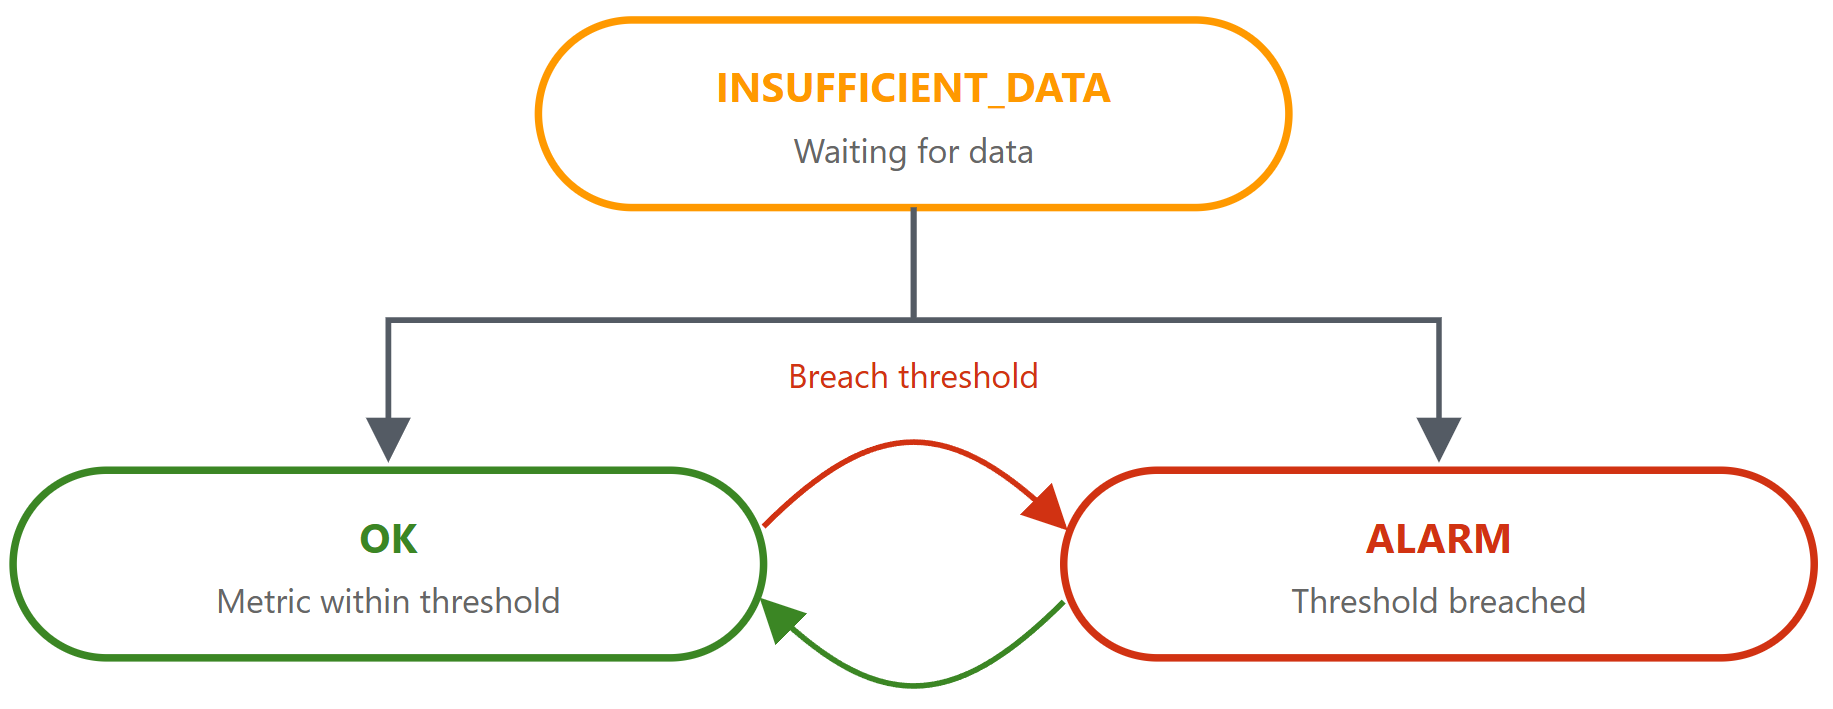
Diagrama de cómo una alarma de CloudWatch cambia de estado a medida que llegan datos de la métrica

Supervisión y resolución de problemas en AWS

Evaluación de alarmas


  1. Recoge puntos de datos a intervalos definidos
  2. Aplica una estadística (Average, Sum, Max, Min) al periodo
  3. Compara el resultado con el umbral
  4. Cuenta los periodos de evaluación en incumplimiento
  5. Cambia de estado si se cumple datapoints-to-alarm


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Supervisión y resolución de problemas en AWS

Estrategias de evaluación


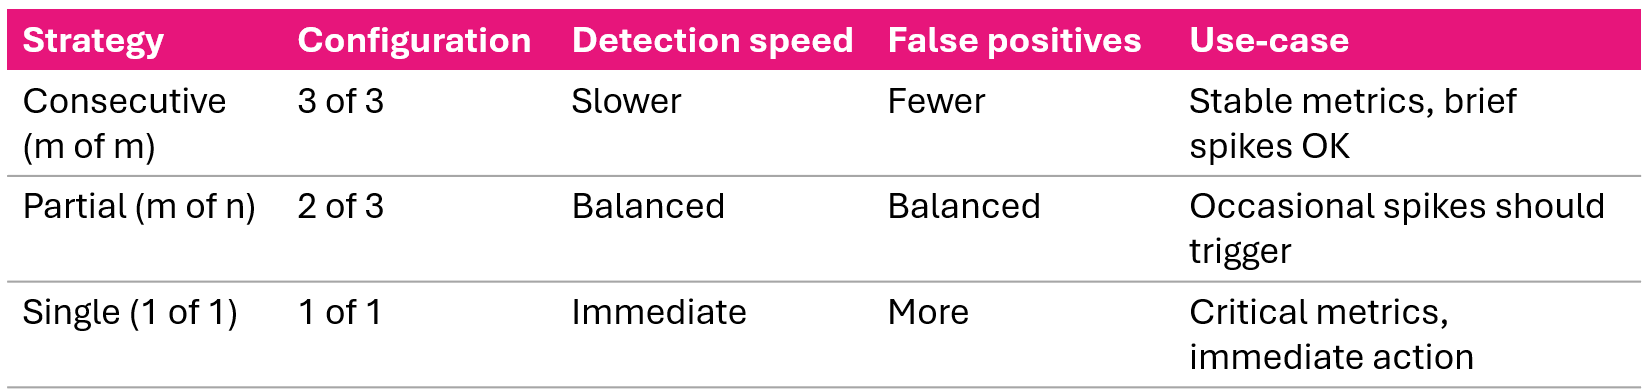
Tres estrategias de evaluación de alarmas: consecutive, partial y single breach, con sus compensaciones de sensibilidad

Supervisión y resolución de problemas en AWS

Tipos de acción y disparadores de alarmas


Disparadores de acción

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Tipos de acción

  • Notificación SNS
  • Auto Scaling
  • Acción de EC2 (stop/terminate/reboot/recover)
  • Systems Manager
Supervisión y resolución de problemas en AWS

Comportamiento con datos ausentes


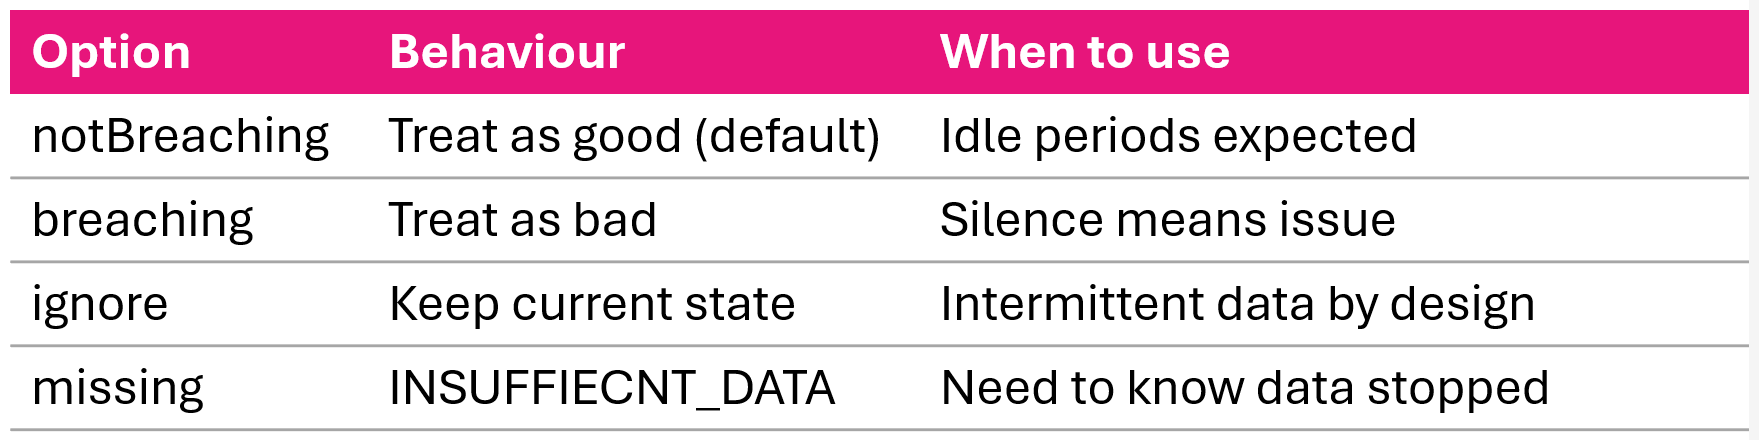
Opciones de comportamiento ante datos ausentes: notBreaching, breaching, ignore y missing

Supervisión y resolución de problemas en AWS

Crear una alarma estándar: AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Supervisión y resolución de problemas en AWS

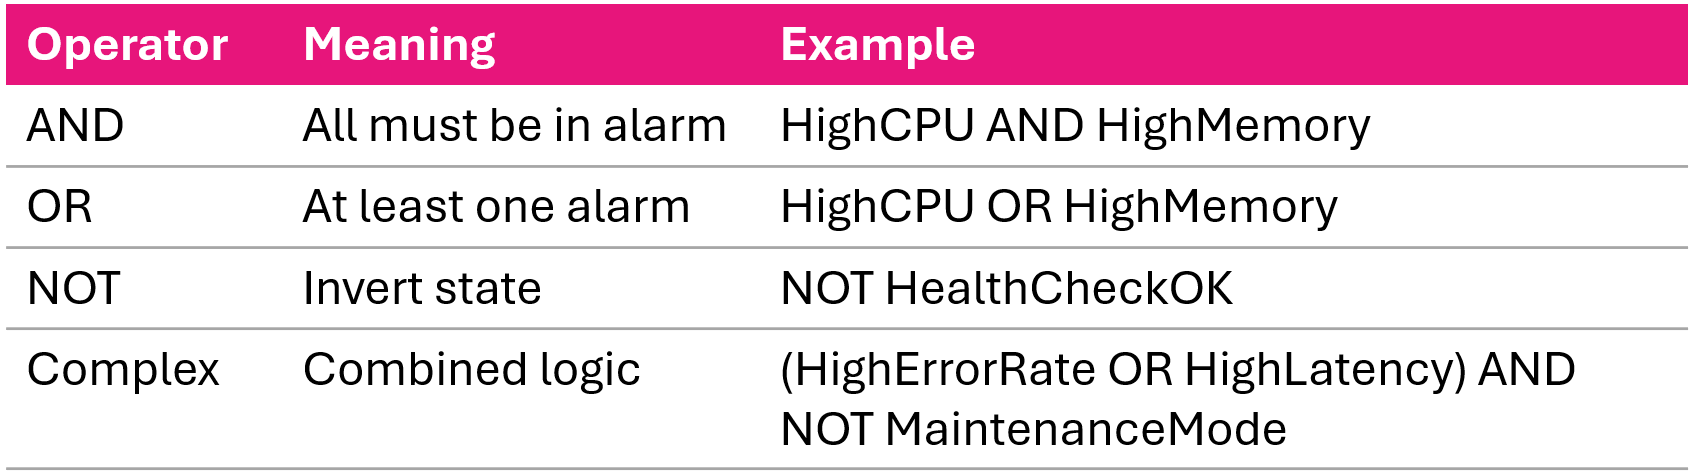
Alarmas compuestas: qué y por qué

Problema

  • Varias alarmas relacionadas saltan por separado = fatiga de alertas

Solución

  • Combina alarmas con operadores lógicos

Lógica de alarma compuesta combinando alarmas hijas con operadores AND, OR y NOT

Supervisión y resolución de problemas en AWS

Crear alarma compuesta: AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Regla compleja de ejemplo
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Supervisión y resolución de problemas en AWS

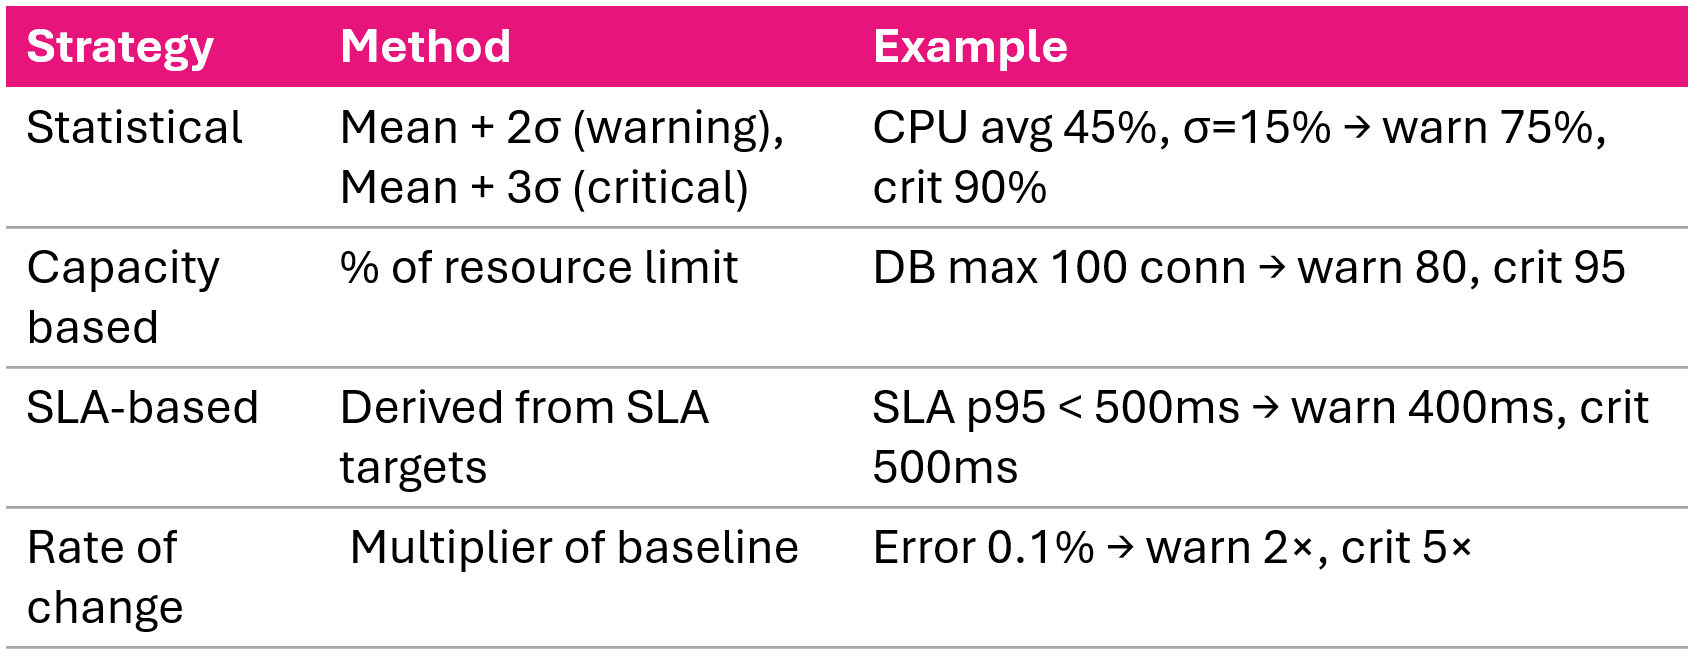
Estrategia de selección de umbrales

Cuatro estrategias para elegir umbrales: desviación del baseline, límites de capacidad, objetivos de SLA y tasa de cambio

Supervisión y resolución de problemas en AWS

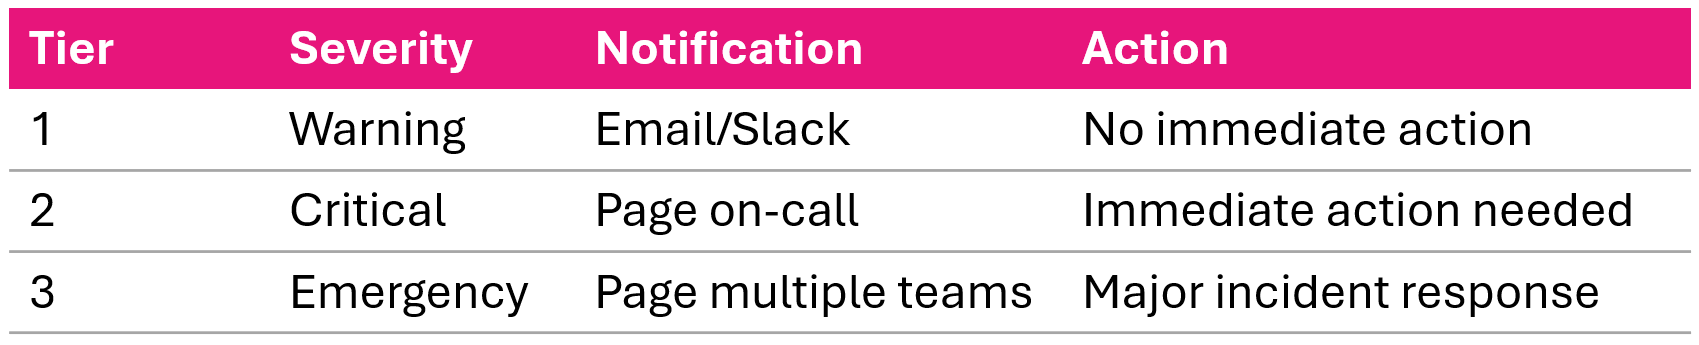
Estrategia de alarmas multinivel


Respuesta de alarmas multinivel con niveles de warning, critical y emergency dirigidos a temas SNS separados

Ejemplo: aviso de CPU al 75%, crítico al 90%, cada uno con temas SNS distintos

Supervisión y resolución de problemas en AWS

Alarmas de detección de anomalías

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • El modelo de ML aprende el comportamiento normal de la métrica
  • Crea una banda de umbral dinámica (configurable)
  • Se adapta a patrones diarios/semanales
  • Reduce el ajuste manual de umbrales
Supervisión y resolución de problemas en AWS

Alarmas por recurso: Lambda y ALB

Alarmas para Lambda
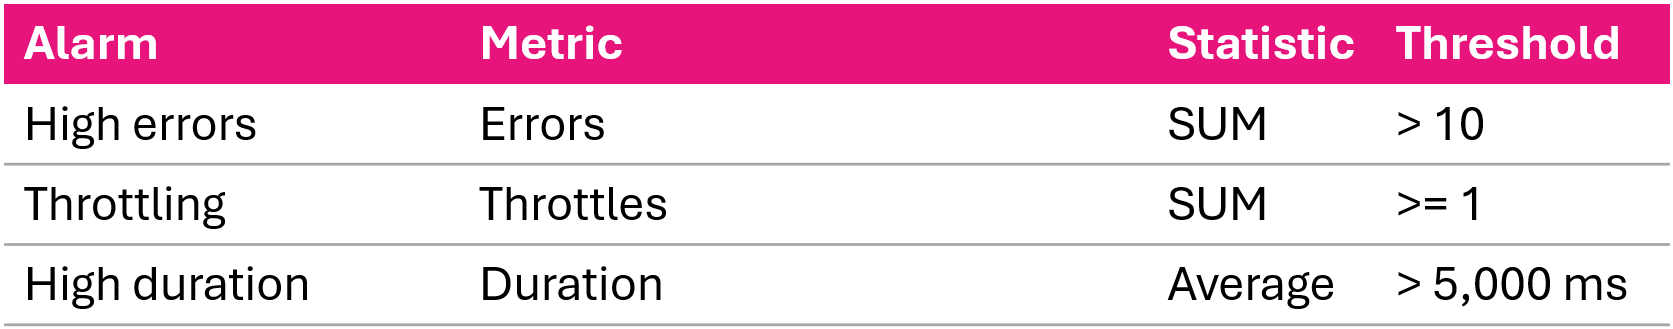
Alarmas recomendadas para Lambda: errores, throttles y duración alta cerca del límite de tiempo de espera

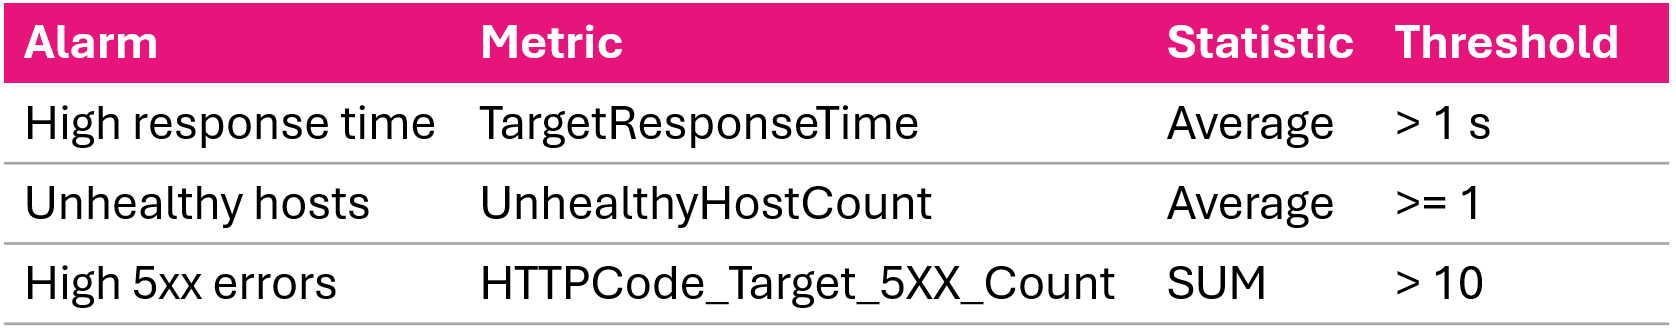
Alarmas para ALB

Alarmas recomendadas para ALB: tiempo de respuesta del destino, hosts no saludables y recuento de errores 5xx

Supervisión y resolución de problemas en AWS

Prácticas recomendadas de gestión de alarmas

  • Nomenclatura: <Service>-<Metric>-<Resource>-<Severity>
  • Descripciones: qué se monitoriza, umbral, pistas de diagnóstico, enlaces a runbook
  • Etiquetas: Environment, Team, Severity
  • Revisión mensual: ajusta umbrales, elimina obsoletas, actualiza acciones
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Supervisión y resolución de problemas en AWS

Resumen del vídeo

  • Tres estados: OK, ALARM, INSUFFICIENT_DATA
  • Estrategias de evaluación: consecutive, partial, single breach
  • Alarmas compuestas combinan varias con AND, OR, NOT
  • Cuatro estrategias de umbral: estadística, capacidad, SLA, tasa de cambio
  • Alertado multinivel: warning → critical → emergency
  • Alarmas por recurso: Lambda (errors, throttles, duration) y ALB (5xx, latency)
Supervisión y resolución de problemas en AWS

¡Vamos a practicar!

Supervisión y resolución de problemas en AWS

Preparing Video For Download...