Allarmi e notifiche CloudWatch

Monitoraggio e risoluzione dei problemi su AWS

John Q. Martin

Principal Consultant

Cosa sono i CloudWatch Alarms
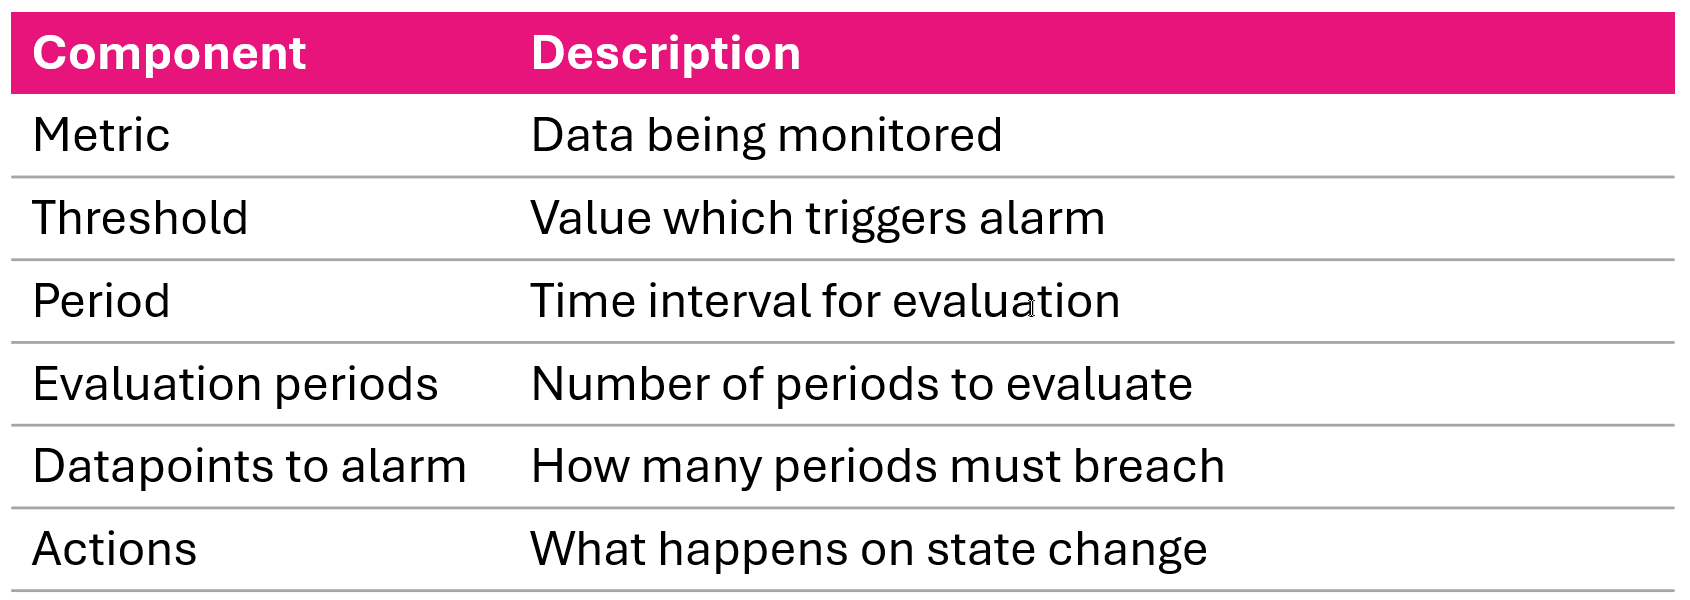
 

Concetti chiave

  • Monitora una singola metrica su un periodo
  • Esegue azioni quando la metrica supera una soglia


Sei componenti chiave di un allarme CloudWatch: metrica, soglia, periodo, periodi di valutazione, datapoints to alarm e azioni

Monitoraggio e risoluzione dei problemi su AWS

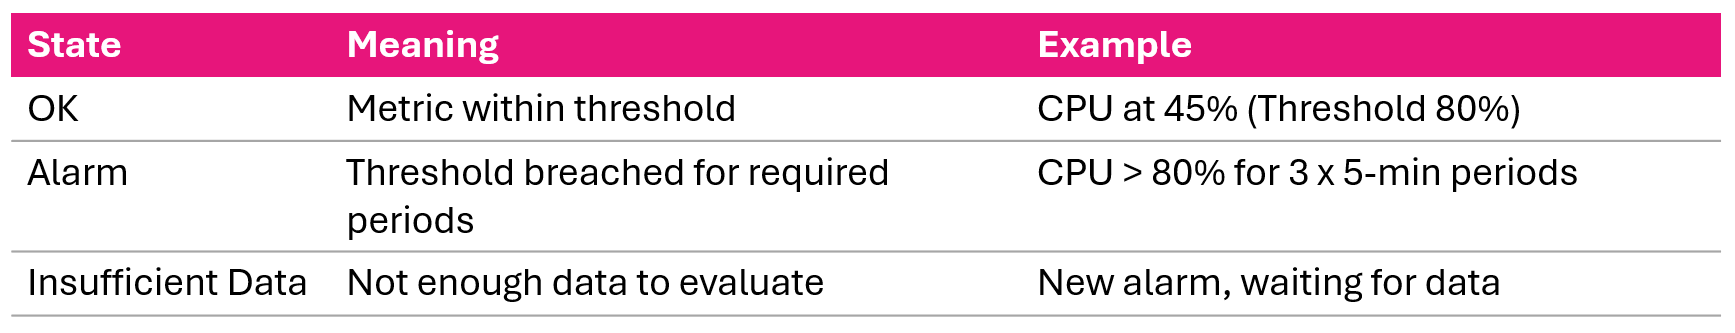
Stati dell'allarme

I tre stati di un allarme CloudWatch: OK, ALARM e INSUFFICIENT_DATA

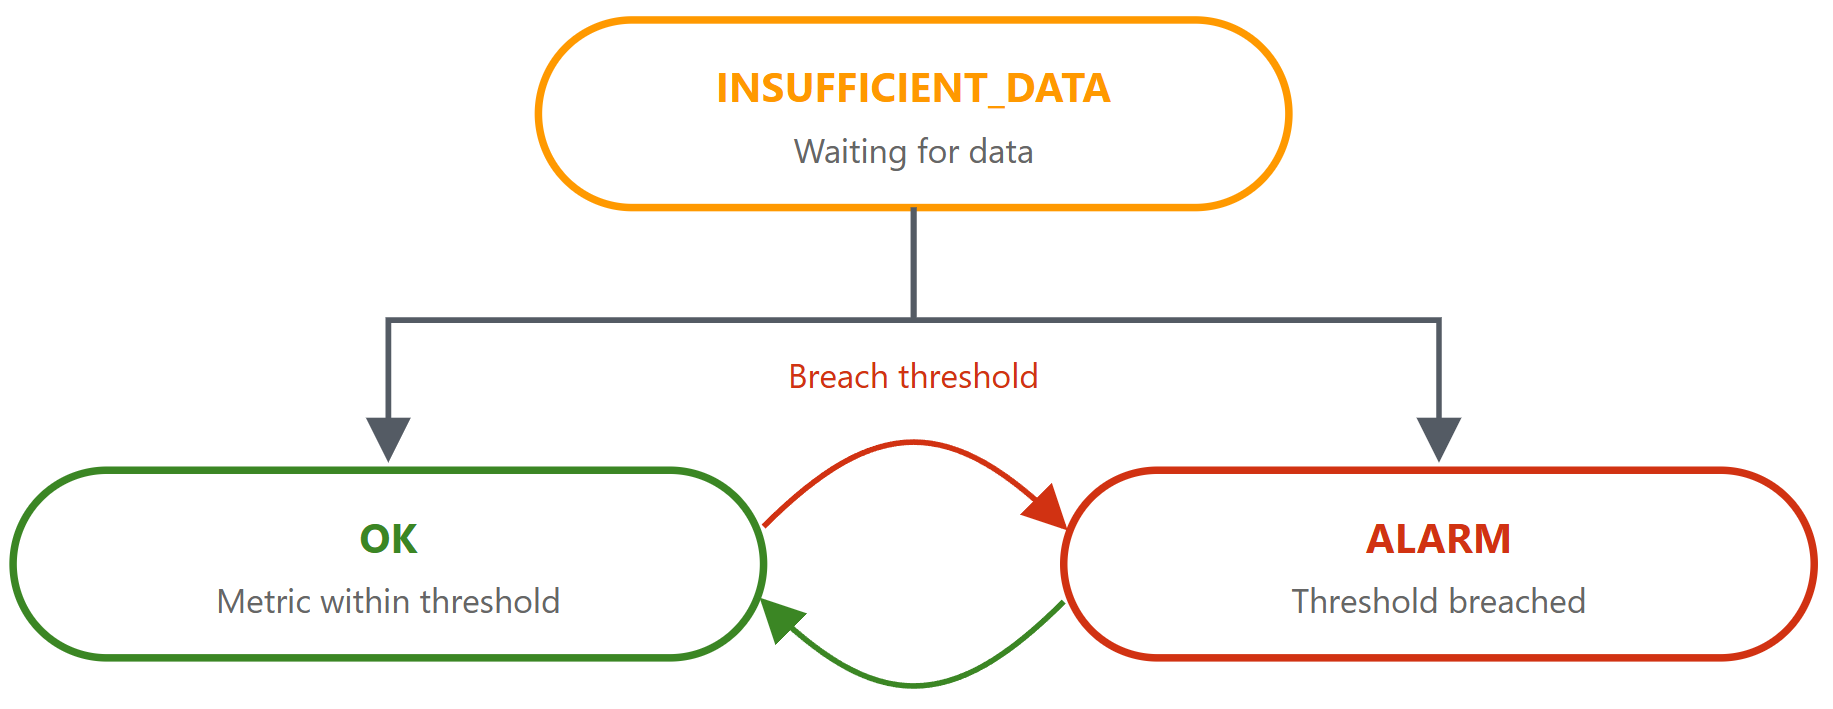
Diagramma di come un allarme CloudWatch passa tra stati al variare dei dati della metrica

Monitoraggio e risoluzione dei problemi su AWS

Valutazione degli allarmi


  1. Raccogli i punti dati a intervalli definiti
  2. Applica una statistica (Average, Sum, Max, Min) sul periodo
  3. Confronta il risultato con la soglia
  4. Conta i periodi di valutazione in violazione
  5. Cambia stato se la soglia di datapoints-to-alarm è raggiunta


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Monitoraggio e risoluzione dei problemi su AWS

Strategie di valutazione


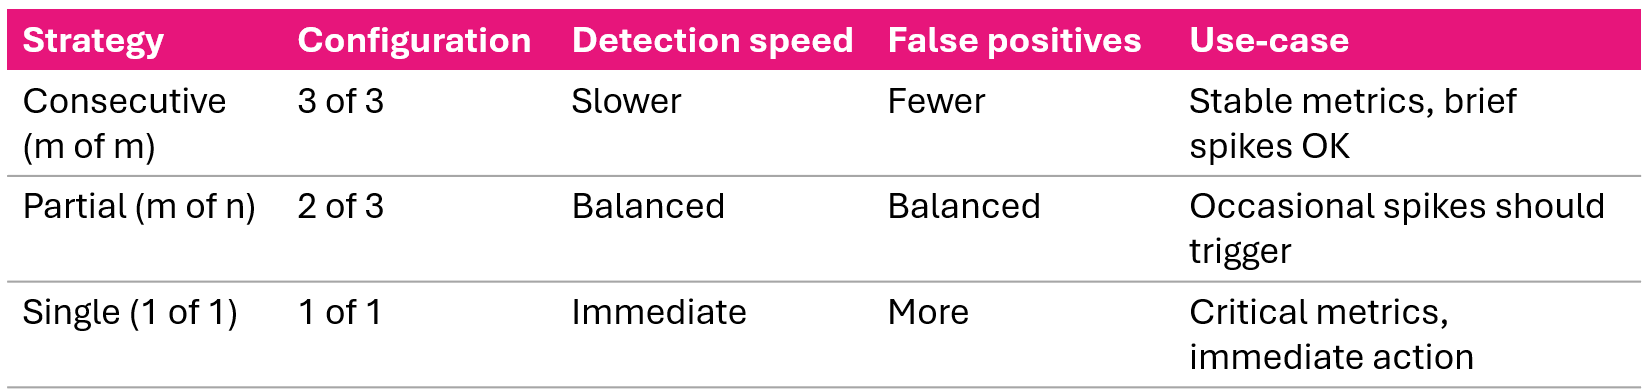
Tre strategie di valutazione dell'allarme: consecutiva, parziale e singola violazione con relativi compromessi di sensibilità

Monitoraggio e risoluzione dei problemi su AWS

Tipi di azioni e trigger degli allarmi


Trigger delle azioni

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Tipi di azione

  • Notifica SNS
  • Auto Scaling
  • Azione EC2 (stop/terminate/reboot/recover)
  • Systems Manager
Monitoraggio e risoluzione dei problemi su AWS

Comportamento con dati mancanti


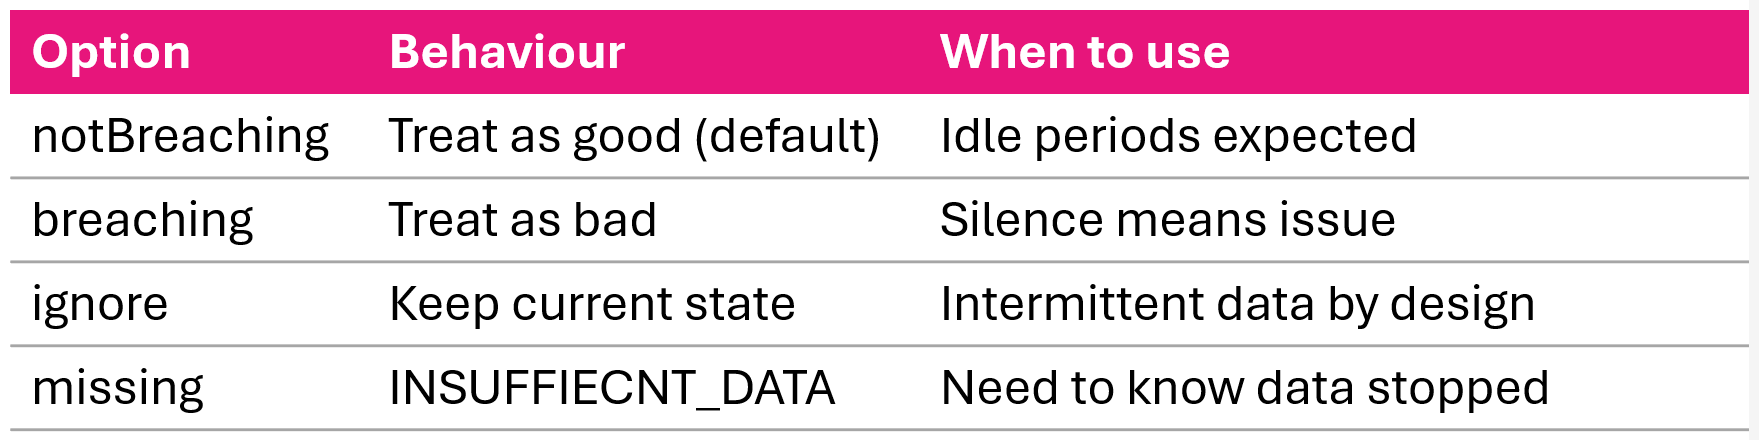
Opzioni di comportamento per dati mancanti: notBreaching, breaching, ignore e missing

Monitoraggio e risoluzione dei problemi su AWS

Creare un allarme standard: AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Monitoraggio e risoluzione dei problemi su AWS

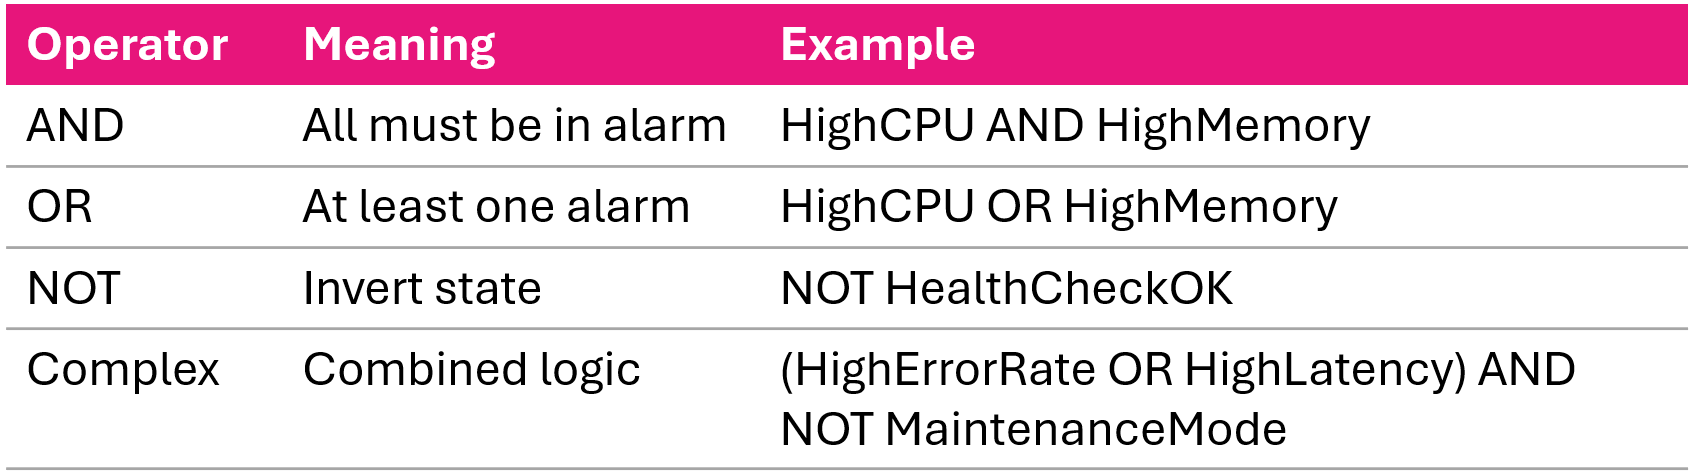
Allarmi compositi: cosa e perché

Problema

  • Più allarmi correlati scattano separatamente = affaticamento da avvisi

Soluzione

  • Combina gli allarmi con operatori logici

Logica di allarme composito che combina allarmi figli con operatori AND, OR e NOT

Monitoraggio e risoluzione dei problemi su AWS

Creare un allarme composito: AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Esempio di regola complessa
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Monitoraggio e risoluzione dei problemi su AWS

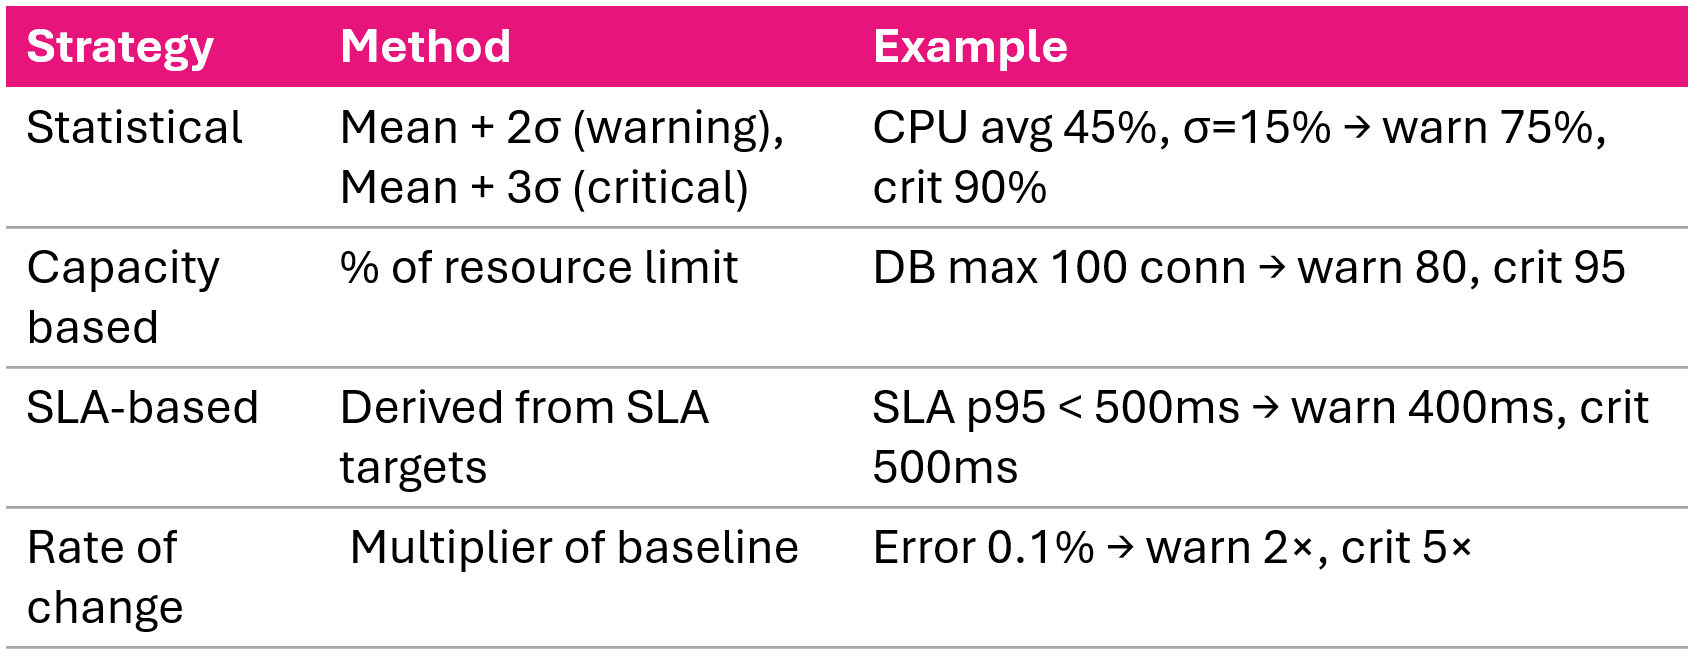
Strategia di selezione delle soglie

Quattro strategie di scelta della soglia: deviazione dal baseline, limiti di capacità, target SLA e tasso di variazione

Monitoraggio e risoluzione dei problemi su AWS

Strategia multi‑livello per gli allarmi
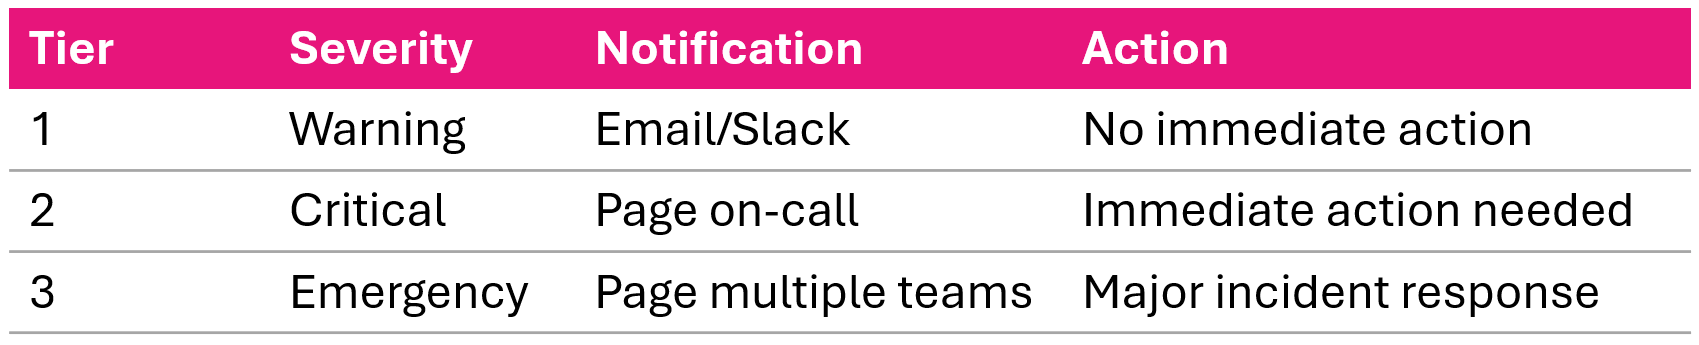
 

Risposta ad allarmi multi-livello con livelli warning, critical ed emergency indirizzati a diversi topic SNS

Esempio: Avviso CPU a 75%, Critico a 90%, ciascuno con topic SNS diversi

Monitoraggio e risoluzione dei problemi su AWS

Allarmi di rilevamento anomalie

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • Il modello di Machine Learning apprende il comportamento normale della metrica
  • Crea una banda di soglia dinamica (configurabile)
  • Si adatta a pattern giornalieri/settimanali
  • Riduce la taratura manuale delle soglie
Monitoraggio e risoluzione dei problemi su AWS

Allarmi per risorse: Lambda e ALB

Allarmi Lambda
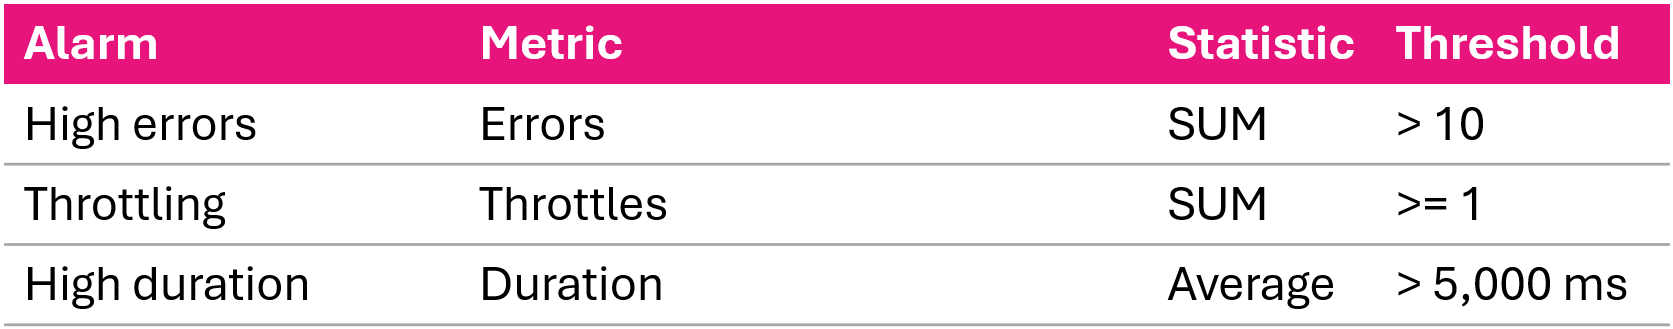
Allarmi Lambda consigliati: errori, throttles e durata elevata vicina al timeout

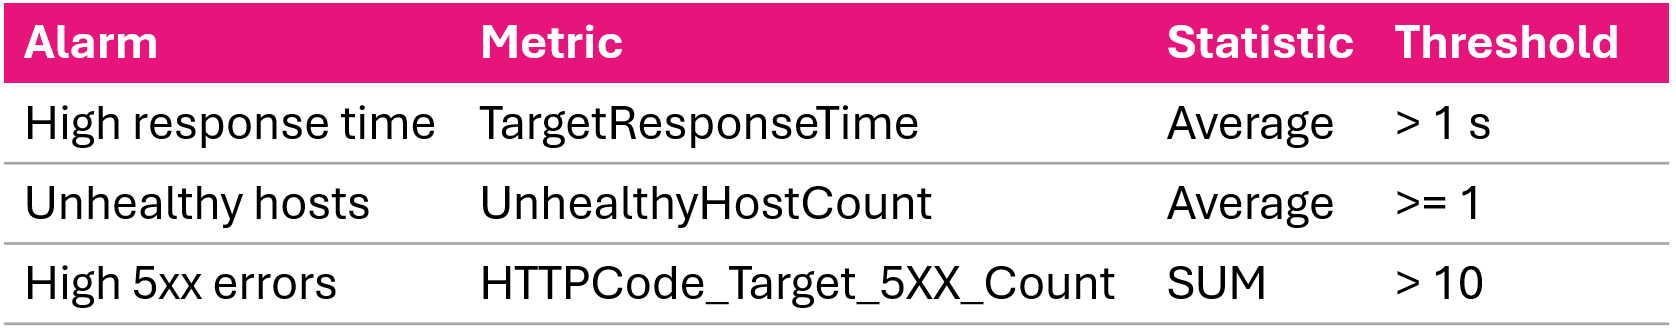
Allarmi ALB

Allarmi ALB consigliati: tempo di risposta dei target, host non integri e conteggi di errori 5xx

Monitoraggio e risoluzione dei problemi su AWS

Best practice per la gestione degli allarmi

  • Nomi: <Service>-<Metric>-<Resource>-<Severity>
  • Descrizioni: cosa è monitorato, soglia, suggerimenti di troubleshooting, link al runbook
  • Tag: Environment, Team, Severity
  • Revisione mensile: regola soglie, rimuovi obsolete, aggiorna azioni
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Monitoraggio e risoluzione dei problemi su AWS

Riepilogo del video

  • Tre stati: OK, ALARM, INSUFFICIENT_DATA
  • Strategie di valutazione: consecutiva, parziale, singola violazione
  • Gli allarmi compositi combinano più allarmi con AND, OR, NOT
  • Quattro strategie di soglia: statistica, capacità, SLA, tasso di variazione
  • Avvisi multi‑livello: warning → critical → emergency
  • Allarmi per risorse: Lambda (errori, throttles, durata) e ALB (5xx, latenza)
Monitoraggio e risoluzione dei problemi su AWS

Esercitiamoci!

Monitoraggio e risoluzione dei problemi su AWS

Preparing Video For Download...