Log-Insights und Analyse
Überwachung und Fehlersuche in AWS

John Q. Martin
Principal Consultant
Struktur von Logs-Insights-Abfragen
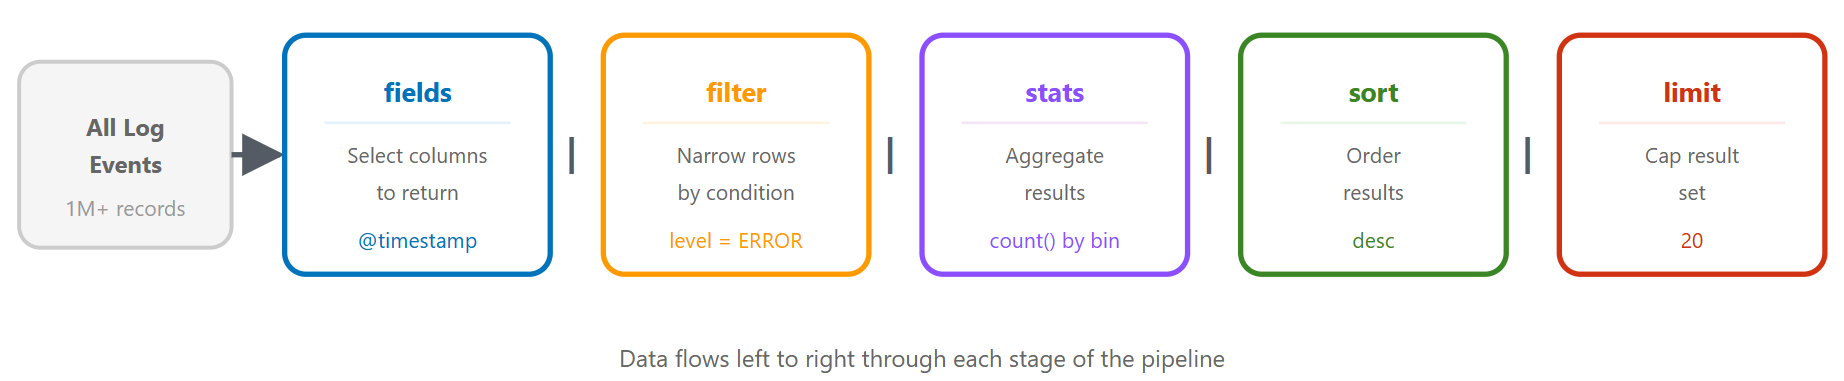
Abfragesprachen: gleiche Abfrage, drei Wege
CloudWatch Logs Insights QL
fields @timestamp, @message, level
| filter level = "ERROR"
| filter @timestamp > ago(1h)
| sort @timestamp desc
| limit 20
OpenSearch PPL
source = `/aws/lambda/my-function`
| where level = 'ERROR' and @timestamp > ago(1h)
| fields @timestamp, @message, level
| sort - @timestamp
| head 20
Abfragesprachen: OpenSearch SQL
OpenSearch SQL
SELECT `@timestamp`, `@message`, level
FROM `/aws/lambda/my-function`
WHERE level = 'ERROR'
  AND `@timestamp` > ago(1h)
ORDER BY `@timestamp` DESC
LIMIT 20
- Standardsyntax: SELECT / FROM / WHERE
- Ermöglicht JOINs über Log-Gruppen
- Nimm, was zu deinem Team passt
Szenario 1: Fehlerspitzen finden
fields @timestamp, @message, level
| filter level = "ERROR"
| stats count() as error_count by bin(5m)
| sort @timestamp desc
Erweitert: nach Fehlertyp gruppieren
fields @timestamp, error_type, error_message
| filter level = "ERROR"
| stats count() as count by error_type, bin(5m)
| sort count desc
Szenario 2: Langsame API-Endpunkte
fields @timestamp, endpoint, response_time, status_code
| filter response_time > 1000
| stats avg(response_time) as avg_time,
        max(response_time) as max_time,
        count() as slow_requests
        by endpoint
| sort avg_time desc
Drill-down
fields @timestamp, endpoint, response_time, user_id, request_id
| filter endpoint = "/api/users" and response_time > 1000
| sort response_time desc
| limit 20
Szenario 3: Fehlgeschlagene Authentifizierung
fields @timestamp, user_id, ip_address, action
| filter action = "login_failed"
| stats count() as failed_attempts by user_id, ip_address
| sort failed_attempts desc
| limit 50
Zeitbasierte Analyse
fields @timestamp, user_id, ip_address
| filter action = "login_failed"
| stats count() as attempts by ip_address, bin(1h)
| filter attempts > 10
| sort attempts desc
Szenarien 4 & 5: DB-Timeouts und Memory Leaks
Datenbank-Timeouts
fields @timestamp, @message
| filter @message like /database/ and @message like /timeout|error|failed/
| parse @message "timeout after * seconds" as timeout_duration
| stats count() as timeout_count,
        avg(timeout_duration) as avg_timeout
        by bin(5m)
Erkennen von Memory Leaks
fields @timestamp, memory_used_mb, heap_size_mb
| stats avg(memory_used_mb) as avg_memory,
        max(memory_used_mb) as max_memory
        by bin(1h)
| sort @timestamp asc
Szenario 6: Request Tracing
fields @timestamp, @message, request_id, service, action
| filter request_id = "abc123def456"
| sort @timestamp asc
Multi-Service-Trace
fields @timestamp, service, action, duration_ms, status
| filter request_id = "abc123def456"
| sort @timestamp asc
| display @timestamp, service, action, duration_ms, status
Fortgeschritten: parse, Regex
Unstrukturierte Logs parsen
fields @timestamp, @message
| parse @message "[*] User * failed to access resource * from IP *"
    as level, user, resource, ip
Regex-Parsing
| parse @message /Request completed in (?<duration>\d+)ms with status (?<status>\d+)/
Fortgeschritten: berechnete Felder
fields @timestamp, requests, errors
| fields error_rate = (errors / requests) * 100

fields @timestamp, status_code
| fields status_category =
    case(status_code < 300, "success",
         status_code < 500, "client_error",
         status_code >= 500, "server_error")
| stats count() as request_count by status_category
Abfrageoptimierung
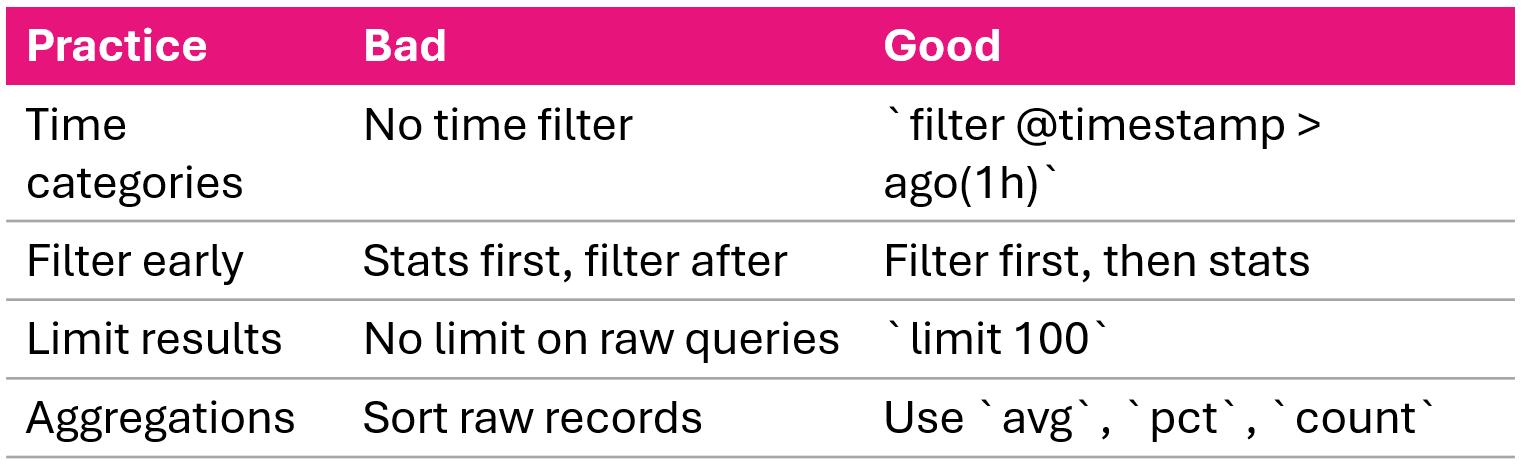
Anomalieerkennung und Korrelation
Statistische Anomalieerkennung
- Basislinie berechnen: Mittelwert und Std.-Abw. über 7 Tage
- Aktuellen Zeitraum mit Basislinie vergleichen
- Werte > 2 Standardabweichungen als anomal markieren
Fehlerraten-Korrelation
fields @timestamp, level
| stats count() as total_requests,
        sum(case(level = "ERROR", 1, 0)) as errors
        by bin(5m)
| fields error_rate = (errors / total_requests) * 100
Zusammenfassung
- CloudWatch Logs Insights: interaktiver Abfragedienst, keine Infrastruktur nötig
- Drei Abfragesprachen: Logs Insights QL, OpenSearch PPL, OpenSearch SQL
- Sechs Troubleshooting-Szenarien: Fehlerspitzen, langsame Endpunkte, fehlgeschlagene Auth, DB-Timeouts, Memory Leaks, Request Tracing
- Fortgeschritten:
parsefür unstrukturierten Text,bin()für Zeitreihen,pct()für Perzentile - Korrelation und Anomalieerkennung: Fehlerratenanalyse, statistischer Basislinienvergleich
- Von Analyse zu Automation: Metrikfilter und Alarme schließen den Kreis
Lass uns üben!
Überwachung und Fehlersuche in AWS

