Traces und Servicemaps analysieren

Überwachung und Fehlersuche in AWS

John Q. Martin

Principal Consultant

Was ist eine Servicemap?


Automatisch aus deinen Trace-Daten erzeugt: kein manueller Aufwand
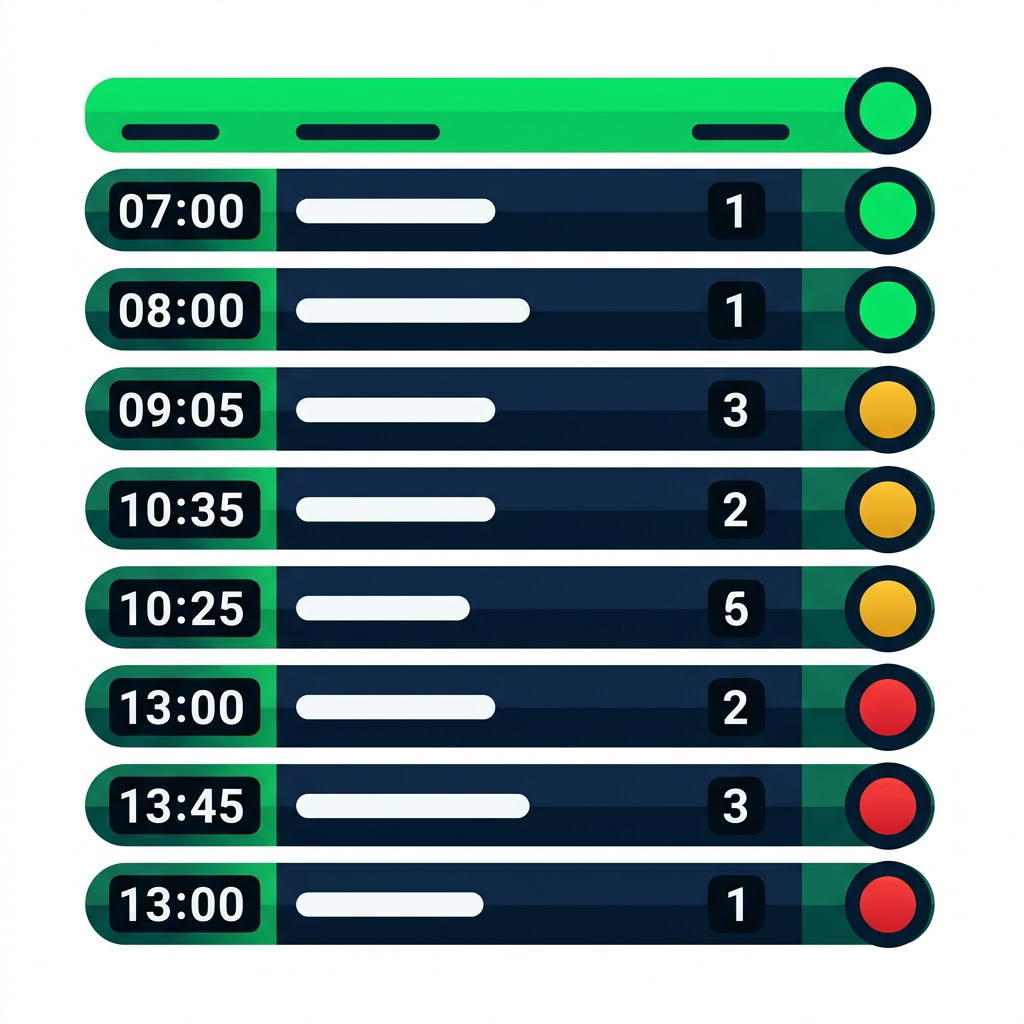
Abfahrtstafel mit Reihen von Services, jede mit einem farbigen Statuslicht: grün für pünktlich, gelb für verzögert, rot für gestoppt

Auf einen Blick: grün = pünktlich · gelb = verzögert · rot = gestoppt


So greifst du darauf zu:

  • X-Ray-Konsole → Service map
  • Filter anwenden
  • Auf einen Knoten klicken → Detailansicht
Überwachung und Fehlersuche in AWS

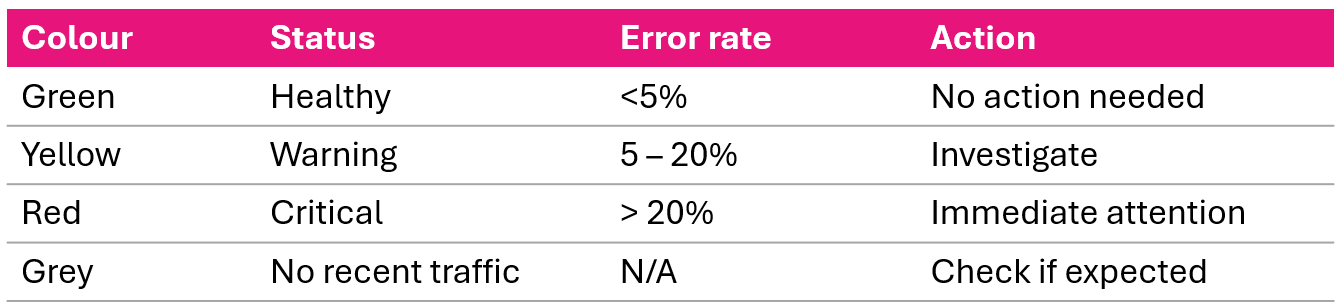
Servicemap-Farbkodierung


Servicemap-Farblegende: grün erfolgreiche Aufrufe, gelb Client-Fehler, rot Server-Fehler, lila Drosselung, grau kein Traffic

Wenn du eine Servicemap öffnest, schau zuerst auf alles, was nicht grün ist.

Klicke auf einen Knoten, um zu sehen: Verteilung der Antwortzeiten, HTTP-Status, Fehlertypen.

Überwachung und Fehlersuche in AWS

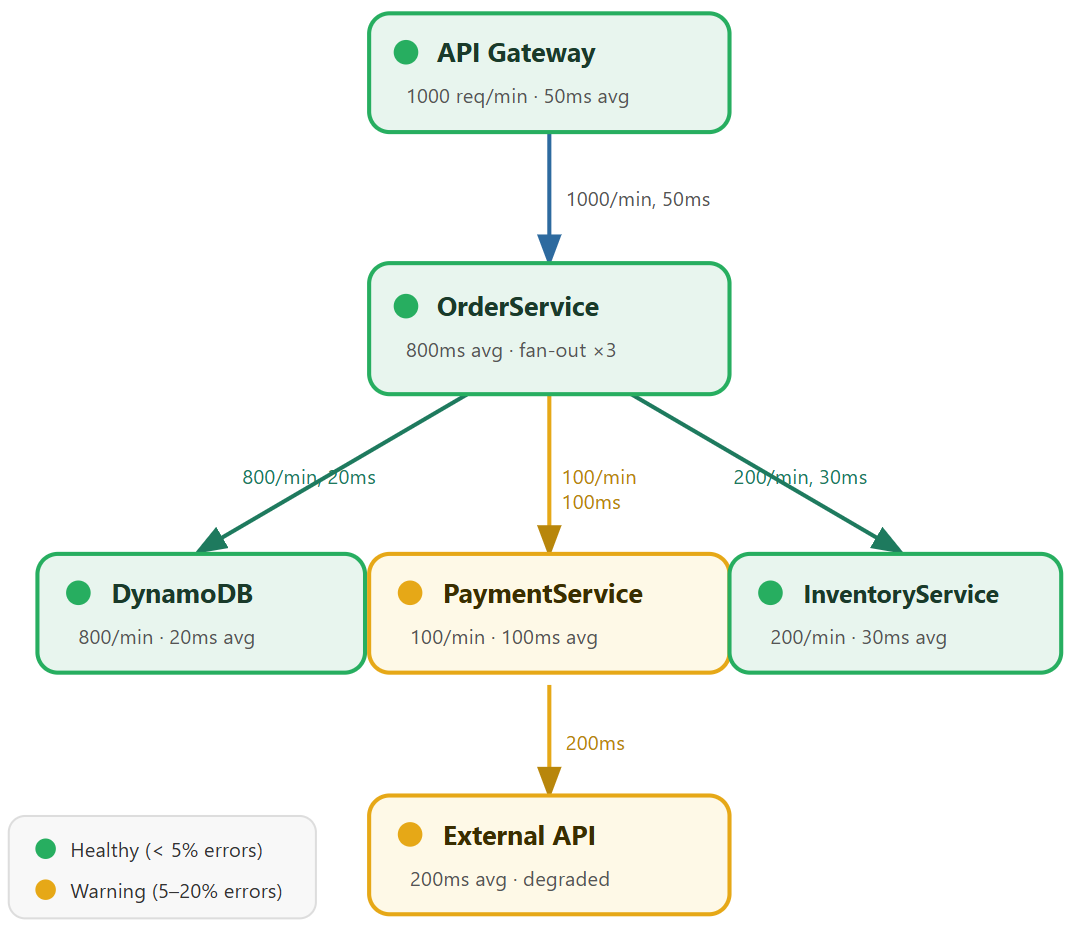
Eine Servicemap lesen


Servicemap mit API Gateway und OrderService, die zu DynamoDB Inventory auffächern, und einem gelben Payment-Service

Überwachung und Fehlersuche in AWS

Kritische-Pfad-Analyse


Kritischer Pfad = längste Kette von Serviceaufrufen

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Summe: 400ms

External API = 50 % der Gesamtlatenz


Was tust du damit?

  • External API ist dein Optimierungsziel
  • Optionen: Caching ergänzen, Timeout + Fallback, SLAs verhandeln

Vergleiche alternativen Pfad:

OrderService -> DynamoDB
Summe: 120ms (schnell)
Überwachung und Fehlersuche in AWS

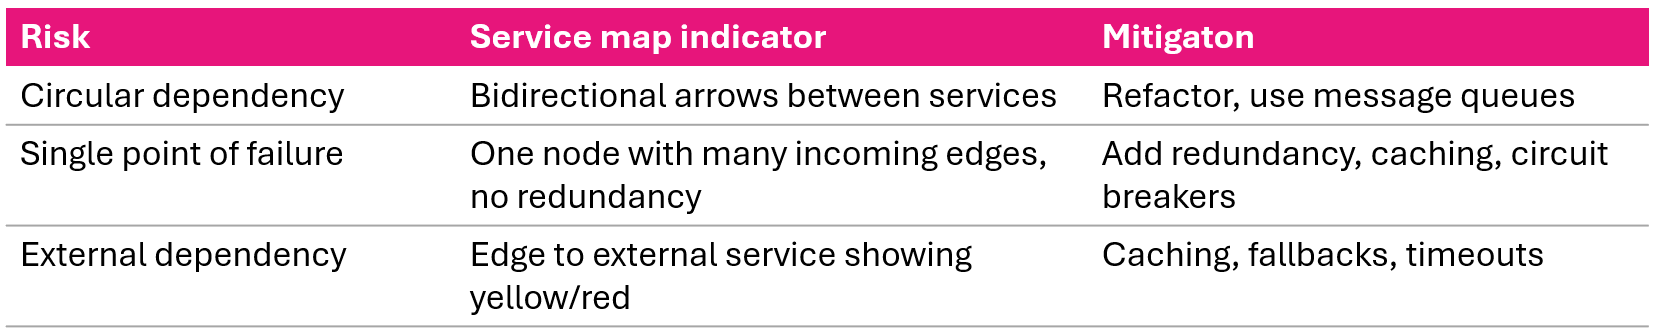
Abhängigkeitsrisiken


Servicemap-Abhängigkeitsrisiken: zirkuläre Abhängigkeiten, Single Points of Failure und riskante externe Abhängigkeiten

Überwachung und Fehlersuche in AWS

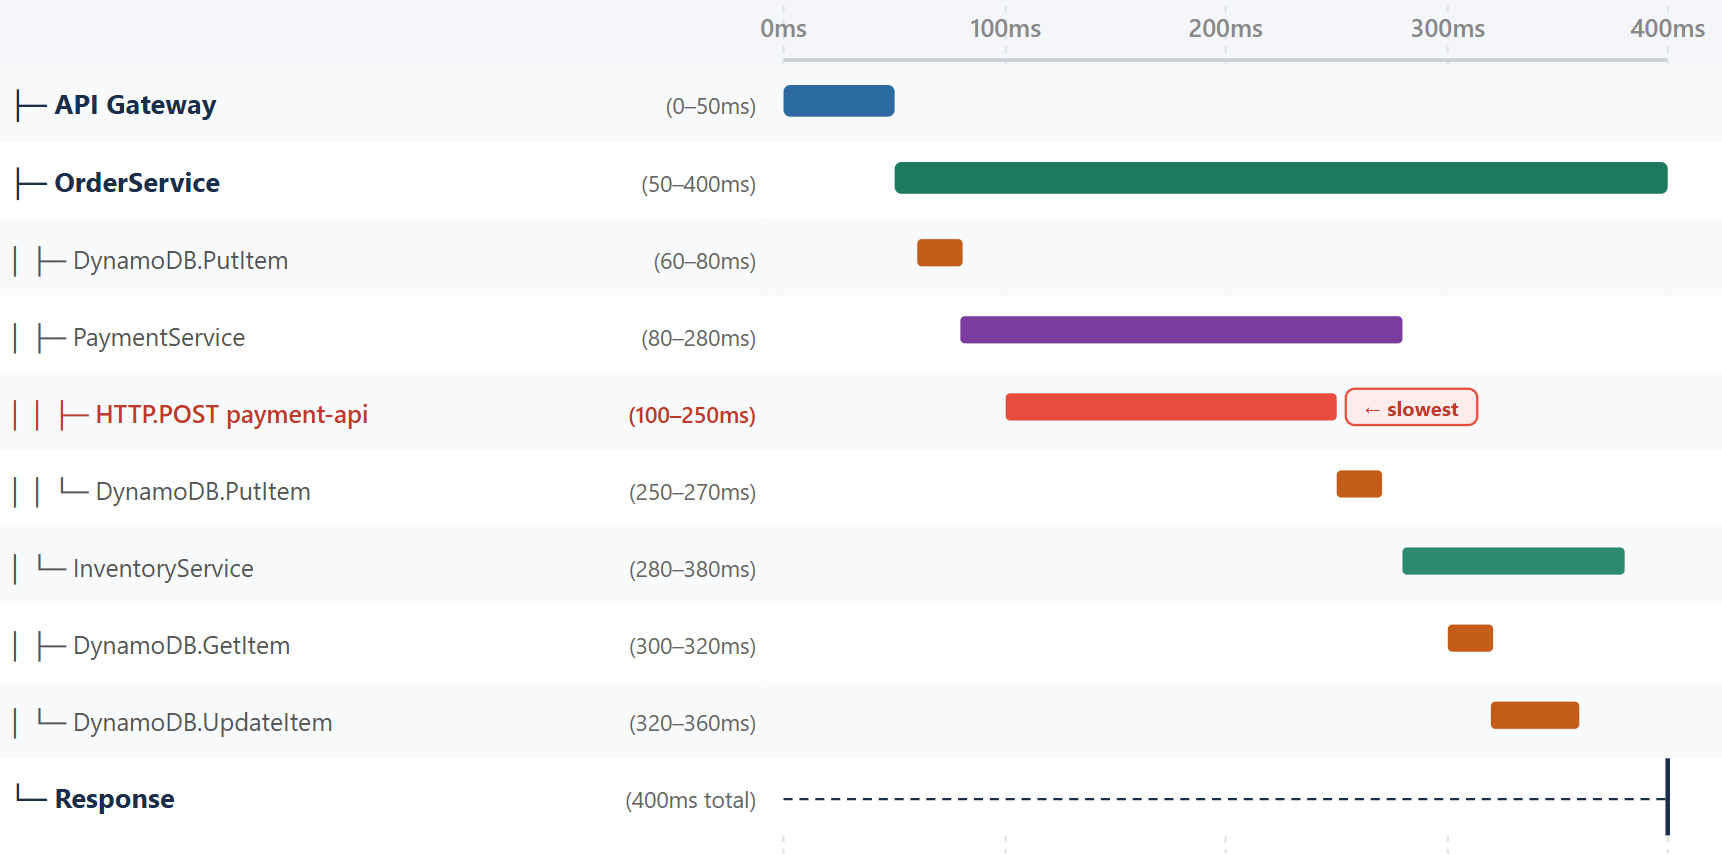
Trace-Zeitachsen verstehen


Trace-Zeitachse mit Subsegmenten entlang der Zeit, wobei ein payment-api-Aufruf die längste Operation ist


  • Horizontale Achse Zeit: wann Operationen starteten und wie lange sie dauerten
  • Vertikale Achse Servicehierarchie: Subsegmente unter Eltern eingerückt
  • HTTP.POST zur payment-api (100–250ms) = die längste Einzeloperation
Überwachung und Fehlersuche in AWS

Muster 1: Sequenzielle Engpässe


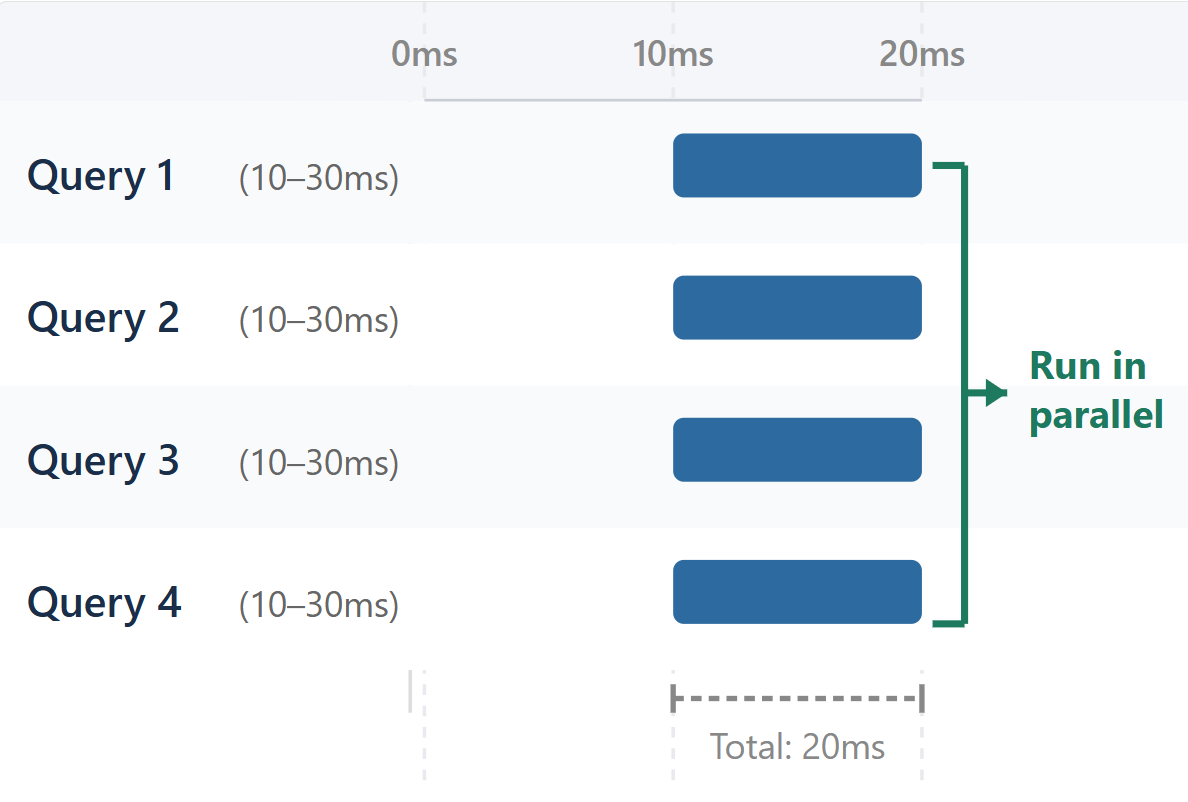
Vorher (sequenziell – 80ms):

Query 1 (10-30ms)
         -> Query 2 (30-50ms)
                  -> Query 3 (50-70ms)
                           -> Query 4 (70-90ms)


Nachher (parallel – 20ms):

Trace-Zeitachse von vier parallelen Queries, überlappend und in 20ms fertig

Überwachung und Fehlersuche in AWS

Muster 2: N+1-Queries und geschwätzige Services


N+1-Query-Problem:

Get user list       (10-20ms)
Get user 1 details  (20-30ms)
Get user 2 details  (30-40ms)
... ×100 sequenzielle Queries

Lösung: Batching, Eager Loading


Geschwätzige Services:

  • 50 kleine Aufrufe zwischen zwei Services statt 1 Batch
  • Jeder Aufruf: Verbindungsaufbau + Serialisierung + Roundtrip
  • 50× Overhead

Lösung: Batch-Requests, Message-Queues, Caching

Überwachung und Fehlersuche in AWS

Muster 3: Cold Starts und kaskadierende Ausfälle
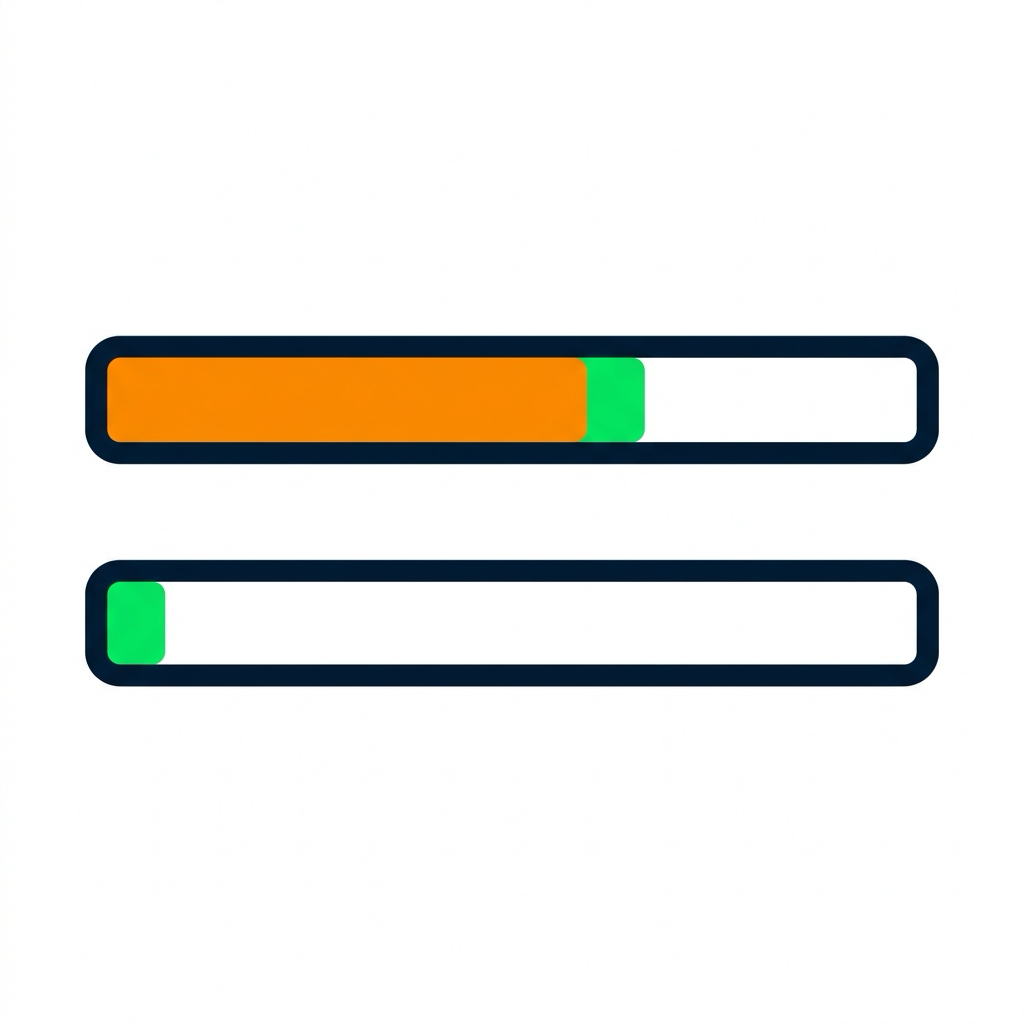
 

Zwei Zeitbalken: Cold Start mit großem orangefarbenen Initialisierungsblock und kleinem grünen Handler; Warm Start nur kleiner grüner Handler

Lambda-Cold-Start:

  • Cold: 3000ms (2500ms Init + 500ms Handler)
  • Warm: 500ms (nur Handler)
  • Sichtbar als großes Init-Segment beim ersten Aufruf

Lösung: Provisioned Concurrency, Initialisierung optimieren


Kaskadierender Ausfall:

Service A [Error]
  -> Service B [Timeout 5s]
    -> Service C [Timeout 5s]
      -> Database [Timeout 5s]

Passende Timeout-Blöcke gestapelt durch die Trace-Hierarchie

Lösung: Timeouts, Circuit Breaker, Fallbacks

Überwachung und Fehlersuche in AWS

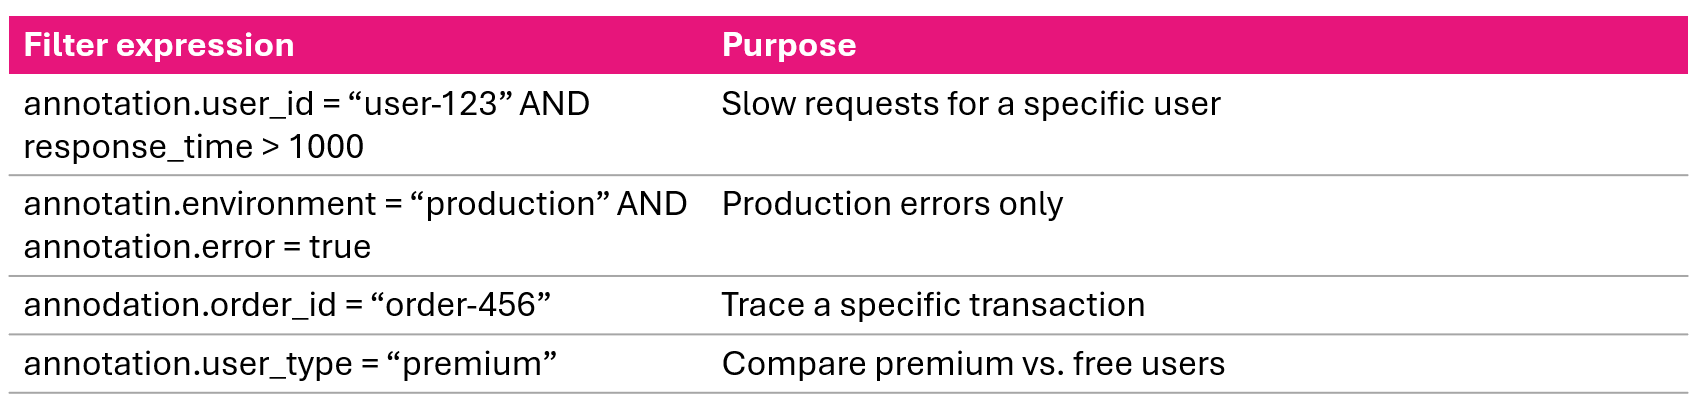
Traces mit Annotationen filtern

X-Ray-Konsole filtert Traces nach Annotation-Key-Value-Paaren

Gruppen vergleichen:

  • Premium-User Ø 200ms vs. Free-User Ø 150ms → Premium-Features erhöhen Latenz
  • EU West 3× langsamer als US East → regionsübergreifender Datenzugriff
Überwachung und Fehlersuche in AWS

Trace-Analyse-Workflow


  1. Identifizieren – filtern: response_time > 1000ms, nach Dauer sortieren
  2. Analysieren – längste Operationen, sequenzielle Engpässe, Parallelisierungs-Chancen
  3. Annotieren – Annotationen für Business-Kontext prüfen: User-ID, Order-ID, Umgebung
  4. Prüfen – Metadaten ansehen: Request-Details, Fehlermeldungen
  5. Korrelieren – mit CloudWatch Logs abgleichen
  6. Diagnostizieren – Ursache: langsame Query, Timeout, Algorithmus, Ressourcenengpass
  7. Beheben – Code optimieren, cachen, parallelisieren, skalieren
  8. Verifizieren – Vorher/Nachher-Traces vergleichen, Latenz und Fehlerraten monitoren
Überwachung und Fehlersuche in AWS

Alerts aus X-Ray-Daten erstellen


# Alarm für hohe Latenz
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# Alarm für viele Fehler
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
Überwachung und Fehlersuche in AWS

Videozusammenfassung


  • Servicemaps – automatisch erzeugte Architekturgrafiken: Knoten (Services), Kanten (Verbindungen), farbcodierte Gesundheit
  • Farbcodierung – grün (Erfolg), gelb (4xx), rot (5xx-Fehler), lila (429), grau (kein Traffic)
  • Kritischer Pfad – längste Aufrufkette, zeigt dein Optimierungsziel
  • Trace-Zeitachsen – zeigen sequenzielle Engpässe, N+1-Queries, Cold Starts, kaskadierende Ausfälle
  • Annotationen – Traces nach Business-Kontext filtern und gruppieren
  • Workflow – acht Schritte: identifizieren → analysieren → annotieren → prüfen → korrelieren → diagnostizieren → beheben → verifizieren
Überwachung und Fehlersuche in AWS

Traces und Servicemaps analysieren

Überwachung und Fehlersuche in AWS

Preparing Video For Download...