CloudWatch-Alarme und Benachrichtigungen

Überwachung und Fehlersuche in AWS

John Q. Martin

Principal Consultant

Was sind CloudWatch-Alarme
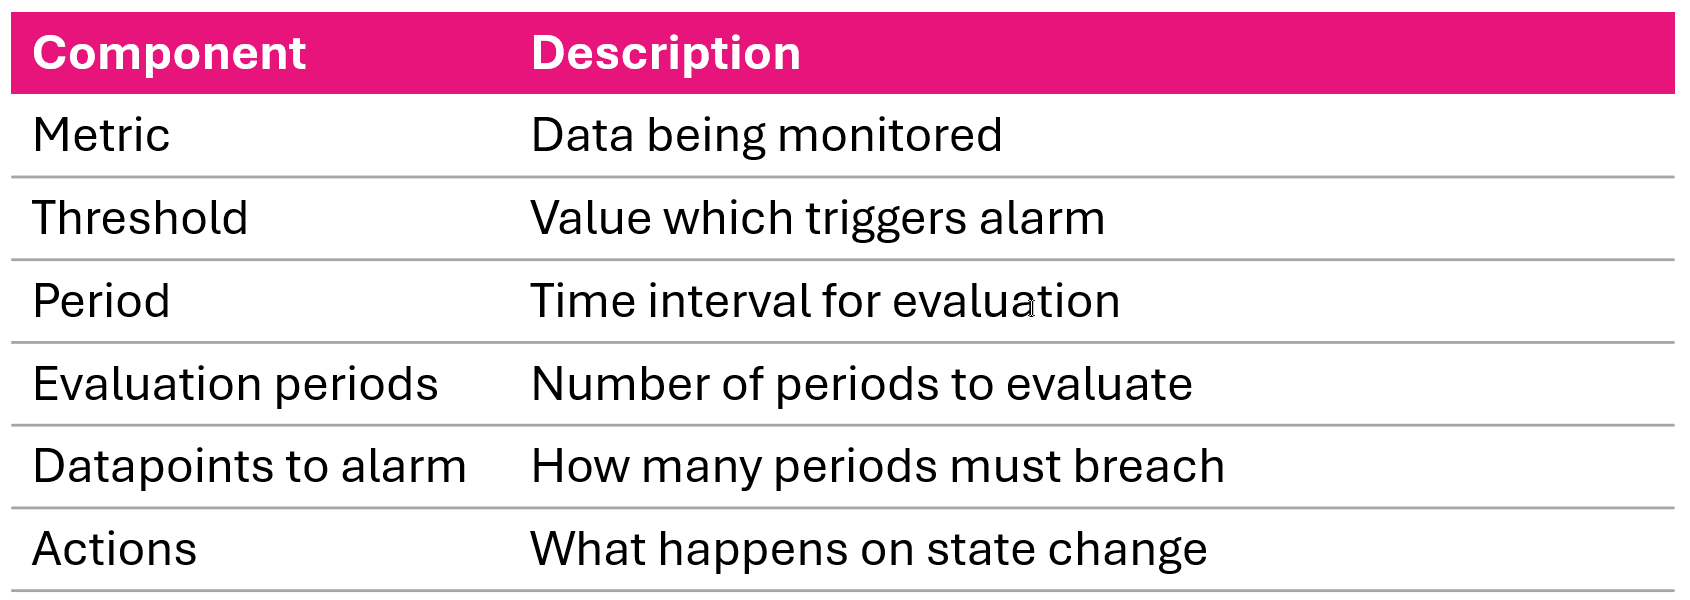
 

Zentrale Konzepte

  • Überwacht eine einzelne Metrik über einen Zeitraum
  • Führt Aktionen aus, wenn die Metrik einen Schwellenwert überschreitet


Sechs zentrale CloudWatch-Alarmkomponenten: Metrik, Schwellenwert, Zeitraum, Auswertungszeiträume, Datapoints to alarm und Aktionen

Überwachung und Fehlersuche in AWS

Alarmzustände

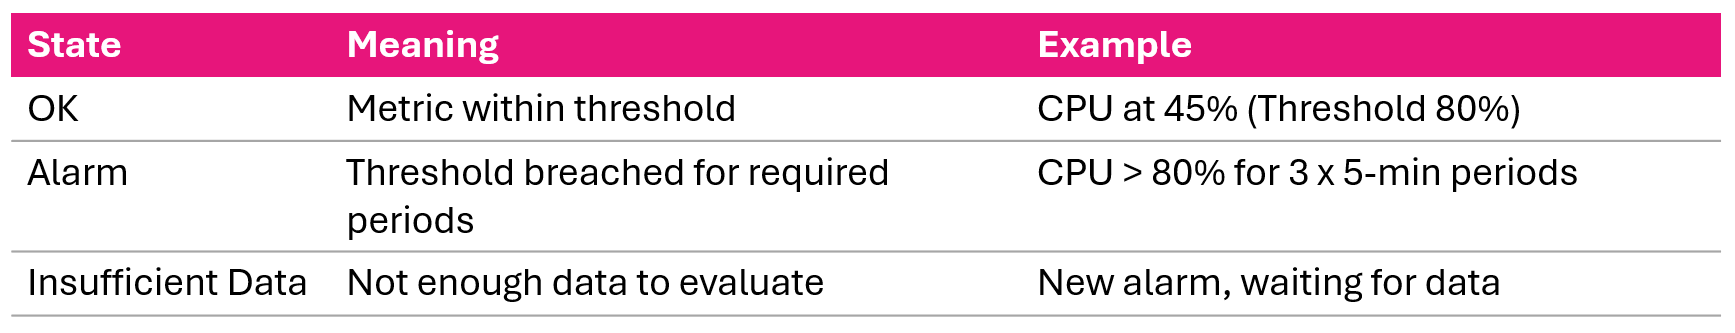
Die drei CloudWatch-Alarmzustände OK, ALARM und INSUFFICIENT_DATA

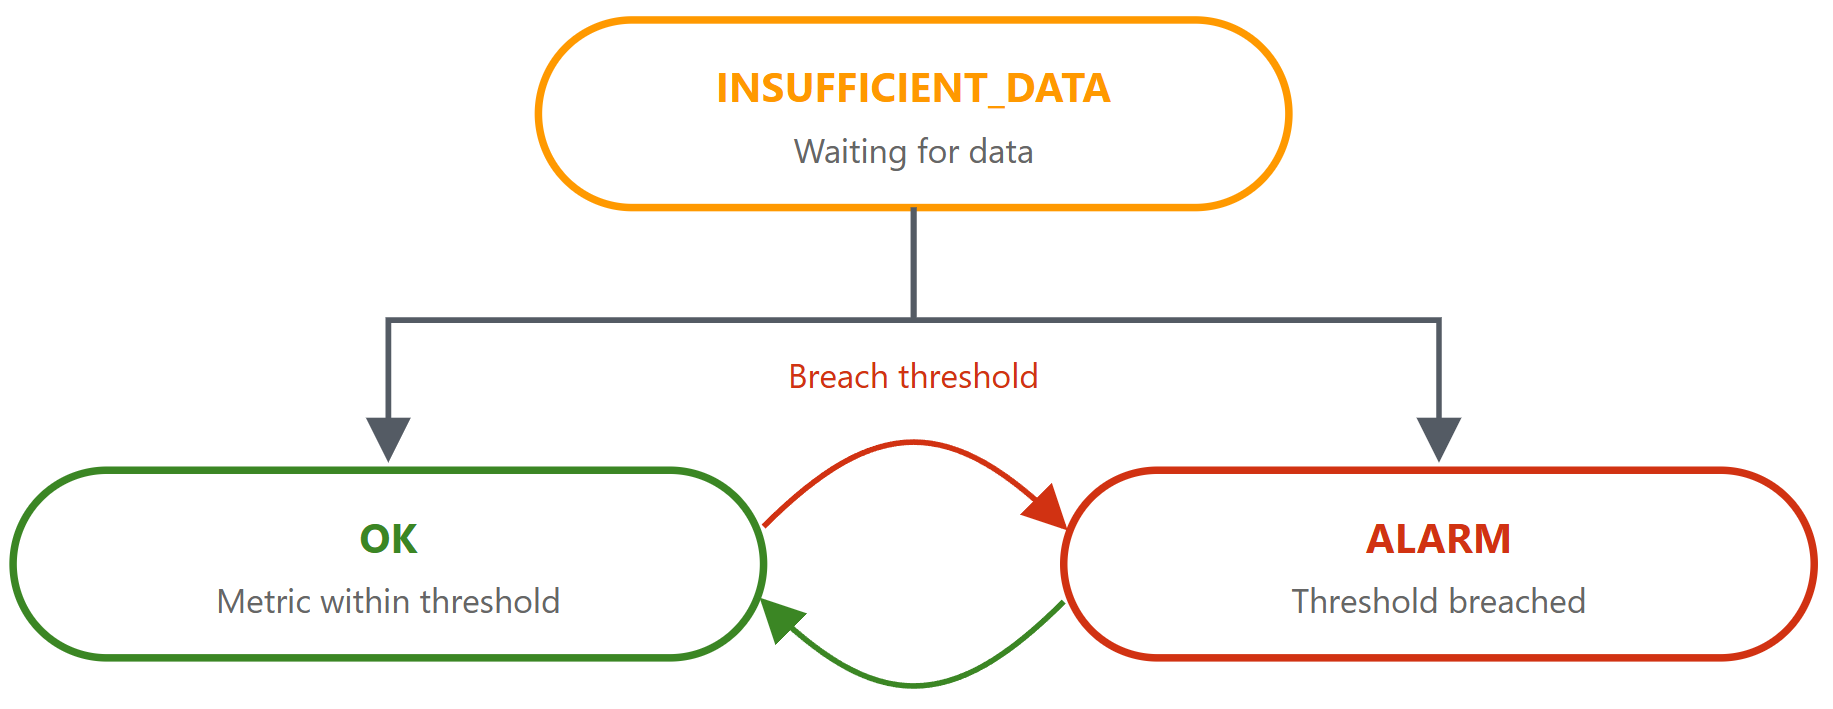
Diagramm: Übergänge eines CloudWatch-Alarms zwischen Zuständen, wenn Metrikdaten eintreffen

Überwachung und Fehlersuche in AWS

Alarmauswertung


  1. Sammle Datenpunkte in definierten Intervallen
  2. Wende Statistik (Average, Sum, Max, Min) über den Zeitraum an
  3. Vergleiche Ergebnis mit dem Schwellenwert
  4. Zähle verletzte Auswertungszeiträume
  5. Ändere Zustand, wenn „datapoints-to-alarm" erfüllt ist


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Überwachung und Fehlersuche in AWS

Auswertungsstrategien


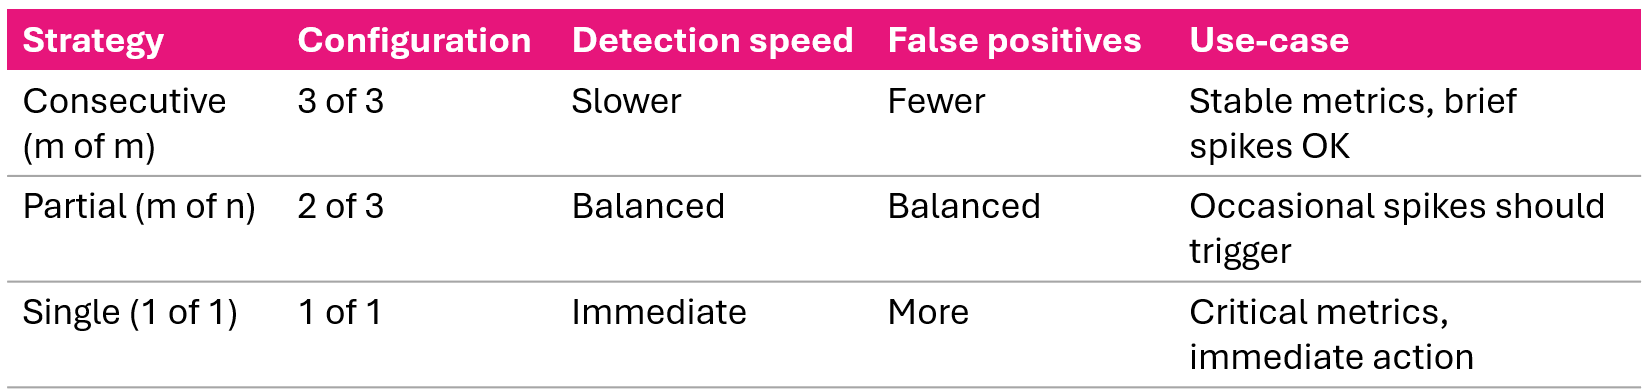
Drei Auswertungsstrategien: aufeinanderfolgend, teilweise und einzelne Verletzung mit Sensitivitätsabstufungen

Überwachung und Fehlersuche in AWS

Alarmaktionen: Typen und Auslöser


Auslösezustände

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Aktionstypen

  • SNS-Benachrichtigung
  • Auto Scaling
  • EC2-Aktion (stop/terminate/reboot/recover)
  • Systems Manager
Überwachung und Fehlersuche in AWS

Verhalten bei fehlenden Daten


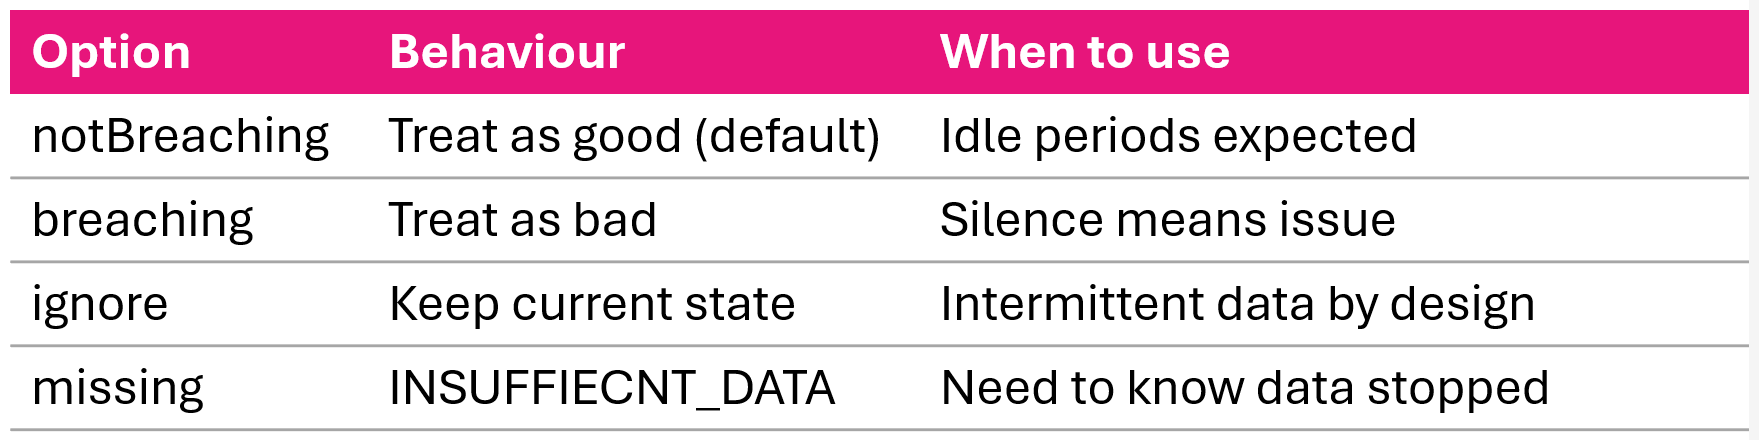
Optionen für das Verhalten bei fehlenden Daten: notBreaching, breaching, ignore und missing

Überwachung und Fehlersuche in AWS

Standardalarm erstellen: AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Überwachung und Fehlersuche in AWS

Verbundalarme: Was und warum

Problem

  • Mehrere verwandte Alarme lösen separat aus = Alarmmüdigkeit

Lösung

  • Alarme mit logischen Operatoren kombinieren

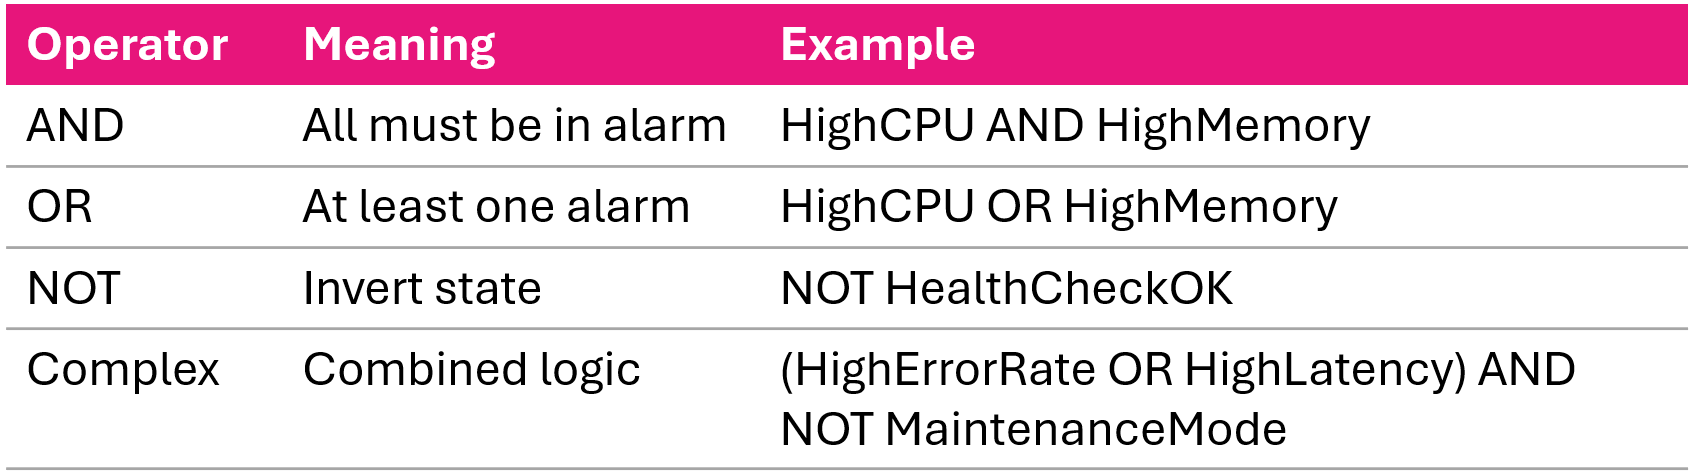
Zusammengesetzte Alarmlogik, kombiniert Kindalarme mit AND-, OR- und NOT-Operatoren

Überwachung und Fehlersuche in AWS

Verbundalarm erstellen: AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Beispiel für eine komplexe Regel
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Überwachung und Fehlersuche in AWS

Strategie zur Schwellenwertwahl

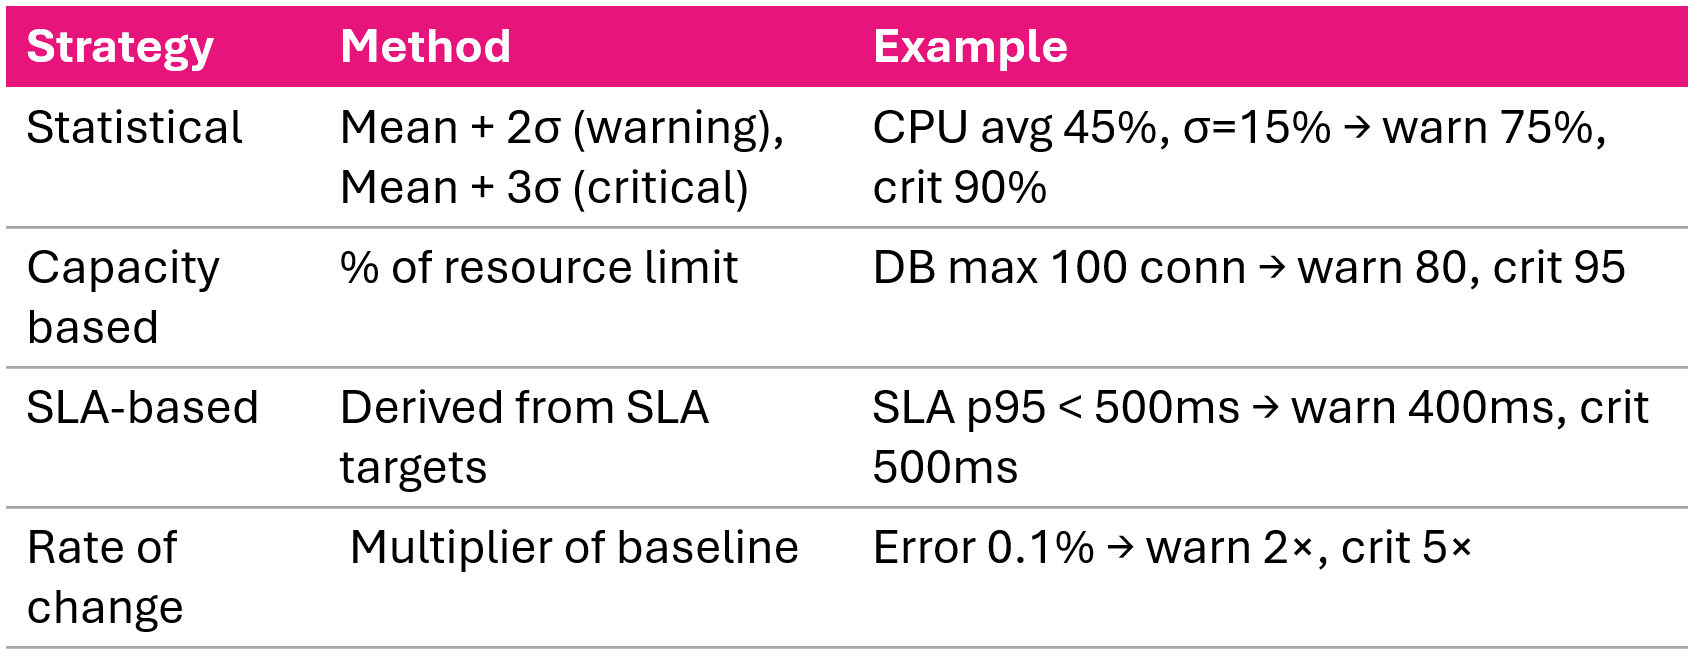
Vier Strategien zur Schwellenwertwahl: Basislinienstreuung, Kapazitätsgrenzen, SLA-Ziele und Änderungsrate

Überwachung und Fehlersuche in AWS

Mehrstufige Alarmstrategie


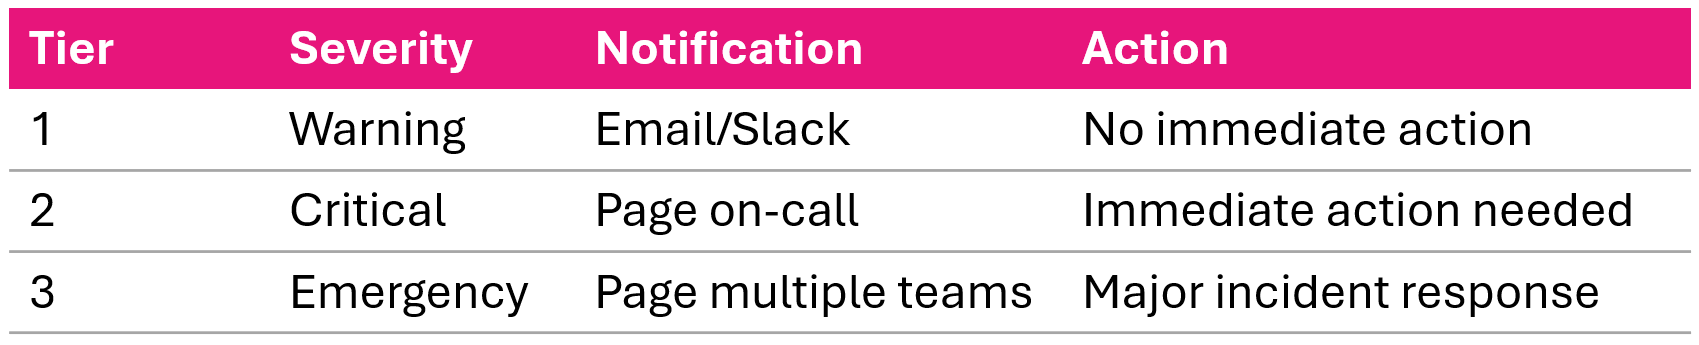
Mehrstufige Alarmreaktion mit Warnung-, Kritisch- und Notfall-Stufen, geroutet zu separaten SNS-Themen

Beispiel: CPU-Warnung bei 75 %, kritisch bei 90 %, jeweils mit unterschiedlichen SNS-Themen

Überwachung und Fehlersuche in AWS

Anomalieerkennungsalarme

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • ML-Modell lernt normales Metrikverhalten
  • Erstellt ein dynamisches Schwellenband (konfigurierbar)
  • Passt sich Tages-/Wochenmustern an
  • Reduziert manuelles Tuning der Schwellenwerte
Überwachung und Fehlersuche in AWS

Ressourcenalarme: Lambda und ALB

Lambda-Alarme
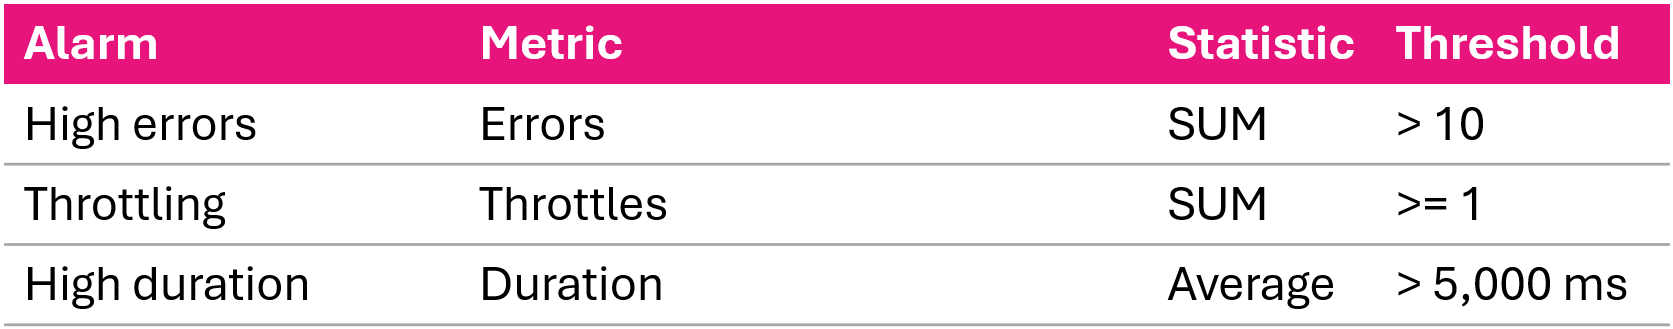
Empfohlene Lambda-Alarme: Fehleranzahl, Throttles und hohe Dauer nahe dem Timeout-Limit

ALB-Alarme

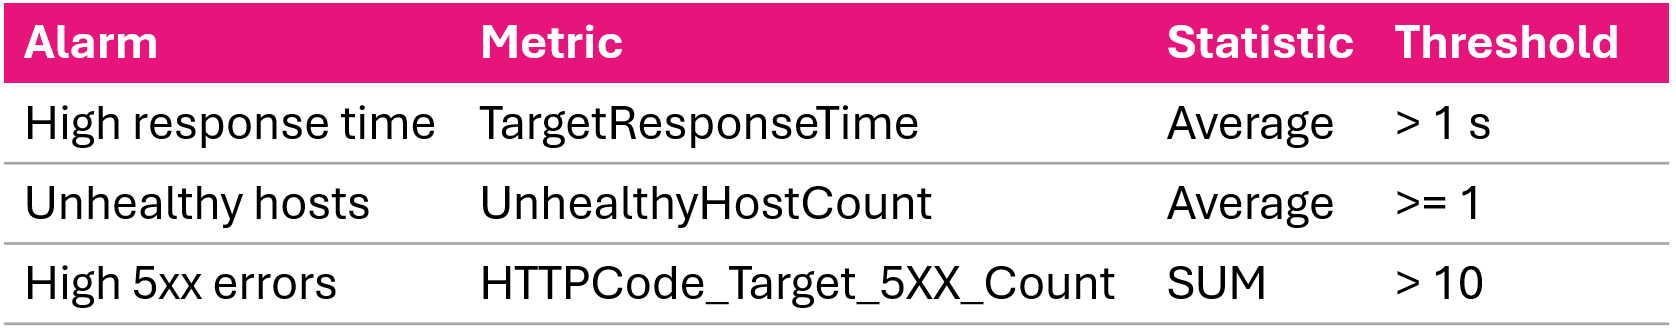
Empfohlene ALB-Alarme: Ziel-Antwortzeit, ungesunde Hosts und 5xx-Fehleranzahl

Überwachung und Fehlersuche in AWS

Empfohlene Praktiken fürs Alarmmanagement

  • Benennung: <Service>-<Metric>-<Resource>-<Severity>
  • Beschreibungen: was überwacht wird, Schwellenwert, Troubleshooting-Tipps, Runbook-Links
  • Tags: Environment, Team, Severity
  • Monatlich prüfen: Schwellen anpassen, Veraltetes entfernen, Aktionen aktualisieren
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Überwachung und Fehlersuche in AWS

Videozusammenfassung

  • Drei Alarmzustände: OK, ALARM, INSUFFICIENT_DATA
  • Auswertungsstrategien: aufeinanderfolgend, teilweise, einzelne Verletzung
  • Verbundalarme kombinieren mehrere Alarme mit AND, OR, NOT
  • Vier Strategien für Schwellenwerte: statistisch, Kapazität, SLA, Änderungsrate
  • Mehrstufiges Alerting: Warnung → kritisch → Notfall
  • Ressourcenalarme für Lambda (Fehler, Throttles, Dauer) und ALB (5xx, Latenz)
Überwachung und Fehlersuche in AWS

Lass uns üben!

Überwachung und Fehlersuche in AWS

Preparing Video For Download...