Logs Insights și analiza jurnalelor
Monitorizare și depanare în AWS

John Q. Martin
Principal Consultant
Structura interogărilor Logs Insights
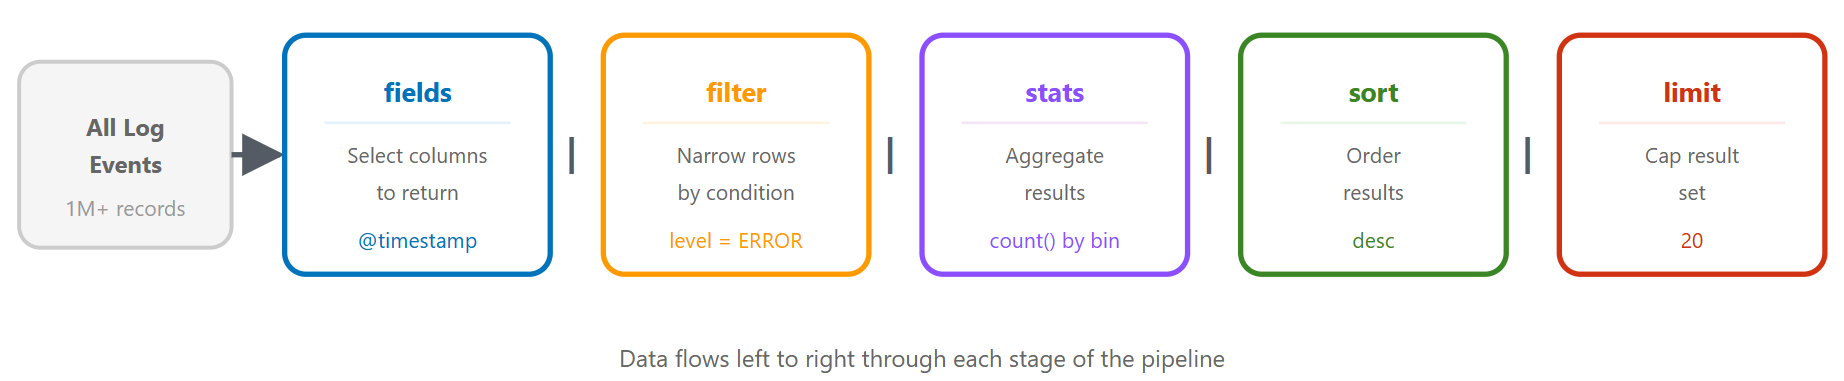
Limbaje de interogare: aceeași interogare, trei moduri
CloudWatch Logs Insights QL
fields @timestamp, @message, level
| filter level = "ERROR"
| filter @timestamp > ago(1h)
| sort @timestamp desc
| limit 20
OpenSearch PPL
source = `/aws/lambda/my-function`
| where level = 'ERROR' and @timestamp > ago(1h)
| fields @timestamp, @message, level
| sort - @timestamp
| head 20
Limbaje de interogare: OpenSearch SQL
OpenSearch SQL
SELECT `@timestamp`, `@message`, level
FROM `/aws/lambda/my-function`
WHERE level = 'ERROR'
  AND `@timestamp` > ago(1h)
ORDER BY `@timestamp` DESC
LIMIT 20
- Sintaxă standard SELECT / FROM / WHERE
- Permite JOINs între grupuri de jurnale
- Alege varianta care se potrivește echipei tale
Scenariul 1: Identificarea vârfurilor de erori
fields @timestamp, @message, level
| filter level = "ERROR"
| stats count() as error_count by bin(5m)
| sort @timestamp desc
Îmbunătățit: grupare după tipul erorii
fields @timestamp, error_type, error_message
| filter level = "ERROR"
| stats count() as count by error_type, bin(5m)
| sort count desc
Scenariul 2: Endpoint-uri API lente
fields @timestamp, endpoint, response_time, status_code
| filter response_time > 1000
| stats avg(response_time) as avg_time,
        max(response_time) as max_time,
        count() as slow_requests
        by endpoint
| sort avg_time desc
Detaliere
fields @timestamp, endpoint, response_time, user_id, request_id
| filter endpoint = "/api/users" and response_time > 1000
| sort response_time desc
| limit 20
Scenariul 3: Autentificare eșuată
fields @timestamp, user_id, ip_address, action
| filter action = "login_failed"
| stats count() as failed_attempts by user_id, ip_address
| sort failed_attempts desc
| limit 50
Analiză temporală
fields @timestamp, user_id, ip_address
| filter action = "login_failed"
| stats count() as attempts by ip_address, bin(1h)
| filter attempts > 10
| sort attempts desc
Scenariile 4 & 5: Timeout-uri de bază de date și scurgeri de memorie
Timeout-uri de bază de date
fields @timestamp, @message
| filter @message like /database/ and @message like /timeout|error|failed/
| parse @message "timeout after * seconds" as timeout_duration
| stats count() as timeout_count,
        avg(timeout_duration) as avg_timeout
        by bin(5m)
Detectarea scurgerilor de memorie
fields @timestamp, memory_used_mb, heap_size_mb
| stats avg(memory_used_mb) as avg_memory,
        max(memory_used_mb) as max_memory
        by bin(1h)
| sort @timestamp asc
Scenariul 6: Trasarea cererilor
fields @timestamp, @message, request_id, service, action
| filter request_id = "abc123def456"
| sort @timestamp asc
Trasare multi-serviciu
fields @timestamp, service, action, duration_ms, status
| filter request_id = "abc123def456"
| sort @timestamp asc
| display @timestamp, service, action, duration_ms, status
Tehnici avansate: parse și Regex
Parsarea jurnalelor nestructurate
fields @timestamp, @message
| parse @message "[*] User * failed to access resource * from IP *"
    as level, user, resource, ip
Parsare cu Regex
| parse @message /Request completed in (?<duration>\d+)ms with status (?<status>\d+)/
Tehnici avansate: câmpuri calculate
fields @timestamp, requests, errors
| fields error_rate = (errors / requests) * 100

fields @timestamp, status_code
| fields status_category =
    case(status_code < 300, "success",
         status_code < 500, "client_error",
         status_code >= 500, "server_error")
| stats count() as request_count by status_category
Optimizarea interogărilor
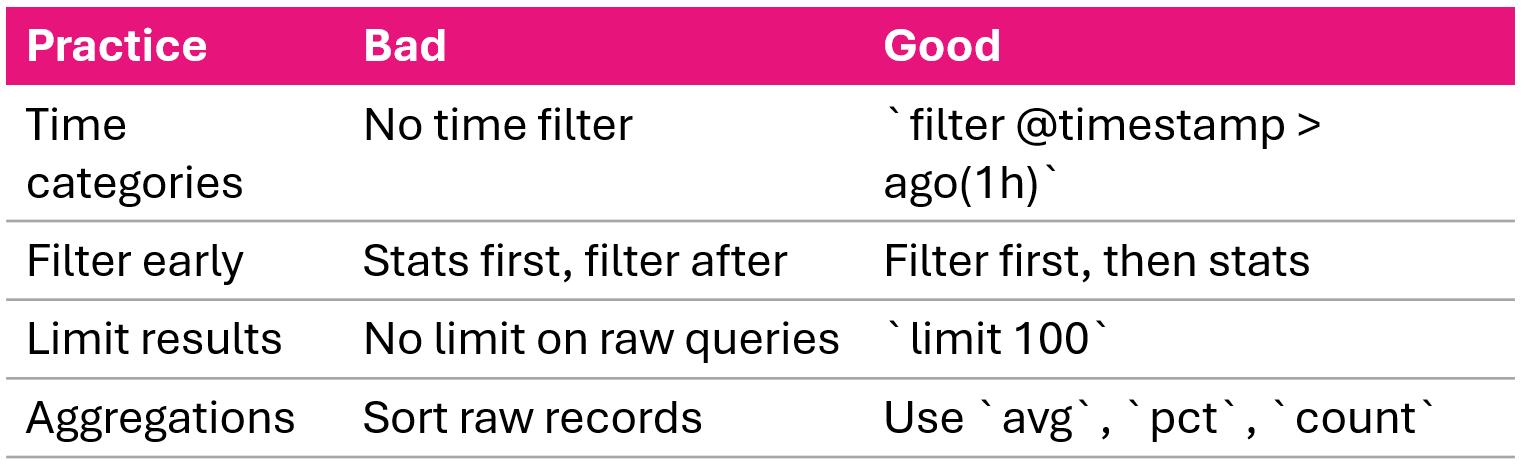
Detectarea anomaliilor și corelarea datelor
Detectarea anomaliilor statistice
- Calculează linia de bază: medie și abatere standard pe 7 zile
- Compară perioada curentă cu linia de bază
- Marchează valorile > 2 abateri standard ca anomalii
Corelarea ratei de erori
fields @timestamp, level
| stats count() as total_requests,
        sum(case(level = "ERROR", 1, 0)) as errors
        by bin(5m)
| fields error_rate = (errors / total_requests) * 100
Rezumat
- CloudWatch Logs Insights: serviciu interactiv de interogare, fără infrastructură proprie
- Trei limbaje de interogare: Logs Insights QL, OpenSearch PPL, OpenSearch SQL
- Șase scenarii de depanare: vârfuri de erori, endpoint-uri lente, autentificare eșuată, timeout-uri DB, scurgeri de memorie, trasarea cererilor
- Tehnici avansate:
parsepentru text nestructurat,bin()pentru serii de timp,pct()pentru percentile - Corelarea și detectarea anomaliilor: analiza ratei de erori, compararea cu linia de bază statistică
- De la investigare la automatizare: filtrele de metrici și alarmele închid bucla
Hai să exersăm!
Monitorizare și depanare în AWS

