Dashboarduri de sănătate a aplicațiilor

Monitorizare și depanare în AWS

John Q. Martin

Principal Consultant

Design dashboard: ierarhia informațiilor
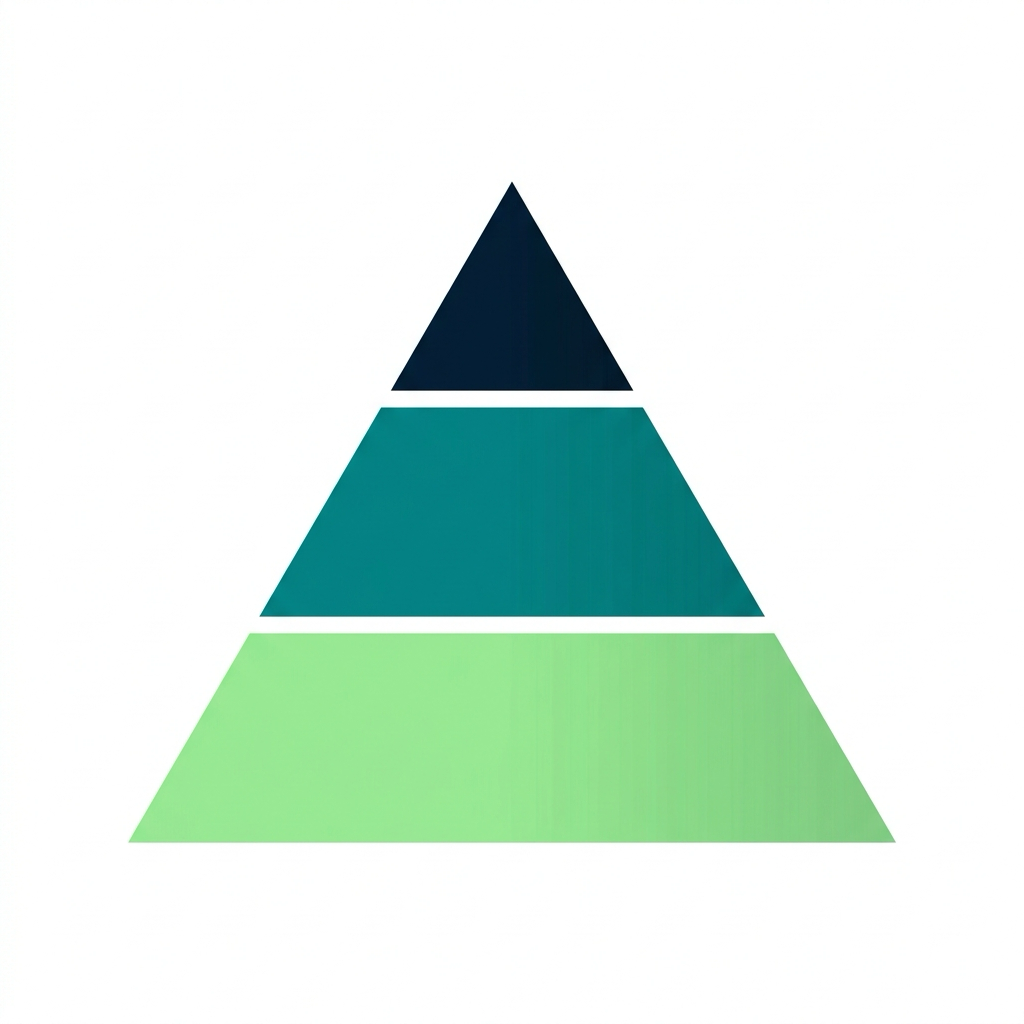
 

Piramidă pe trei niveluri: un vârf îngust și întunecat, un nivel mijlociu teal și o bază largă verde

Ca într-un spital: recepție → secție → specialist


Sus - Rezumat executiv

  • Starea generală a sistemului
  • Metrici cheie, SLA, incidente active

Mijloc - Sănătatea serviciilor

  • Rate de erori, percentile de latență, debit

Jos - Diagnostice detaliate

  • Trace-uri, loguri, utilizarea resurselor, starea dependențelor
Monitorizare și depanare în AWS

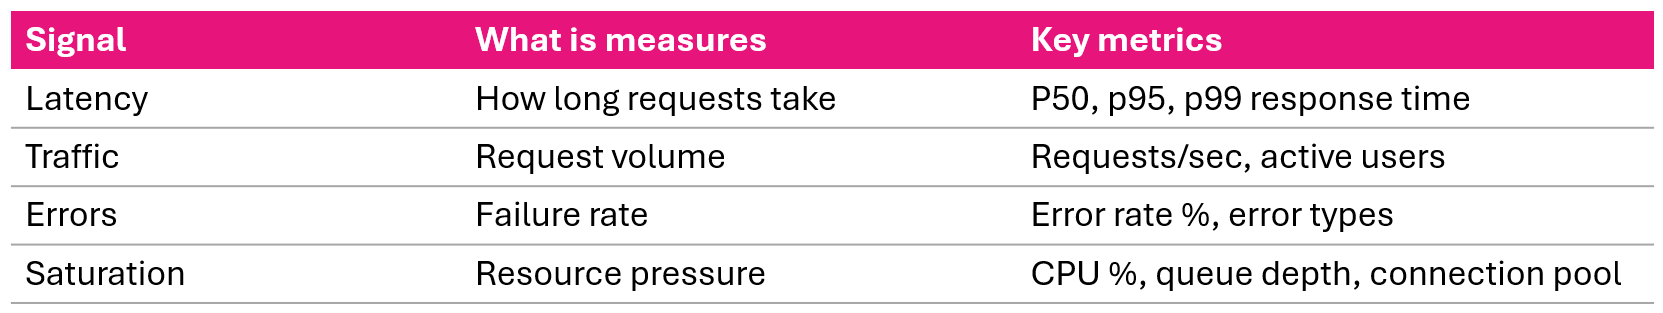
Cele patru semnale de aur


Cele patru semnale de aur ale monitorizării: latență, trafic, erori și saturație

Acestea patru acoperă marea majoritate a problemelor pe care le vei întâlni.

Monitorizare și depanare în AWS

Metoda RED


RED pentru servicii bazate pe cereri:
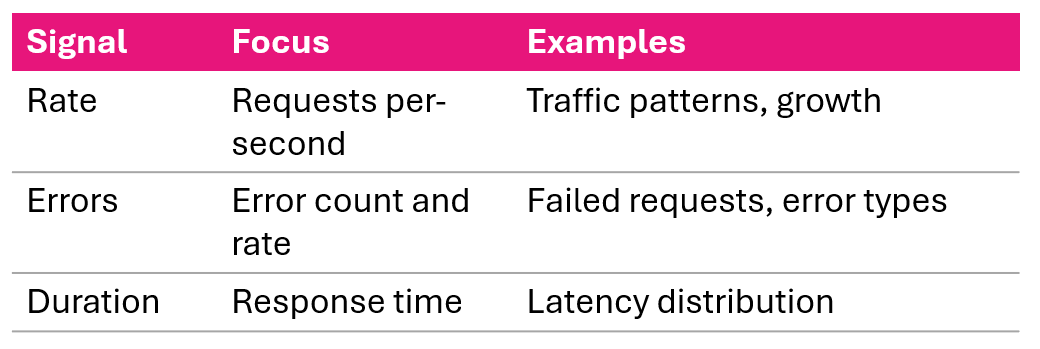
Modelul RED cu rată, erori și durată pentru servicii bazate pe cereri


Relația cu semnalele de aur:

  • RED este un subset al celor patru semnale de aur
  • Conceput pentru servicii care procesează cereri ale utilizatorilor
  • Saturația (al 4-lea semnal de aur) se adaugă pentru monitorizarea infrastructurii

Folosește RED ca punct de plecare și adaugă saturația pentru diagnostice aprofundate.

Monitorizare și depanare în AWS

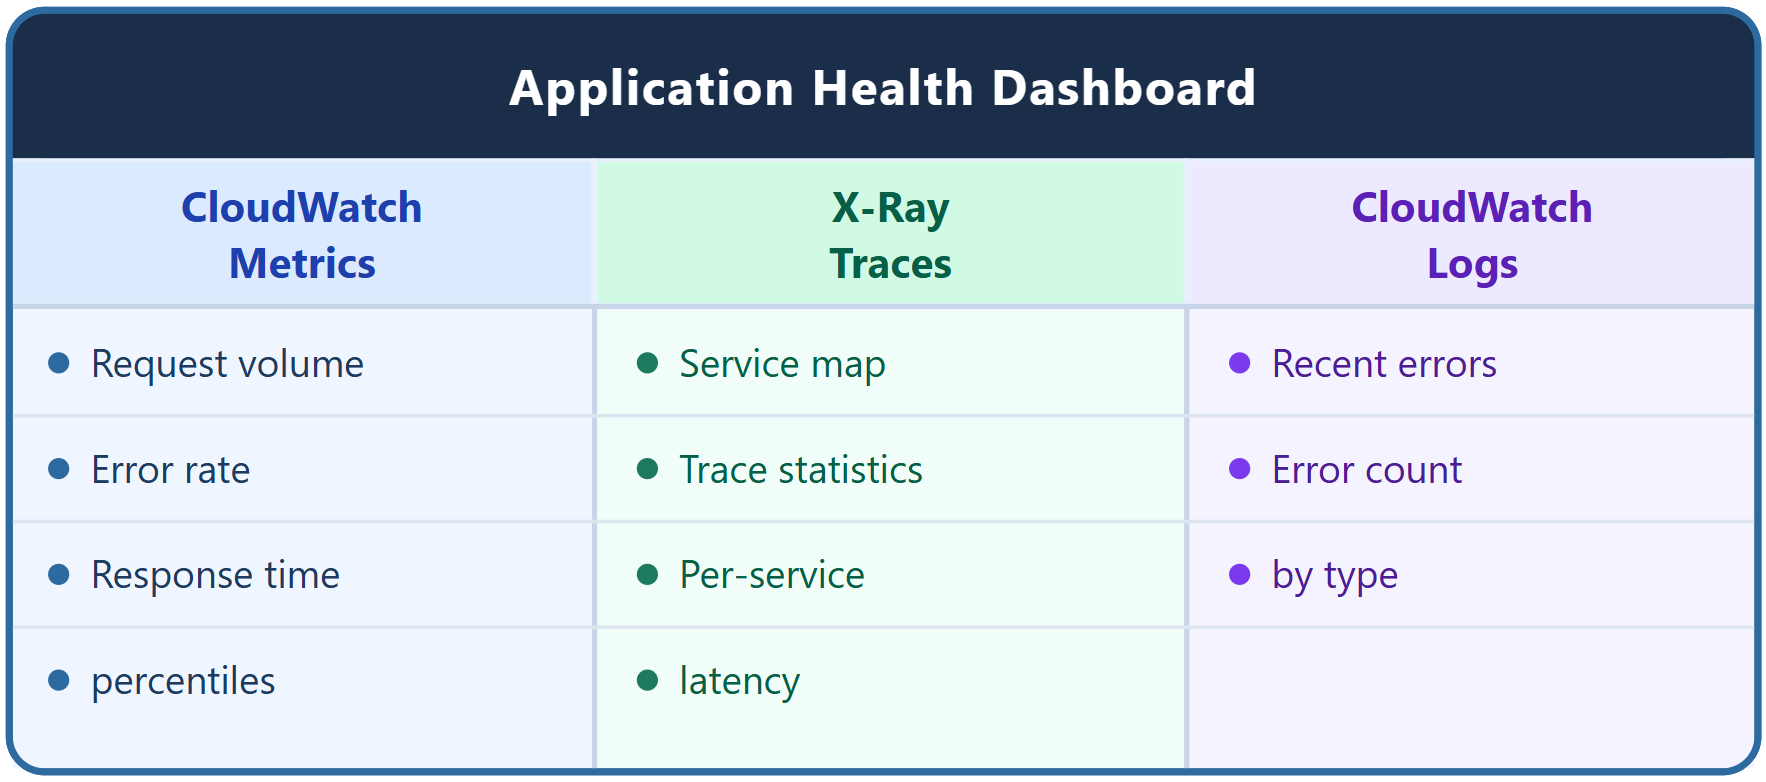
Trei surse de date


Diagramă cu trei surse de date pentru dashboard: metrici CloudWatch, trace-uri X-Ray și CloudWatch Logs

Monitorizare și depanare în AWS

Widget-uri de metrici CloudWatch

Volumul de cereri:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

Rata de erori (calcul metric):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

Percentile timp de răspuns:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • Volumul cererilor din ALB RequestCount
  • Rata de erori folosește calcul metric - erori / invocații x 100
  • Timp de răspuns ca percentile p50, p95, p99
Monitorizare și depanare în AWS

Widget-uri X-Ray și loguri


Widget-uri X-Ray:

  • Hartă servicii - topologia aplicației cu indicatori de sănătate
  • Statistici trace - timp mediu de răspuns, rată erori, rată defecte
  • Latență serviciu - comparație timp de răspuns per serviciu


Widget-uri CloudWatch Logs:

Interogare erori recente:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

Număr erori pe tip:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
Monitorizare și depanare în AWS

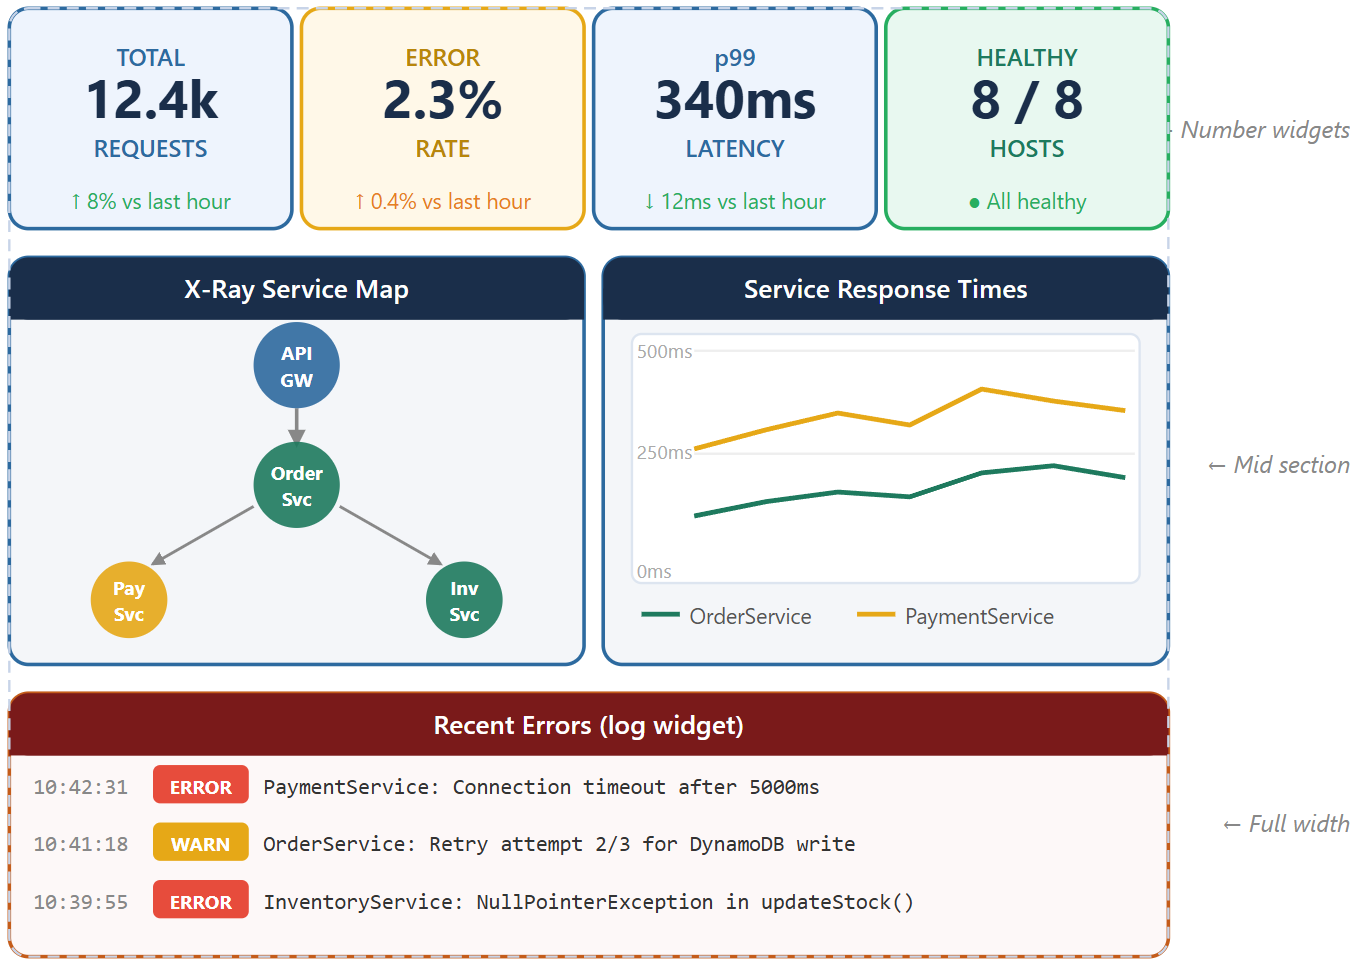
Layout complet al dashboardului


Layout dashboard de sănătate cu widget-uri rezumat sus, hartă servicii la mijloc și loguri de erori jos

Monitorizare și depanare în AWS

Flux de lucru pentru rezolvarea incidentelor
 

Clipboard de triaj la urgențe cu benzi colorate de prioritate și un stetoscop

Ca la triaj: stabilizare → diagnostic → tratament → verificare

  1. Identificare - indicatori roșii/galbeni, vârfuri de erori
  2. Delimitare - ce servicii? când? se agravează?
  3. Corelare - erori + latență, trafic + resurse
  4. Aprofundare - hartă servicii → trace-uri → loguri
  5. Cauza principală - dependință, BD, memorie, configurație
  6. Remediere - circuit breaker, scalare, rollback, failover
  7. Verificare - rată erori normală, hartă verde, alarme inactive
Monitorizare și depanare în AWS

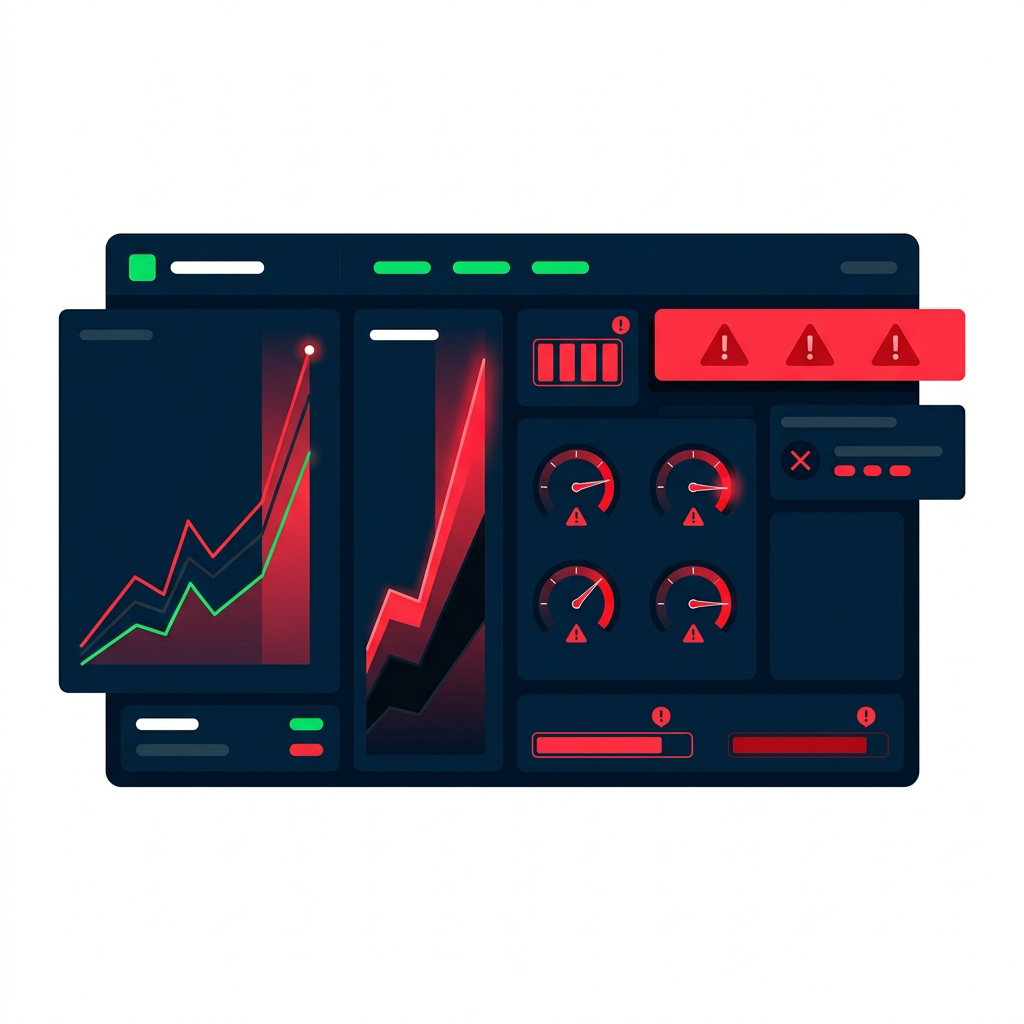
Scenariul 1: vârf brusc de trafic

Dashboard de monitorizare în timpul unui vârf de trafic: grafice liniare în creștere bruscă, indicatoare în zona roșie, bannere de alertă roșii

Ce vezi pe dashboard:

  • Volum cereri de 10× față de normal
  • Rată erori 25%
  • Latență 3000ms
  • CPU 95%

Analiză: Resursele sunt depășite de vârful de trafic


Acțiuni:

  • Scalare imediată
  • Activare auto-scalare
  • Implementare rate limiting
  • Adaugă caching pentru a reduce presiunea pe backend
Monitorizare și depanare în AWS

Scenariul 2: blocaj la baza de date

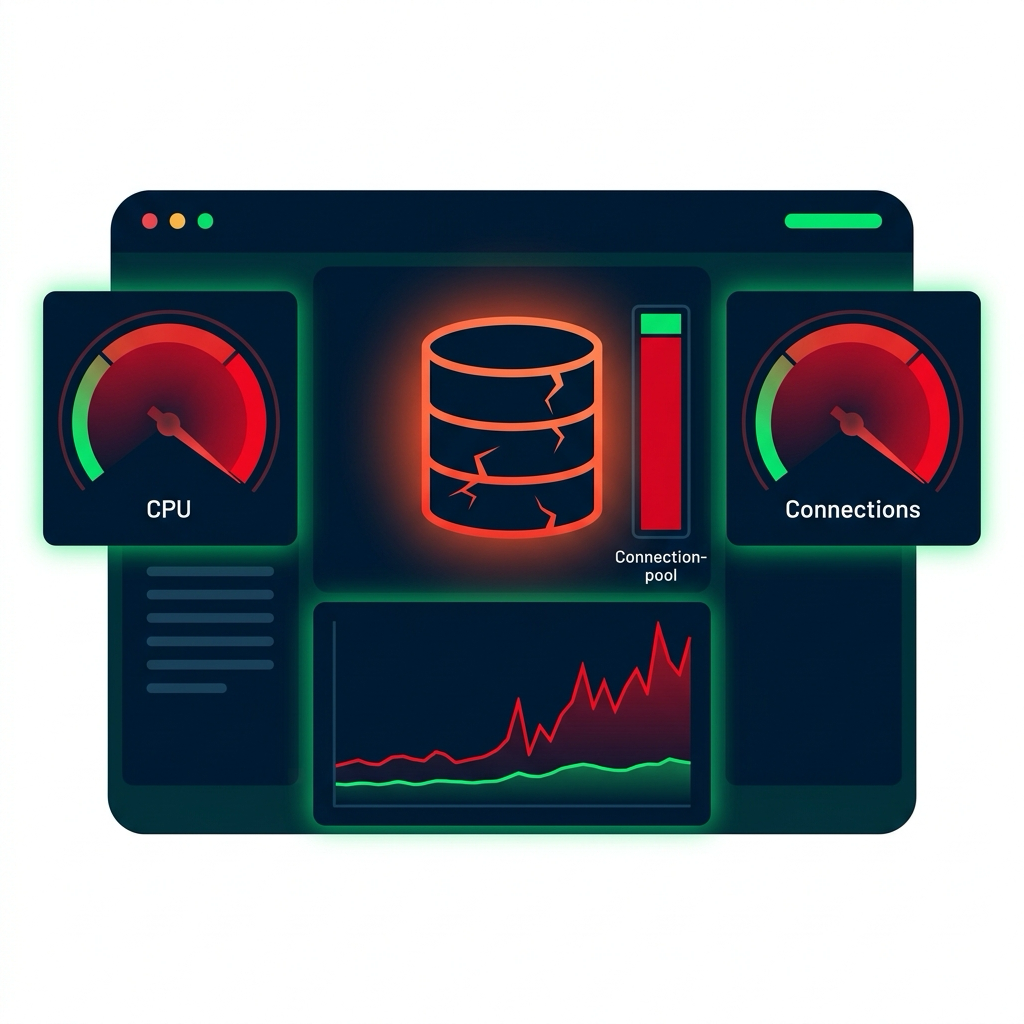
Dashboard de monitorizare cu blocaj la baza de date: iconiță de bază de date crăpată în roșu, indicatoare CPU și conexiuni la maximum, grafic de latență interogări în creștere abruptă, pool de conexiuni aproape plin

Ce vezi pe dashboard:

  • CPU bază de date 95%
  • Conexiuni BD 95/100
  • Latență interogări 5000ms
  • Latență aplicație 5500ms

Analiză: Baza de date este blocajul – interogările lente epuizează pool-ul de conexiuni


Acțiuni:

  • Identifică interogările lente în loguri
  • Adaugă indecși, optimizează interogările
  • Mărește dimensiunea pool-ului de conexiuni
  • Scalează baza de date
Monitorizare și depanare în AWS

Scenariul 3: eșec în cascadă


Ce vezi pe harta serviciilor:
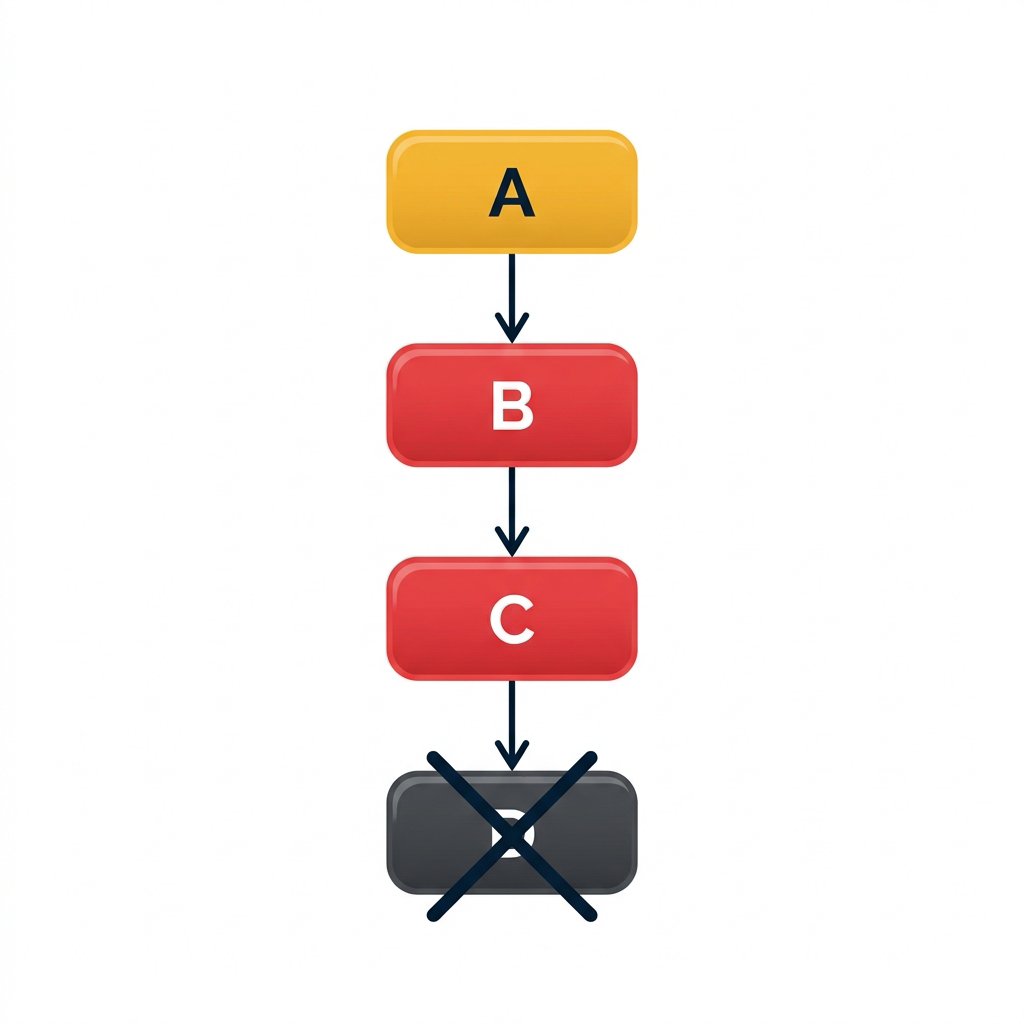
Cascadă pe harta serviciilor: nodul A în chihlimbar cu erori client, B și C în roșu cu defecte server, D întunecat și complet oprit, săgeți în josul lanțului


Analiză:

O problemă minoră în Serviciul A s-a propagat în lanțul de dependențe

Acțiuni:

  • Circuit breakere pentru a opri cascada
  • Timeout-uri la fiecare nivel de serviciu
  • Mecanisme de fallback pentru dependențele eșuate
  • Rezolvarea cauzei principale în Serviciul A
Monitorizare și depanare în AWS

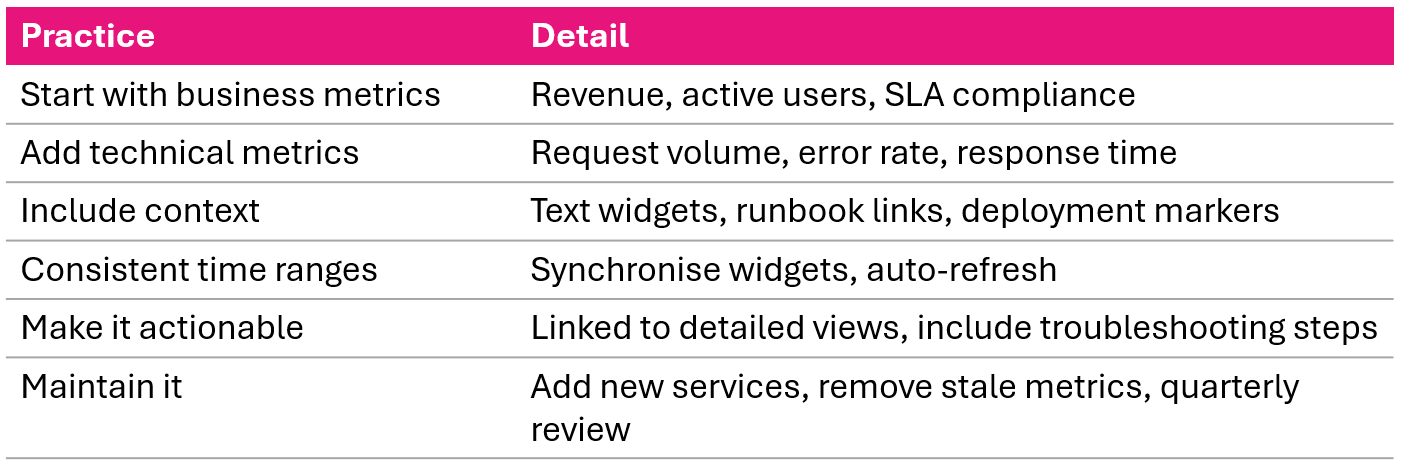
Bune practici pentru dashboarduri


Șase bune practici recomandate pentru dashboarduri de sănătate a aplicațiilor

Monitorizare și depanare în AWS

Rezumat video și finalizarea cursului

  • Proiectează folosind ierarhia informațiilor și cele patru semnale de aur
  • Combină metrici CloudWatch, trace-uri X-Ray și loguri într-o singură vizualizare
  • Flux de incidente în șapte pași: identificare → delimitare → corelare → aprofundare → cauza principală → remediere → verificare

Acum poți:

  • Monitoriza cu metrici CloudWatch, loguri și dashboarduri
  • Configura alarme și notificări cu SNS și SQS
  • Implementa trasare distribuită cu X-Ray
  • Construi dashboarduri de sănătate a aplicațiilor pentru excelență operațională
Monitorizare și depanare în AWS

Dashboarduri de sănătate a aplicațiilor

Monitorizare și depanare în AWS

Preparing Video For Download...