Analiza urmelor și hărților de servicii
Monitorizare și depanare în AWS

John Q. Martin
Principal Consultant
Ce este o hartă de servicii?
Generat automat din datele urmelor: fără configurare manuală
Dintr-o privire: verde = la timp · portocaliu = întârziat · roșu = oprit
Codificarea culorilor pe harta de servicii
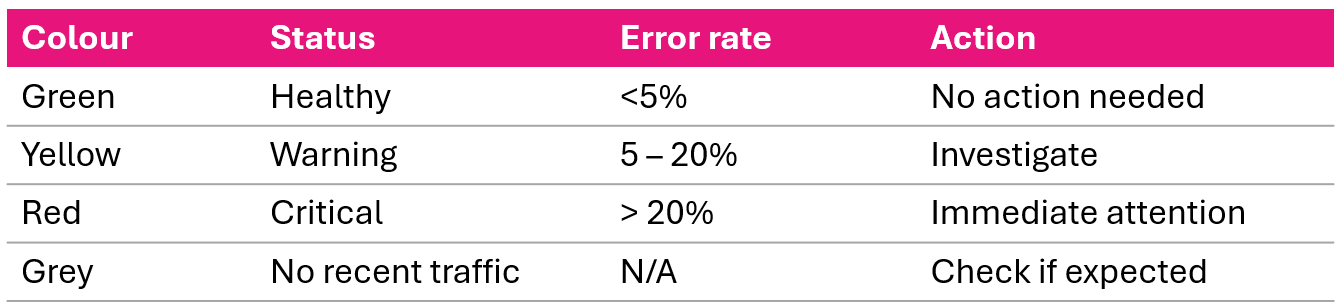
Când deschizi o hartă de servicii, îndreaptă-te direct spre tot ce nu este verde.
Apasă orice nod pentru a vedea: distribuția timpului de răspuns, defalcarea statusurilor HTTP, tipurile de erori.
Cum citești o hartă de servicii
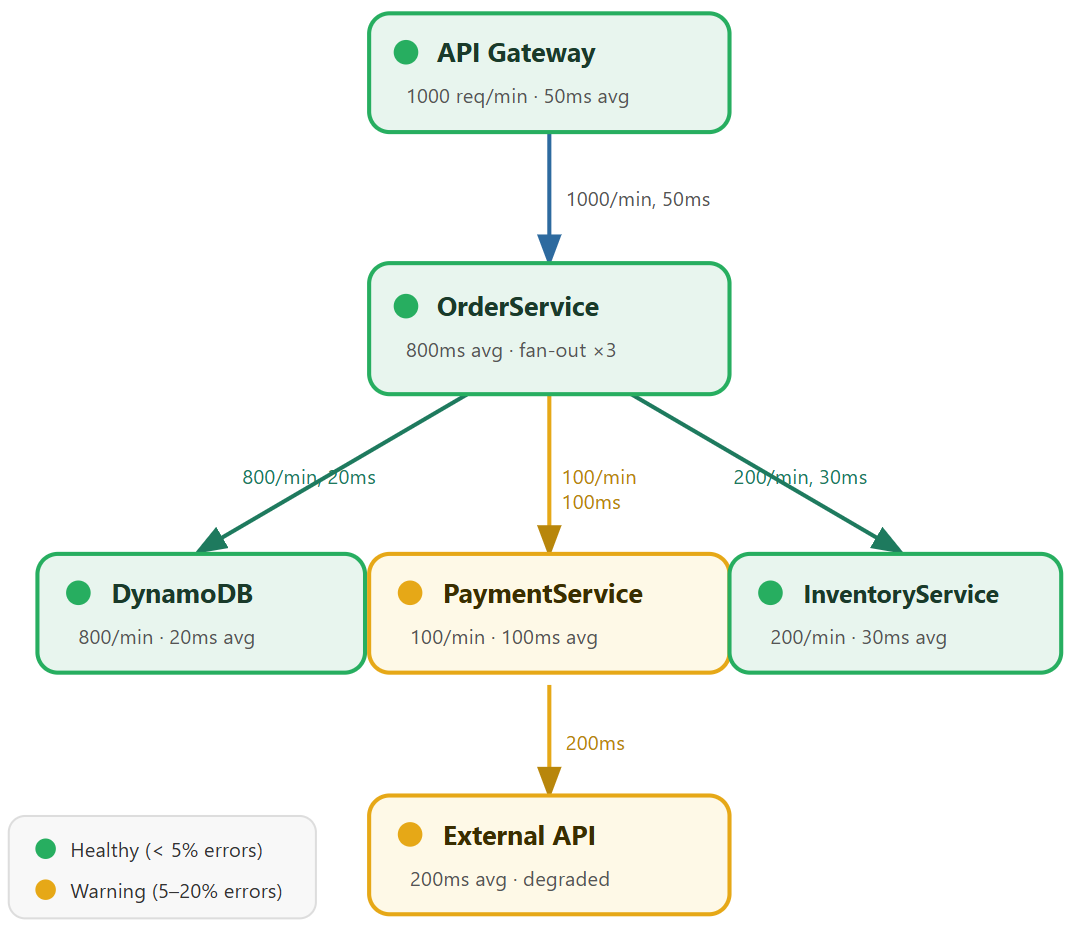
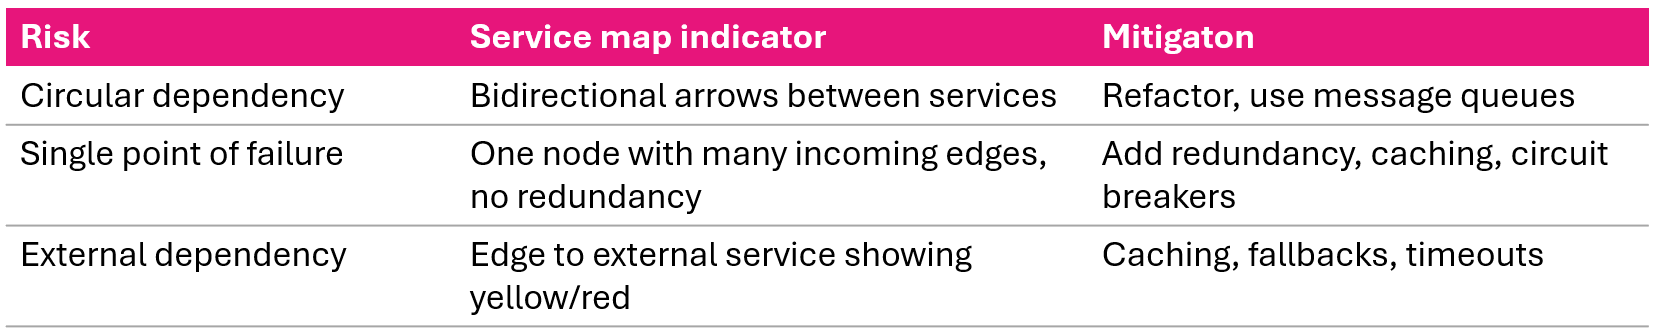
Riscuri de dependențe
Înțelegerea cronologiilor urmelor
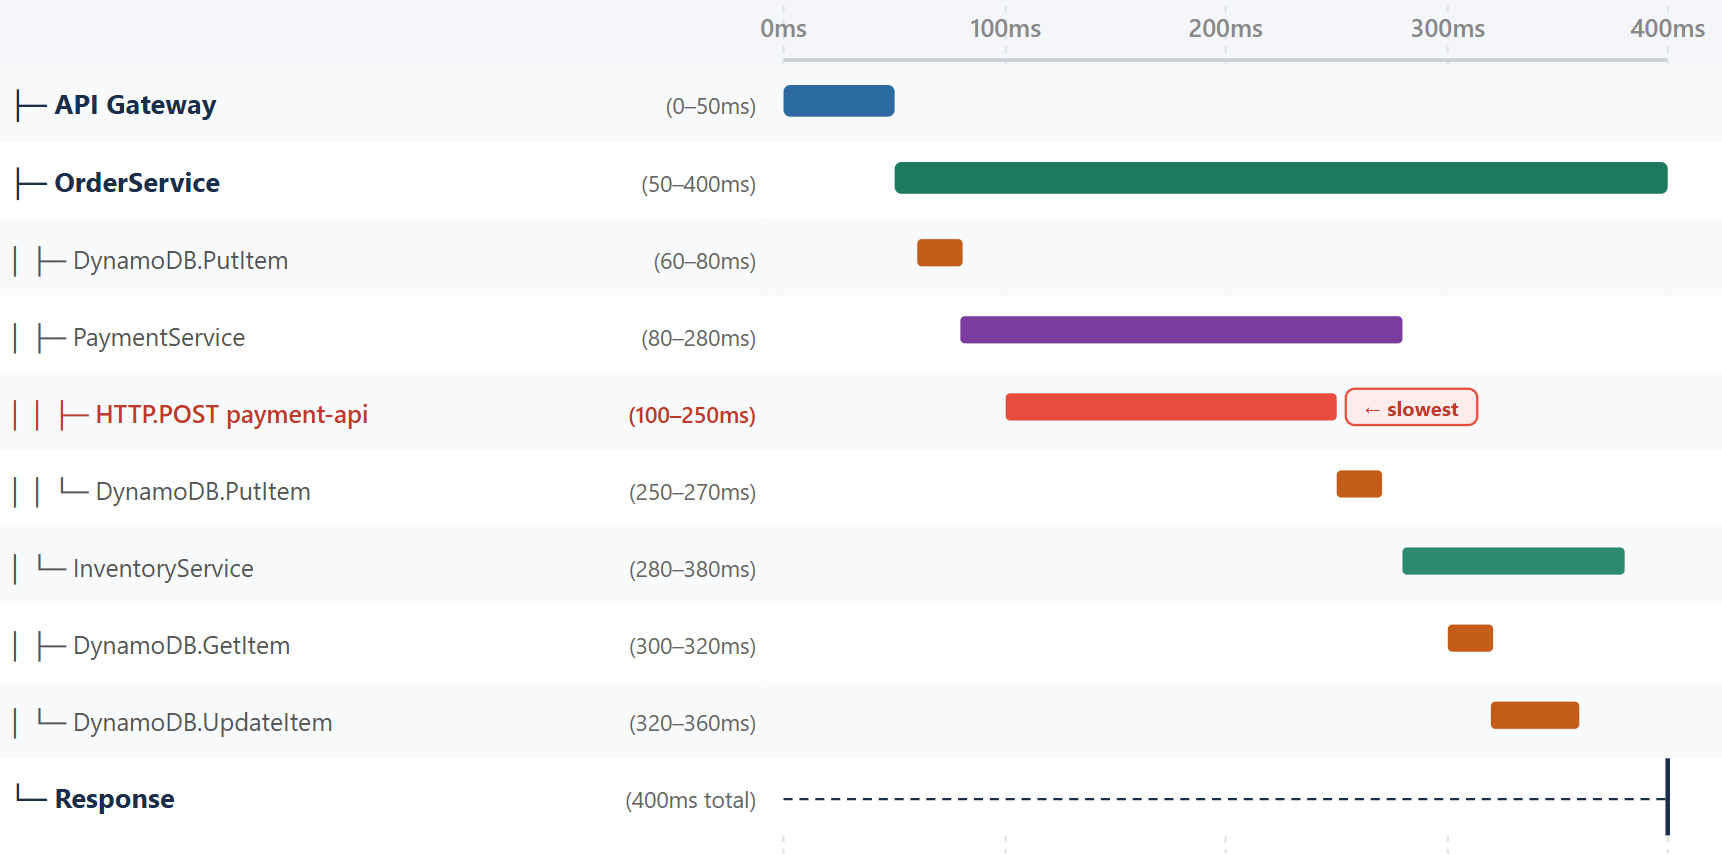
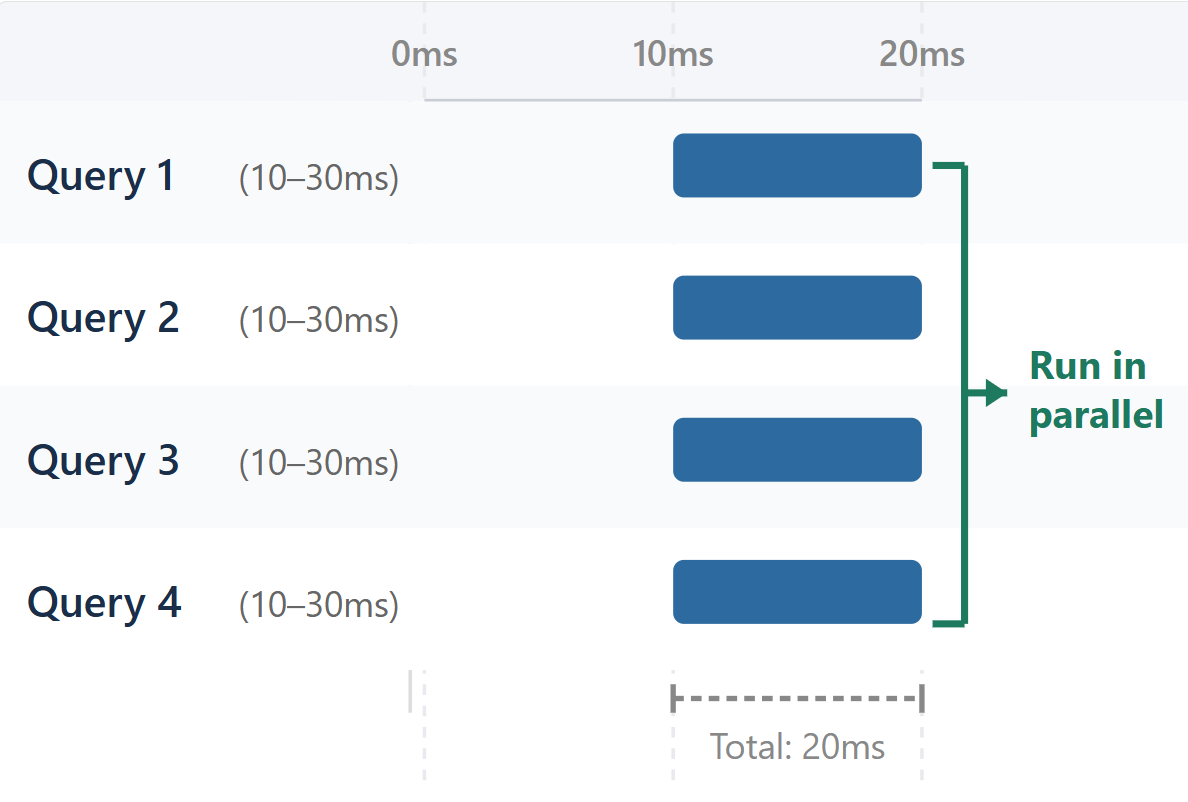
Tiparul 1: Blocaje secvențiale
După (paralel - 20ms):
Tiparul 3: Porniri la rece și defecțiuni în cascadă
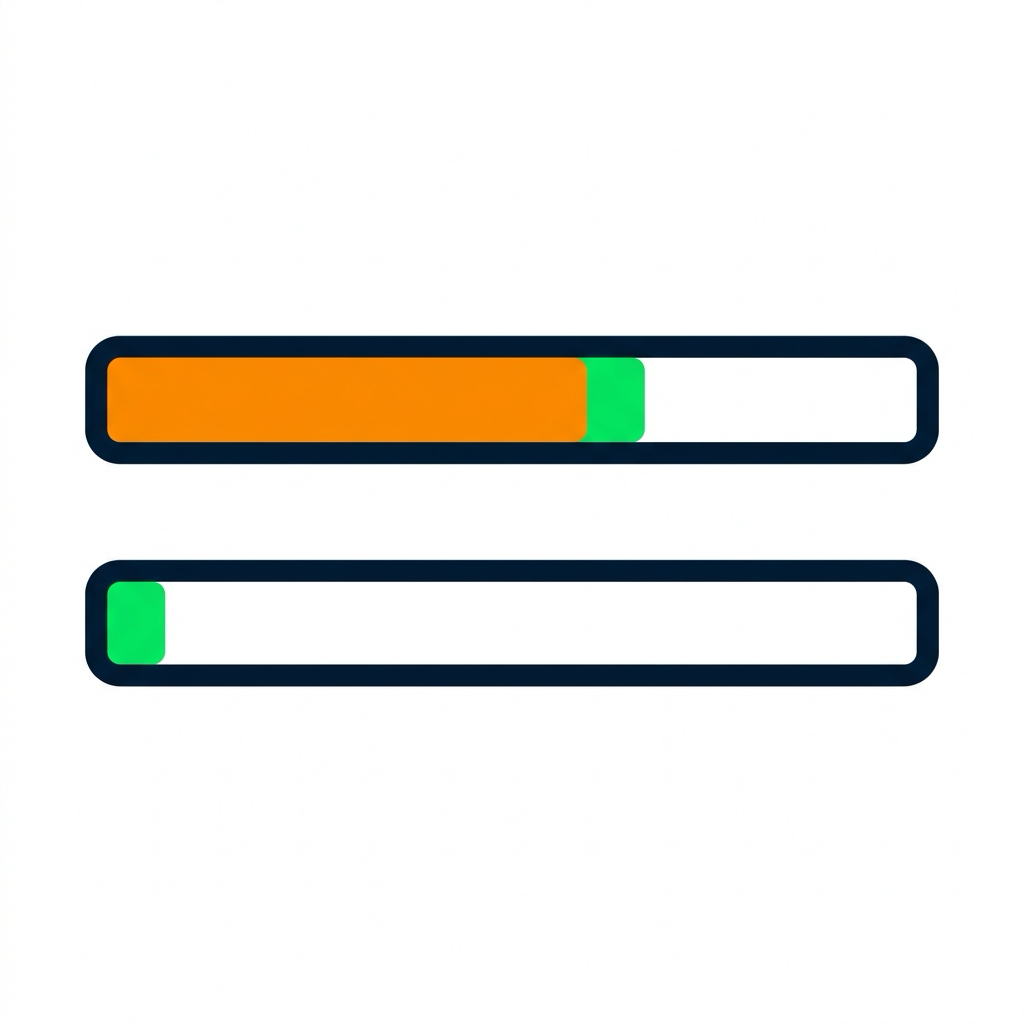
Pornire la rece Lambda:
- La rece: 3000ms (2500ms inițializare + 500ms handler)
- La cald: 500ms (doar handler)
- Vizibil ca segment mare de inițializare la prima invocare
Soluție: concurență provizionată, optimizarea inițializării
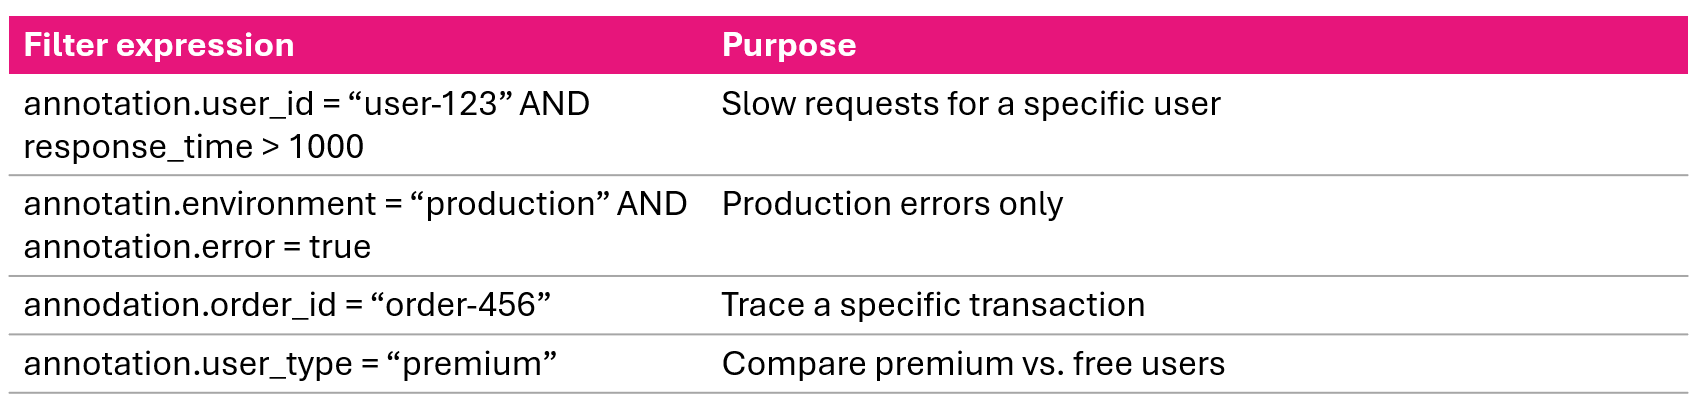
Filtrarea urmelor cu adnotări