Alarme și notificări CloudWatch

Monitorizare și depanare în AWS

John Q. Martin

Principal Consultant

Ce sunt alarmele CloudWatch
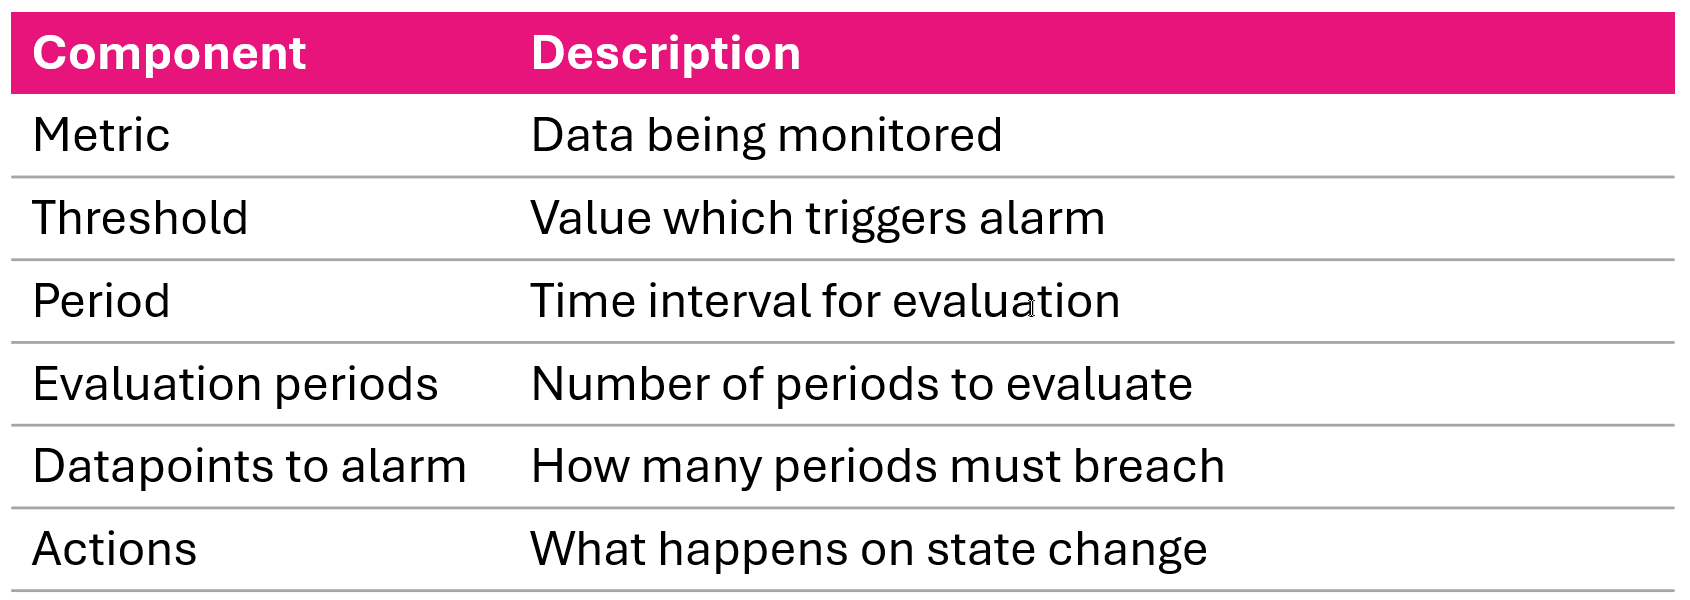
 

Concepte cheie

  • Monitorizează o singură metrică pe o perioadă de timp
  • Execută acțiuni când metrica depășește un prag


Cele șase componente principale ale unui alarm CloudWatch: metrică, prag, perioadă, perioade de evaluare, puncte de date pentru alarm și acțiuni

Monitorizare și depanare în AWS

Stările alarmei

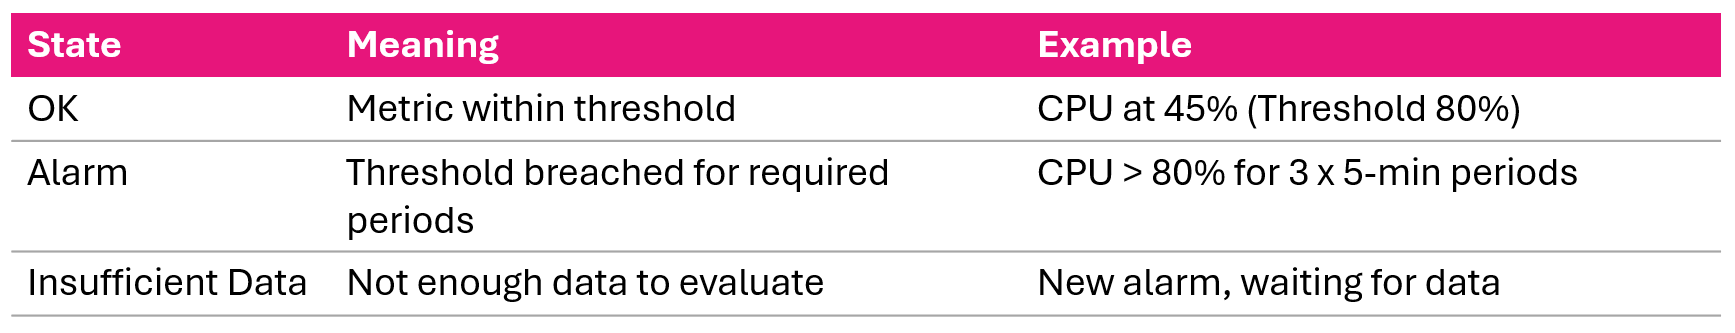
Cele trei stări ale unui alarm CloudWatch: OK, ALARM și INSUFFICIENT_DATA

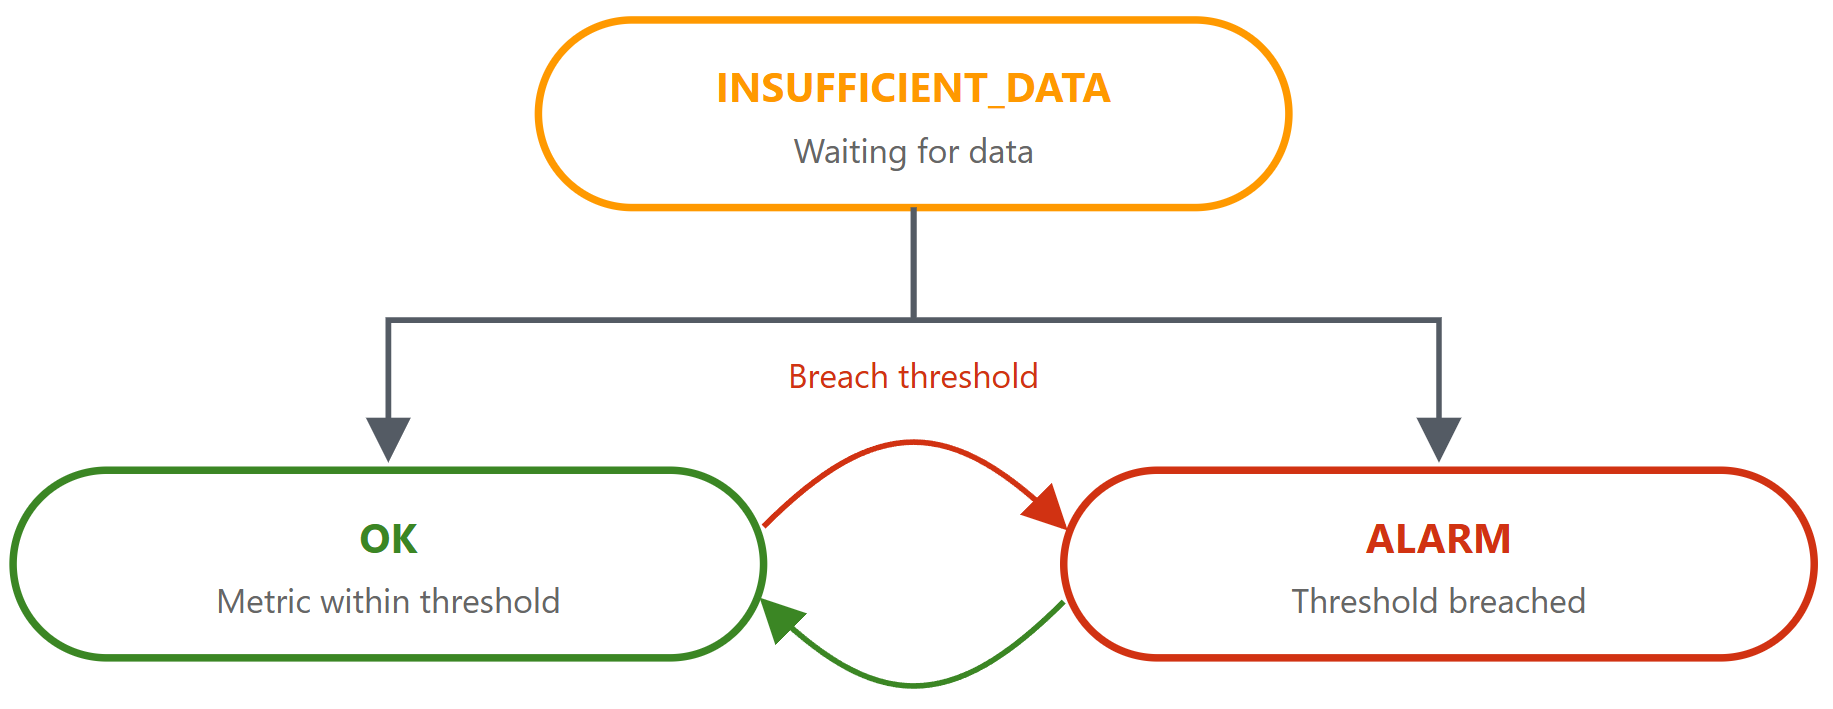
Diagramă care arată cum tranziționează un alarm CloudWatch între stări pe măsură ce sosesc date despre metrică

Monitorizare și depanare în AWS

Evaluarea alarmei


  1. Colectează puncte de date la intervale specificate
  2. Aplică o statistică (Average, Sum, Max, Min) pe perioadă
  3. Compară rezultatul cu pragul
  4. Numără perioadele de evaluare care depășesc pragul
  5. Schimbă starea dacă pragul de puncte-de-date-pentru-alarm este atins


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Monitorizare și depanare în AWS

Strategii de evaluare


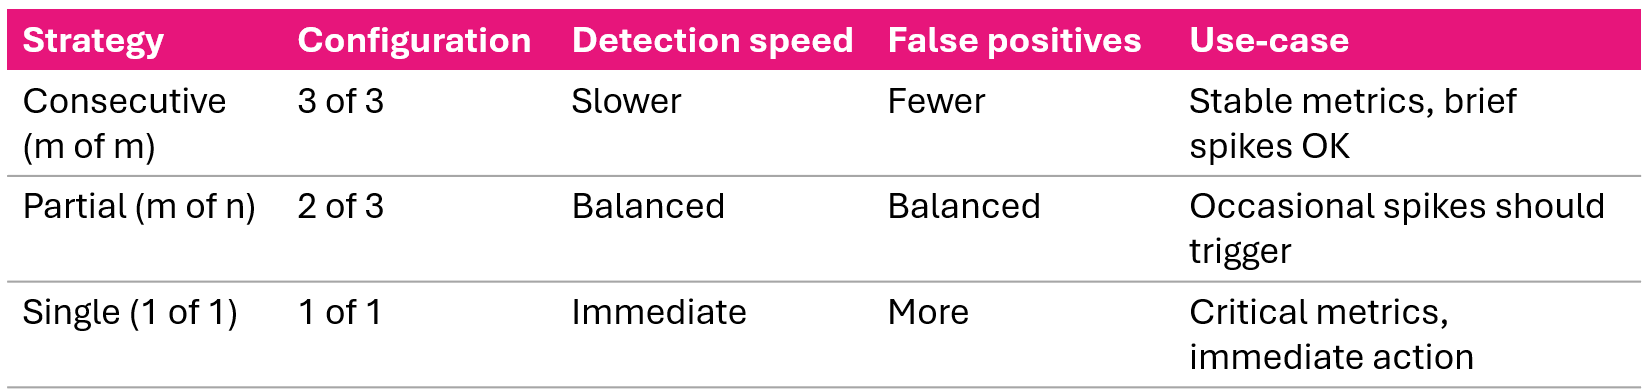
Trei strategii de evaluare a alarmei: consecutivă, parțială și singură depășire, cu compromisurile de sensibilitate aferente

Monitorizare și depanare în AWS

Tipuri și declanșatori de acțiuni pentru alarme


Declanșatori de acțiuni

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Tipuri de acțiuni

  • Notificare SNS
  • Auto Scaling
  • Acțiune EC2 (oprire/terminare/repornire/recuperare)
  • Systems Manager
Monitorizare și depanare în AWS

Comportamentul în cazul datelor lipsă
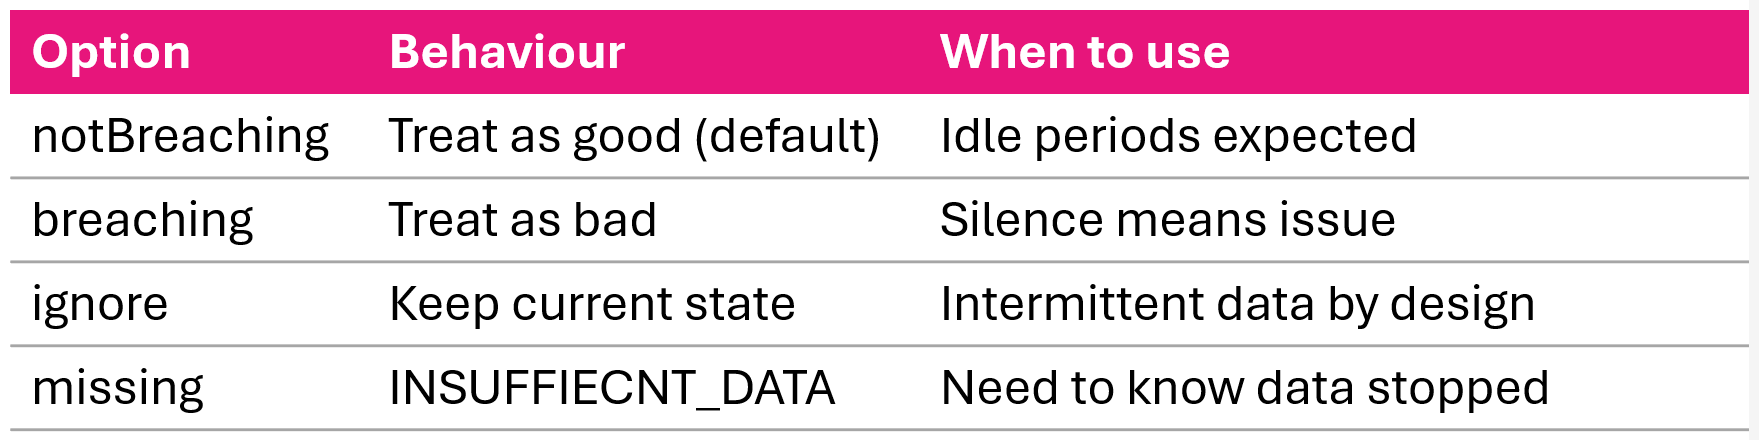
 

Opțiuni pentru comportamentul în cazul datelor lipsă: notBreaching, breaching, ignore și missing

Monitorizare și depanare în AWS

Crearea unui alarm standard: AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Monitorizare și depanare în AWS

Alarme compuse: ce sunt și de ce le folosim
Problemă

  • Mai multe alarme corelate se declanșează separat = oboseală prin alerte

Soluție

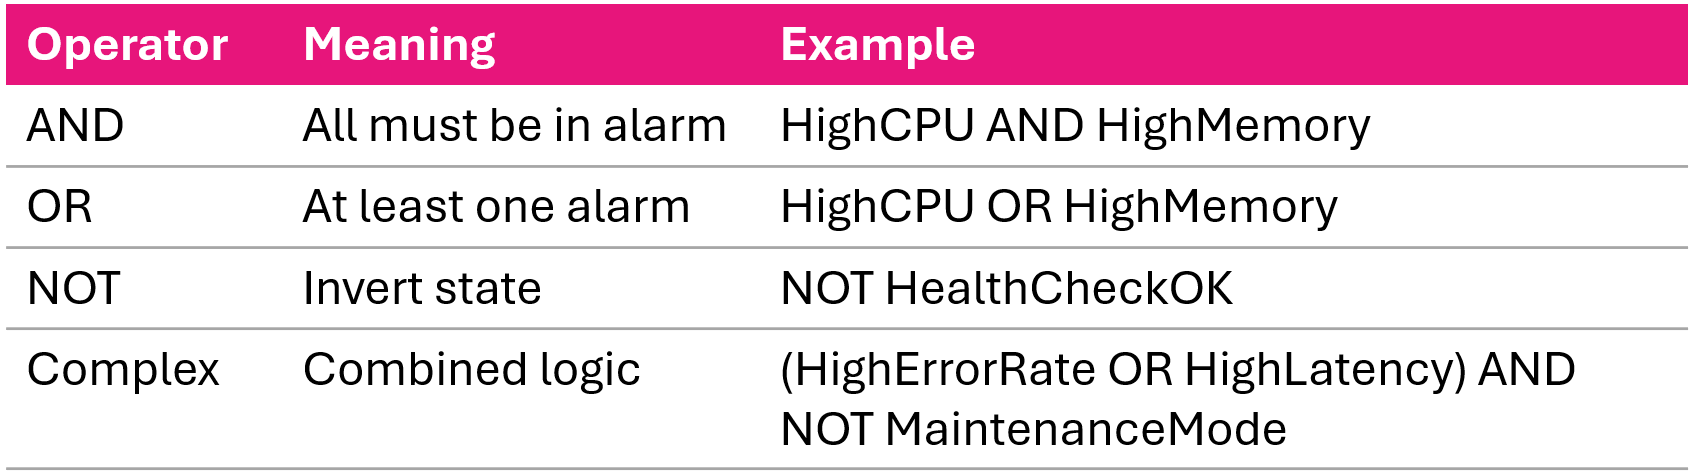
  • Combină alarmele cu operatori logici

Logica alarmei compuse care combină alarme secundare cu operatorii AND, OR și NOT

Monitorizare și depanare în AWS

Crearea unei alarme compuse: AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Exemplu de regulă complexă
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Monitorizare și depanare în AWS

Strategia de selectare a pragului

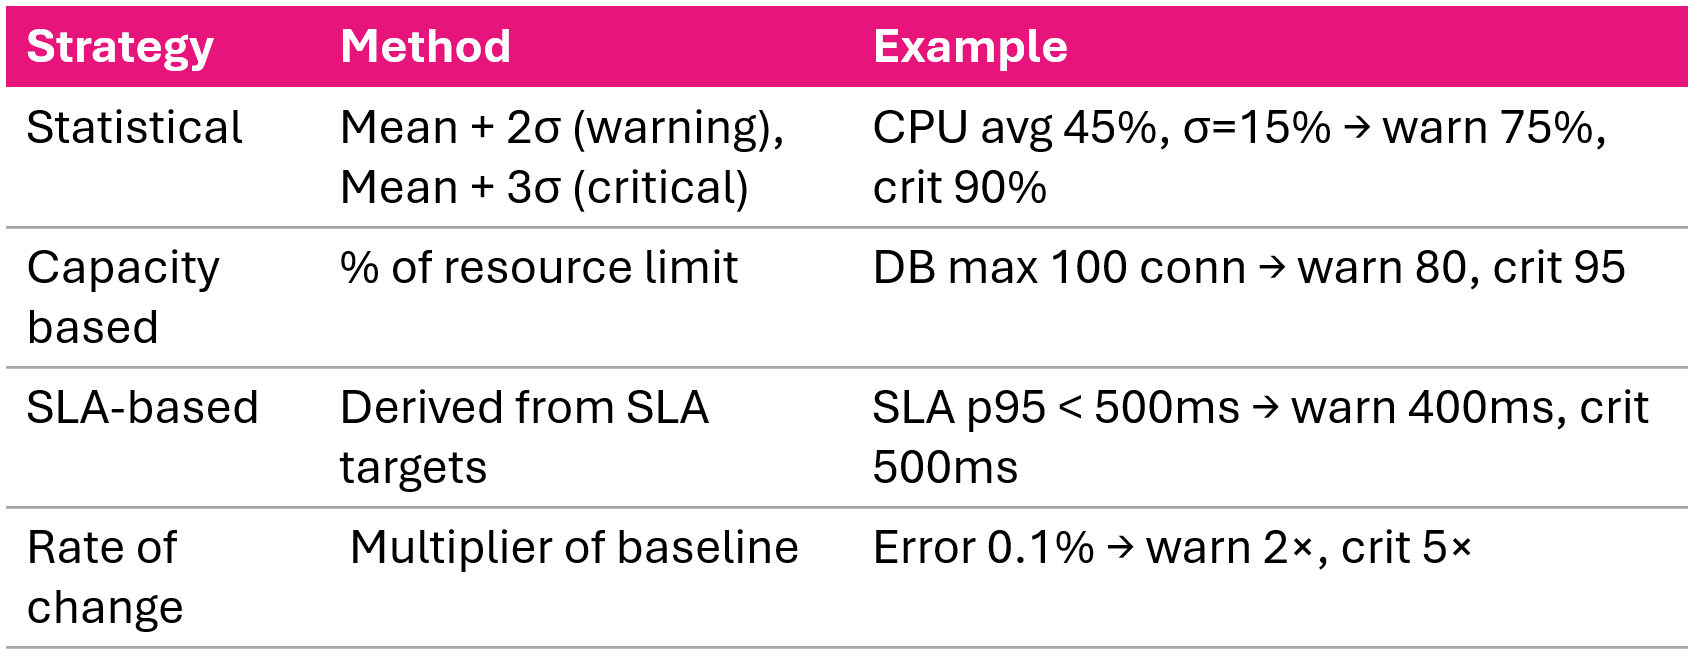
Patru strategii de selectare a pragului: abatere de la linia de bază, limite de capacitate, ținte SLA și rata de schimbare

Monitorizare și depanare în AWS

Strategie de alarmare pe mai multe niveluri
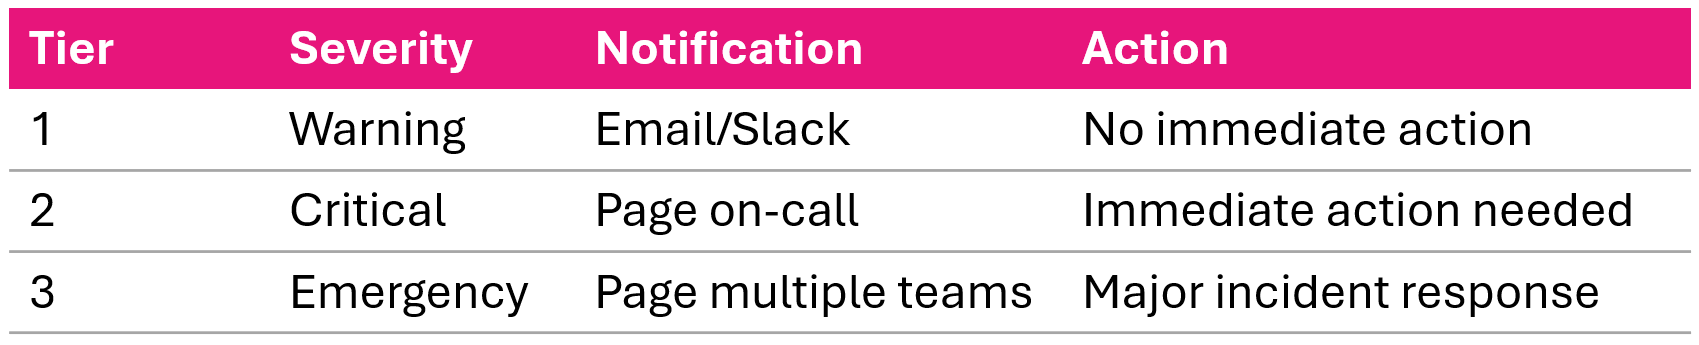
 

Răspuns la alarme pe mai multe niveluri: avertizare, critic și urgență, direcționate către topicuri SNS separate

Exemplu: Avertizare CPU la 75%, Critic la 90%, fiecare cu topicuri SNS diferite

Monitorizare și depanare în AWS

Alarme de detectare a anomaliilor

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • Modelul ML învață comportamentul normal al metricii
  • Creează o bandă dinamică de prag (configurabilă)
  • Se adaptează la tipare zilnice/săptămânale
  • Reduce ajustarea manuală a pragurilor
Monitorizare și depanare în AWS

Alarme pentru resurse: Lambda și ALB

Alarme Lambda
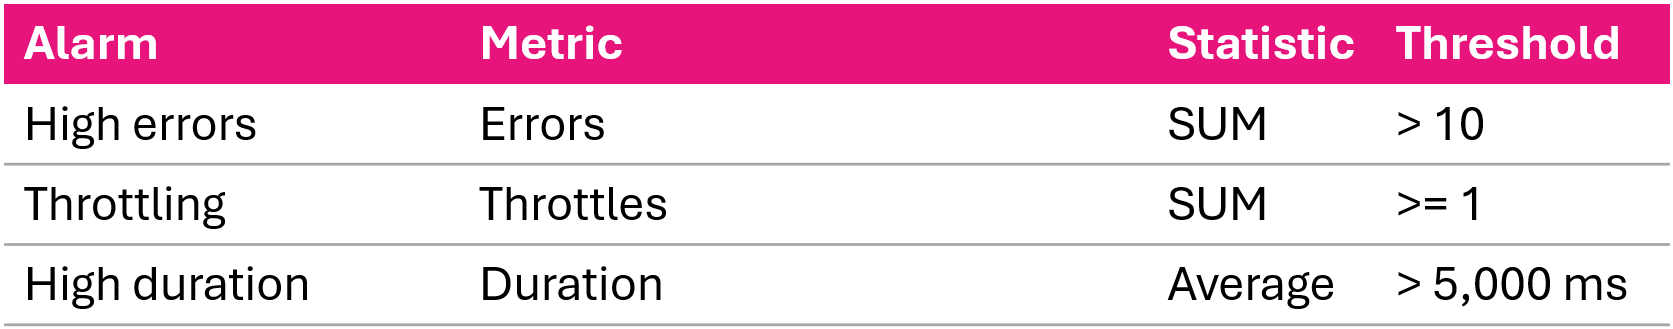
Alarme Lambda recomandate care monitorizează numărul de erori, limitările și durata ridicată aproape de limita de timeout

Alarme ALB

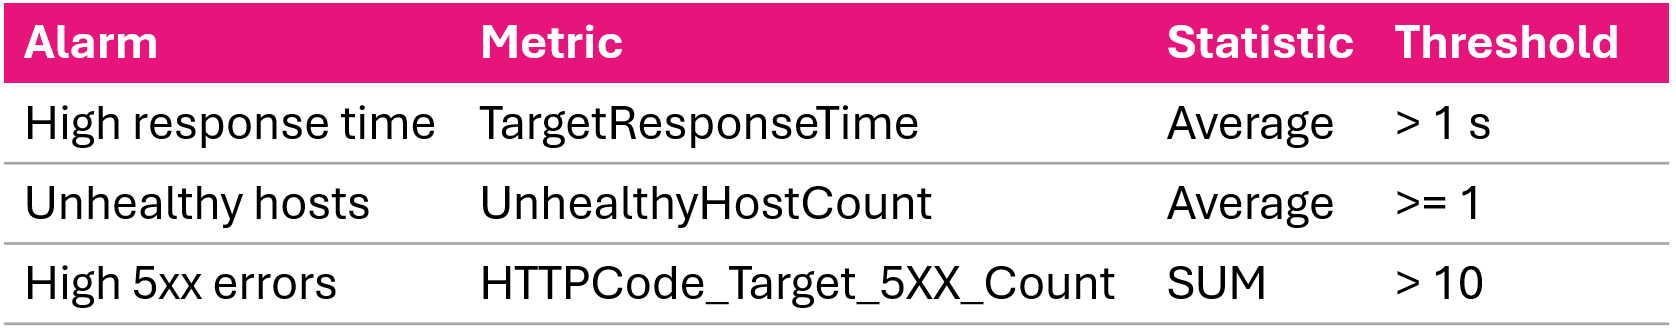
Alarme ALB recomandate care monitorizează timpul de răspuns al țintei, gazdele nesănătoase și numărul de erori 5xx

Monitorizare și depanare în AWS

Practici recomandate pentru gestionarea alarmelor

  • Denumire: <Service>-<Metric>-<Resource>-<Severity>
  • Descrieri: ce se monitorizează, prag, indicii de depanare, linkuri runbook
  • Etichete: Mediu, Echipă, Severitate
  • Revizuire lunară: ajustează pragurile, elimină alarmele obsolete, actualizează acțiunile
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Monitorizare și depanare în AWS

Rezumatul videoclipului

  • Trei stări ale alarmei: OK, ALARM, INSUFFICIENT_DATA
  • Strategii de evaluare: consecutivă, parțială, singură depășire
  • Alarmele compuse combină mai multe alarme cu AND, OR, NOT
  • Patru strategii de prag: statistică, capacitate, SLA, rată de schimbare
  • Alertare pe mai multe niveluri: avertizare → critic → urgență
  • Alarme pentru resurse Lambda (erori, limitări, durată) și ALB (5xx, latență)
Monitorizare și depanare în AWS

Hai să exersăm!

Monitorizare și depanare în AWS

Preparing Video For Download...