アプリケーション健全性ダッシュボード

AWS のモニタリングとトラブルシューティング

John Q. Martin

Principal Consultant

ダッシュボード設計:情報の階層
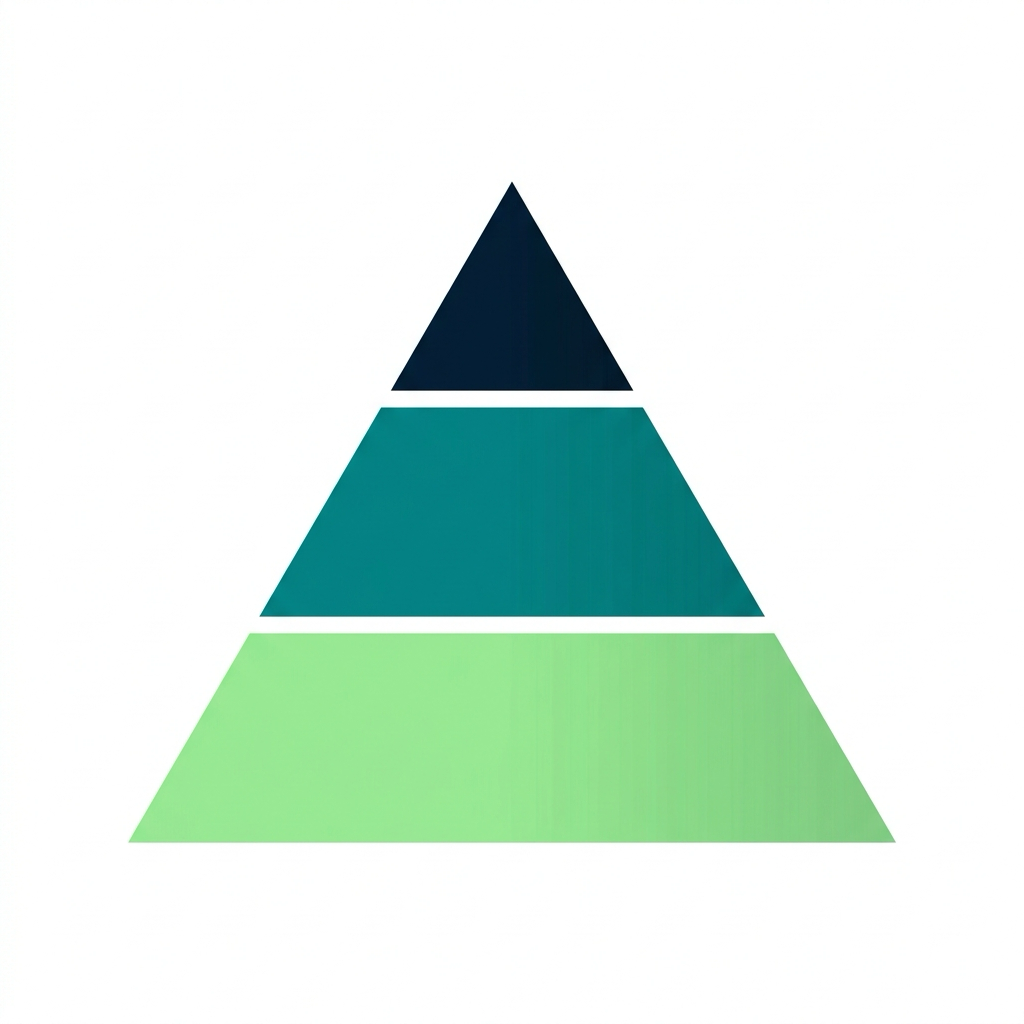
 

3層ピラミッド:上部は細い濃色、中段はティール色、底部は最も広い緑色

病院に例えると:受付 → 病棟 → 専門医


上位 - エグゼクティブサマリー

  • システム全体の健全性
  • 主要ビジネス指標、SLA、現在のインシデント

中位 - サービス健全性

  • エラー率、レイテンシパーセンタイル、スループット

下位 - 詳細診断

  • トレース、ログ、リソース使用率、依存関係の健全性
AWS のモニタリングとトラブルシューティング

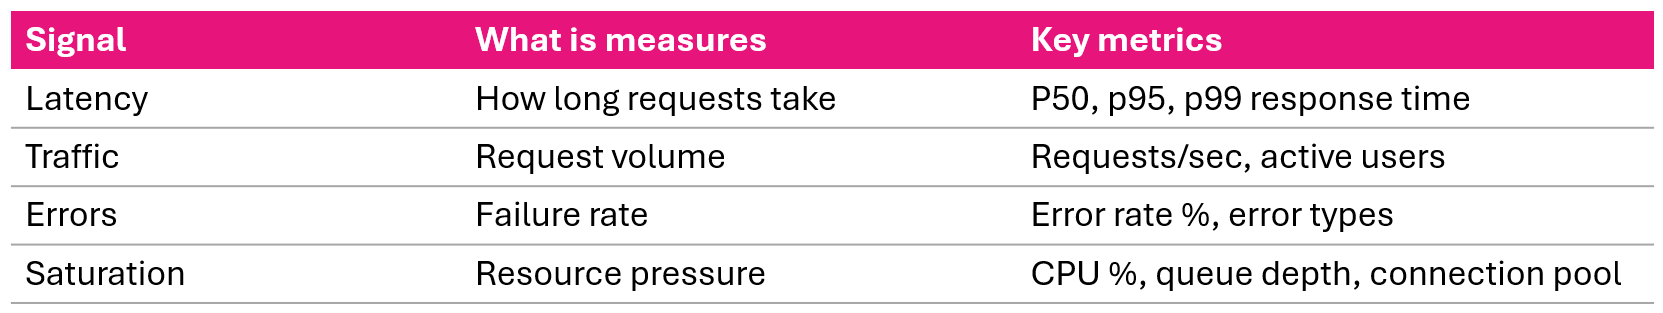
4つのゴールデンシグナル


モニタリングの4つのゴールデンシグナル:レイテンシ、トラフィック、エラー、サチュレーション

この4つを把握すれば、大半の問題に対応できます。

AWS のモニタリングとトラブルシューティング

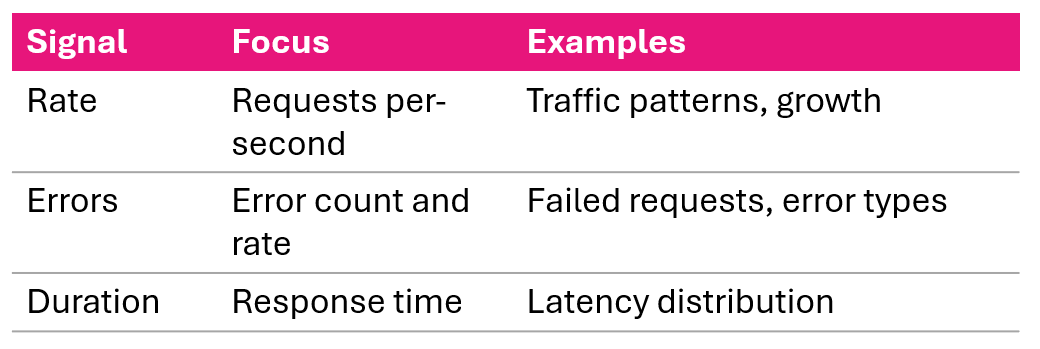
REDメソッド


リクエスト駆動型サービスのための RED:

REDメソッドのパターン:リクエスト駆動型サービスにおけるRate、Errors、Durationを示す図


ゴールデンシグナルとの関係:

  • RED は4つのゴールデンシグナルの絞り込みサブセットです
  • ユーザーリクエストを処理するサービス向けに設計されています
  • インフラ監視にはサチュレーション(第4のゴールデンシグナル)を追加します

まず RED を起点にし、より深い診断にはサチュレーションを加えましょう。

AWS のモニタリングとトラブルシューティング

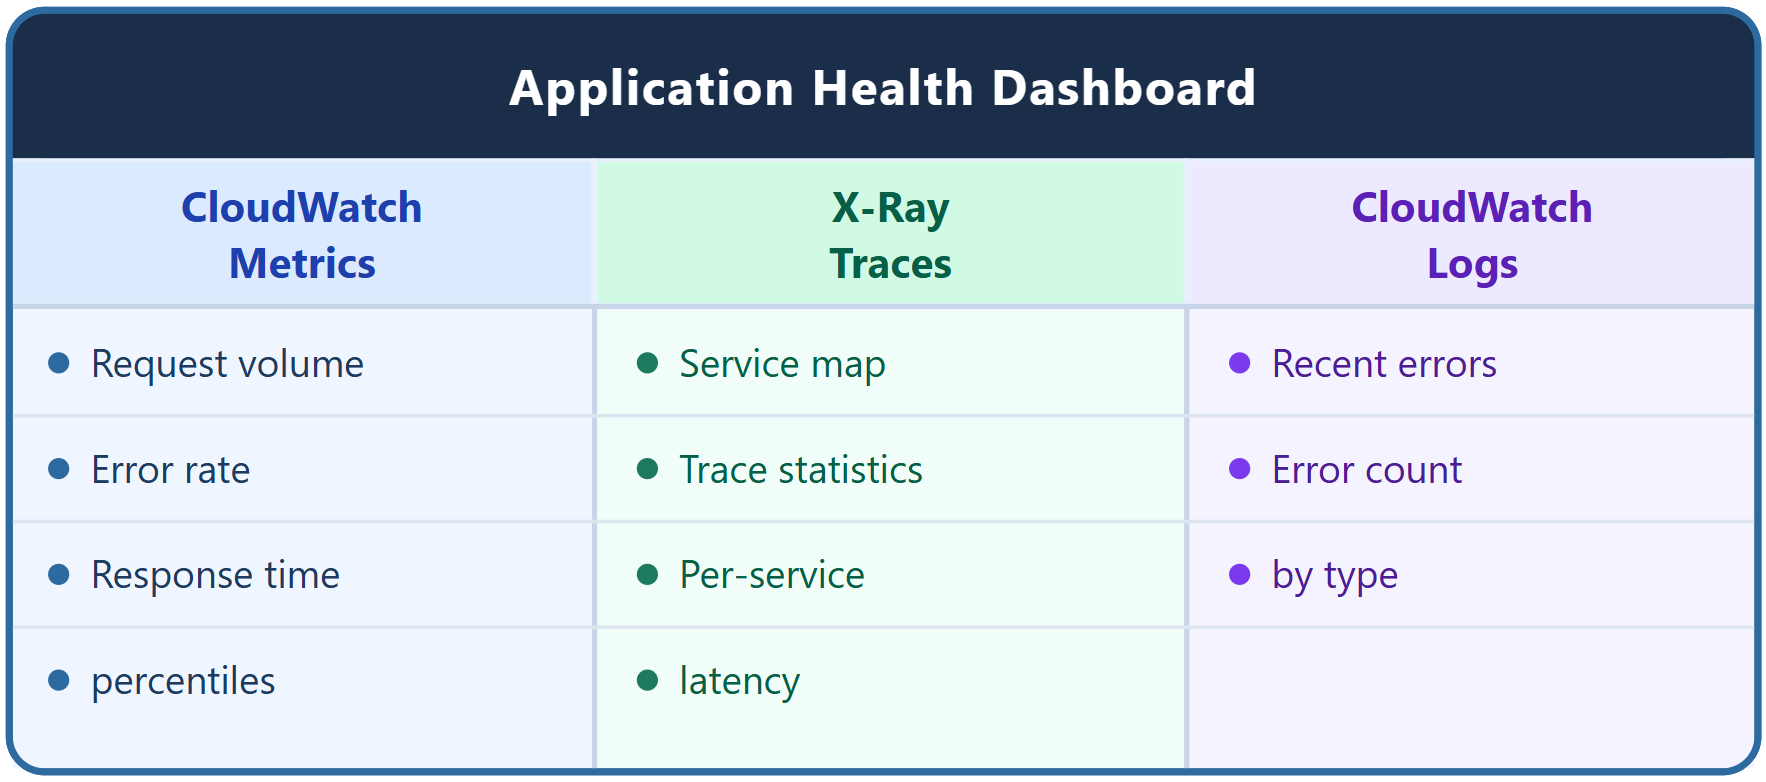
3つのデータソース


ダッシュボードの3つのデータソース:CloudWatchメトリクス、X-Rayトレース、CloudWatch Logsを示す図

AWS のモニタリングとトラブルシューティング

CloudWatch メトリクスウィジェット

リクエスト数:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

エラー率(メトリクス計算):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

レスポンスタイムのパーセンタイル:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • リクエスト数は ALB の RequestCount から取得します
  • エラー率は メトリクス計算 を使用:errors / invocations × 100
  • レスポンスタイムは p50、p95、p99 のパーセンタイルで表示します
AWS のモニタリングとトラブルシューティング

X-Ray とログウィジェット


X-Ray ウィジェット:

  • サービスマップ - 健全性インジケーター付きのアプリケーショントポロジー
  • トレース統計 - 平均レスポンスタイム、エラー率、障害率
  • サービスレイテンシ - サービスごとのレスポンスタイム比較


CloudWatch Logs ウィジェット:

直近のエラークエリ:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

エラー種別のカウント:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
AWS のモニタリングとトラブルシューティング

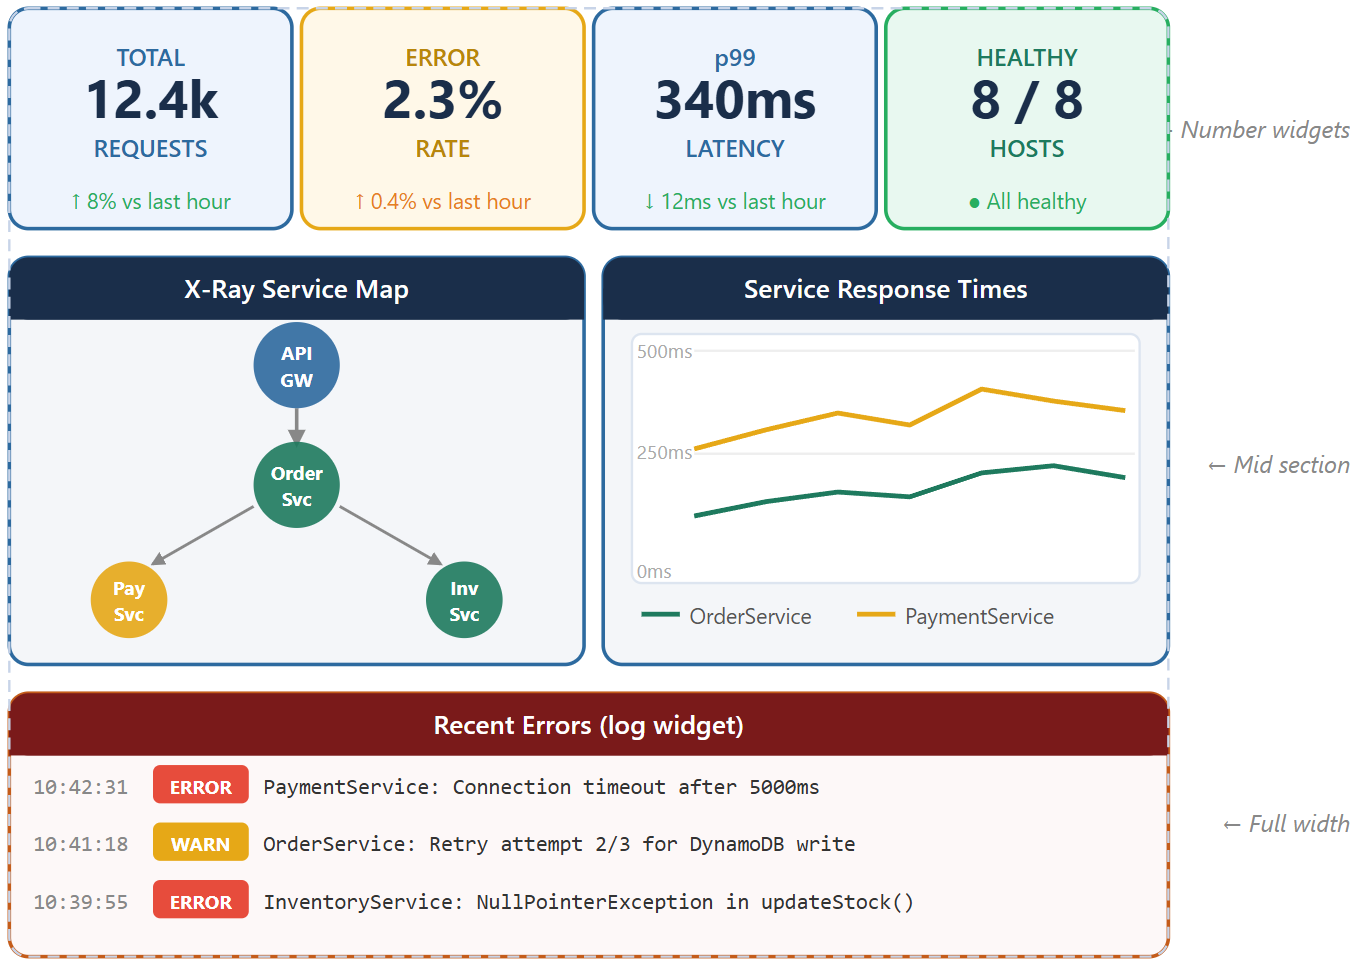
ダッシュボードの完全なレイアウト


ヘルスダッシュボードのレイアウト:上部にサマリーウィジェット、中段にサービスマップ、下部にエラーログ

AWS のモニタリングとトラブルシューティング

インシデントのトラブルシューティングワークフロー


優先度ごとに色分けされたクリップボードと聴診器:救急トリアージのイメージ

救急トリアージに例えると:安定化 → 診断 → 治療 → 確認

  1. 特定 - 赤・黄インジケーター、エラースパイク
  2. 範囲確認 - どのサービスか、いつか、悪化しているか
  3. 相関分析 - エラーとレイテンシ、トラフィックとリソース
  4. 掘り下げ - サービスマップ → トレース → ログ
  5. 根本原因 - 依存関係、DB、メモリ、設定
  6. 修正 - サーキットブレーカー、スケール、ロールバック、フェイルオーバー
  7. 確認 - エラー率の正常化、マップが緑、アラーム解除
AWS のモニタリングとトラブルシューティング

シナリオ1:突然のトラフィックスパイク

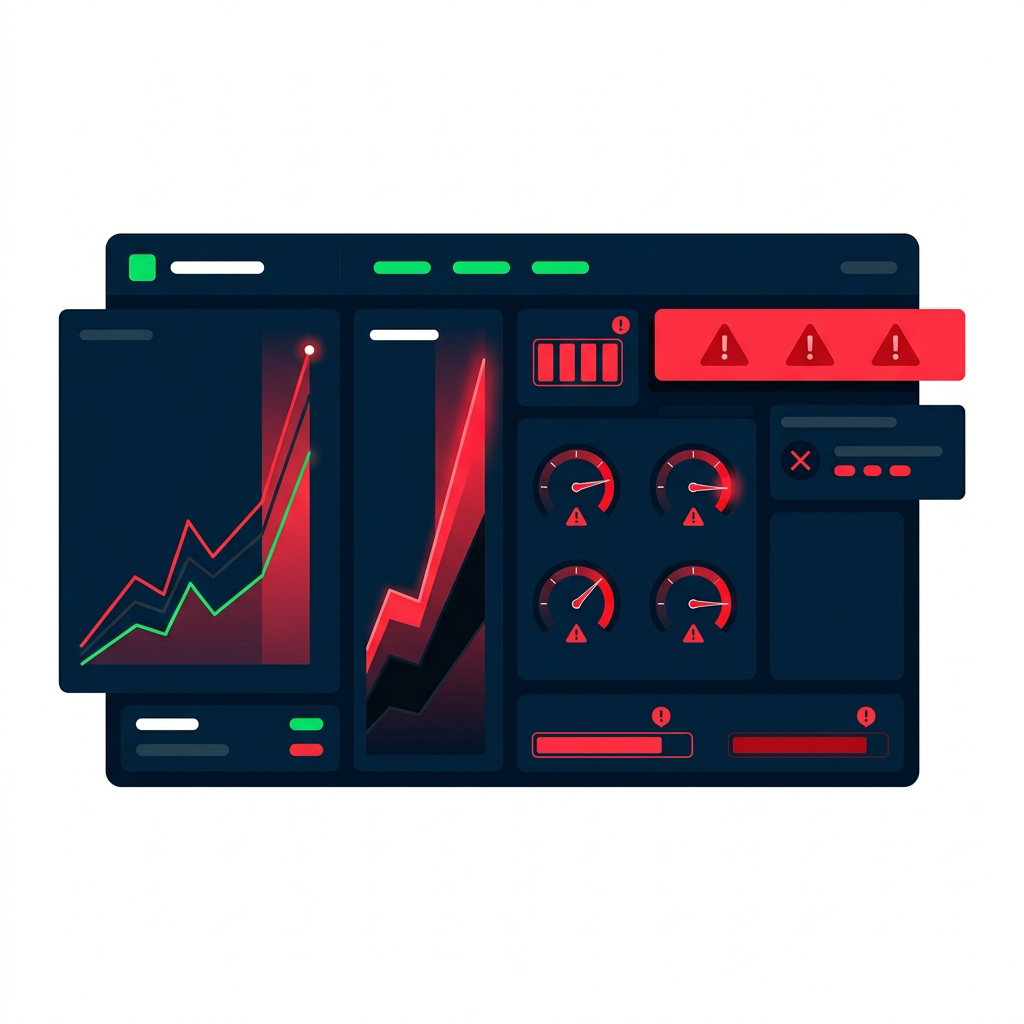
トラフィックスパイク中のモニタリングダッシュボード:急上昇する折れ線グラフ、赤ゾーンに張り付いたゲージ、赤いアラートバナー

ダッシュボードに表示される状態:

  • リクエスト数が通常の10倍
  • エラー率 25%
  • レイテンシ 3000ms
  • CPU 95%

分析: トラフィック急増によるリソース過負荷


対応策:

  • 即時スケールアウト
  • オートスケーリングの有効化
  • レート制限の実装
  • キャッシュの追加によるバックエンド負荷の軽減
AWS のモニタリングとトラブルシューティング

シナリオ2:データベースボトルネック

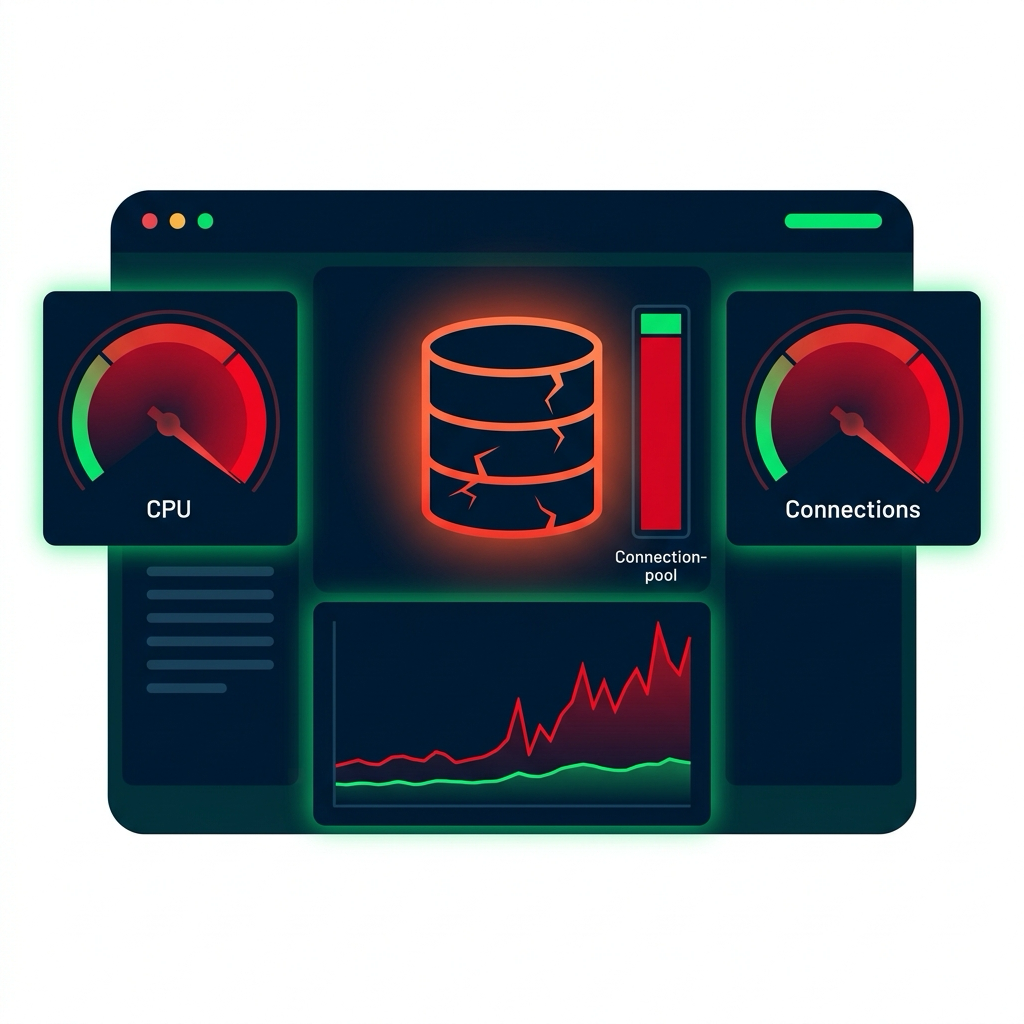
データベースボトルネックを示すモニタリングダッシュボード:ひび割れた赤いDBアイコン、赤ゾーンに張り付いたCPUと接続数のゲージ、急上昇するクエリレイテンシグラフ、ほぼ満杯のコネクションプールバー

ダッシュボードに表示される状態:

  • DB CPU 95%
  • DB 接続数 95/100
  • クエリレイテンシ 5000ms
  • アプリレイテンシ 5500ms

分析: データベースがボトルネックとなり、低速クエリがコネクションプールを枯渇させています


対応策:

  • ログで低速クエリを特定する
  • インデックスの追加とクエリの最適化
  • コネクションプールサイズの拡大
  • データベースのスケールアップ
AWS のモニタリングとトラブルシューティング

シナリオ3:カスケード障害


サービスマップに表示される状態:

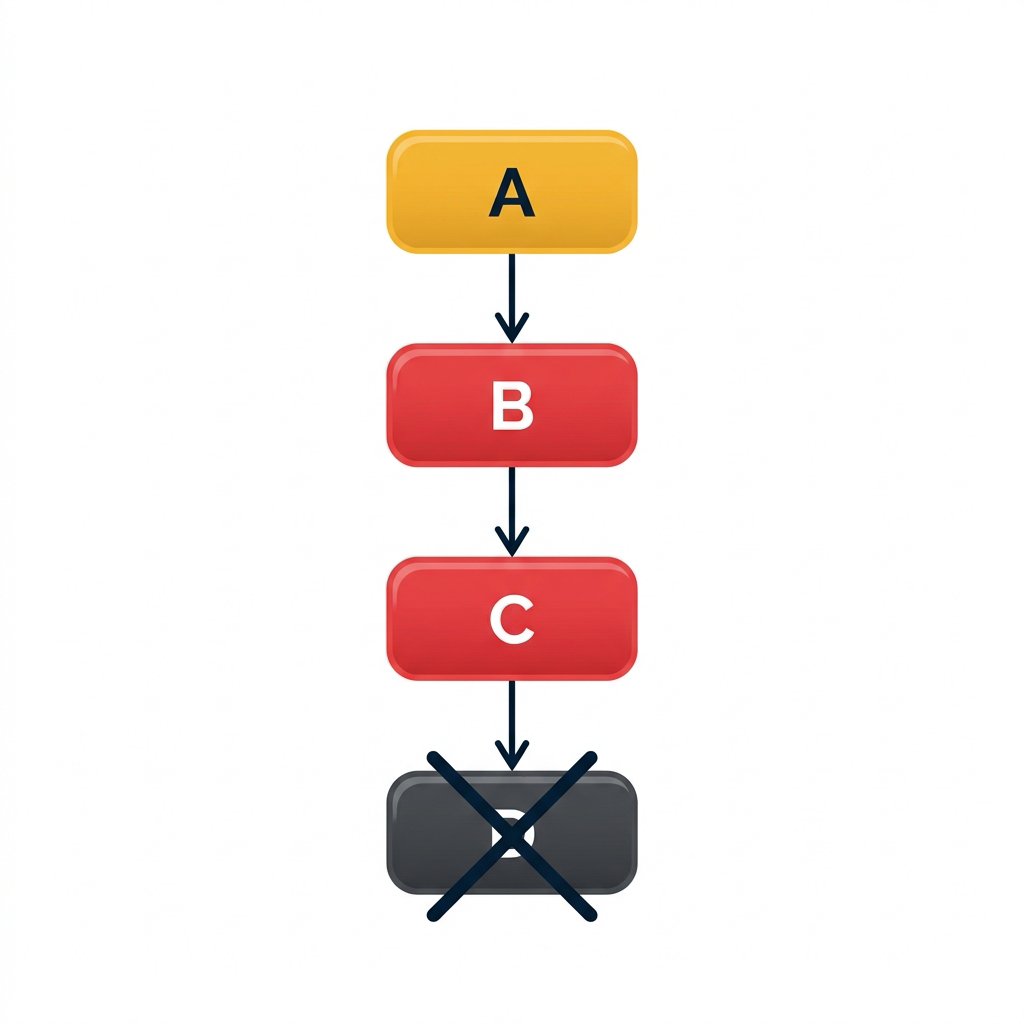
サービスマップのカスケード:Aノードが黄色(クライアントエラー)、BとCが赤(サーバー障害)、Dが暗色で完全停止、依存チェーンに沿って矢印が流れている


分析:

サービス A の小さな問題が依存チェーン全体に波及しました

対応策:

  • カスケードを止めるサーキットブレーカーの導入
  • 各サービス層でのタイムアウト設定
  • 失敗した依存関係に対するフォールバック機構の実装
  • サービス A の根本原因の修正
AWS のモニタリングとトラブルシューティング

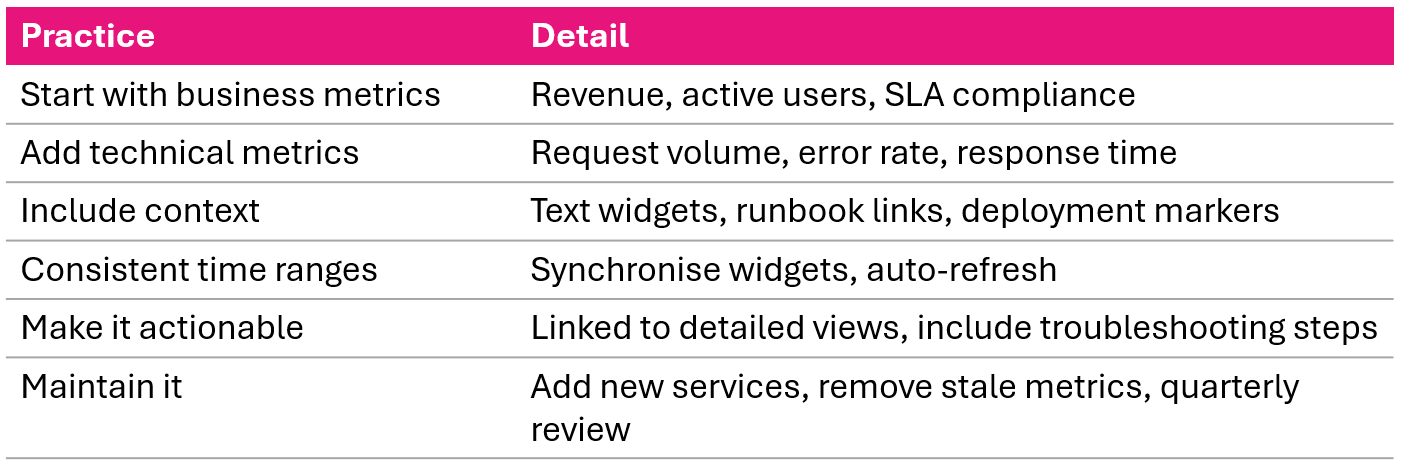
ダッシュボードの推奨プラクティス


アプリケーション健全性モニタリングにおけるダッシュボードの6つの推奨プラクティス

AWS のモニタリングとトラブルシューティング

動画のまとめとコース修了

  • 情報の階層と4つのゴールデンシグナルを活用して設計します
  • CloudWatch メトリクス、X-Ray トレース、ログを1つのビューに統合します
  • 7ステップのインシデントワークフロー:特定 → 範囲確認 → 相関分析 → 掘り下げ → 根本原因 → 修正 → 確認

習得したスキル:

  • CloudWatch メトリクス、ログ、ダッシュボードによるモニタリング
  • SNS と SQS を使ったアラームと通知の設定
  • X-Ray による分散トレーシングの実装
  • 運用品質向上のためのアプリケーション健全性ダッシュボードの構築
AWS のモニタリングとトラブルシューティング

アプリケーション健全性ダッシュボード

AWS のモニタリングとトラブルシューティング

Preparing Video For Download...