トレースとサービスマップの分析

AWS のモニタリングとトラブルシューティング

John Q. Martin

Principal Consultant

サービスマップとは?


トレースデータから自動生成:手動設定不要
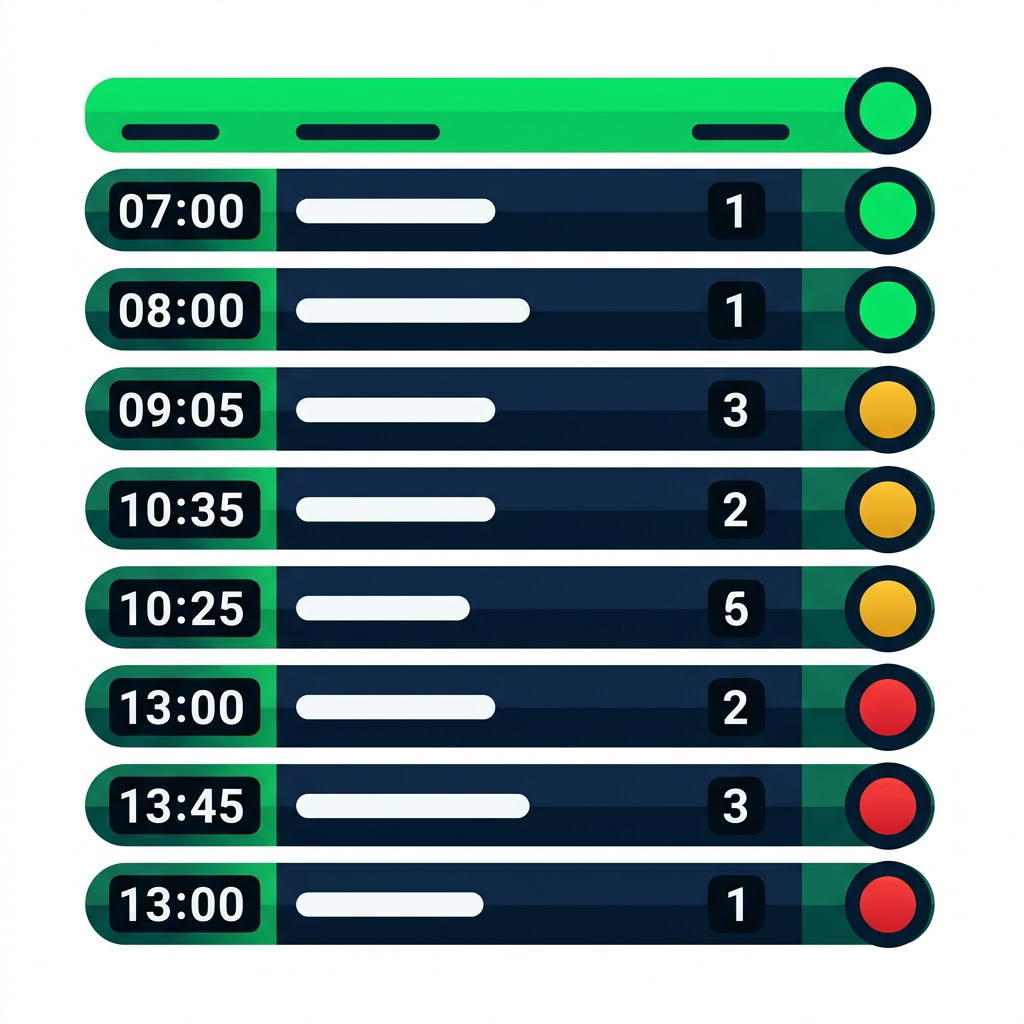
サービスの一覧が並ぶ鉄道の発車案内板。各行にステータスランプがあり、緑は定刻、黄色は遅延、赤は停止を示す

一目でわかる: = 正常 · = 遅延 · = 停止


アクセス方法:

  • X-Ray コンソール → Service map
  • フィルターを適用
  • ノードをクリック → 詳細を確認
AWS のモニタリングとトラブルシューティング

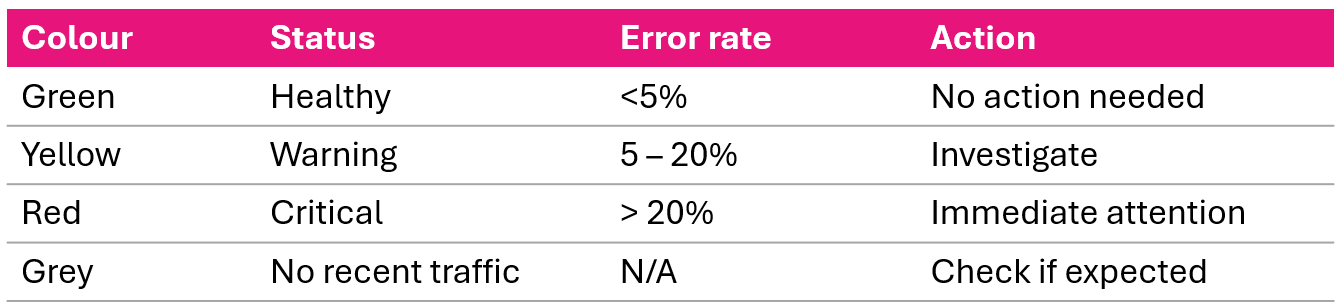
サービスマップの色分け


サービスマップの色分けキー:緑は成功した呼び出し、黄色はクライアントエラー、赤はサーバー障害、紫はスロットリング、グレーはトラフィックなし

サービスマップを開いたら、緑以外の箇所をすぐに確認しましょう。

ノードをクリックすると、レスポンス時間の分布・HTTPステータスの内訳・エラーの種類を確認できます。

AWS のモニタリングとトラブルシューティング

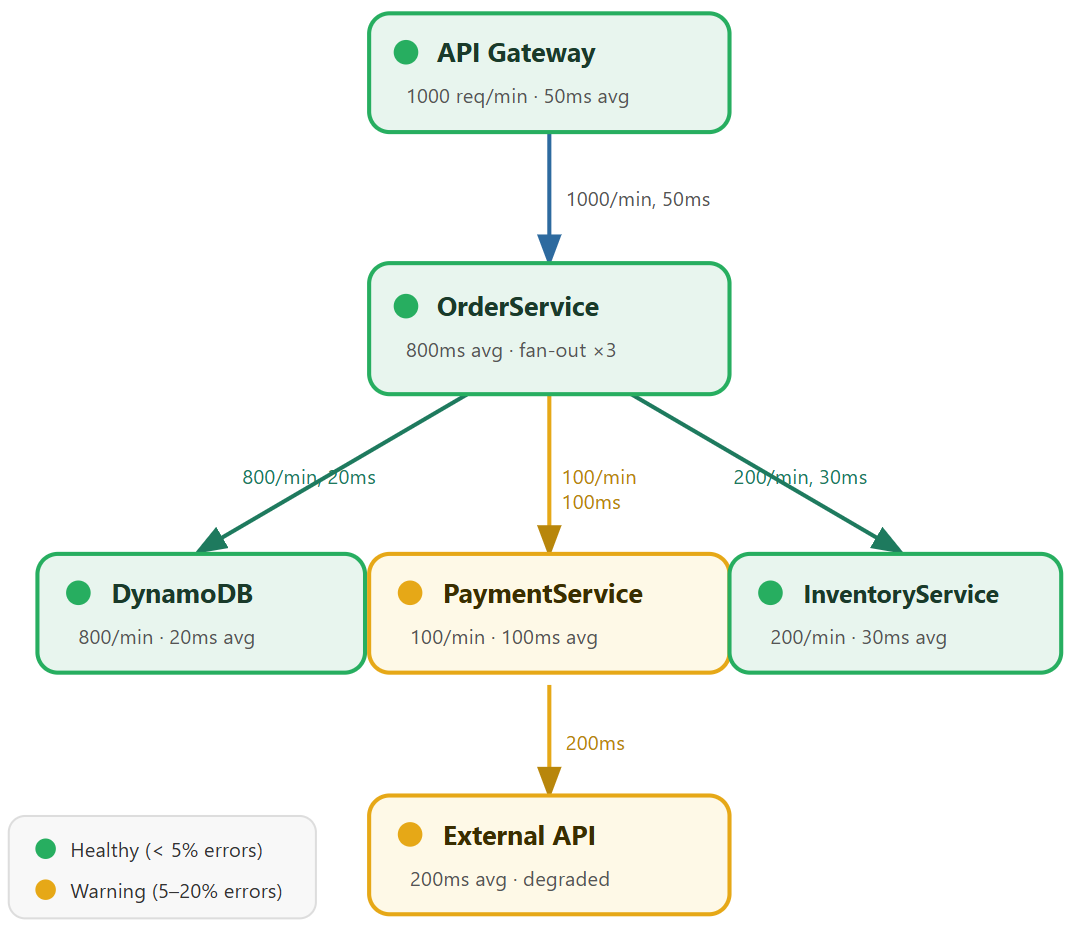
サービスマップの読み方


API Gateway と OrderService が DynamoDB Inventory および黄色の Payment サービスに扇状につながるサービスマップ

AWS のモニタリングとトラブルシューティング

クリティカルパス分析


クリティカルパス = 最長のサービス呼び出しチェーン

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Total: 400ms

External API = 全レイテンシの 50%


対処方法:

  • External API が最適化の対象
  • 選択肢:キャッシュの追加、タイムアウト+フォールバックの実装、SLA の交渉

別のパスと比較:

OrderService -> DynamoDB
Total: 120ms (fast)
AWS のモニタリングとトラブルシューティング

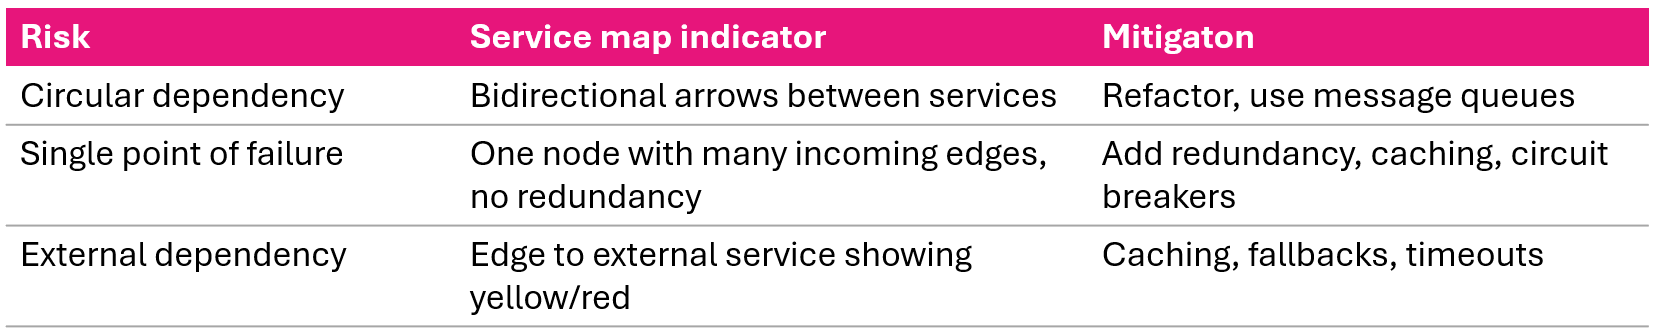
依存関係のリスク


サービスマップの依存関係リスク:循環依存、単一障害点、リスクの高い外部依存

AWS のモニタリングとトラブルシューティング

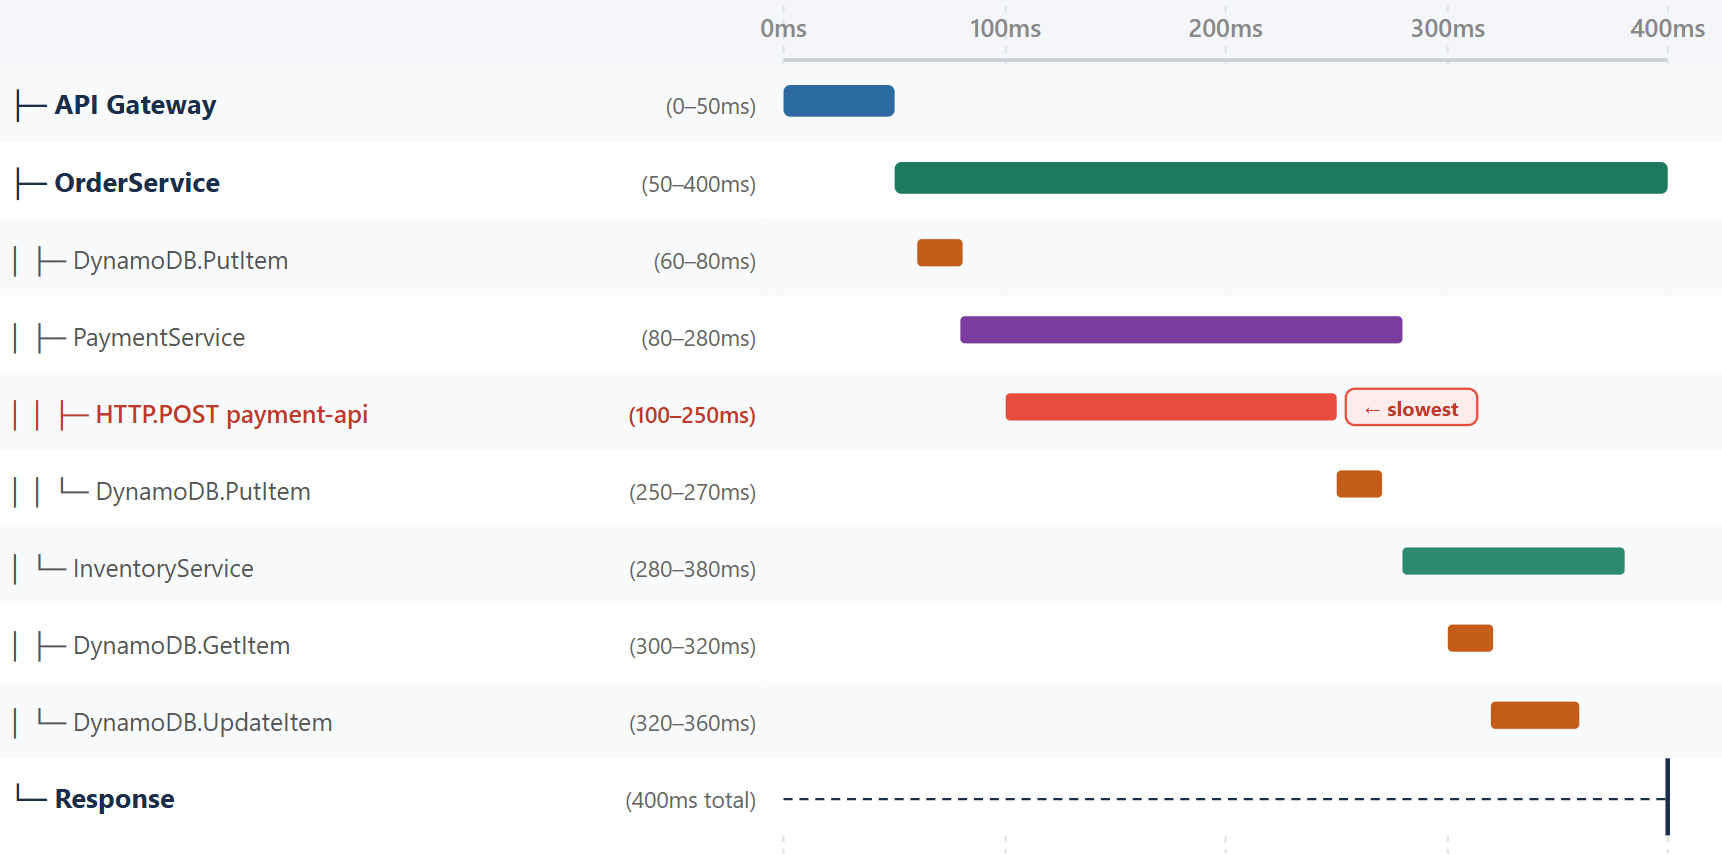
トレースタイムラインの見方


時間軸に沿ってサブセグメントが並ぶトレースタイムライン。payment-api の呼び出しが最も長い処理として表示されている


  • 横軸:時間。処理の開始タイミングと所要時間を示します
  • 縦軸:サービス階層。サブセグメントは親の下にインデントされます
  • payment-api への HTTP.POST(100〜250ms)が最も長い単一処理
AWS のモニタリングとトラブルシューティング

パターン 1:逐次処理のボトルネック


改善前(逐次処理 - 80ms):

Query 1 (10-30ms)
         -> Query 2 (30-50ms)
                  -> Query 3 (50-70ms)
                           -> Query 4 (70-90ms)


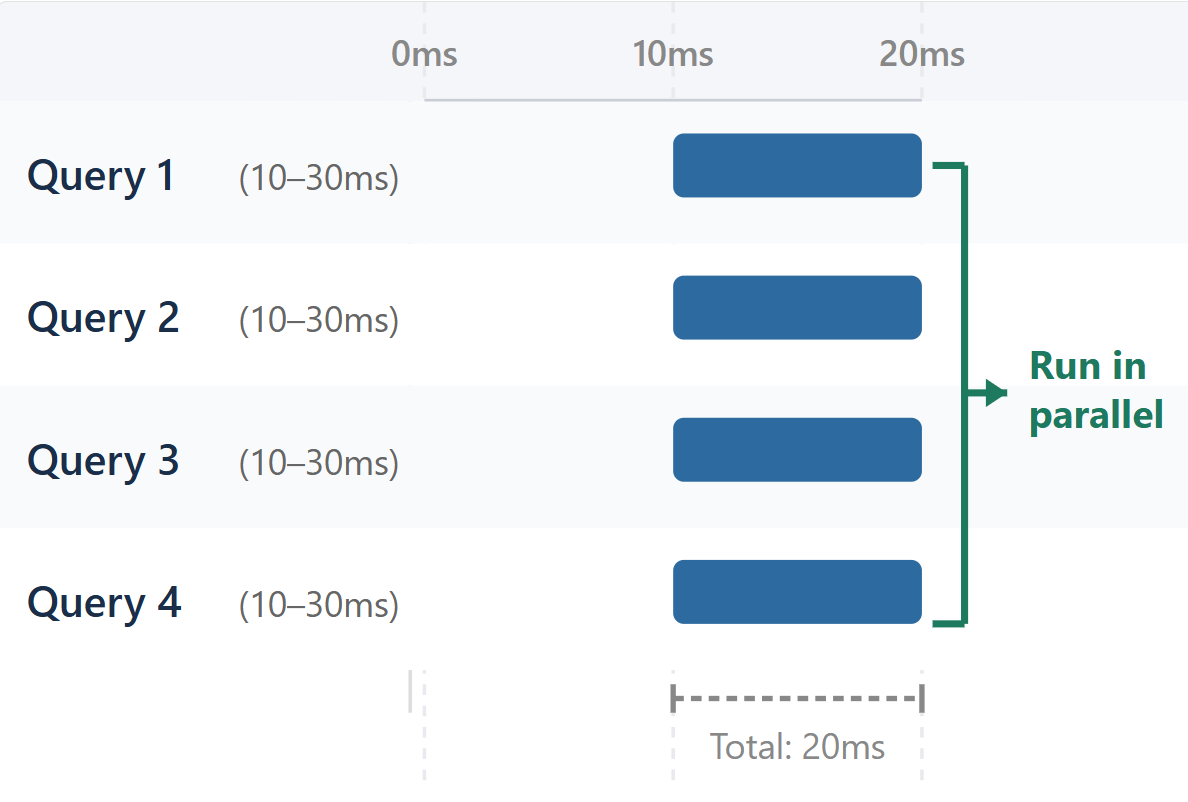
改善後(並列処理 - 20ms):

4つのクエリが並列に実行され、重なりながら 20ms で完了するトレースタイムライン

AWS のモニタリングとトラブルシューティング

パターン 2:N+1 クエリと過剰な細粒度呼び出し


N+1 クエリ問題:

Get user list       (10-20ms)
Get user 1 details  (20-30ms)
Get user 2 details  (30-40ms)
... ×100 sequential queries

解決策:バッチクエリ、積極的ローディング


過剰な細粒度呼び出し:

  • 2つのサービス間で 1回のバッチ処理の代わりに 50回の小さな呼び出し
  • 各呼び出しにコネクション確立・シリアライズ・ラウンドトリップが発生
  • オーバーヘッドが 50倍

解決策:バッチリクエスト、メッセージキュー、キャッシュ

AWS のモニタリングとトラブルシューティング

パターン 3:コールドスタートと連鎖障害


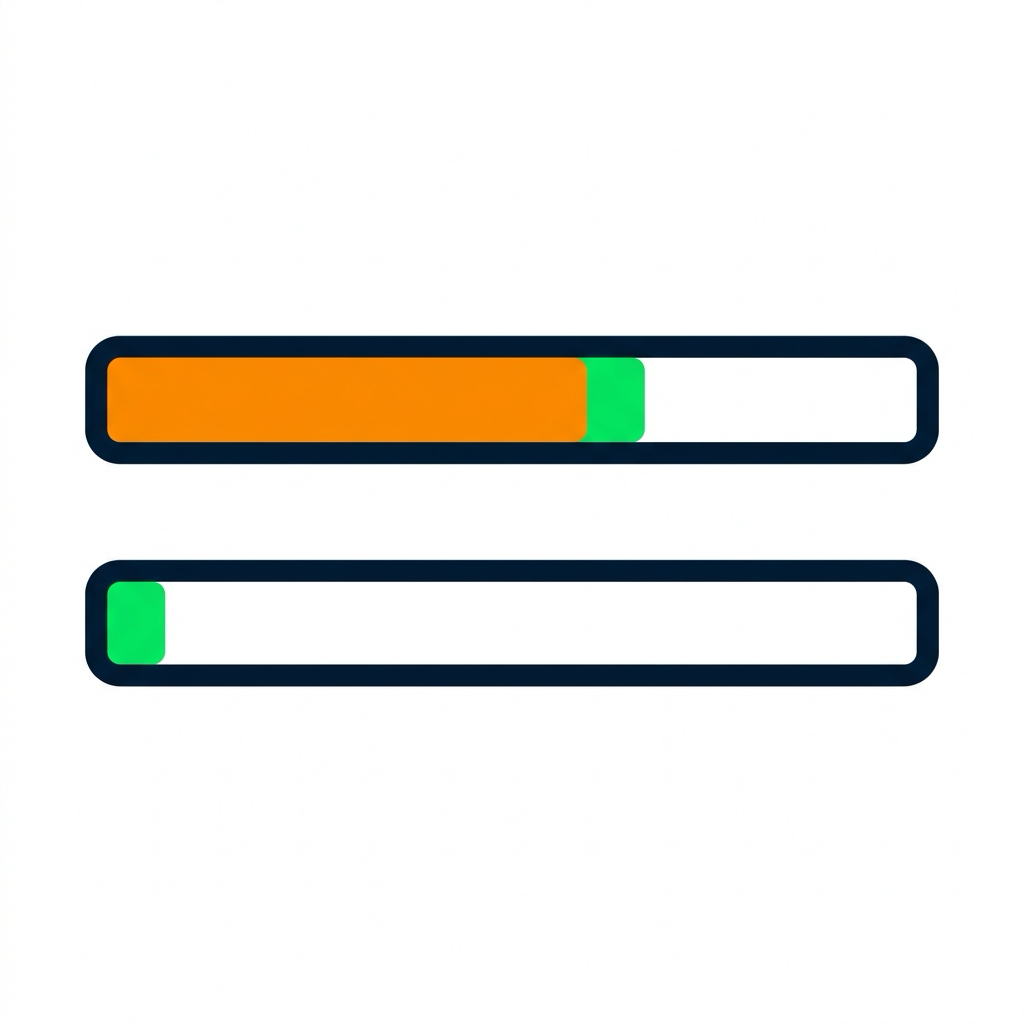
2本のタイムラインバー:コールドスタートは大きなオレンジ色の初期化ブロックの後に小さな緑のハンドラー、ウォームスタートは小さな緑のハンドラーのみ

Lambda コールドスタート:

  • コールド:3000ms(初期化 2500ms + ハンドラー 500ms)
  • ウォーム:500ms(ハンドラーのみ)
  • 初回起動時に大きな初期化セグメントとして表示される

解決策:プロビジョンド同時実行、初期化処理の最適化


連鎖障害:

Service A [Error]
  -> Service B [Timeout 5s]
    -> Service C [Timeout 5s]
      -> Database [Timeout 5s]

トレース階層全体にわたってタイムアウトが積み重なって表示される

解決策:タイムアウト、サーキットブレーカー、フォールバック

AWS のモニタリングとトラブルシューティング

アノテーションによるトレースのフィルタリング

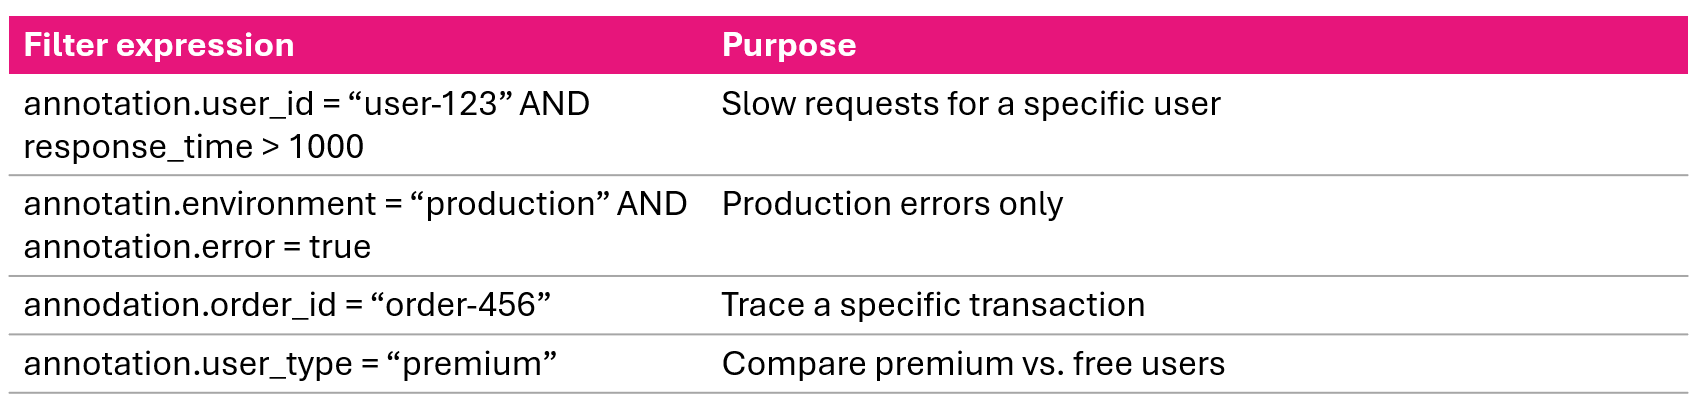
アノテーションのキーと値のペアでトレースをフィルタリングする X-Ray コンソール

グループ比較:

  • プレミアムユーザーの平均 200ms vs. 無料ユーザーの平均 150ms → プレミアム機能がレイテンシを増加させている
  • EU West は US East の 3倍遅い → クロスリージョンのデータアクセスの問題
AWS のモニタリングとトラブルシューティング

トレース分析のワークフロー


  1. 特定 - フィルター:response_time > 1000ms、処理時間で並べ替え
  2. 分析 - 最も時間のかかる処理、逐次ボトルネック、並列化の機会を探す
  3. アノテーション確認 - ビジネスコンテキストのアノテーションを確認:ユーザー ID、注文 ID、環境
  4. レビュー - メタデータを確認:リクエストの詳細、エラーメッセージ
  5. 関連付け - CloudWatch Logs と照合
  6. 診断 - 根本原因の特定:低速クエリ、タイムアウト、アルゴリズム、リソース枯渇
  7. 修正 - コードの最適化、キャッシュの追加、並列化、スケーリング
  8. 確認 - 修正前後のトレースを比較し、レイテンシとエラー率を監視
AWS のモニタリングとトラブルシューティング

X-Ray データを使ったアラートの作成


# High latency alarm
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# High error count alarm
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
AWS のモニタリングとトラブルシューティング

ビデオのまとめ


  • サービスマップ - 自動生成されるアーキテクチャ図:ノード(サービス)、エッジ(接続)、色分けによる正常性表示
  • 色分け - 緑(成功)、黄(4xx)、赤(5xx 障害)、紫(429)、グレー(トラフィックなし)
  • クリティカルパス - 最長の呼び出しチェーン。最適化対象を特定できます
  • トレースタイムライン - 逐次ボトルネック、N+1 クエリ、コールドスタート、連鎖障害を明らかにします
  • アノテーション - ビジネスコンテキストでトレースをフィルタリング・グループ化
  • ワークフロー - 8ステップ:特定 → 分析 → アノテーション確認 → レビュー → 関連付け → 診断 → 修正 → 確認
AWS のモニタリングとトラブルシューティング

トレースとサービスマップの分析

AWS のモニタリングとトラブルシューティング

Preparing Video For Download...