Aperçu et analyse des journaux
Surveillance et dépannage sur AWS

John Q. Martin
Principal Consultant
Structure d'une requête Logs Insights
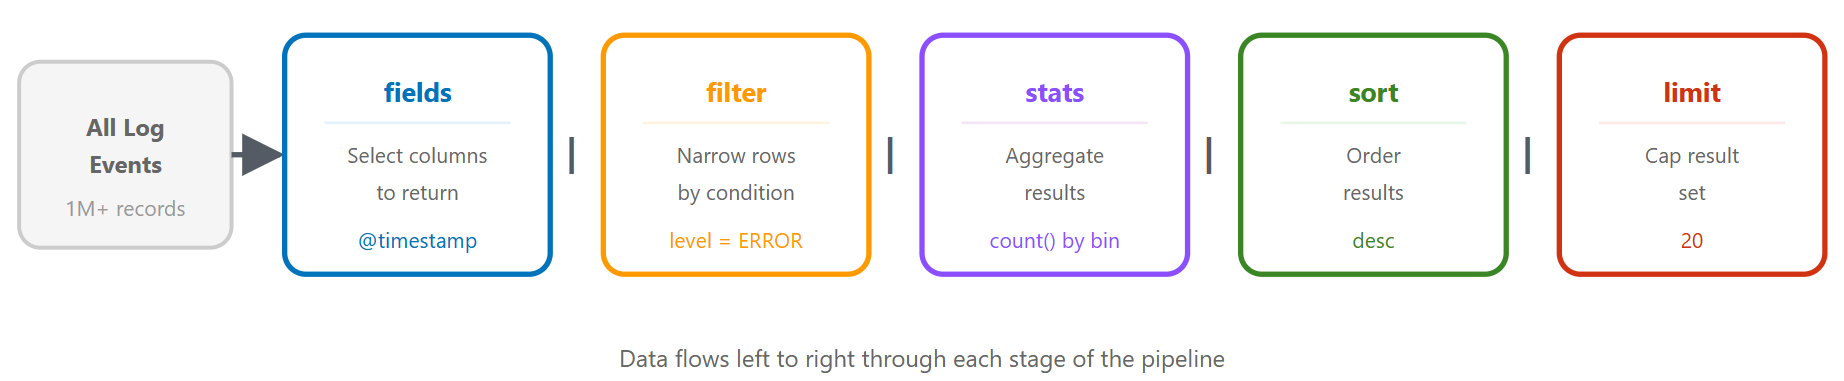
Langages de requête : même requête, trois façons
CloudWatch Logs Insights QL
fields @timestamp, @message, level
| filter level = "ERROR"
| filter @timestamp > ago(1h)
| sort @timestamp desc
| limit 20
OpenSearch PPL
source = `/aws/lambda/my-function`
| where level = 'ERROR' and @timestamp > ago(1h)
| fields @timestamp, @message, level
| sort - @timestamp
| head 20
Langages de requête : OpenSearch SQL
OpenSearch SQL
SELECT `@timestamp`, `@message`, level
FROM `/aws/lambda/my-function`
WHERE level = 'ERROR'
  AND `@timestamp` > ago(1h)
ORDER BY `@timestamp` DESC
LIMIT 20
- Syntaxe standard SELECT / FROM / WHERE
- Ajoute des JOIN entre des groupes de journaux
- Choisissez ce qui convient à votre équipe
Scénario 1 : repérer les pics d'erreurs
fields @timestamp, @message, level
| filter level = "ERROR"
| stats count() as error_count by bin(5m)
| sort @timestamp desc
Amélioré : regrouper par type d'erreur
fields @timestamp, error_type, error_message
| filter level = "ERROR"
| stats count() as count by error_type, bin(5m)
| sort count desc
Scénario 2 : points de terminaison API lents
fields @timestamp, endpoint, response_time, status_code
| filter response_time > 1000
| stats avg(response_time) as avg_time,
        max(response_time) as max_time,
        count() as slow_requests
        by endpoint
| sort avg_time desc
Analyse détaillée
fields @timestamp, endpoint, response_time, user_id, request_id
| filter endpoint = "/api/users" and response_time > 1000
| sort response_time desc
| limit 20
Scénario 3 : authentifications échouées
fields @timestamp, user_id, ip_address, action
| filter action = "login_failed"
| stats count() as failed_attempts by user_id, ip_address
| sort failed_attempts desc
| limit 50
Analyse temporelle
fields @timestamp, user_id, ip_address
| filter action = "login_failed"
| stats count() as attempts by ip_address, bin(1h)
| filter attempts > 10
| sort attempts desc
Scénarios 4 et 5 : expirations DB et fuites de mémoire
Expirations de base de données
fields @timestamp, @message
| filter @message like /database/ and @message like /timeout|error|failed/
| parse @message "timeout after * seconds" as timeout_duration
| stats count() as timeout_count,
        avg(timeout_duration) as avg_timeout
        by bin(5m)
Détection de fuite de mémoire
fields @timestamp, memory_used_mb, heap_size_mb
| stats avg(memory_used_mb) as avg_memory,
        max(memory_used_mb) as max_memory
        by bin(1h)
| sort @timestamp asc
Scénario 6 : traçage d'une requête
fields @timestamp, @message, request_id, service, action
| filter request_id = "abc123def456"
| sort @timestamp asc
Trace multi‑service
fields @timestamp, service, action, duration_ms, status
| filter request_id = "abc123def456"
| sort @timestamp asc
| display @timestamp, service, action, duration_ms, status
Techniques avancées : parse, Regex
Analyse de journaux non structurés
fields @timestamp, @message
| parse @message "[*] User * failed to access resource * from IP *"
    as level, user, resource, ip
Analyse par expressions rationnelles (Regex)
| parse @message /Request completed in (?<duration>\d+)ms with status (?<status>\d+)/
Techniques avancées : champs calculés
fields @timestamp, requests, errors
| fields error_rate = (errors / requests) * 100

fields @timestamp, status_code
| fields status_category =
    case(status_code < 300, "success",
         status_code < 500, "client_error",
         status_code >= 500, "server_error")
| stats count() as request_count by status_category
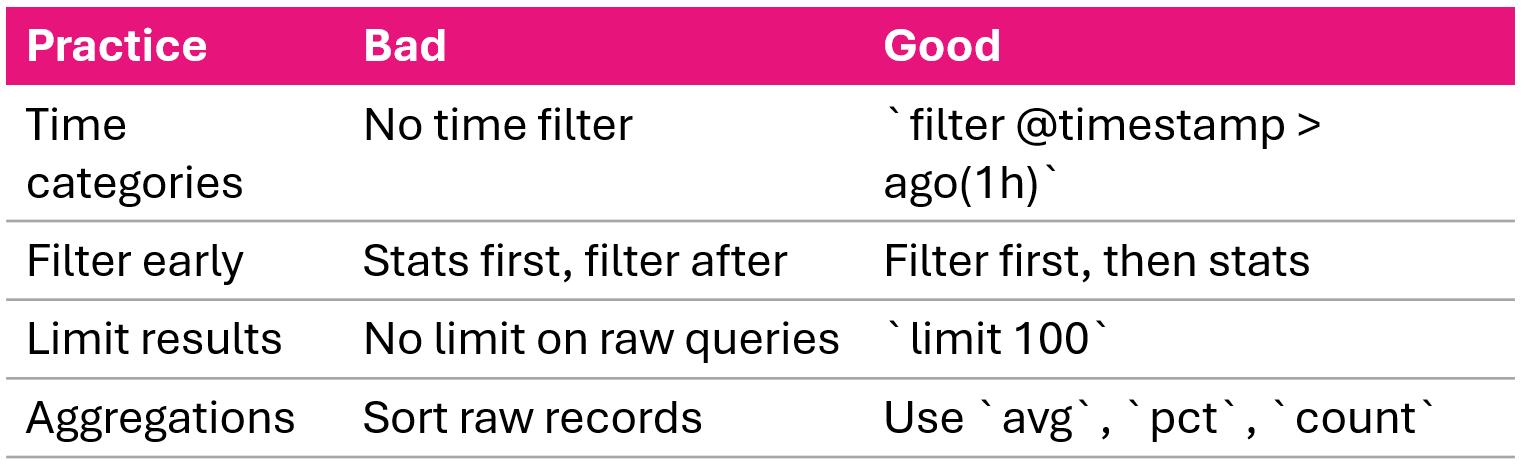
Optimisation des requêtes
Détection d'anomalies et corrélation
Détection d'anomalies statistiques
- Calculer la base de référence : moyenne et éc.‑type sur 7 jours
- Comparer la période actuelle à cette base
- Marquer comme anormales les valeurs > 2 écarts types
Corrélation du taux d'erreur
fields @timestamp, level
| stats count() as total_requests,
        sum(case(level = "ERROR", 1, 0)) as errors
        by bin(5m)
| fields error_rate = (errors / total_requests) * 100
Résumé
- CloudWatch Logs Insights : service de requêtes interactif, sans infrastructure
- Trois langages : Logs Insights QL, OpenSearch PPL, OpenSearch SQL
- Six scénarios de dépannage : pics d'erreurs, points lents, auth échouée, expirations BD, fuites de mémoire, traçage de requêtes
- Techniques avancées :
parsepour texte non structuré,bin()pour séries temporelles,pct()pour percentiles - Corrélation et détection d'anomalies : analyse du taux d'erreur, comparaison à une base statistique
- De l'enquête à l'automatisation : filtres de mesures et alarmes bouclent la boucle
Passons à la pratique !
Surveillance et dépannage sur AWS

