Tableaux de bord de santé applicative
Surveillance et dépannage sur AWS

John Q. Martin
Principal Consultant
Conception de tableau de bord : hiérarchie de l'information
Comme à l'hôpital : accueil → unité → spécialiste
Les quatre signaux d'or
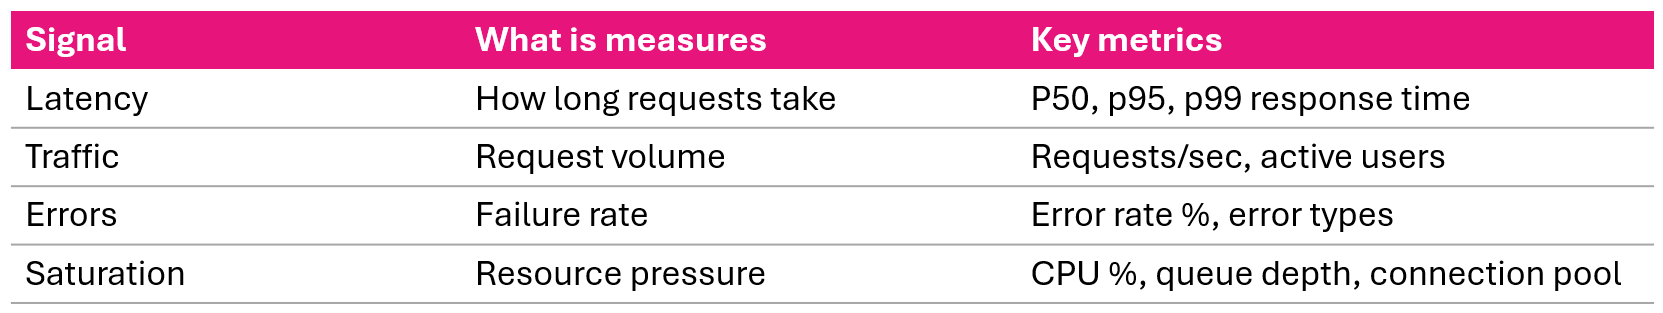
Couvrez ces quatre aspects et vous couvrez la grande majorité des problèmes.
La méthode RED
RED pour les services à requêtes :
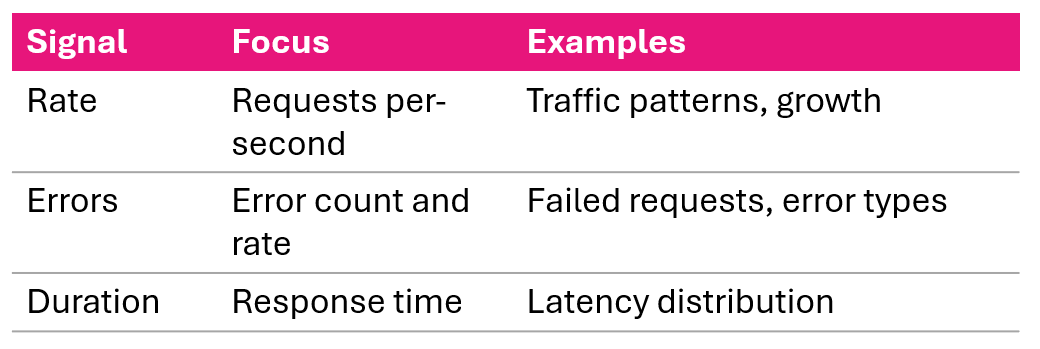
Trois sources de données
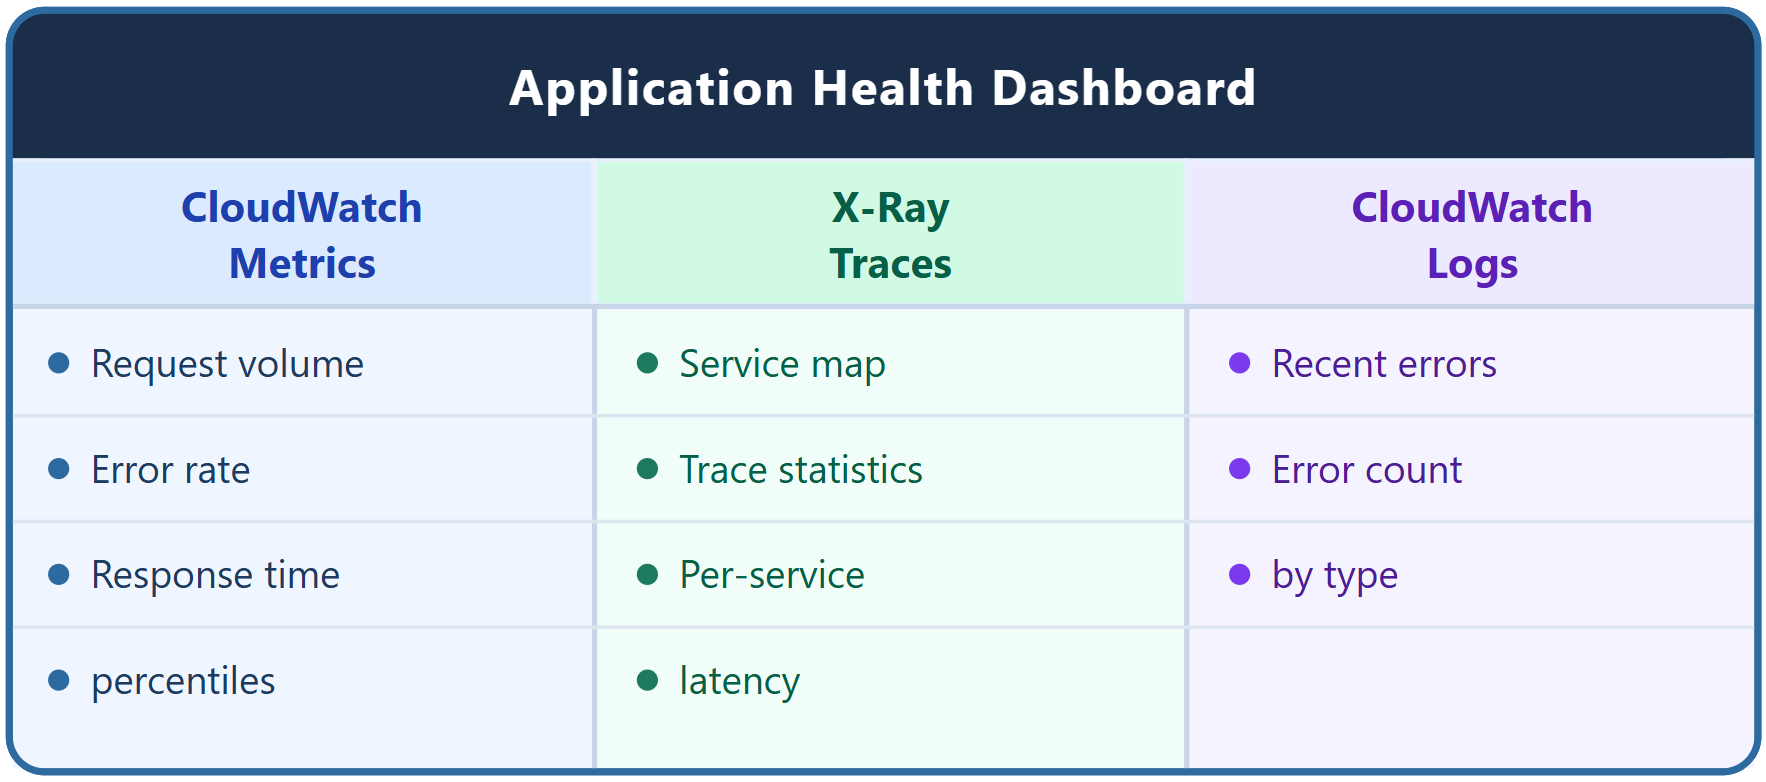
Disposition complète du tableau de bord
Flux de dépannage d'incident
Comme au triage à l'urgence : stabiliser → diagnostiquer → traiter → vérifier
Scénario 1 : pic de trafic soudain
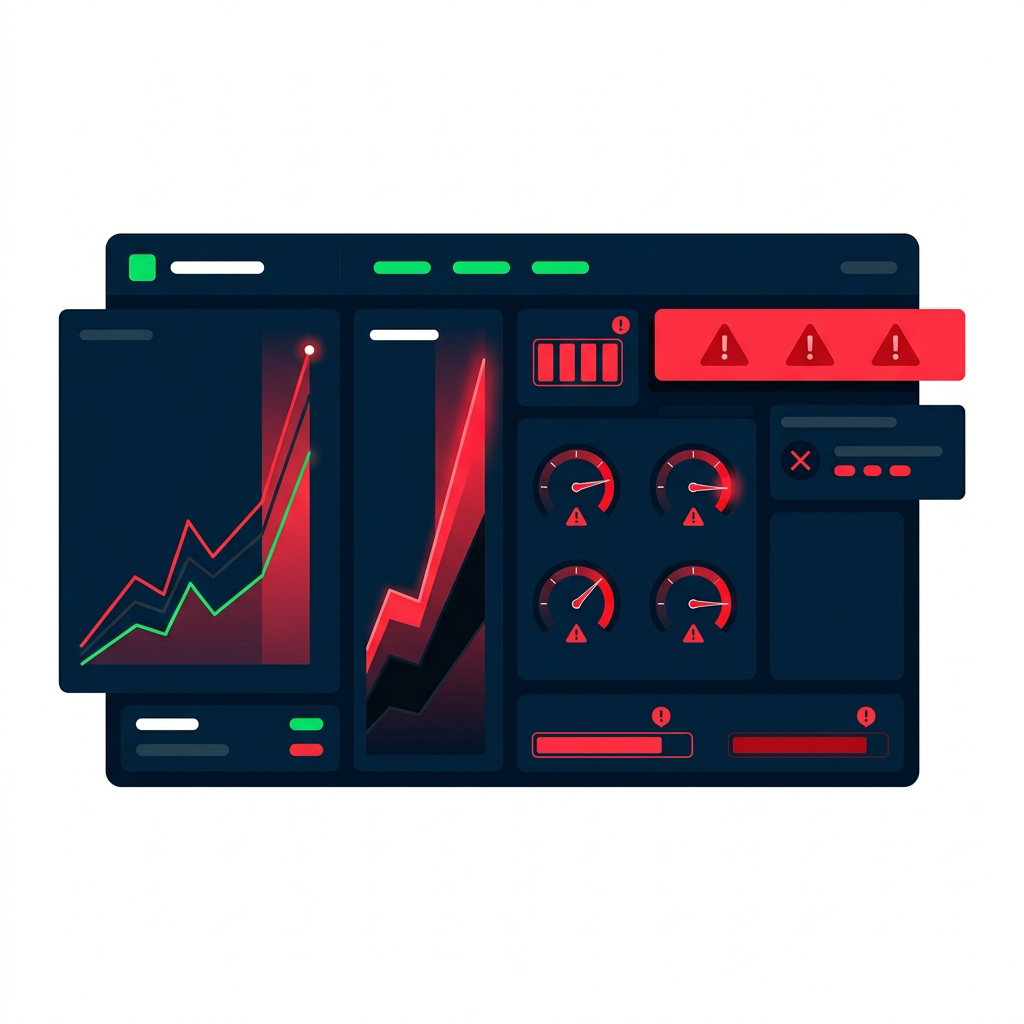
Ce que vous voyez sur le tableau de bord :
- Volume de requêtes 10× la normale
- Taux d'erreurs 25 %
- Latence 3000 ms
- CPU 95 %
Analyse : Ressources saturées par une flambée de trafic
Scénario 2 : goulot d'étranglement BD
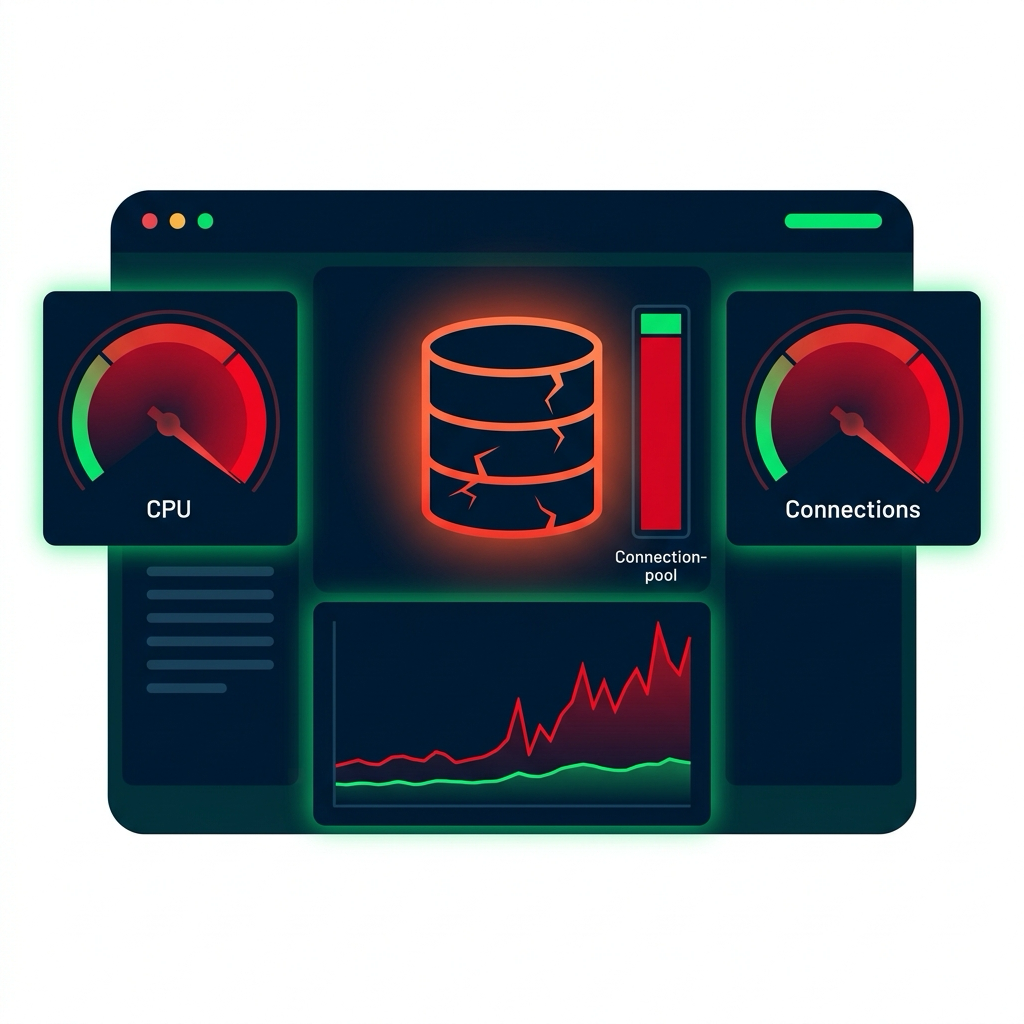
Ce que vous voyez sur le tableau de bord :
- CPU BD 95 %
- Connexions BD 95/100
- Latence des requêtes 5000 ms
- Latence appli 5500 ms
Analyse : La base de données est le goulot ; requêtes lentes qui épuisent le bassin de connexions
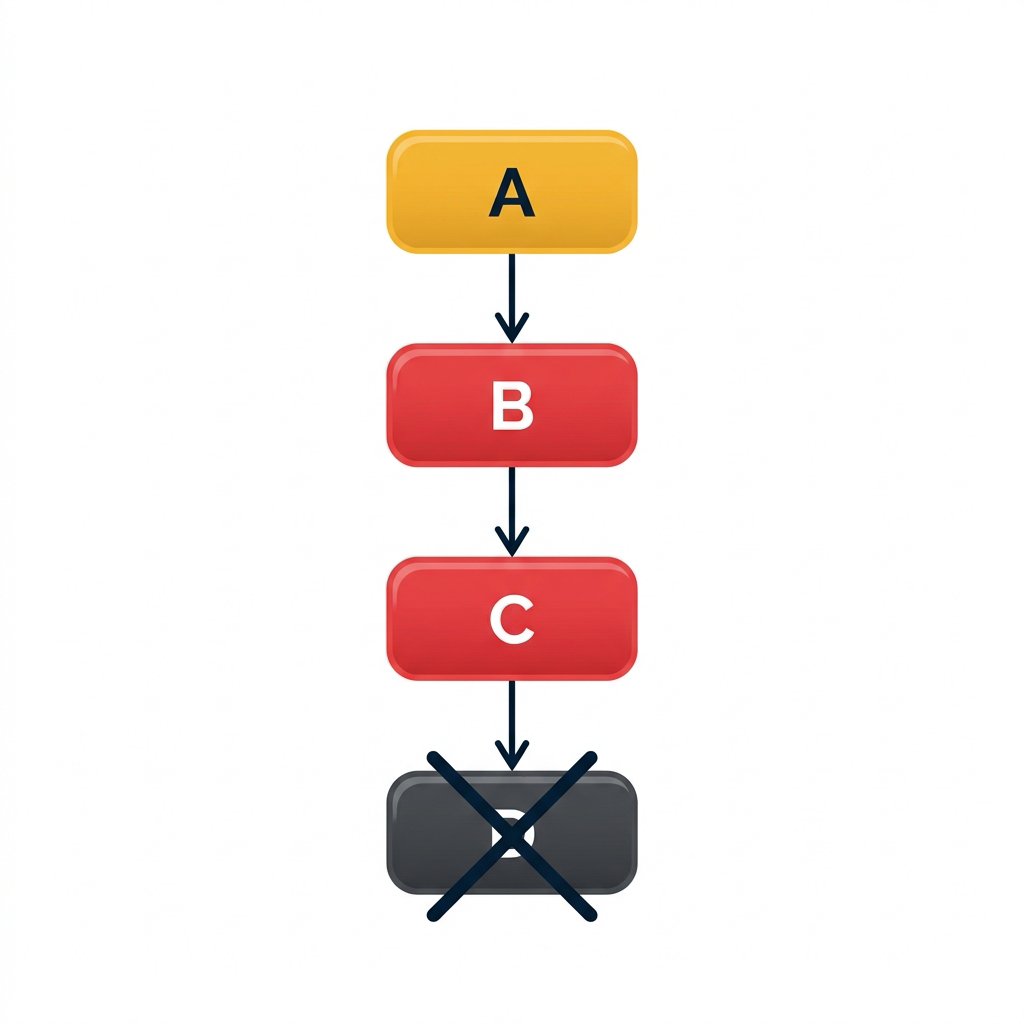
Scénario 3 : défaillance en cascade
Ce que vous voyez sur la carte des services :
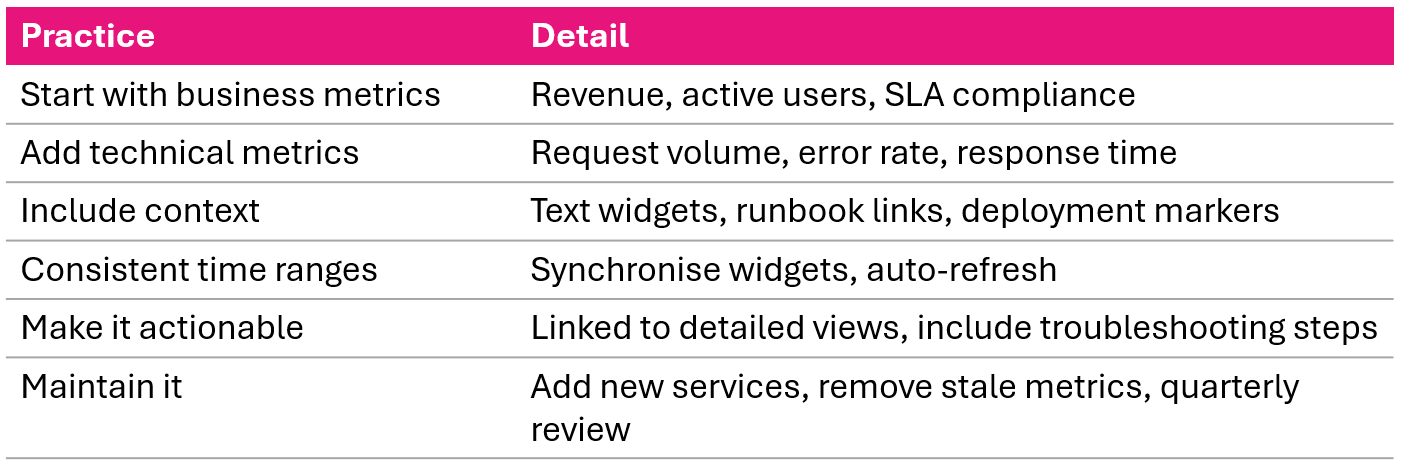
Pratiques exemplaires pour tableaux de bord