Analyse des traces et des cartes de services

Surveillance et dépannage sur AWS

John Q. Martin

Principal Consultant

Qu'est-ce qu'une carte de services ?


Généré automatiquement à partir de vos traces : aucune configuration manuelle
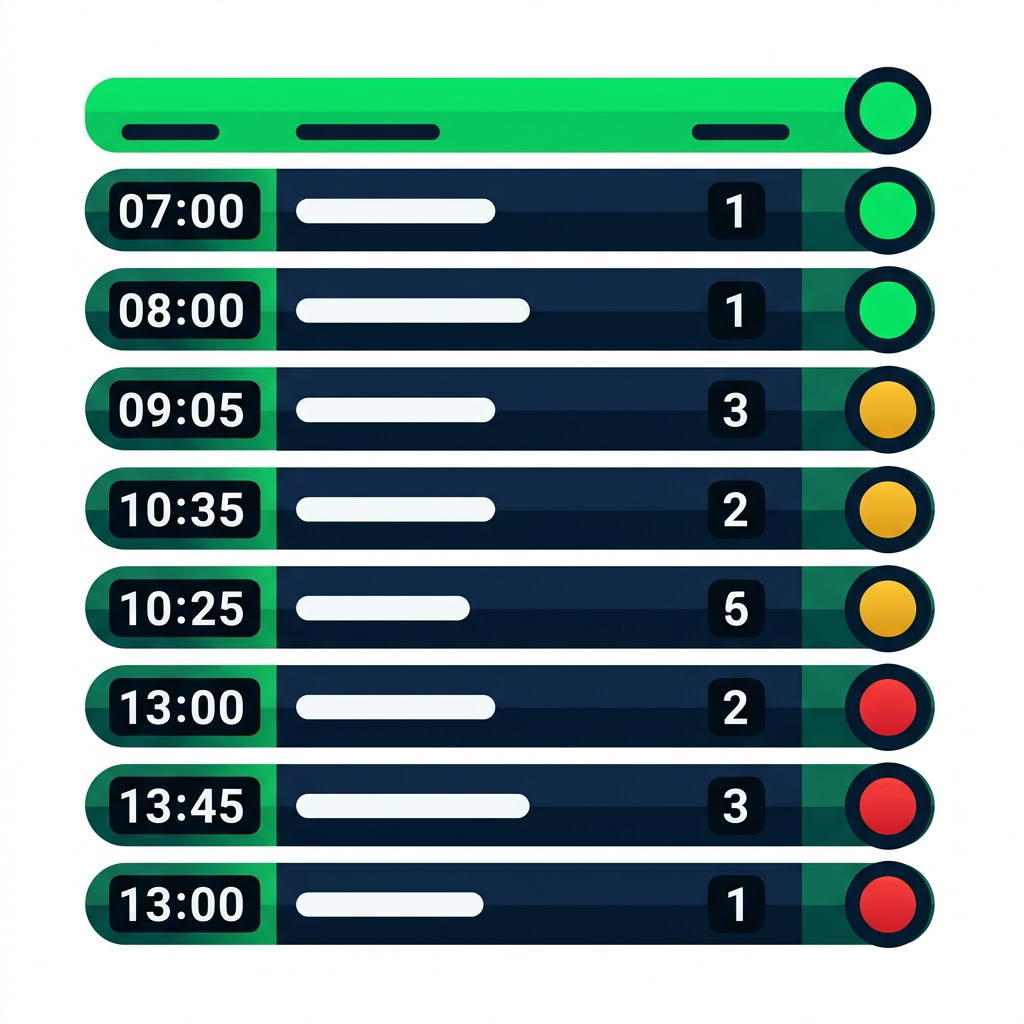
Tableau des départs ferroviaires avec des rangées de services, chacun avec un voyant coloré : vert à l'heure, ambre en retard, rouge arrêté

Coup d'œil : vert = à l'heure · ambre = en retard · rouge = arrêté


Y accéder :

  • Console X-Ray → Service map
  • Appliquer des filtres
  • Cliquer un nœud → détails approfondis
Surveillance et dépannage sur AWS

Code de couleurs de la carte de services
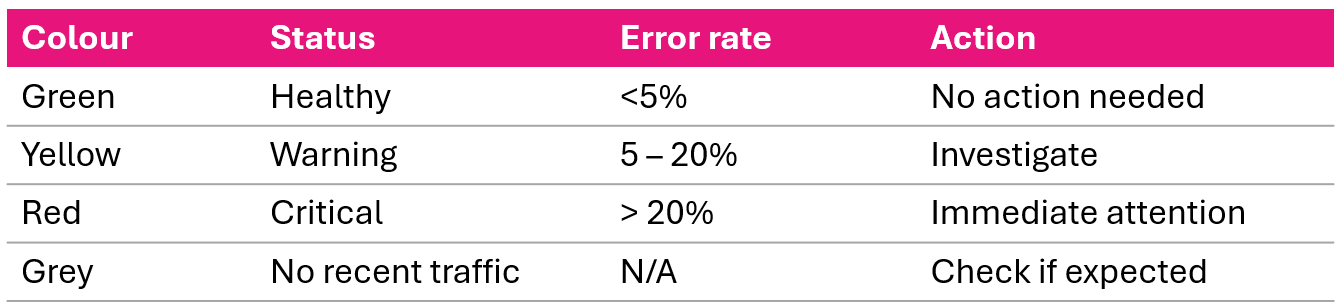
 

Légende des couleurs de la carte de services : vert appels réussis, jaune erreurs client, rouge pannes serveur, violet limitation, gris aucun trafic

Quand vous ouvrez une carte, allez directement à tout ce qui n'est pas vert.

Cliquez sur un nœud pour voir : distribution des temps de réponse, répartition des statuts HTTP, types d'erreurs.

Surveillance et dépannage sur AWS

Lire une carte de services


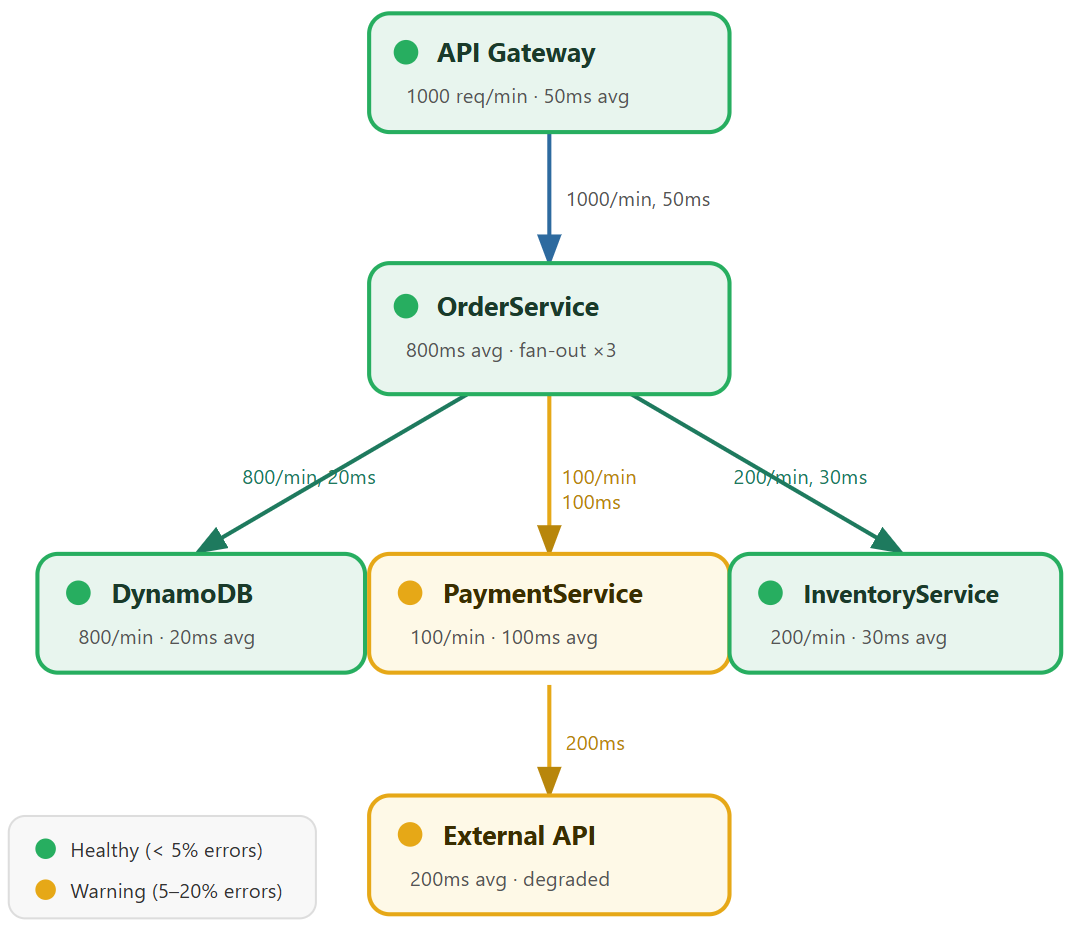
Carte de services où API Gateway et OrderService se déploient vers DynamoDB Inventory et un service Payment en jaune

Surveillance et dépannage sur AWS

Analyse du chemin critique


Chemin critique = plus longue chaîne d'appels

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Total : 400ms

External API = 50 % de la latence totale


À en faire :

  • External API est votre cible d'optimisation
  • Options : ajouter de la mise en cache, implémenter délai d'attente + solution de rechange, négocier les SLA

Comparer une autre voie :

OrderService -> DynamoDB
Total : 120ms (rapide)
Surveillance et dépannage sur AWS

Risques de dépendance


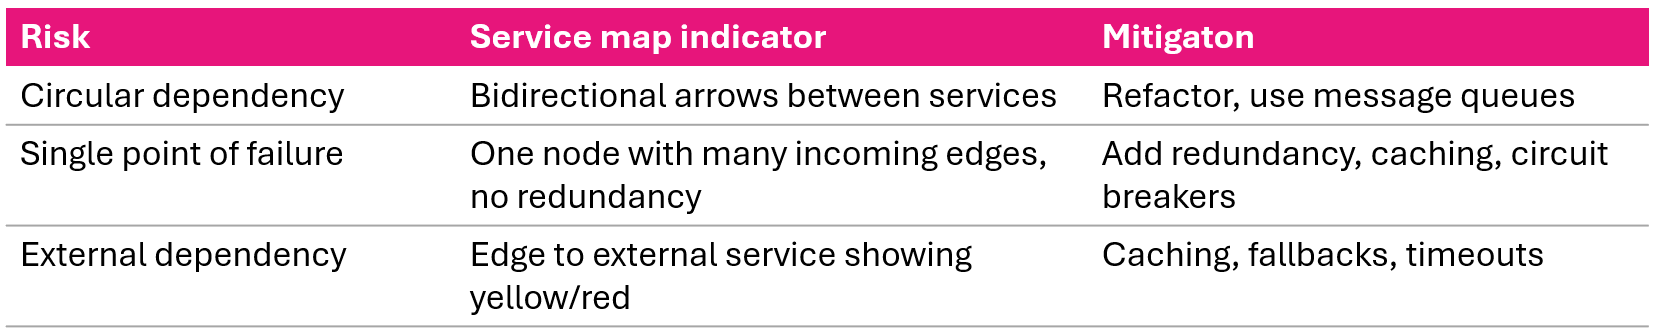
Carte de services illustrant les risques : dépendances circulaires, points de défaillance uniques et dépendances externes risquées

Surveillance et dépannage sur AWS

Comprendre les chronologies de traces
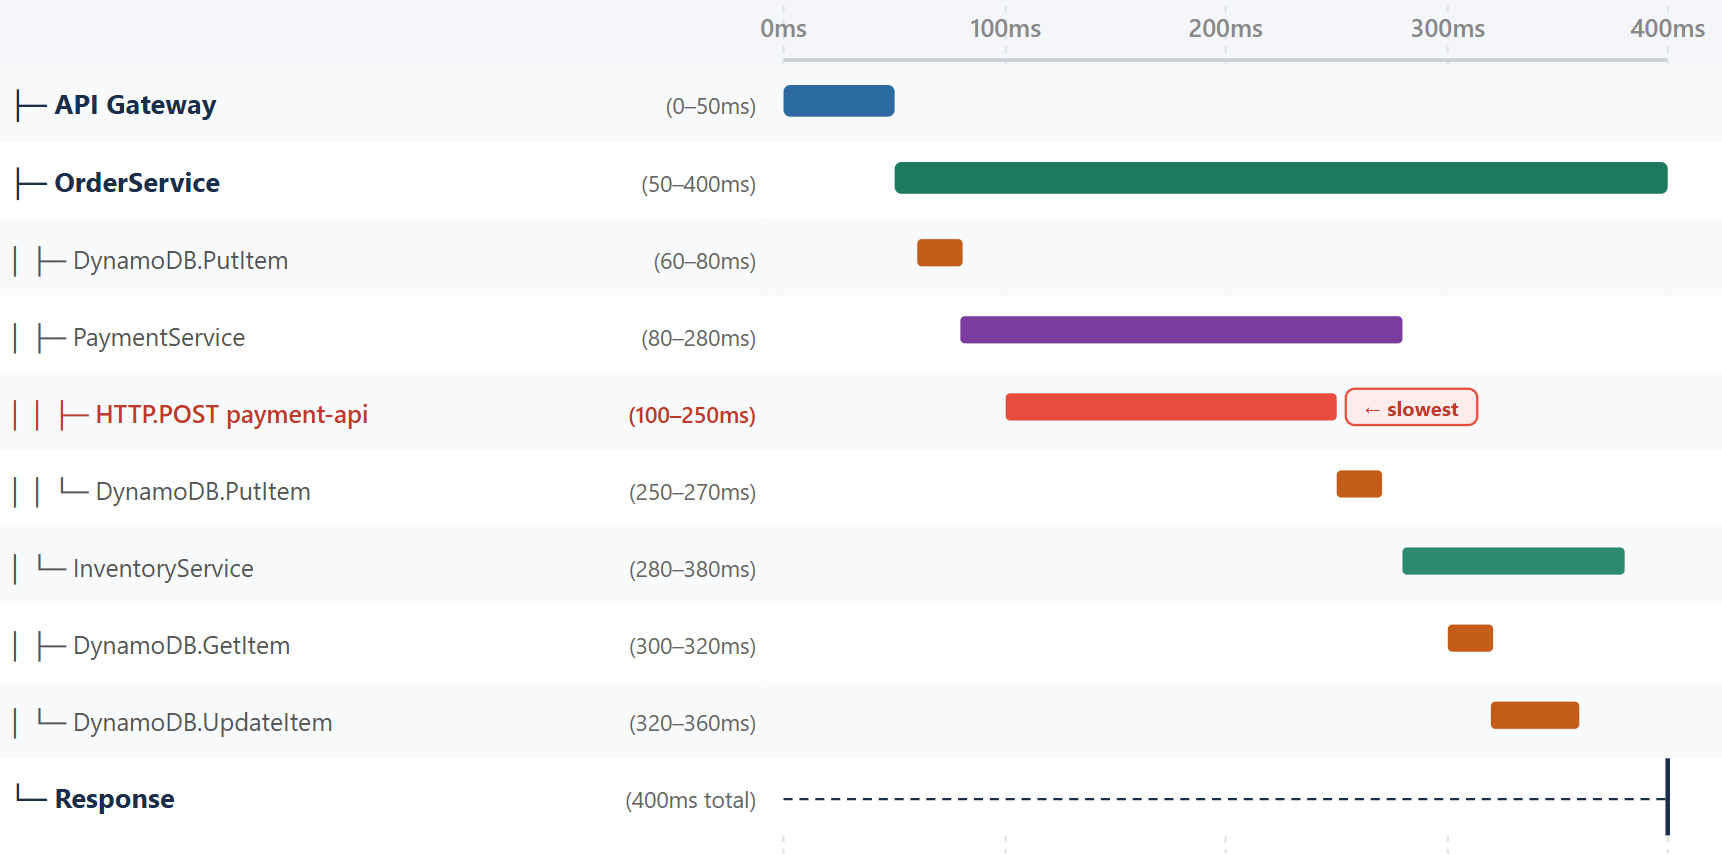
 

Chronologie de trace avec sous-segments le long d'un axe temporel montrant un appel payment-api comme l'opération la plus longue


  • Axe horizontal temps : quand les opérations ont commencé et leur durée
  • Axe vertical hiérarchie des services : sous-segments en retrait sous les parents
  • HTTP.POST vers payment-api (100-250ms) = l'opération la plus longue
Surveillance et dépannage sur AWS

Modèle 1 : Goulots d'étranglement séquentiels


Avant (séquentiel - 80ms) :

Query 1 (10-30ms)
         -> Query 2 (30-50ms)
                  -> Query 3 (50-70ms)
                           -> Query 4 (70-90ms)


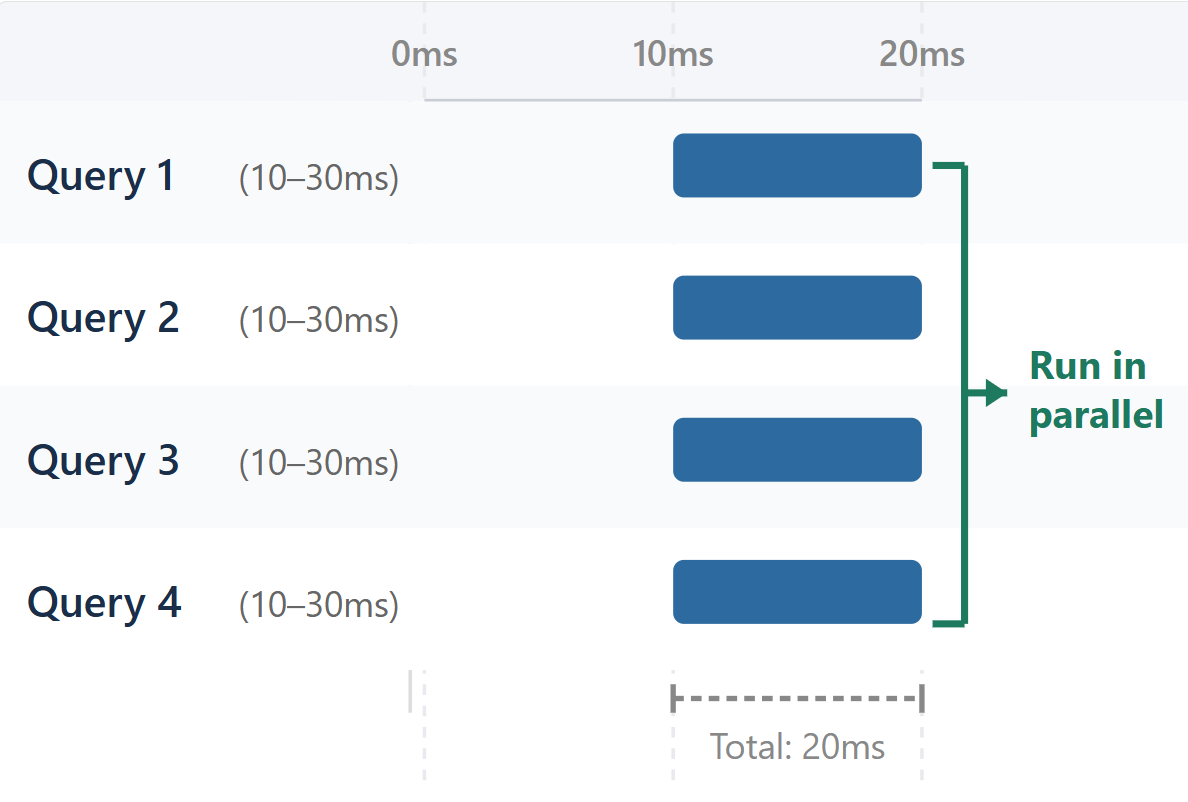
Après (parallèle - 20ms) :

Chronologie de trace de quatre requêtes s'exécutant en parallèle et se chevauchant pour finir en 20ms

Surveillance et dépannage sur AWS

Modèle 2 : Requêtes N+1 et services bavards


Problème de requêtes N+1 :

Get user list       (10-20ms)
Get user 1 details  (20-30ms)
Get user 2 details  (30-40ms)
... ×100 requêtes séquentielles

Correctif : regrouper les requêtes, chargement hâtif


Services bavards :

  • 50 petits appels entre deux services au lieu d'un lot
  • Chaque appel : établissement de connexion + sérialisation + aller-retour
  • 50× la surcharge

Correctif : regrouper les demandes, files de messages, mise en cache

Surveillance et dépannage sur AWS

Modèle 3 : Démarrages à froid et défaillances en cascade
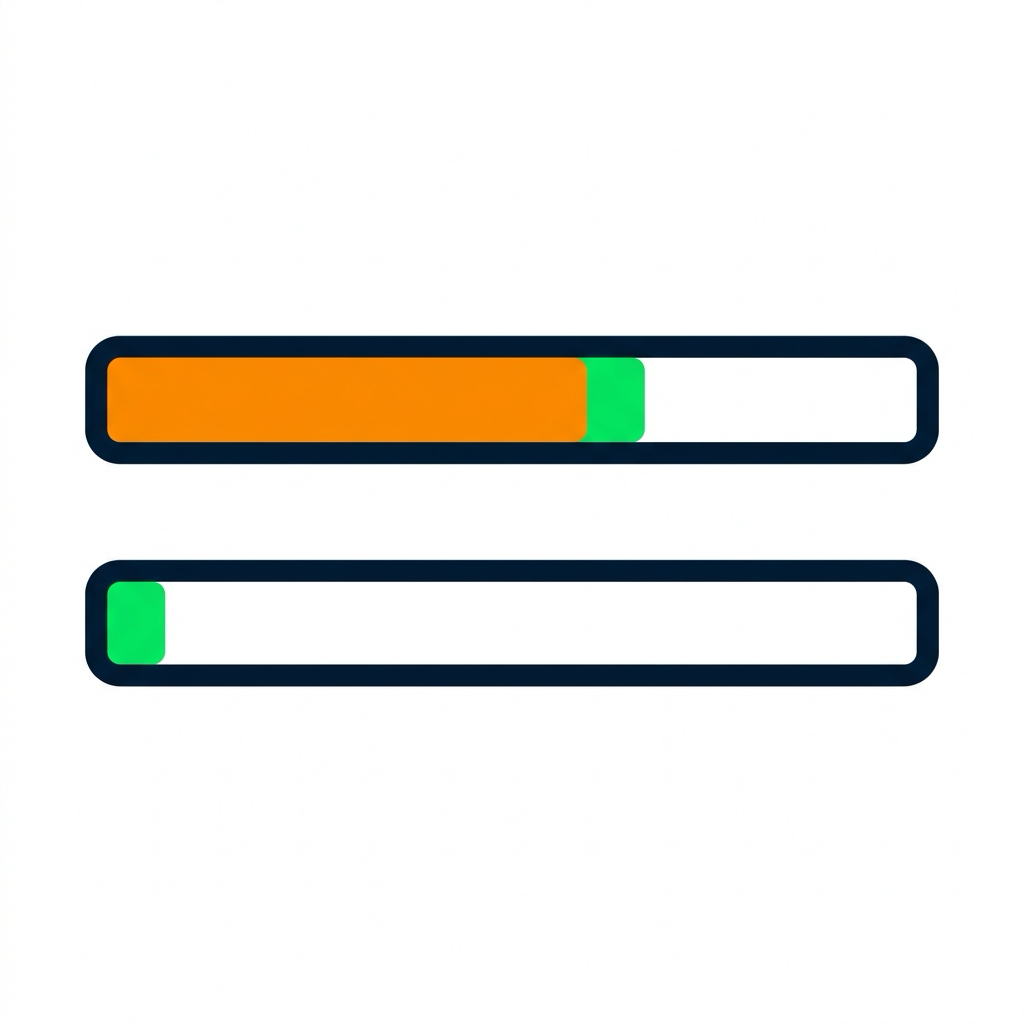
 

Deux barres de chronologie : un démarrage à froid a un grand bloc orange d'initialisation puis un petit gestionnaire vert ; un démarrage à chaud n'affiche que le petit gestionnaire vert

Démarrage à froid Lambda :

  • À froid : 3000ms (2500ms init + 500ms gestionnaire)
  • À chaud : 500ms (gestionnaire seulement)
  • Visible comme un grand segment d'init au premier appel

Correctif : simultanéité provisionnée, optimiser l'initialisation


Défaillance en cascade :

Service A [Error]
  -> Service B [Timeout 5s]
    -> Service C [Timeout 5s]
      -> Database [Timeout 5s]

Blocs de délai d'attente correspondants empilés dans la hiérarchie de la trace

Correctif : délais d'attente, coupe-circuits, solutions de rechange

Surveillance et dépannage sur AWS

Filtrer les traces avec des annotations
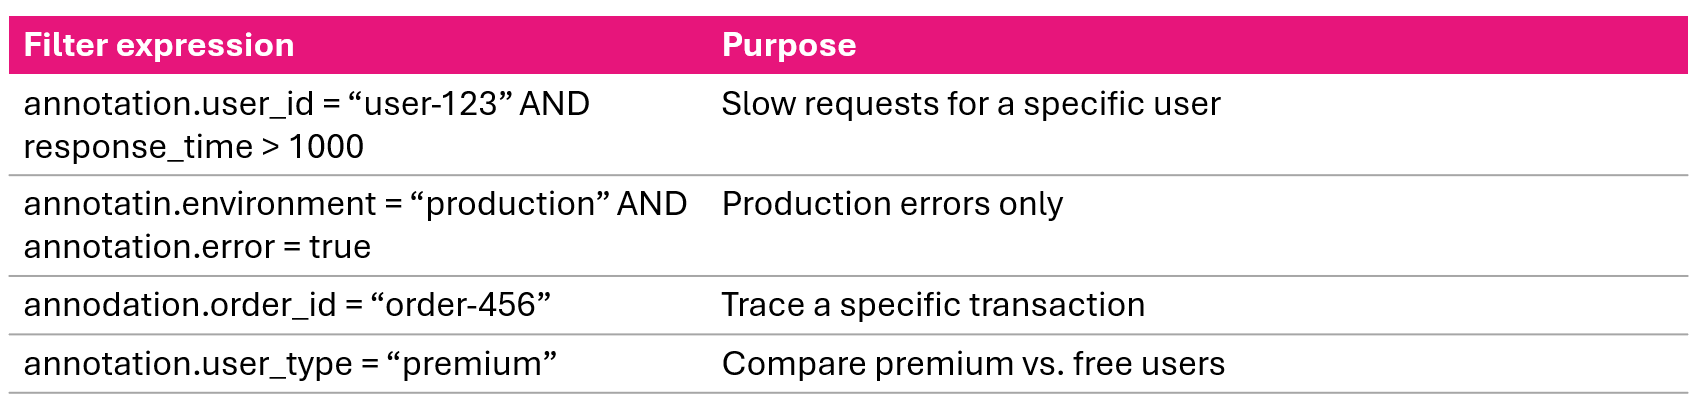
Console X-Ray filtrant les traces par paires clé-valeur d'annotations

Comparer des groupes :

  • Utilisateurs Premium moy. 200ms vs. gratuits moy. 150ms → fonctionnalités premium ajoutent de la latence
  • UE Ouest 3× plus lent que US Est → problème d'accès interrégional aux données
Surveillance et dépannage sur AWS

Flux d'analyse des traces


  1. Identifier - filtrer : response_time > 1000ms, trier par durée
  2. Analyser - repérer opérations les plus longues, goulots séquentiels, parallélisme possible
  3. Annoter - vérifier les annotations pour le contexte d'affaires : ID utilisateur, ID commande, environnement
  4. Réviser - examiner les métadonnées : détails de la requête, messages d'erreur
  5. Corréler - recouper avec CloudWatch Logs
  6. Diagnostiquer - cause première : requête lente, délai d'attente, algorithme, ressources épuisées
  7. Corriger - optimiser le code, ajouter de la mise en cache, paralléliser, mettre à l'échelle
  8. Vérifier - comparer les traces avant/après, suivre latence et taux d'erreurs
Surveillance et dépannage sur AWS

Créer des alertes à partir des données X-Ray


# Alarme de forte latence
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# Alarme de nombre élevé d'erreurs
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
Surveillance et dépannage sur AWS

Résumé vidéo


  • Cartes de services - diagrammes d'architecture générés automatiquement : nœuds (services), arêtes (connexions), état codé par couleur
  • Code de couleurs - vert (succès), jaune (4xx), rouge (pannes 5xx), violet (429), gris (aucun trafic)
  • Chemin critique - plus longue chaîne d'appels, cible d'optimisation
  • Chronologies de traces - révèlent goulots séquentiels, requêtes N+1, démarrages à froid, défaillances en cascade
  • Annotations - filtrer et regrouper les traces par contexte d'affaires
  • Flux de travail - huit étapes : identifier → analyser → annoter → réviser → corréler → diagnostiquer → corriger → vérifier
Surveillance et dépannage sur AWS

Analyse des traces et des cartes de services

Surveillance et dépannage sur AWS

Preparing Video For Download...