Alarmes et notifications CloudWatch

Surveillance et dépannage sur AWS

John Q. Martin

Principal Consultant

Qu'est‑ce que les alarmes CloudWatch
 

Concepts clés

  • Surveille une seule mesure sur une période
  • Agit quand la mesure dépasse un seuil


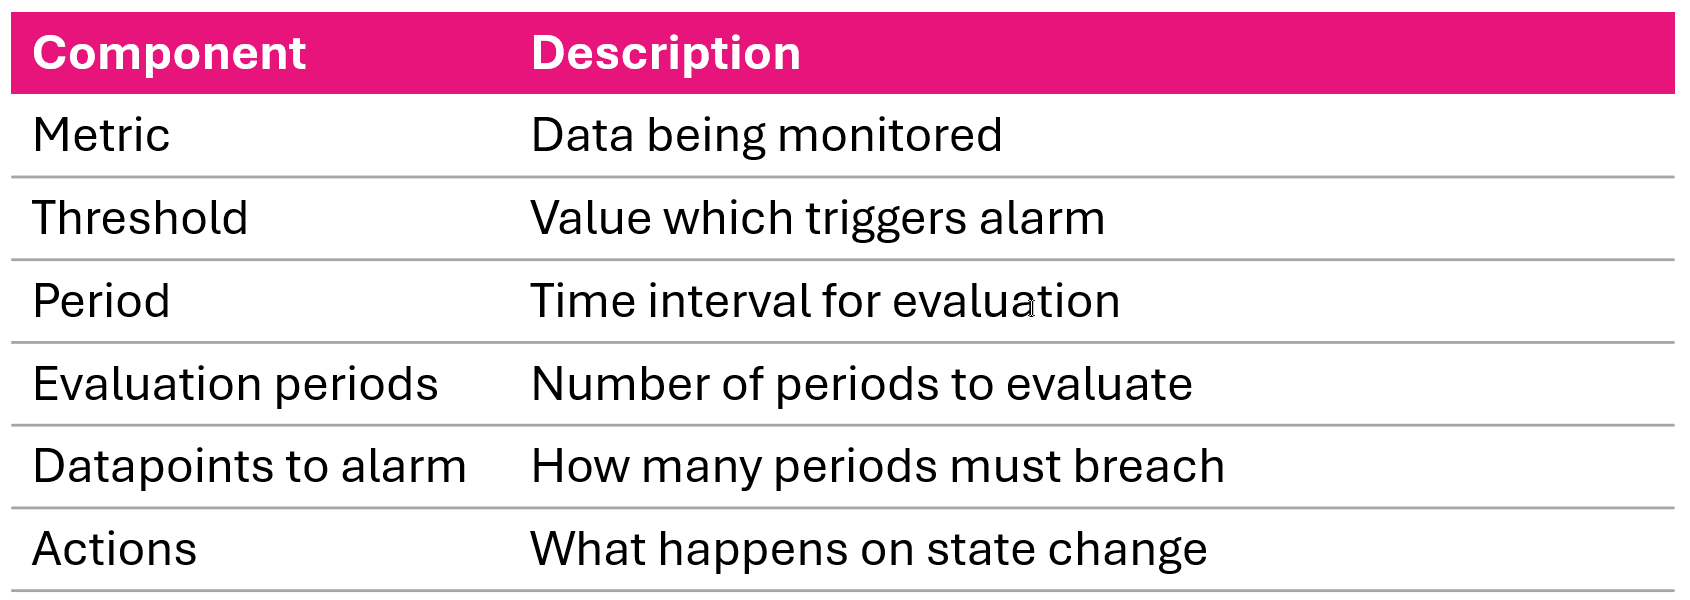
Six composants clés d'une alarme CloudWatch : metric threshold period evaluation periods datapoints to alarm and actions

Surveillance et dépannage sur AWS

États d'alarme

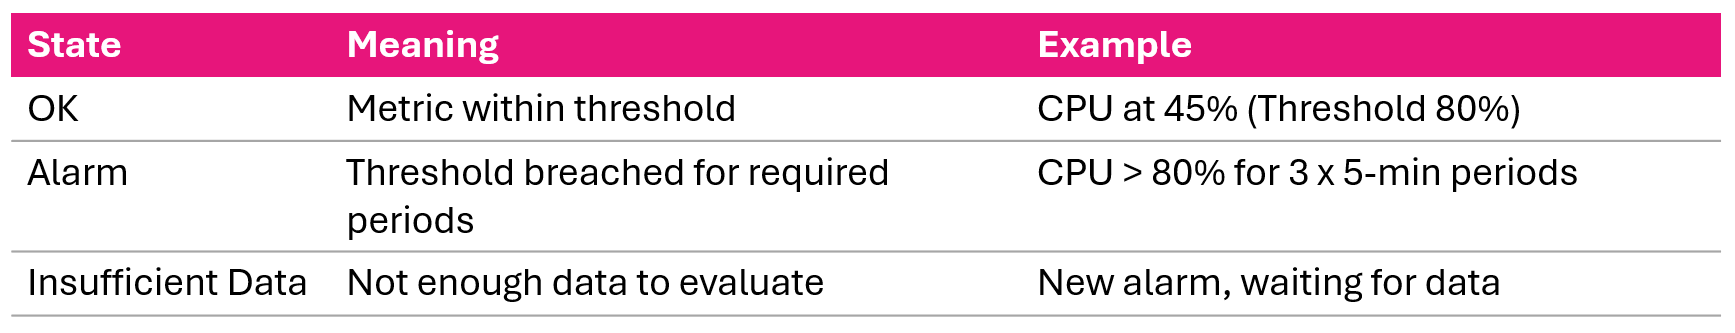
Les trois états d'une alarme CloudWatch : OK ALARM et INSUFFICIENT_DATA

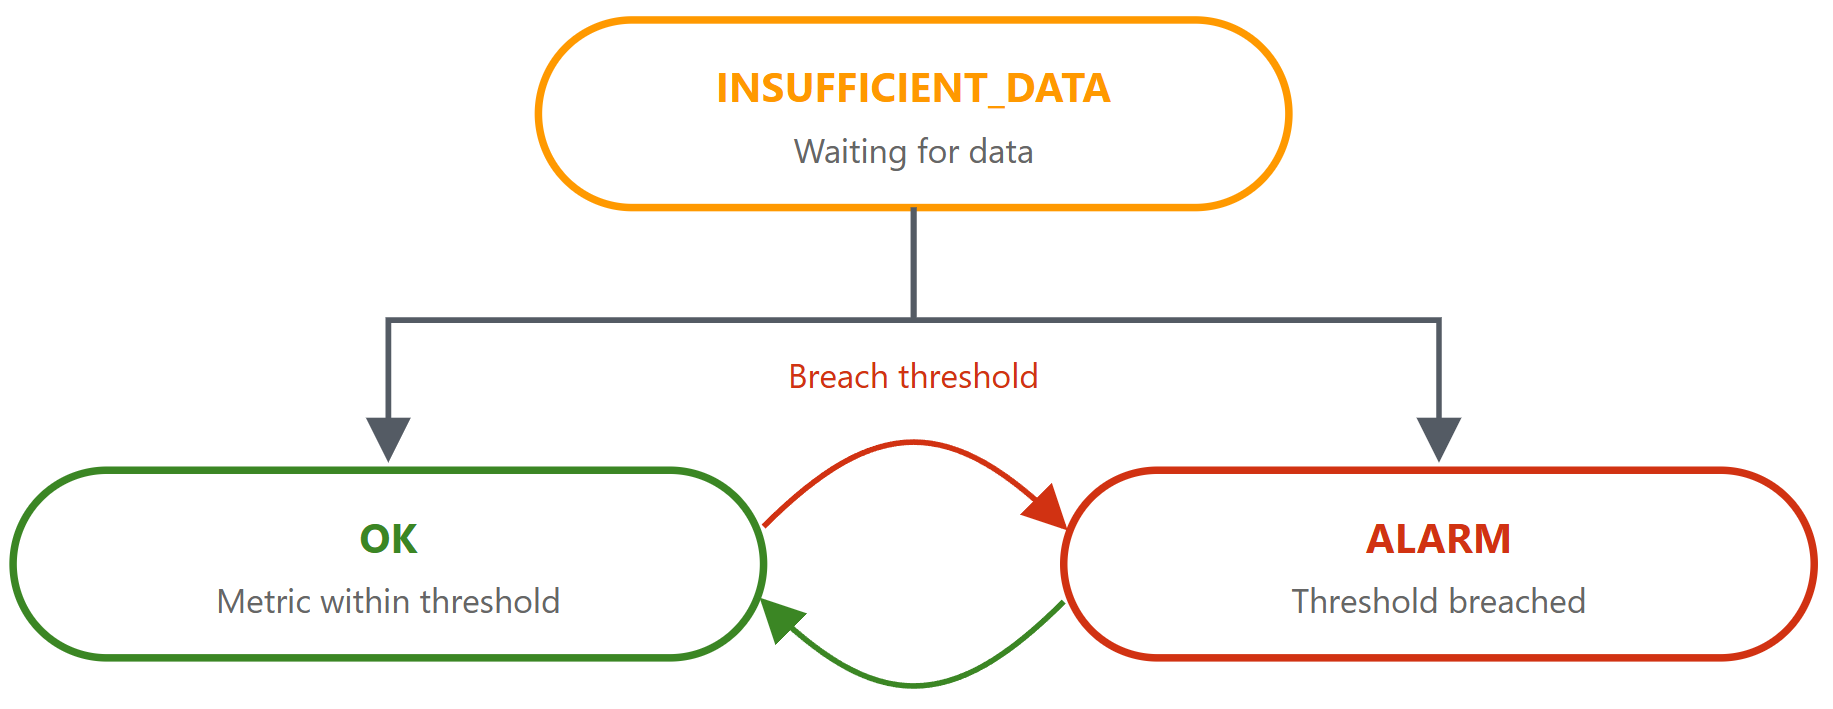
Schéma des transitions d'état d'une alarme CloudWatch selon l'arrivée des données de mesure

Surveillance et dépannage sur AWS

Évaluation d'une alarme


  1. Recueillir des points de données à des intervalles donnés
  2. Appliquer une statistique (Average, Sum, Max, Min) sur la période
  3. Comparer le résultat au seuil
  4. Compter les périodes d'évaluation en violation
  5. Changer d'état si le seuil « datapoints-to-alarm » est atteint


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Surveillance et dépannage sur AWS

Stratégies d'évaluation


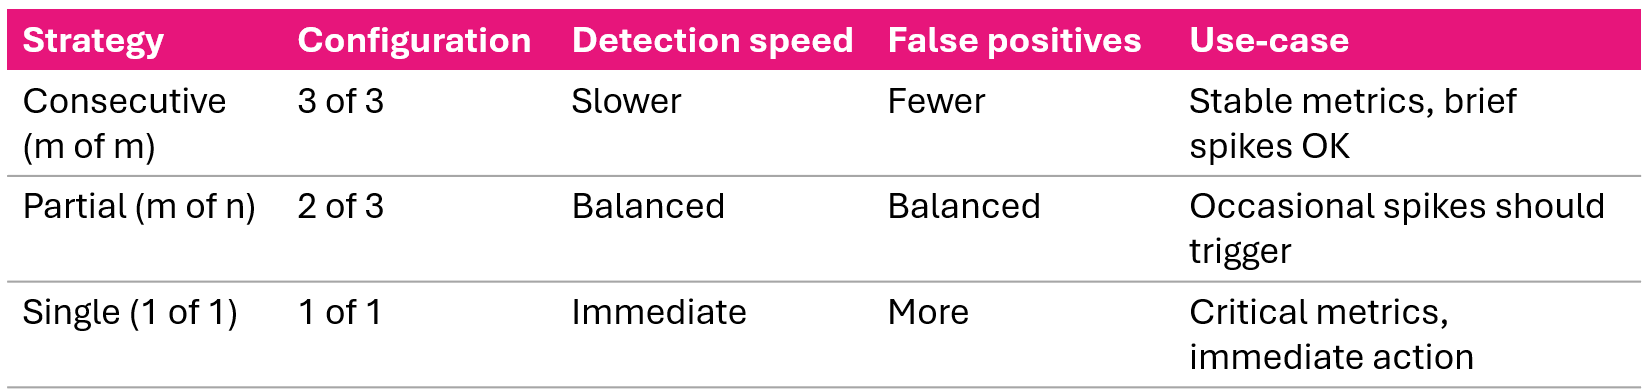
Trois stratégies d'évaluation : violations consécutives partielle et unique, avec compromis de sensibilité

Surveillance et dépannage sur AWS

Types d'actions et déclencheurs d'alarme


Déclencheurs d'actions

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Types d'actions

  • Notification SNS
  • Auto Scaling
  • Action EC2 (arrêter/terminer/redémarrer/récupérer)
  • Systems Manager
Surveillance et dépannage sur AWS

Comportement en cas de données manquantes
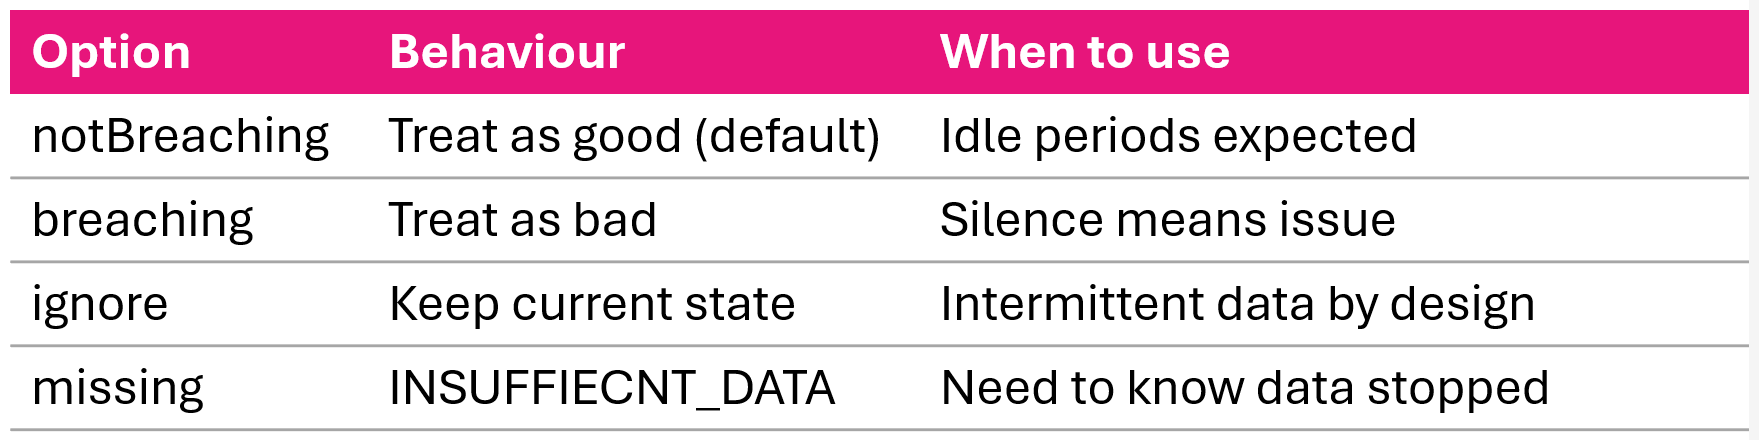
 

Options de gestion des données manquantes : notBreaching breaching ignore et missing

Surveillance et dépannage sur AWS

Créer une alarme standard : AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Surveillance et dépannage sur AWS

Alarmes composites : quoi et pourquoi
Problème

  • Plusieurs alarmes liées se déclenchent séparément = fatigue d'alerte

Solution

  • Combiner les alarmes avec des opérateurs logiques

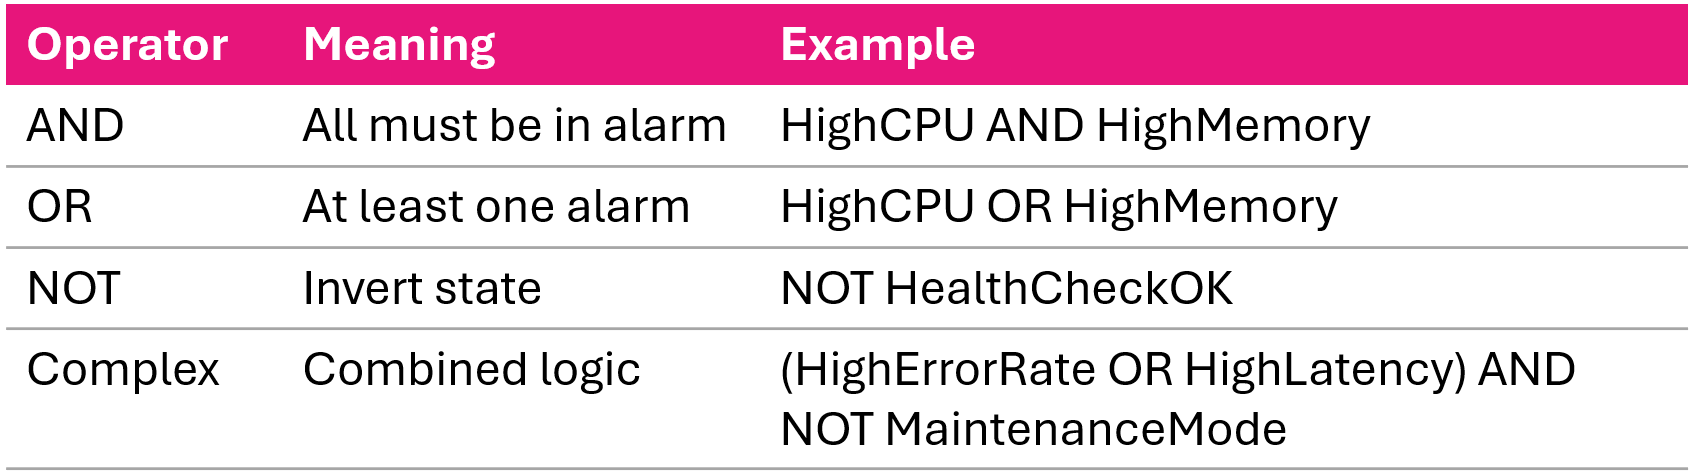
Logique d'une alarme composite combinant des alarmes enfants avec les opérateurs AND OR et NOT

Surveillance et dépannage sur AWS

Créer une alarme composite : AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Exemple de règle complexe
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Surveillance et dépannage sur AWS

Stratégie de sélection des seuils

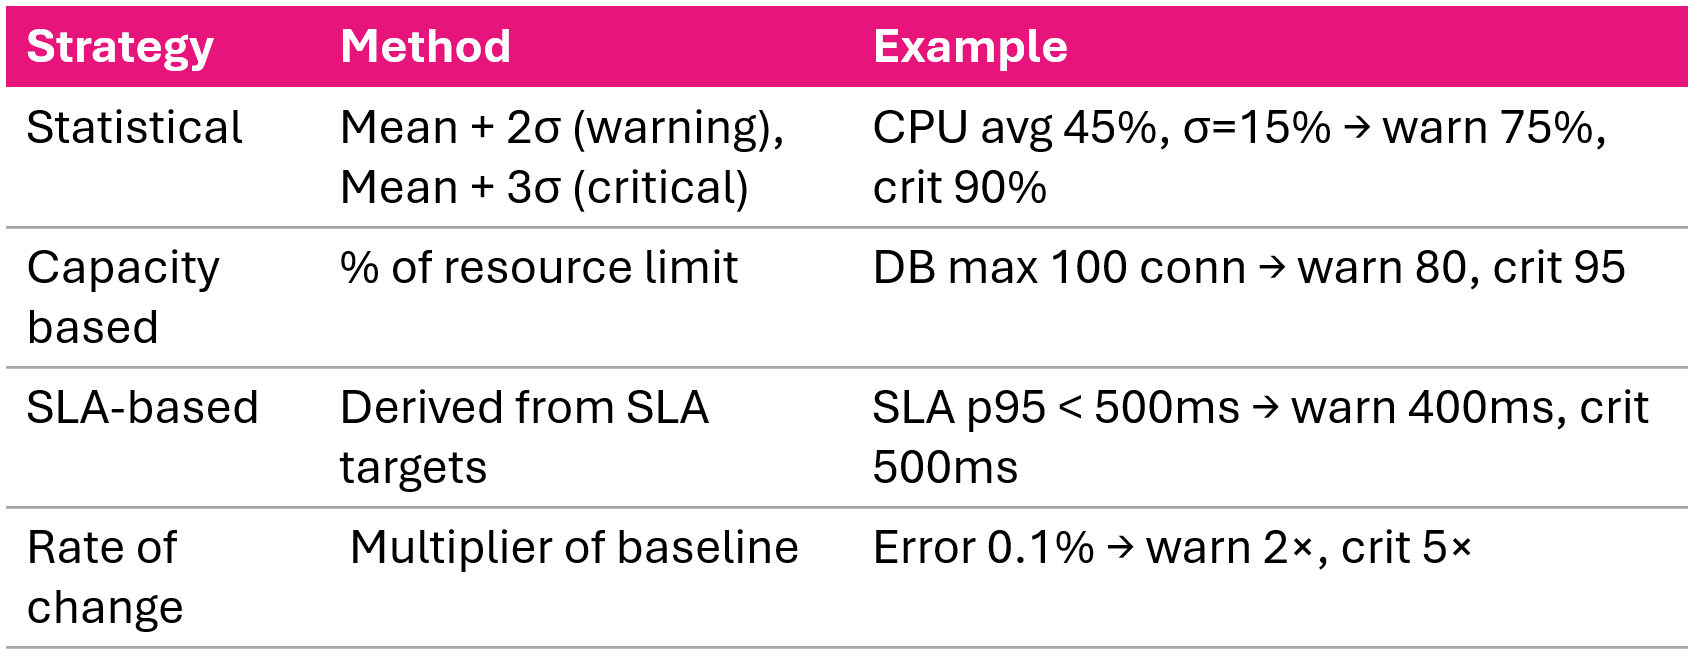
Quatre stratégies de choix de seuil : écart à la référence limites de capacité cibles SLA et taux de variation

Surveillance et dépannage sur AWS

Stratégie d'alarme à plusieurs niveaux
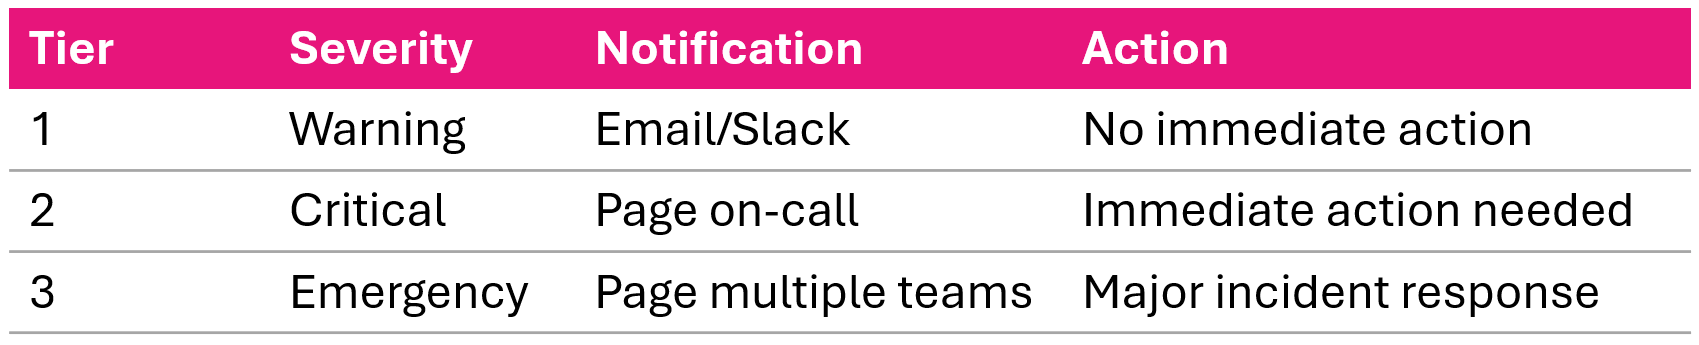
 

Réponse à plusieurs niveaux : avertissement critique et urgence, acheminés vers des sujets SNS distincts

Exemple : avertissement CPU à 75 %, critique à 90 %, chacun vers un sujet SNS différent

Surveillance et dépannage sur AWS

Alarmes de détection d'anomalies

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • Le modèle de Machine Learning apprend le comportement normal de la mesure
  • Crée une bande de seuil dynamique (paramétrable)
  • S'adapte aux cycles quotidiens/hebdomadaires
  • Réduit l'ajustement manuel des seuils
Surveillance et dépannage sur AWS

Alarmes par ressource : Lambda et ALB

Alarmes Lambda
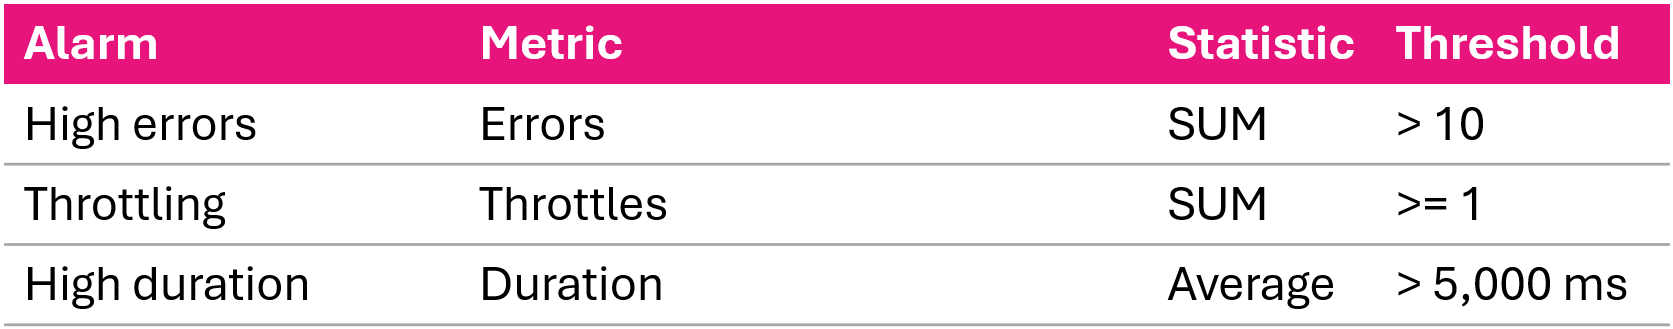
Alarmes Lambda recommandées : erreurs limitations et durée élevée proche de l'échéance

Alarmes ALB

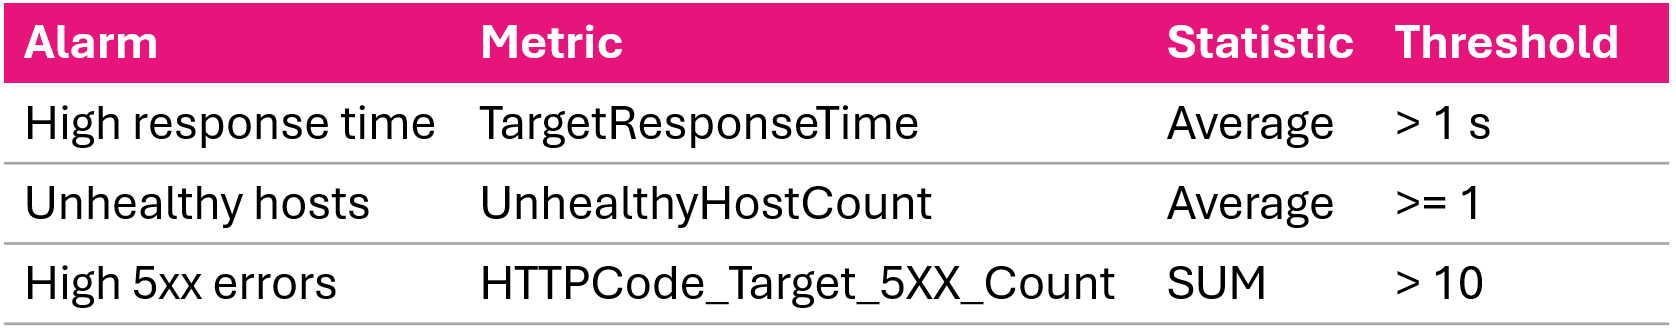
Alarmes ALB recommandées : temps de réponse des cibles hôtes défaillants et erreurs 5xx

Surveillance et dépannage sur AWS

Pratiques recommandées de gestion des alarmes

  • Nommage : <Service>-<Metric>-<Resource>-<Severity>
  • Descriptions : quoi surveiller, seuil, pistes de dépannage, liens vers le guide d'exploitation
  • Étiquettes : environnement, équipe, gravité
  • Revue mensuelle : ajuster les seuils, retirer l'obsolète, mettre à jour les actions
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Surveillance et dépannage sur AWS

Résumé de la vidéo

  • Trois états : OK, ALARM, INSUFFICIENT_DATA
  • Stratégies d'évaluation : consécutive, partielle, violation unique
  • Alarmes composites : combiner plusieurs alarmes avec AND, OR, NOT
  • Quatre stratégies de seuil : statistique, capacité, SLA, taux de variation
  • Alerte à plusieurs niveaux : avertissement → critique → urgence
  • Alarmes par ressource pour Lambda (erreurs, limitations, durée) et ALB (5xx, latence)
Surveillance et dépannage sur AWS

Passons à la pratique !

Surveillance et dépannage sur AWS

Preparing Video For Download...