Dashboardy kondycji aplikacji

Monitoring and Troubleshooting AWS

John Q. Martin

Principal Consultant

Projekt dashboardu: hierarchia informacji
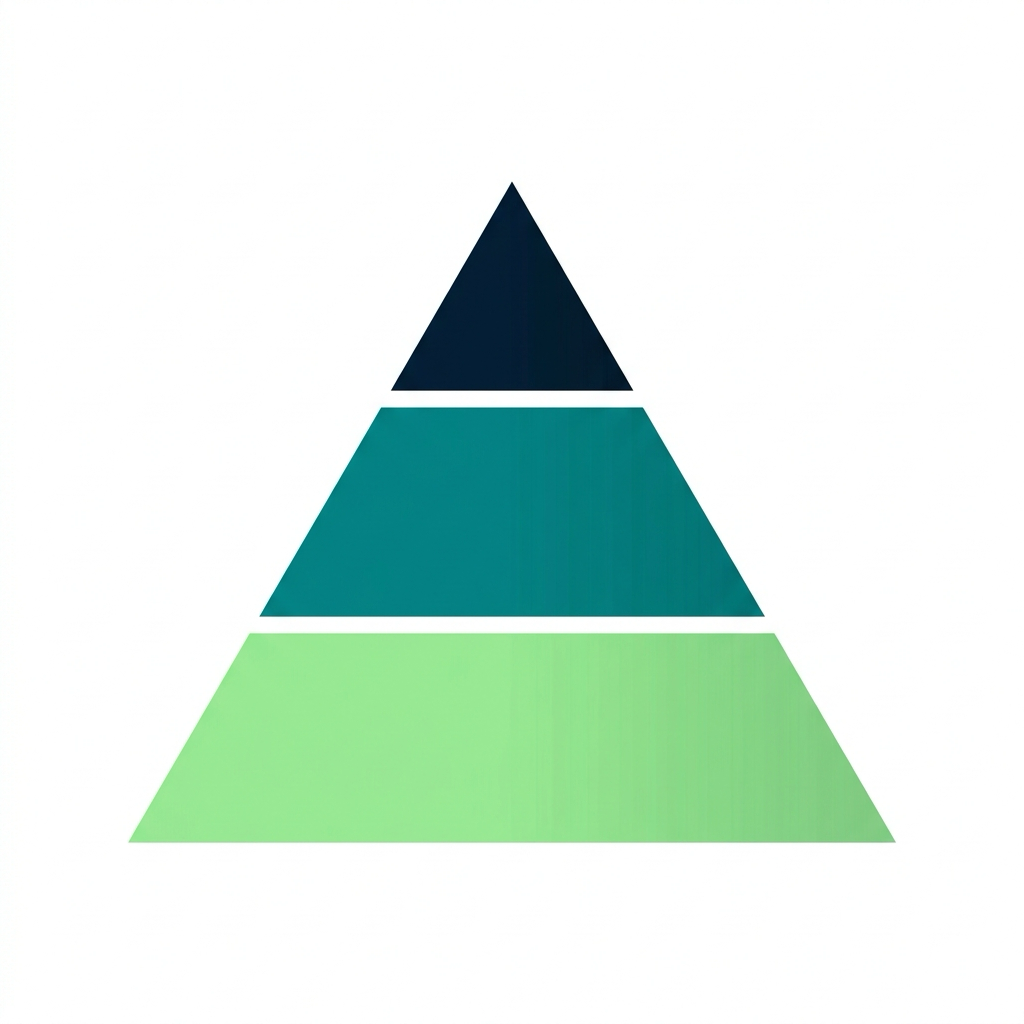
 

Trójpoziomowa piramida: wąska ciemna góra, szerszy turkusowy środek i najszerszy zielony spód

Jak w szpitalu: recepcja → oddział → konsultant


Góra – podsumowanie dla kadry zarządzającej

  • Ogólna kondycja systemu
  • Kluczowe wskaźniki biznesowe, SLA, bieżące incydenty

Środek – kondycja usług

  • Wskaźniki błędów, percentyle opóźnień, przepustowość

Dół – szczegółowa diagnostyka

  • Ślady, logi, wykorzystanie zasobów, kondycja zależności
Monitoring and Troubleshooting AWS

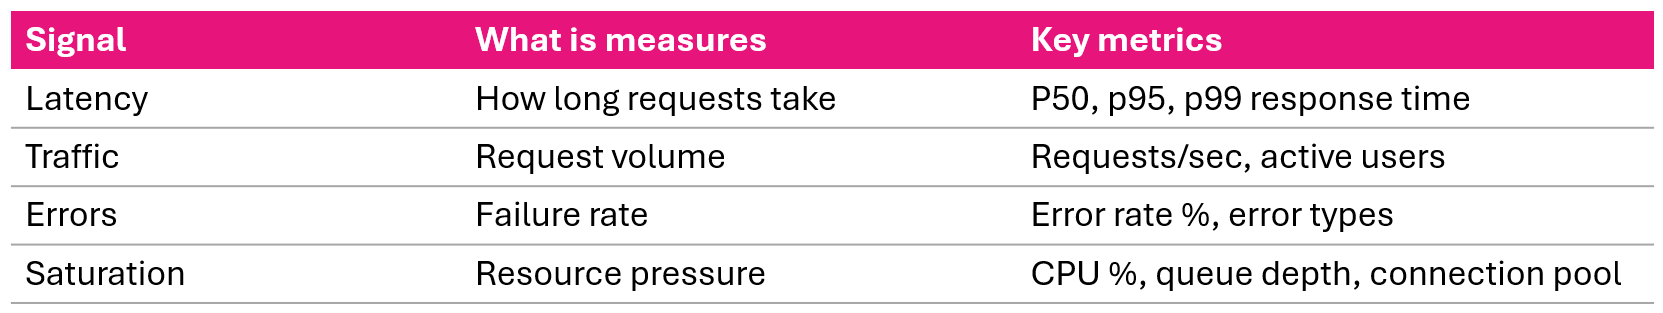
Cztery złote sygnały


Cztery złote sygnały monitorowania: opóźnienie, ruch, błędy i nasycenie

Te cztery sygnały obejmują zdecydowaną większość problemów, które napotkasz.

Monitoring and Troubleshooting AWS

Metoda RED


RED dla usług obsługujących żądania:
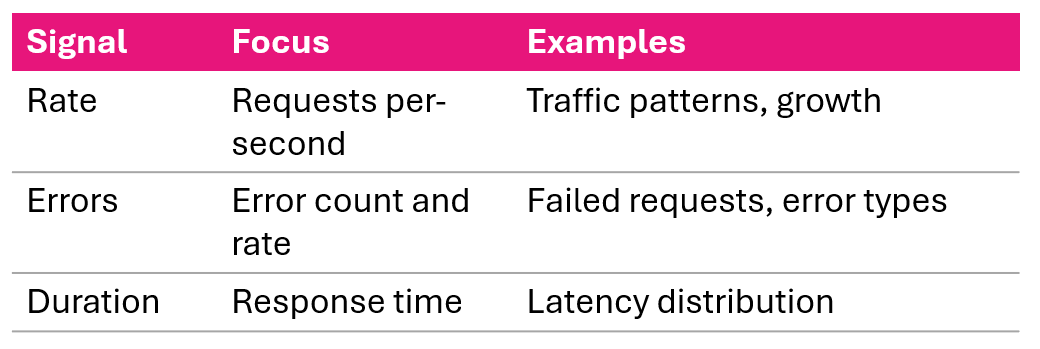
Wzorzec metody RED pokazujący wskaźnik, błędy i czas trwania dla usług obsługujących żądania


Związek ze złotymi sygnałami:

  • RED to skupiony podzbiór czterech złotych sygnałów
  • Zaprojektowany dla usług obsługujących żądania użytkowników
  • Nasycenie (4. złoty sygnał) dodaje się przy monitorowaniu infrastruktury

Zacznij od RED, a nasycenie dodaj przy głębszej diagnostyce.

Monitoring and Troubleshooting AWS

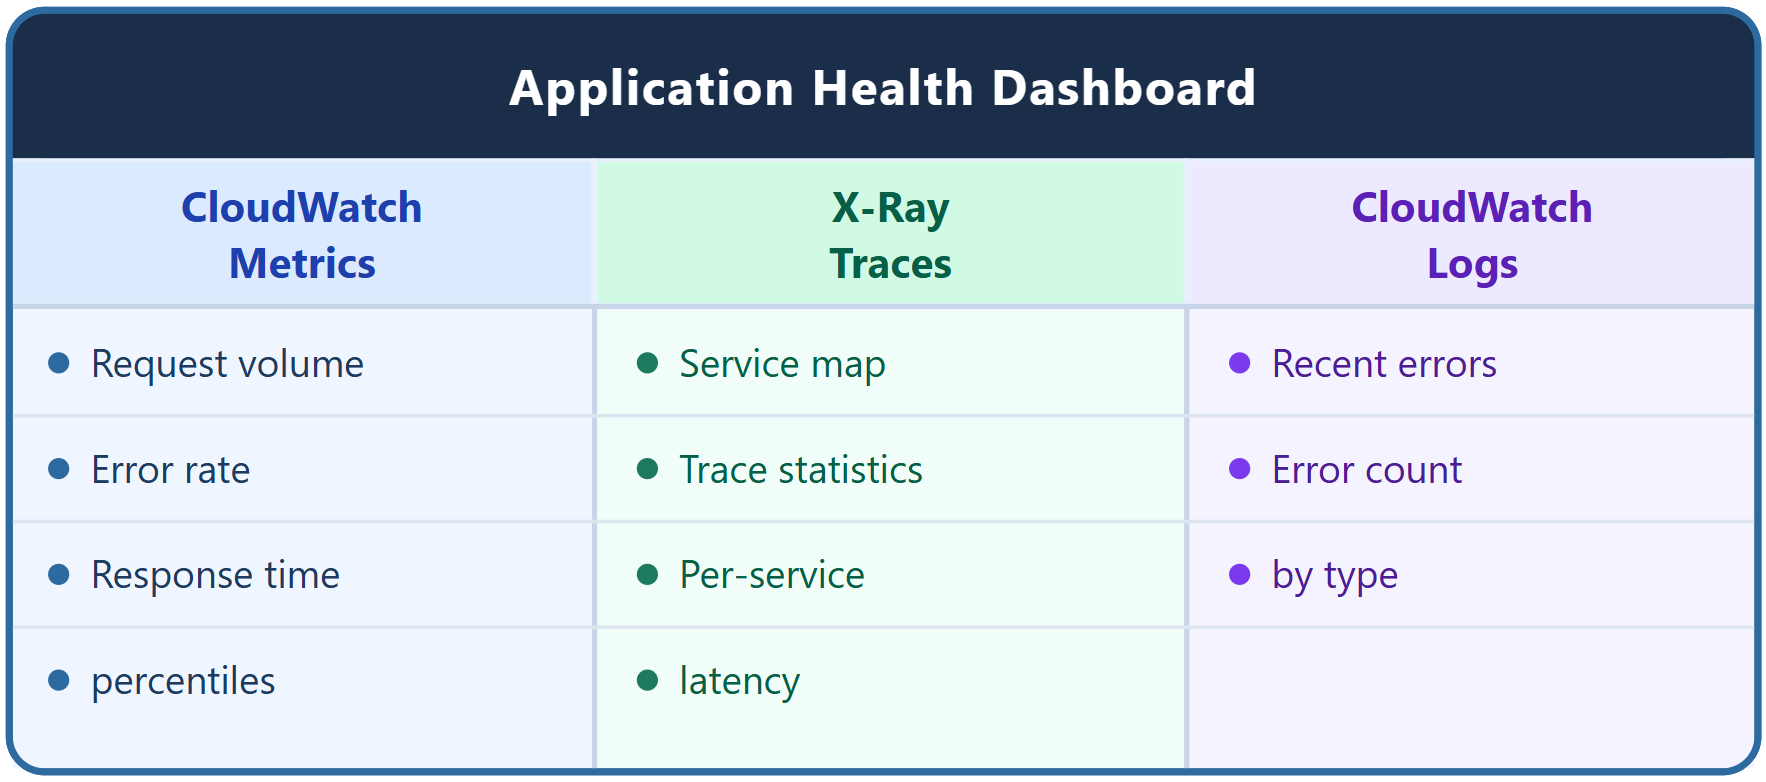
Trzy źródła danych


Diagram trzech źródeł danych dashboardu: metryki CloudWatch, ślady X-Ray i CloudWatch Logs

Monitoring and Troubleshooting AWS

Widżety metryk CloudWatch

Wolumen żądań:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

Wskaźnik błędów (metric math):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

Percentyle czasu odpowiedzi:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • Wolumen żądań z ALB RequestCount
  • Wskaźnik błędów używa metric math – błędy / wywołania × 100
  • Czas odpowiedzi jako percentyle p50, p95, p99
Monitoring and Troubleshooting AWS

Widżety X-Ray i logów


Widżety X-Ray:

  • Mapa usług – topologia aplikacji ze wskaźnikami kondycji
  • Statystyki śladów – średni czas odpowiedzi, wskaźnik błędów, wskaźnik awarii
  • Opóźnienie usług – porównanie czasu odpowiedzi dla poszczególnych usług


Widżety CloudWatch Logs:

Zapytanie o ostatnie błędy:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

Liczba błędów według typu:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
Monitoring and Troubleshooting AWS

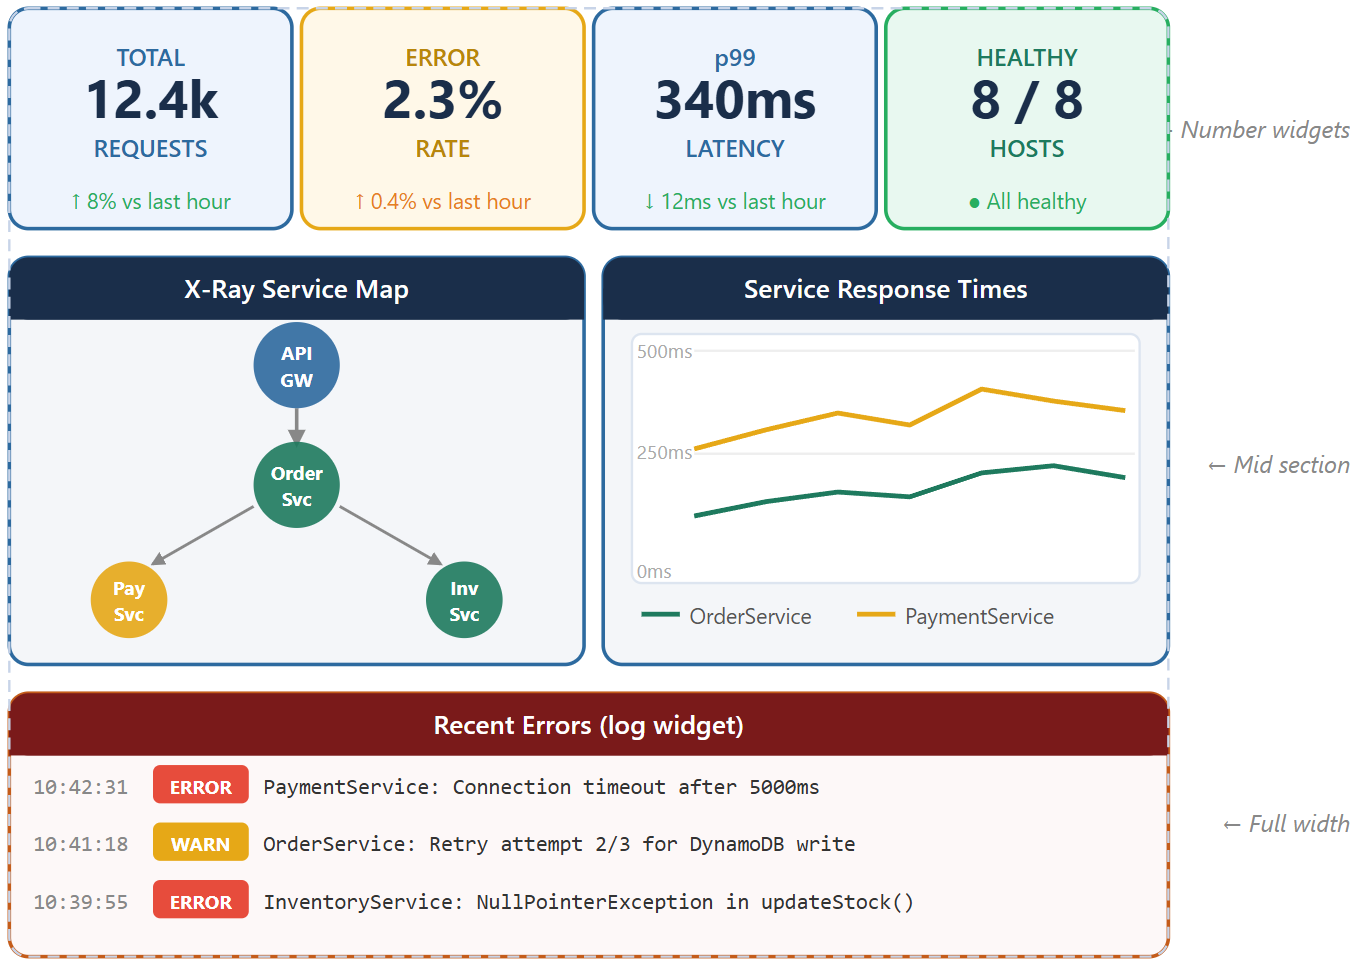
Kompletny układ dashboardu


Układ dashboardu kondycji: widżety podsumowania na górze, mapa usług pośrodku i logi błędów na dole

Monitoring and Troubleshooting AWS

Przepływ pracy przy rozwiązywaniu incydentów
 

Karta triage z oddziału ratunkowego z kolorowymi paskami priorytetów i stetoskopem

Jak triage na SOR-ze: stabilizacja → diagnoza → leczenie → weryfikacja

  1. Identyfikacja – czerwone/żółte wskaźniki, skoki błędów
  2. Zakres – które usługi? kiedy? czy się pogarsza?
  3. Korelacja – błędy + opóźnienia, ruch + zasoby
  4. Drążenie – mapa usług → ślady → logi
  5. Przyczyna źródłowa – zależność, baza danych, pamięć, konfiguracja
  6. Naprawa – wyłącznik awaryjny, skalowanie, rollback, failover
  7. Weryfikacja – wskaźnik błędów normalny, mapa zielona, alarmy wyciszone
Monitoring and Troubleshooting AWS

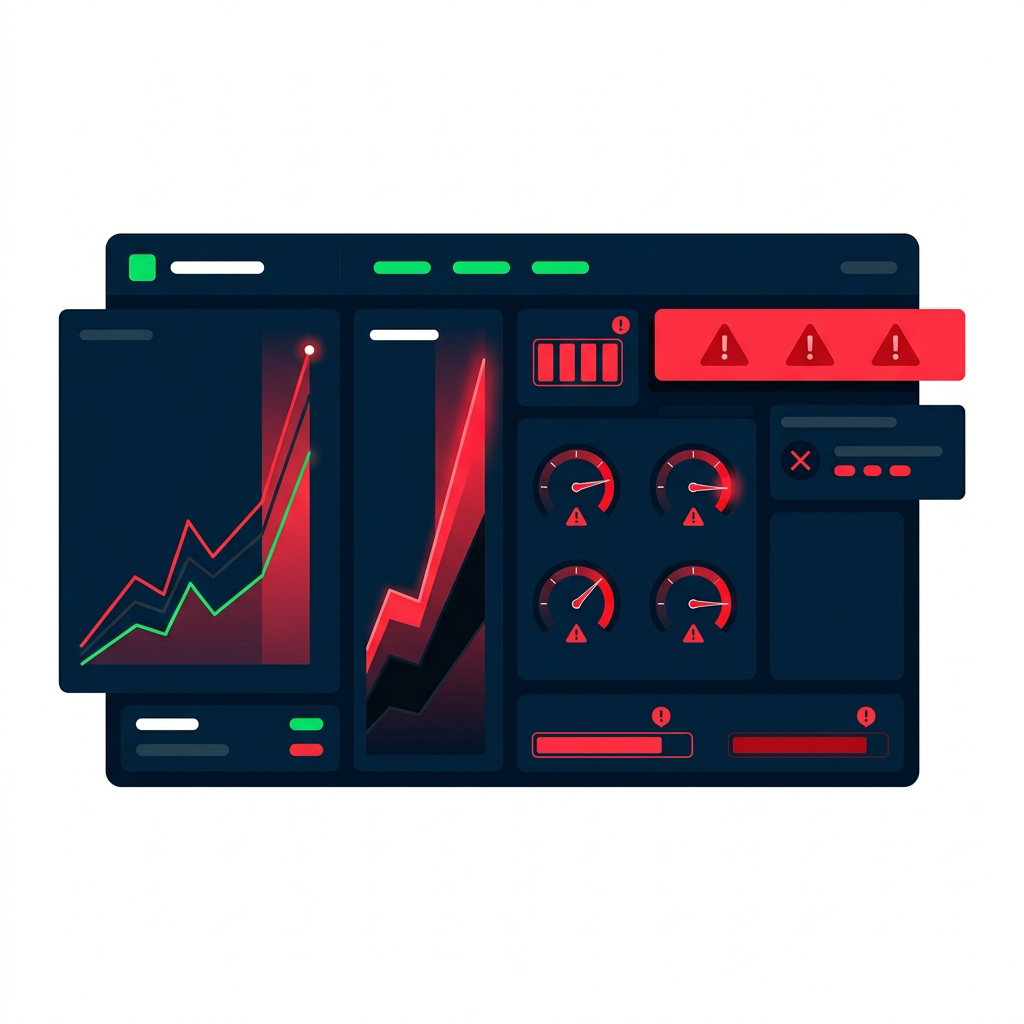
Scenariusz 1: nagły skok ruchu

Dashboard monitorowania podczas skoku ruchu: wykresy liniowe strzelające w górę, wskaźniki w czerwonej strefie, czerwone banery alarmowe

Co widać na dashboardzie:

  • Wolumen żądań 10× powyżej normy
  • Wskaźnik błędów 25%
  • Opóźnienie 3000 ms
  • CPU 95%

Analiza: Zasoby przeciążone przez nagły skok ruchu


Działania:

  • Natychmiastowe skalowanie poziome
  • Włączenie automatycznego skalowania
  • Wdrożenie ograniczania szybkości żądań
  • Dodanie cachowania, aby odciążyć backend
Monitoring and Troubleshooting AWS

Scenariusz 2: wąskie gardło bazy danych
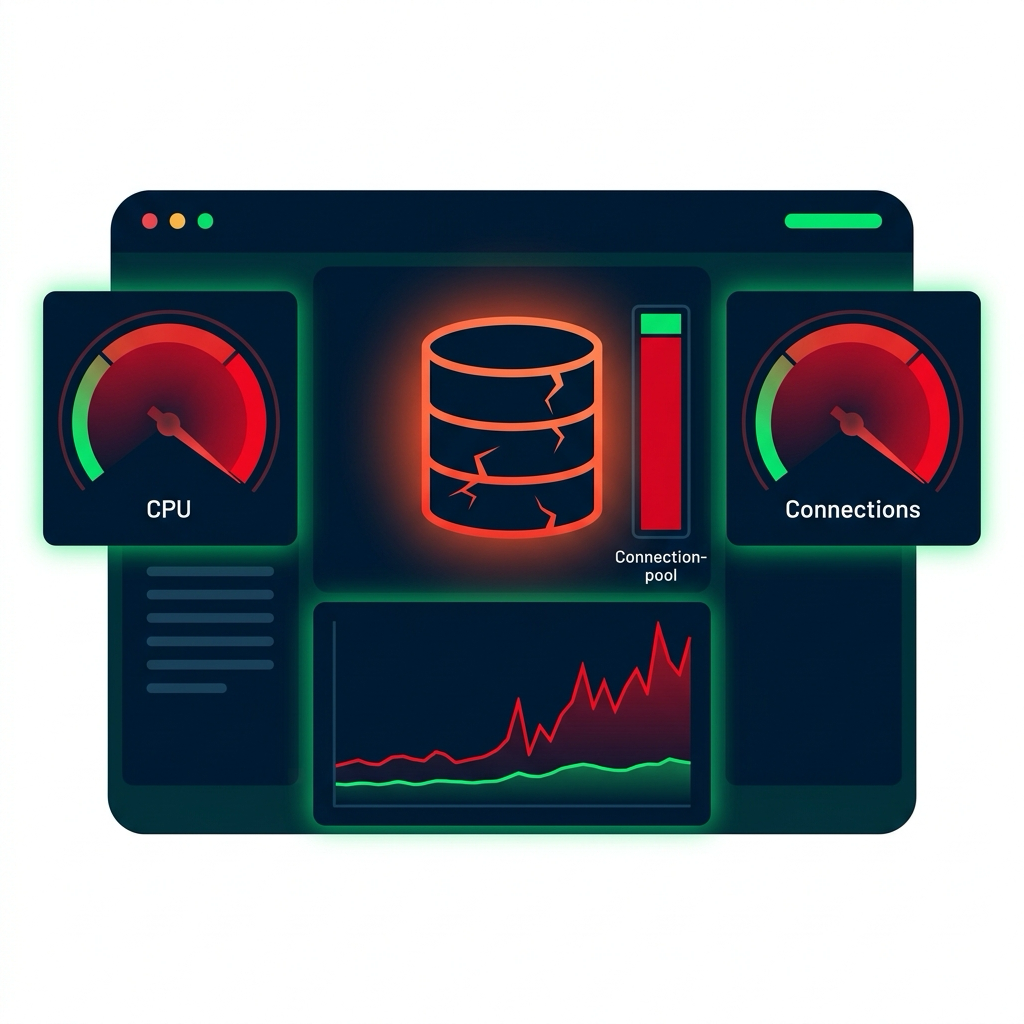
Dashboard monitorowania pokazujący wąskie gardło bazy danych: pęknięta czerwona ikona bazy, CPU i liczba połączeń na maksimum, stromy wykres opóźnień zapytań, pasek puli połączeń prawie pełny

Co widać na dashboardzie:

  • CPU bazy danych 95%
  • Połączenia z bazą 95/100
  • Opóźnienie zapytań 5000 ms
  • Opóźnienie aplikacji 5500 ms

Analiza: Baza danych jest wąskim gardłem – wolne zapytania wyczerpują pulę połączeń


Działania:

  • Identyfikacja wolnych zapytań w logach
  • Dodanie indeksów i optymalizacja zapytań
  • Zwiększenie rozmiaru puli połączeń
  • Skalowanie bazy danych
Monitoring and Troubleshooting AWS

Scenariusz 3: awaria kaskadowa


Co widać na mapie usług:
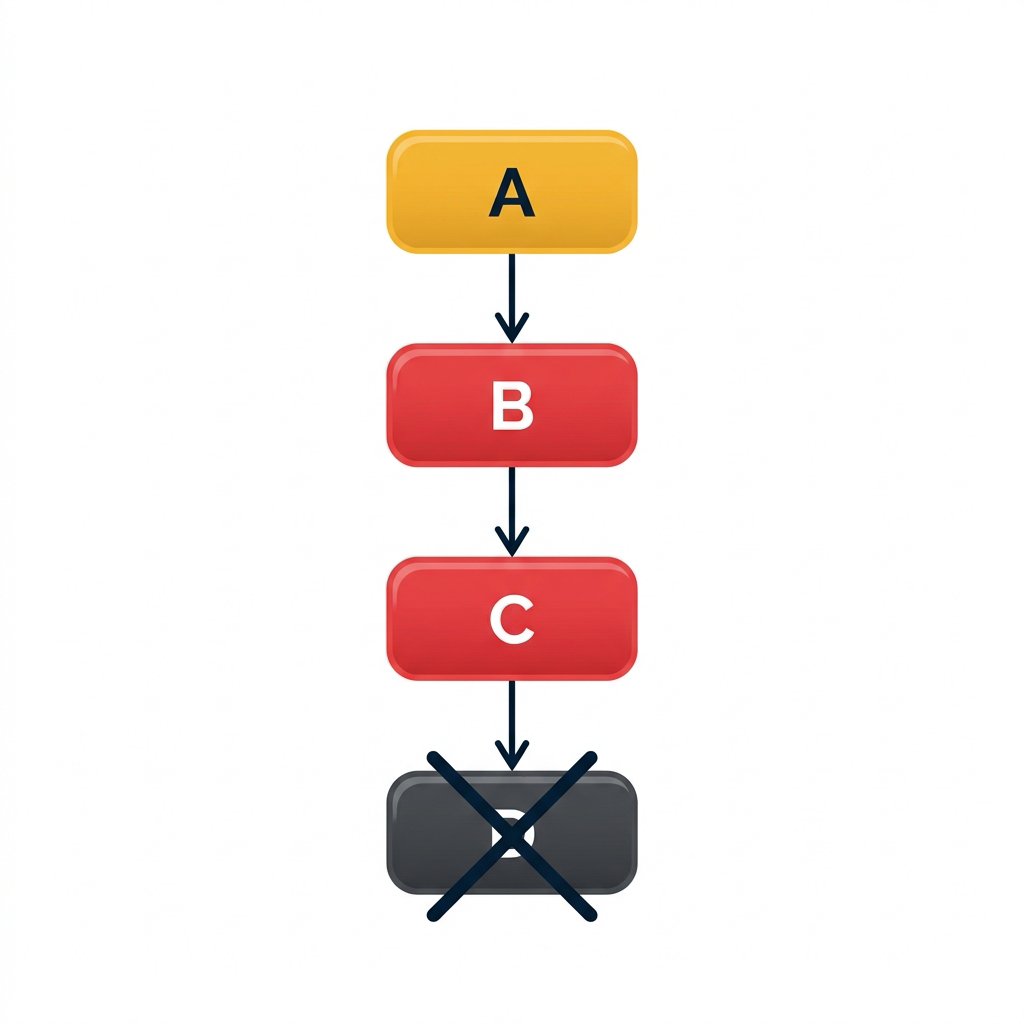
Kaskada awarii na mapie usług: węzeł A bursztynowy z błędami klienta, B i C czerwone z awariami serwera, D ciemny i całkowicie niedostępny, strzałki pokazują przepływ przez łańcuch


Analiza:

Mały problem w usłudze A przeszedł kaskadowo przez łańcuch zależności

Działania:

  • Wyłączniki awaryjne zatrzymujące kaskadę
  • Limity czasu na każdym poziomie usług
  • Mechanizmy fallback dla niedostępnych zależności
  • Usunięcie przyczyny źródłowej w usłudze A
Monitoring and Troubleshooting AWS

Dobre praktyki projektowania dashboardów
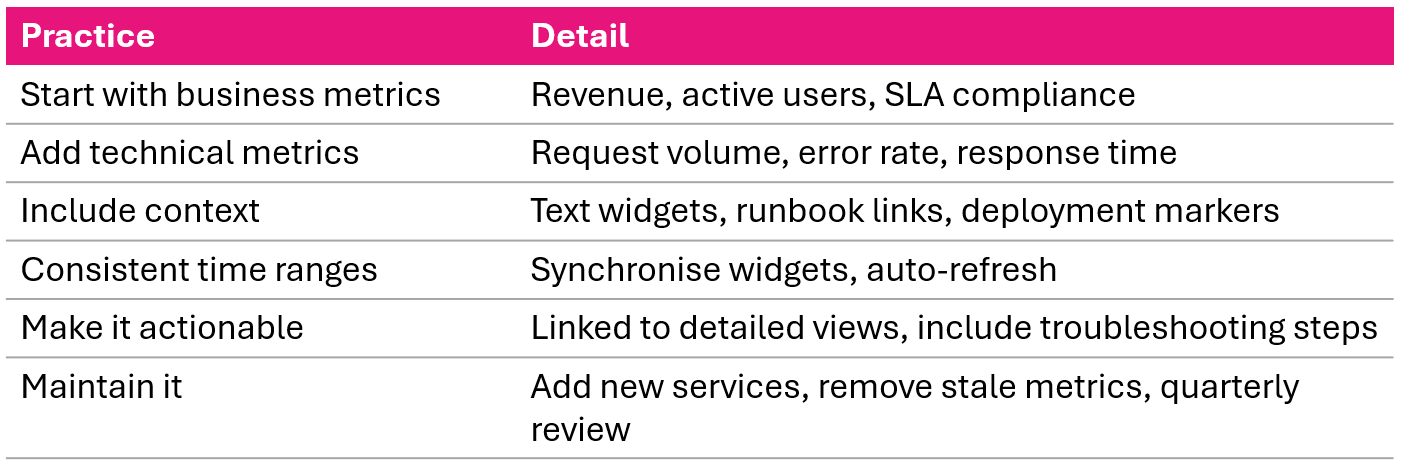
 

Sześć zalecanych praktyk projektowania dashboardów do monitorowania kondycji aplikacji

Monitoring and Troubleshooting AWS

Podsumowanie nagrania i ukończenie kursu

  • Projektuj z użyciem hierarchii informacji i czterech złotych sygnałów
  • Łącz metryki CloudWatch, ślady X-Ray i logi w jednym widoku
  • Siedmiokrokowy przepływ pracy przy incydentach: identyfikacja → zakres → korelacja → drążenie → przyczyna źródłowa → naprawa → weryfikacja

Potrafisz już:

  • Monitorować za pomocą metryk CloudWatch, logów i dashboardów
  • Konfigurować alarmy i powiadomienia z SNS i SQS
  • Wdrażać rozproszone śledzenie z X-Ray
  • Budować dashboardy kondycji aplikacji dla doskonałości operacyjnej
Monitoring and Troubleshooting AWS

Dashboardy kondycji aplikacji

Monitoring and Troubleshooting AWS

Preparing Video For Download...