Analiza śladów i map usług

Monitoring and Troubleshooting AWS

John Q. Martin

Principal Consultant

Czym jest mapa usług?


Generowana automatycznie z danych śledzenia: bez ręcznej konfiguracji
Tablica odjazdów kolejowych z rzędami usług, każda z kolorowym wskaźnikiem stanu: zielony oznacza na czas, pomarańczowy oznacza opóźnienie, czerwony oznacza zatrzymanie

Na pierwszy rzut oka: zielony = na czas · pomarańczowy = opóźniony · czerwony = zatrzymany


Dostęp:

  • Konsola X-Ray → Service map
  • Zastosuj filtry
  • Kliknij węzeł → szczegółowy podgląd
Monitoring and Troubleshooting AWS

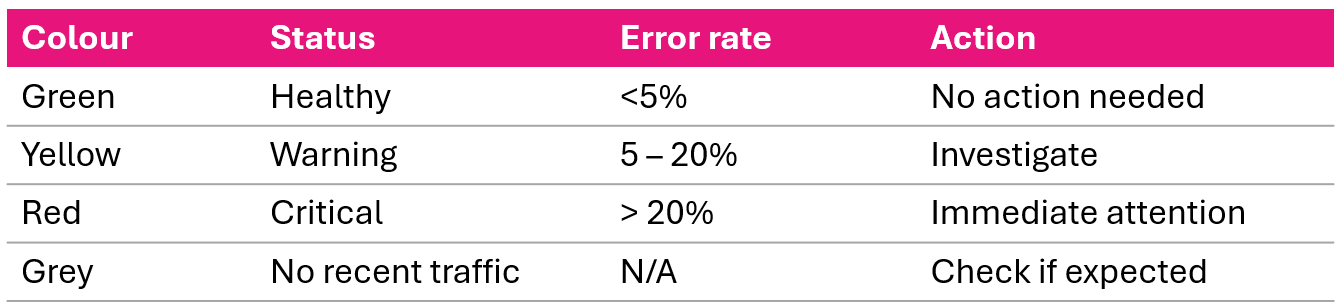
Kodowanie kolorami na mapie usług


Legenda kolorów mapy usług: zielony — udane wywołania, żółty — błędy klienta, czerwony — błędy serwera, fioletowy — throttling, szary — brak ruchu

Po otwarciu mapy usług od razu sprawdź wszystko, co nie jest zielone.

Kliknij dowolny węzeł, aby zobaczyć: rozkład czasu odpowiedzi, podział statusów HTTP, typy błędów.

Monitoring and Troubleshooting AWS

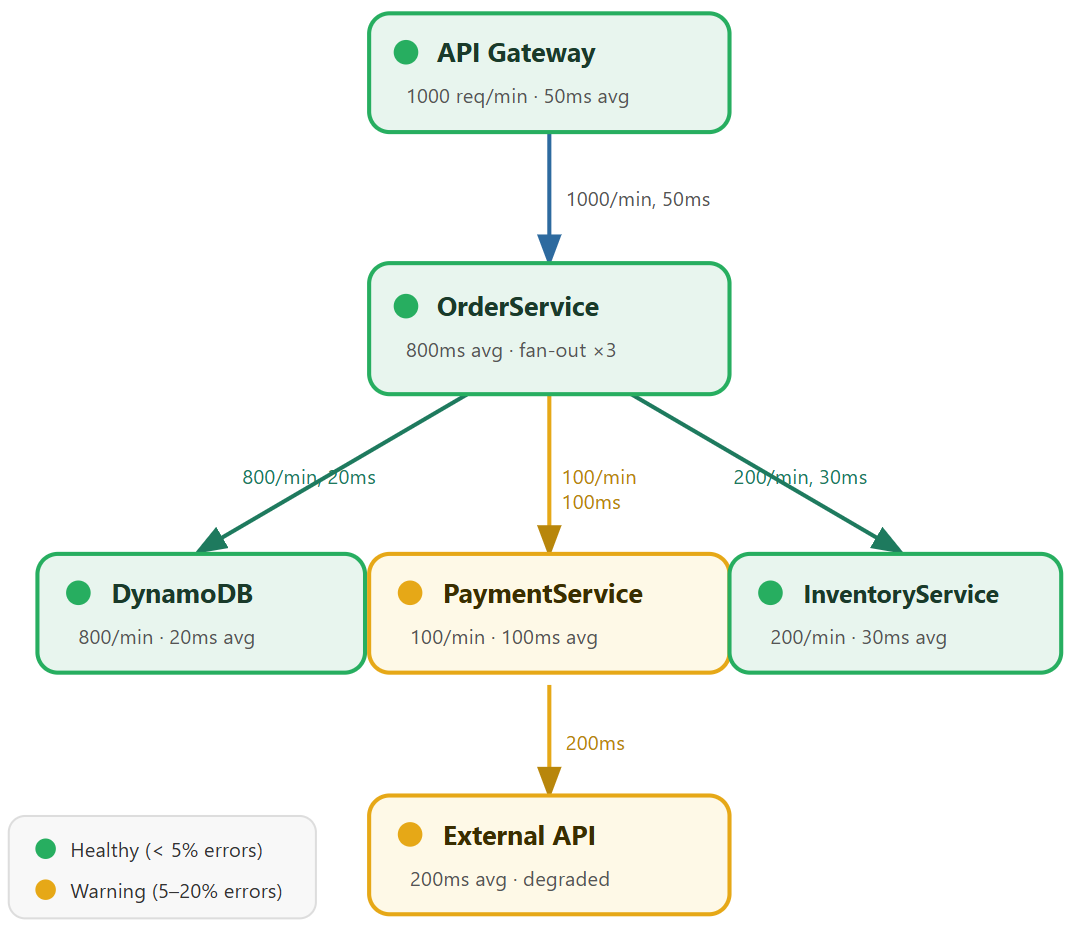
Jak czytać mapę usług?


Mapa usług z API Gateway i OrderService rozchodzącymi się do DynamoDB Inventory oraz żółtej usługi Payment

Monitoring and Troubleshooting AWS

Analiza ścieżki krytycznej


Ścieżka krytyczna = najdłuższy łańcuch wywołań

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Total: 400ms

External API = 50% całkowitego opóźnienia


Co z tym zrobić:

  • External API to cel optymalizacji
  • Opcje: dodaj cache, wdróż timeout + fallback, wynegocjuj SLA

Porównaj alternatywną ścieżkę:

OrderService -> DynamoDB
Total: 120ms (fast)
Monitoring and Troubleshooting AWS

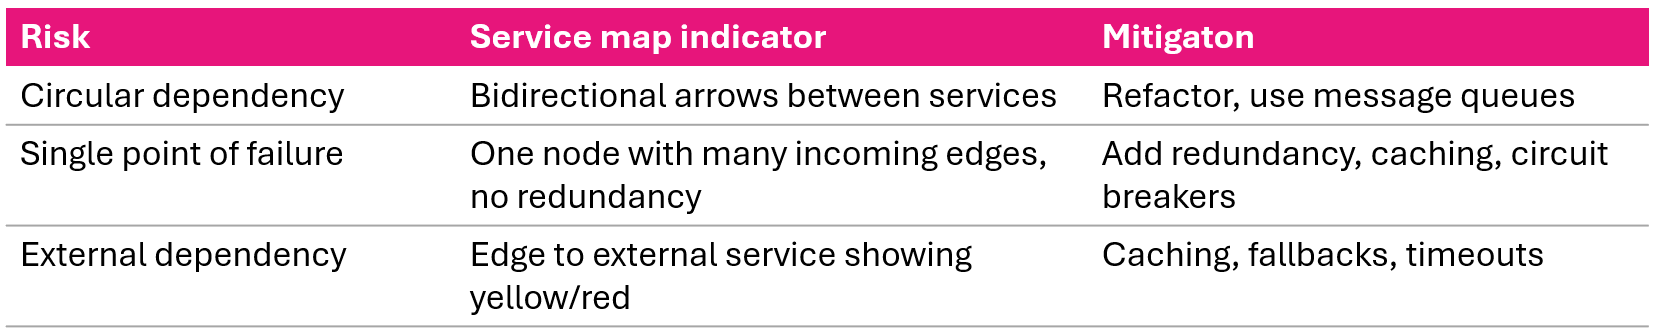
Ryzyka zależności


Ryzyka zależności na mapie usług: zależności cykliczne, pojedyncze punkty awarii i ryzykowne zależności zewnętrzne

Monitoring and Troubleshooting AWS

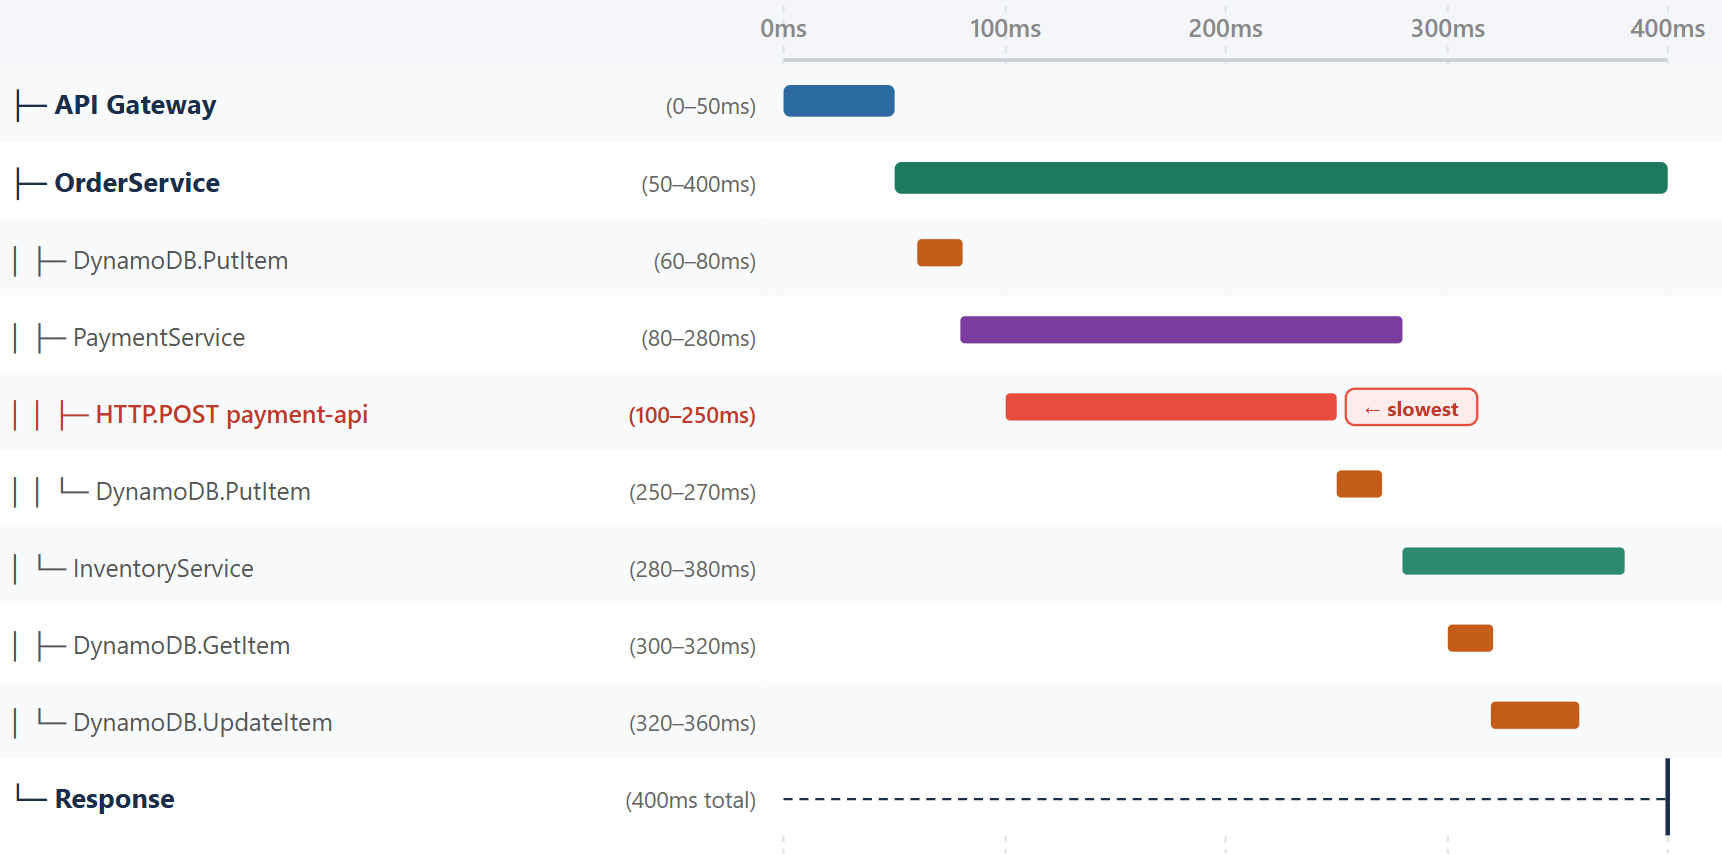
Jak czytać oś czasu śladu?


Oś czasu śladu z podsegmentami wzdłuż osi czasu — wywołanie payment-api jako najdłuższa operacja


  • Oś pozioma — czas: kiedy operacje się zaczęły i jak długo trwały
  • Oś pionowa — hierarchia usług: podsegmenty wcięte pod elementami nadrzędnymi
  • HTTP.POST do payment-api (100–250ms) = pojedyncza najdłuższa operacja
Monitoring and Troubleshooting AWS

Wzorzec 1: sekwencyjne wąskie gardła


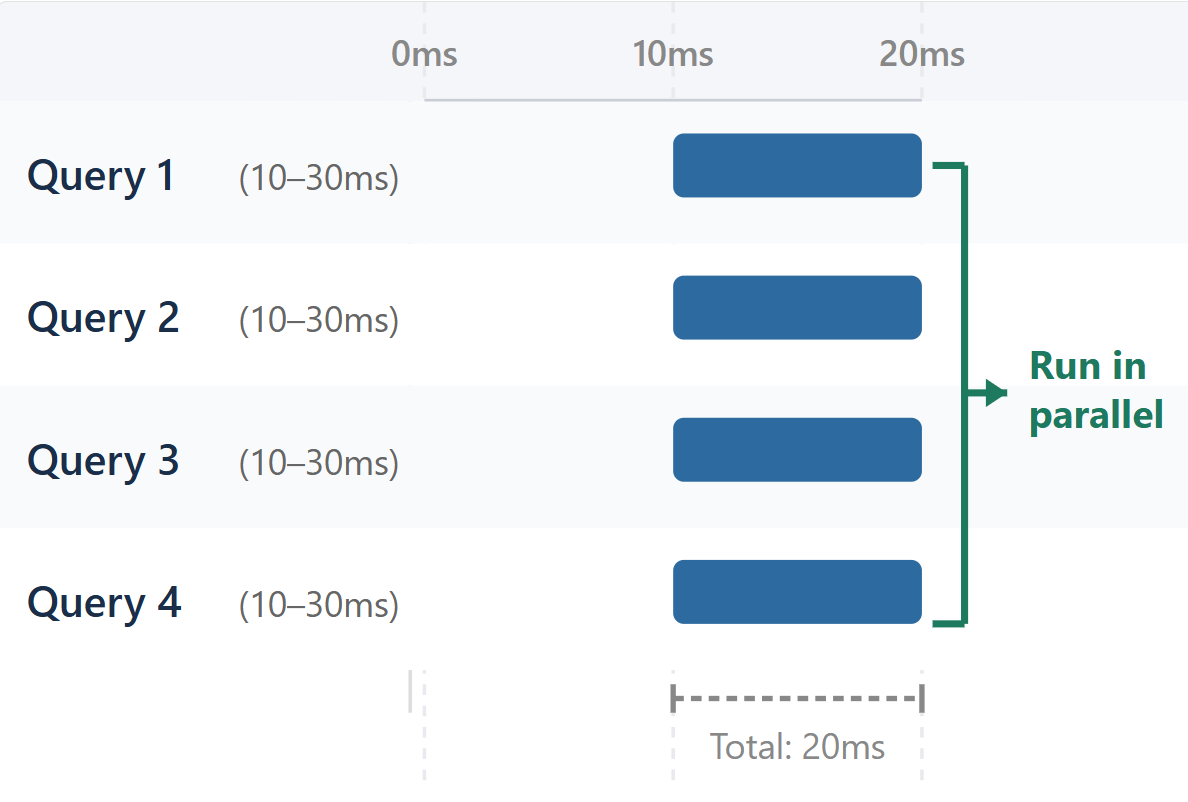
Przed (sekwencyjnie — 80ms):

Query 1 (10-30ms)
         -> Query 2 (30-50ms)
                  -> Query 3 (50-70ms)
                           -> Query 4 (70-90ms)


Po (równolegle — 20ms):

Oś czasu śladu z czterema zapytaniami uruchomionymi równolegle, nakładającymi się i kończącymi w 20ms

Monitoring and Troubleshooting AWS

Wzorzec 2: zapytania N+1 i nadmiarowe wywołania


Problem N+1 zapytań:

Get user list       (10-20ms)
Get user 1 details  (20-30ms)
Get user 2 details  (30-40ms)
... ×100 sequential queries

Rozwiązanie: zapytania wsadowe, eager loading


Nadmiernie gadatliwe usługi:

  • 50 małych wywołań między dwiema usługami zamiast 1 wsadowego
  • Każde wywołanie: nawiązanie połączenia + serializacja + round-trip
  • 50-krotny narzut

Rozwiązanie: żądania wsadowe, kolejki komunikatów, cache

Monitoring and Troubleshooting AWS

Wzorzec 3: zimne starty i awarie kaskadowe
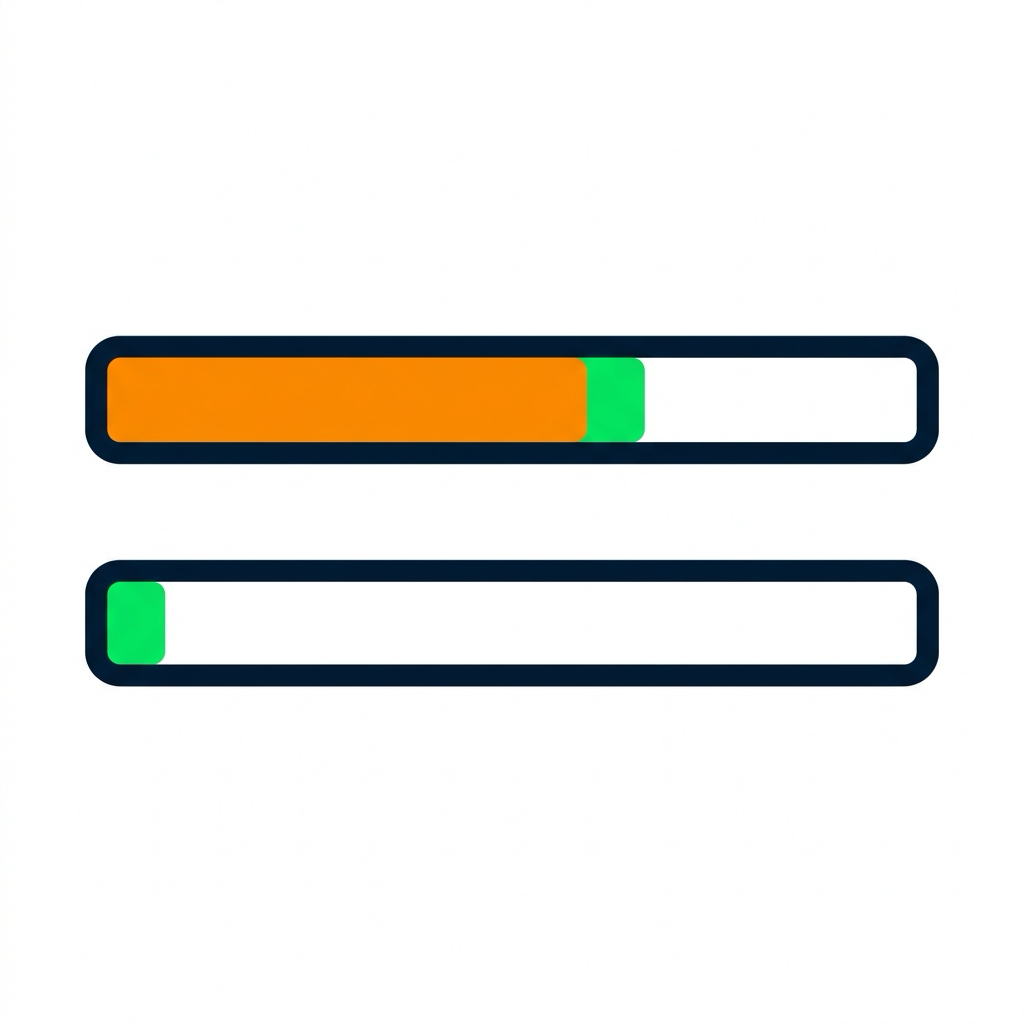
 

Dwa paski osi czasu: zimny start ma duży pomarańczowy blok inicjalizacji, a następnie mały zielony handler; ciepły start to tylko mały zielony handler

Zimny start Lambda:

  • Zimny: 3000ms (2500ms inicjalizacja + 500ms handler)
  • Ciepły: 500ms (tylko handler)
  • Widoczny jako duży segment inicjalizacji przy pierwszym wywołaniu

Rozwiązanie: provisioned concurrency, optymalizacja inicjalizacji


Awaria kaskadowa:

Service A [Error]
  -> Service B [Timeout 5s]
    -> Service C [Timeout 5s]
      -> Database [Timeout 5s]

Nakładające się timeouty ułożone w hierarchii śladu

Rozwiązanie: timeouty, circuit breakery, fallbacki

Monitoring and Troubleshooting AWS

Filtrowanie śladów za pomocą adnotacji
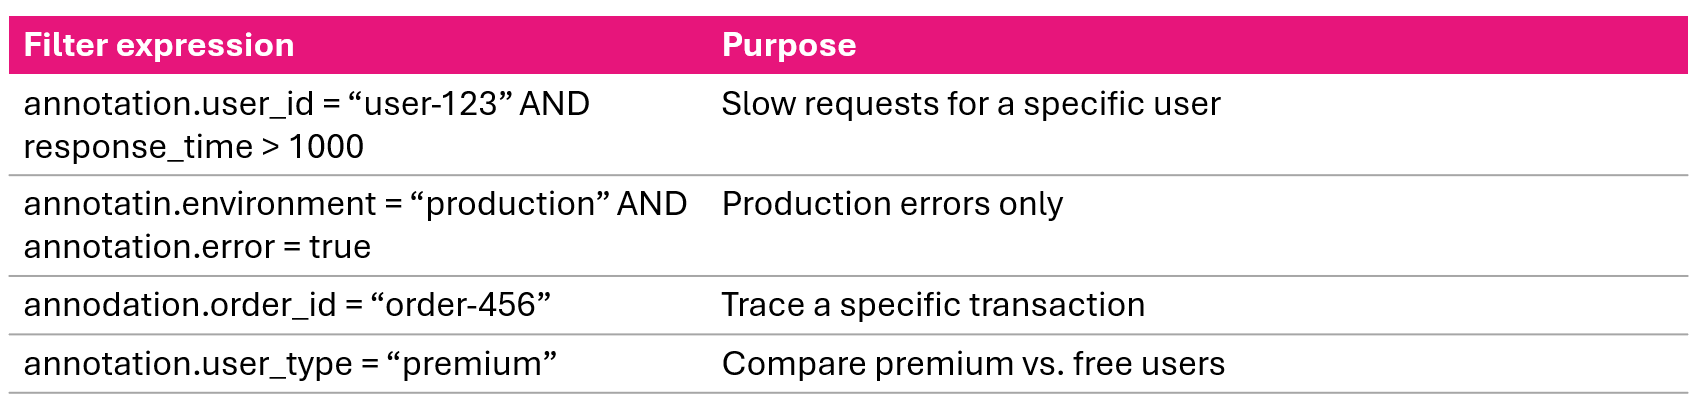
Konsola X-Ray filtrująca ślady według par klucz–wartość adnotacji

Porównaj grupy:

  • Użytkownicy premium: średnio 200ms, darmowi: 150ms → funkcje premium dodają opóźnienie
  • EU West 3× wolniejszy niż US East → problem z dostępem do danych między regionami
Monitoring and Troubleshooting AWS

Przepływ pracy przy analizie śladów


  1. Identyfikuj — filtr: response_time > 1000ms, sortuj według czasu trwania
  2. Analizuj — znajdź najdłuższe operacje, sekwencyjne wąskie gardła, możliwości równoległości
  3. Adnotuj — sprawdź adnotacje pod kątem kontekstu biznesowego: ID użytkownika, ID zamówienia, środowisko
  4. Przeglądaj — sprawdź metadane: szczegóły żądania, komunikaty o błędach
  5. Koreluj — porównaj z logami CloudWatch
  6. Diagnozuj — przyczyna źródłowa: wolne zapytanie, timeout, algorytm, wyczerpanie zasobów
  7. Napraw — optymalizuj kod, dodaj cache, zrównoleglaj, skaluj
  8. Weryfikuj — porównaj ślady przed i po, monitoruj opóźnienia i wskaźniki błędów
Monitoring and Troubleshooting AWS

Tworzenie alertów z danych X-Ray


# High latency alarm
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# High error count alarm
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
Monitoring and Troubleshooting AWS

Podsumowanie


  • Mapy usług — automatycznie generowane diagramy architektury: węzły (usługi), krawędzie (połączenia), stan oznaczony kolorami
  • Kodowanie kolorami — zielony (sukces), żółty (4xx), czerwony (błędy 5xx), fioletowy (429), szary (brak ruchu)
  • Ścieżka krytyczna — najdłuższy łańcuch wywołań, wskazuje cel optymalizacji
  • Osie czasu śladów — ujawniają sekwencyjne wąskie gardła, zapytania N+1, zimne starty, awarie kaskadowe
  • Adnotacje — filtrowanie i grupowanie śladów według kontekstu biznesowego
  • Przepływ pracy — osiem kroków: identyfikuj → analizuj → adnotuj → przeglądaj → koreluj → diagnozuj → napraw → weryfikuj
Monitoring and Troubleshooting AWS

Analiza śladów i map usług

Monitoring and Troubleshooting AWS

Preparing Video For Download...