Alarmy i powiadomienia CloudWatch

Monitoring and Troubleshooting AWS

John Q. Martin

Principal Consultant

Czym są alarmy CloudWatch?
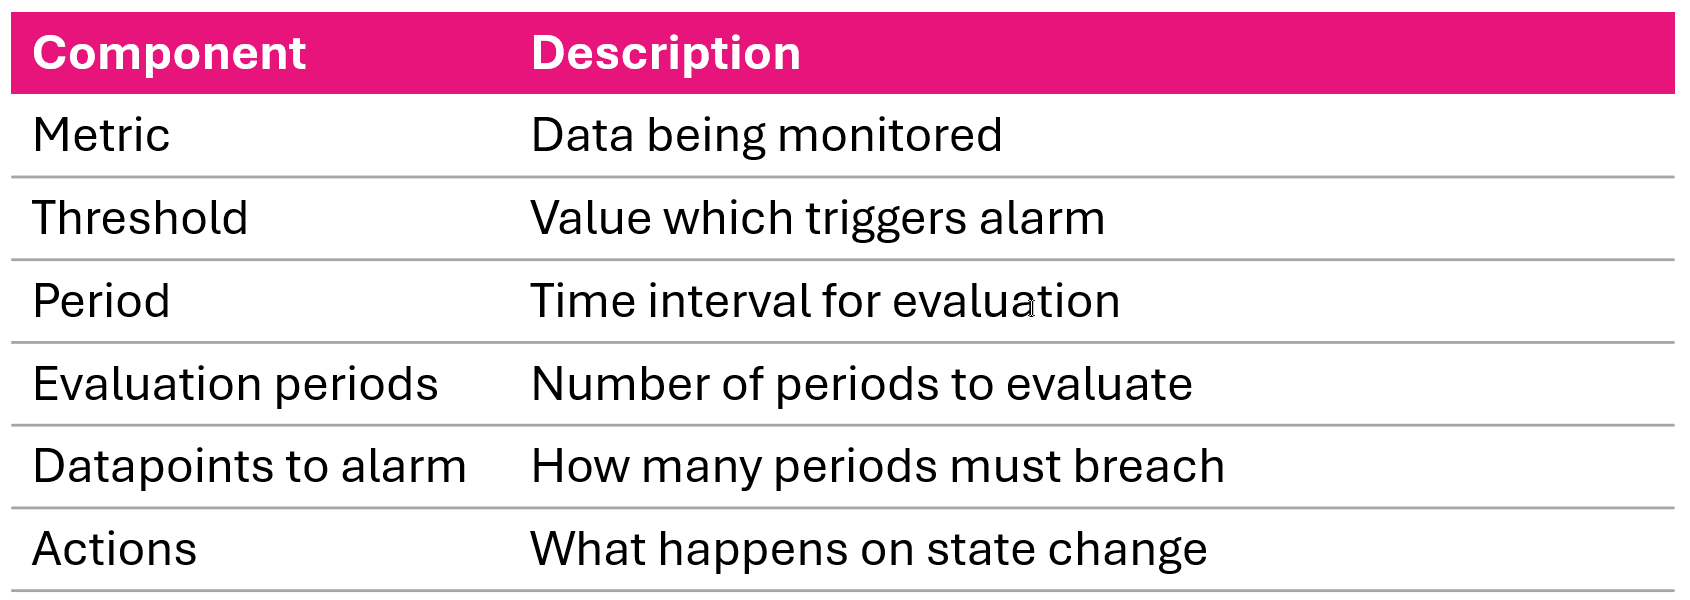
 

Kluczowe pojęcia

  • Monitoruje jedną metrykę przez określony czas
  • Uruchamia akcje, gdy metryka przekroczy próg


Sześć głównych komponentów alarmu CloudWatch: metryka, próg, okres, okresy ewaluacji, punkty danych do alarmu i akcje

Monitoring and Troubleshooting AWS

Stany alarmu

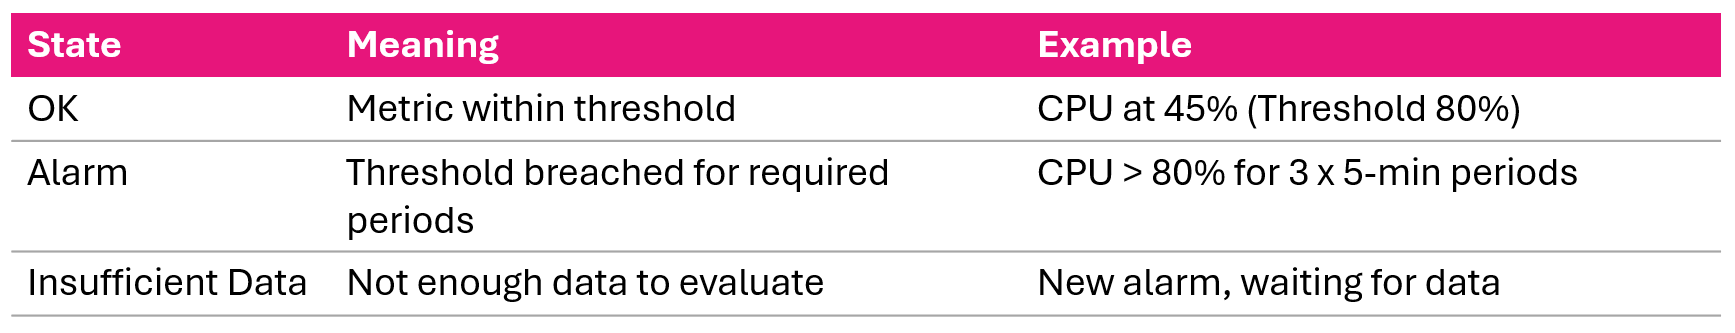
Trzy stany alarmu CloudWatch: OK, ALARM i INSUFFICIENT_DATA

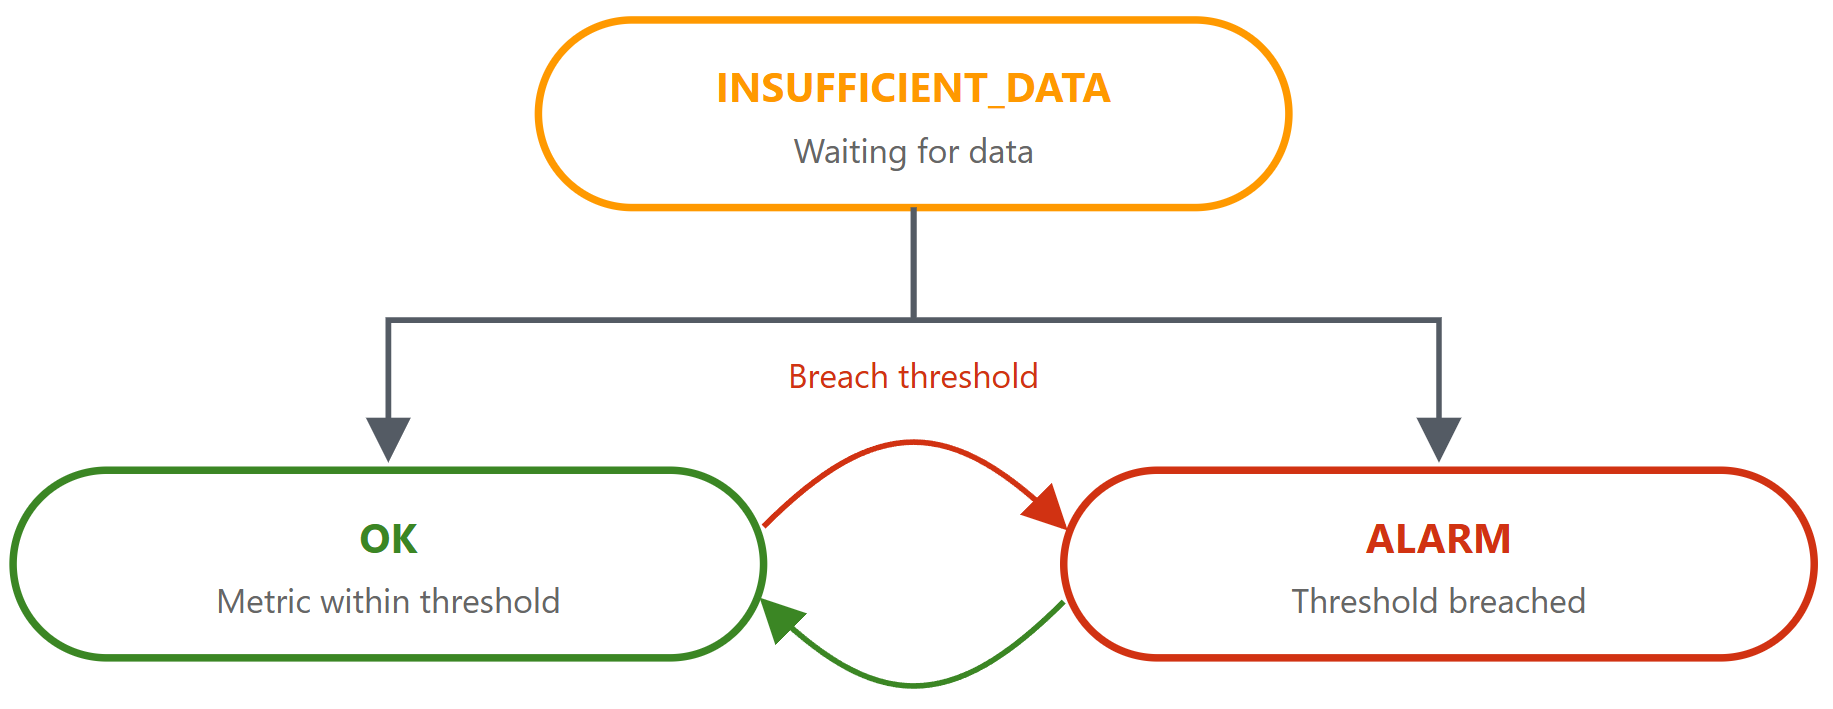
Diagram przejść między stanami alarmu CloudWatch w miarę napływania danych metryki

Monitoring and Troubleshooting AWS

Ewaluacja alarmu


  1. Zbiera punkty danych w określonych interwałach
  2. Stosuje statystykę (Average, Sum, Max, Min) do okresu
  3. Porównuje wynik z progiem
  4. Zlicza okresy ewaluacji z przekroczeniem progu
  5. Zmienia stan, gdy spełniony jest warunek datapoints-to-alarm


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Monitoring and Troubleshooting AWS

Strategie ewaluacji


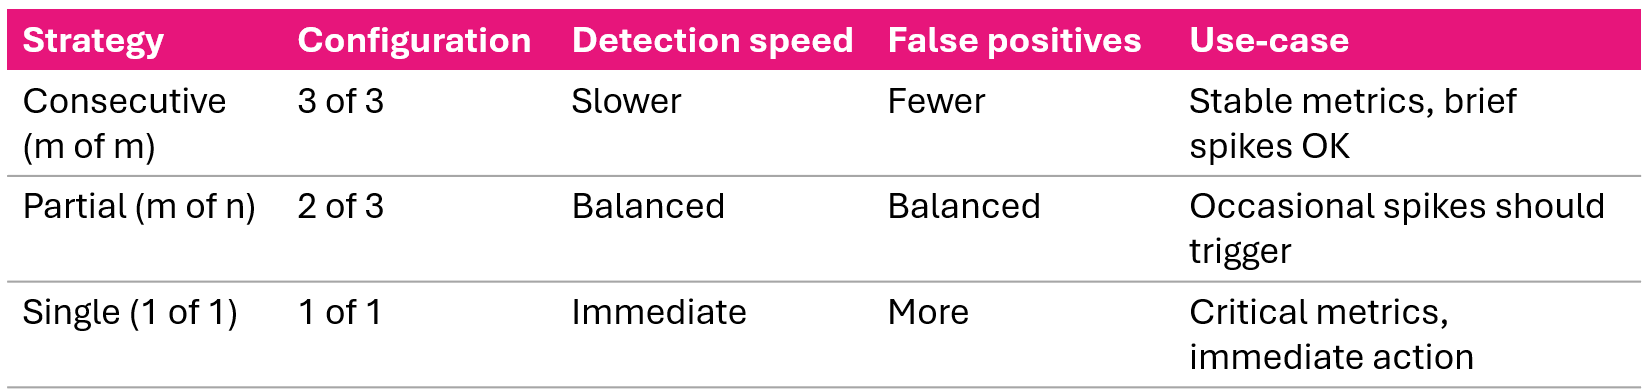
Trzy strategie ewaluacji alarmu: kolejne naruszenia, częściowe i pojedyncze — z omówieniem ich wrażliwości

Monitoring and Troubleshooting AWS

Typy akcji i wyzwalacze alarmu


Wyzwalacze akcji

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Typy akcji

  • Powiadomienie SNS
  • Auto Scaling
  • Akcja EC2 (stop/terminate/reboot/recover)
  • Systems Manager
Monitoring and Troubleshooting AWS

Zachowanie przy brakujących danych


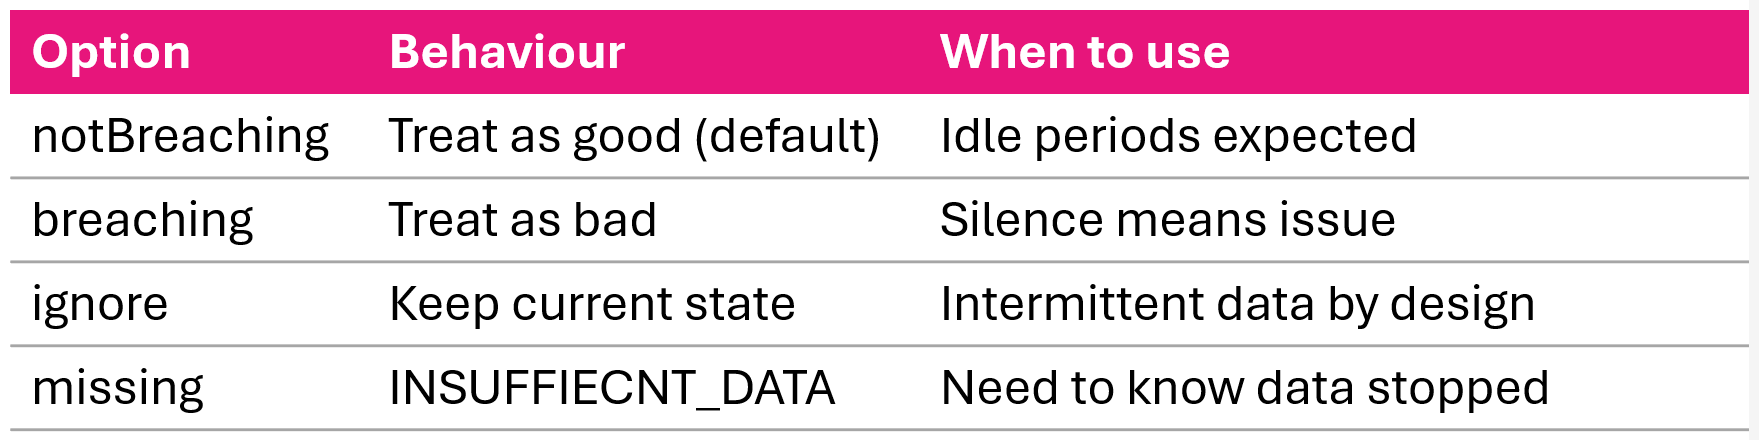
Opcje zachowania alarmu przy brakujących danych: notBreaching, breaching, ignore i missing

Monitoring and Troubleshooting AWS

Tworzenie alarmu standardowego: AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Monitoring and Troubleshooting AWS

Alarmy złożone: czym są i po co je stosować
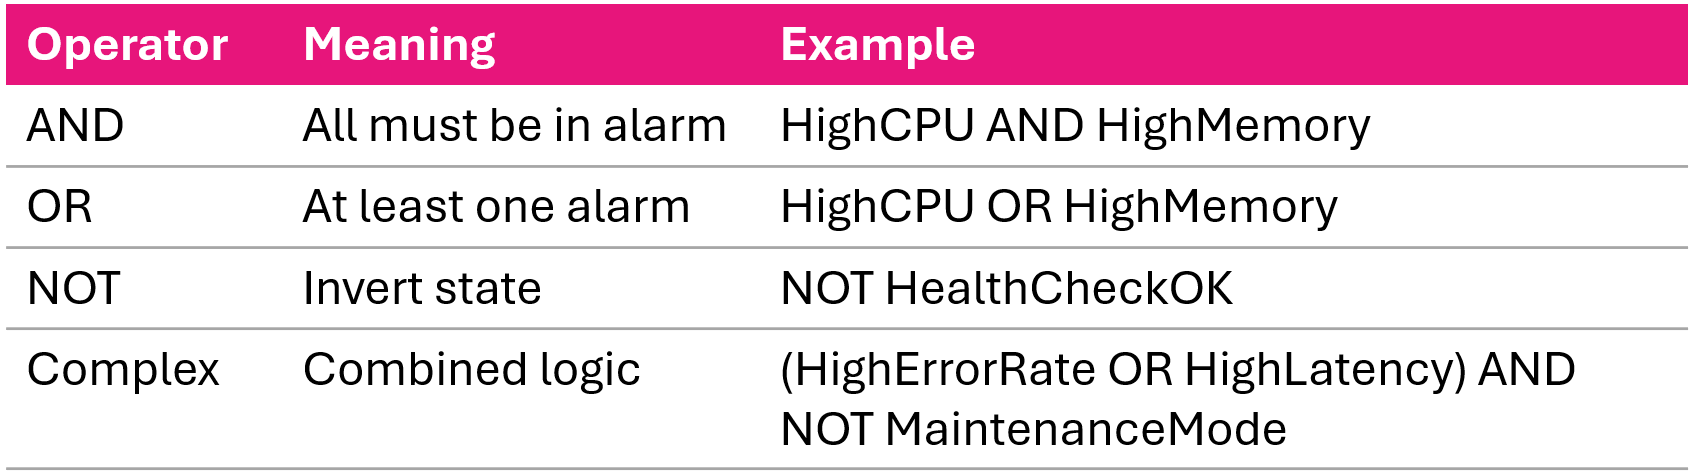
Problem

  • Wiele powiązanych alarmów wyzwala się osobno = przeciążenie alertami

Rozwiązanie

  • Łączy alarmy za pomocą operatorów logicznych

Logika alarmu złożonego łącząca alarmy podrzędne operatorami AND, OR i NOT

Monitoring and Troubleshooting AWS

Tworzenie alarmu złożonego: AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Przykład złożonej reguły
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Monitoring and Troubleshooting AWS

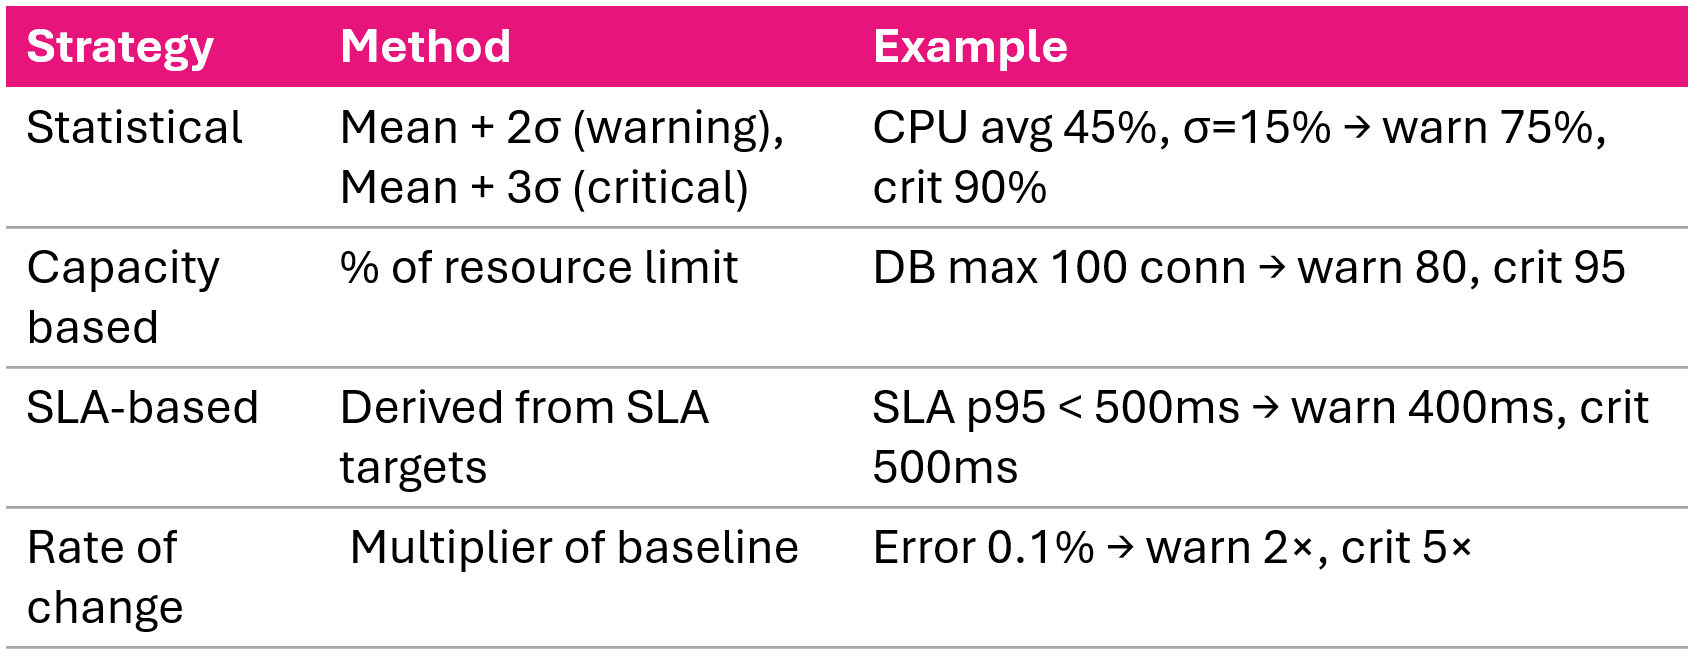
Strategia doboru progu

Cztery strategie doboru progu: odchylenie od linii bazowej, limity pojemności, cele SLA i szybkość zmian

Monitoring and Troubleshooting AWS

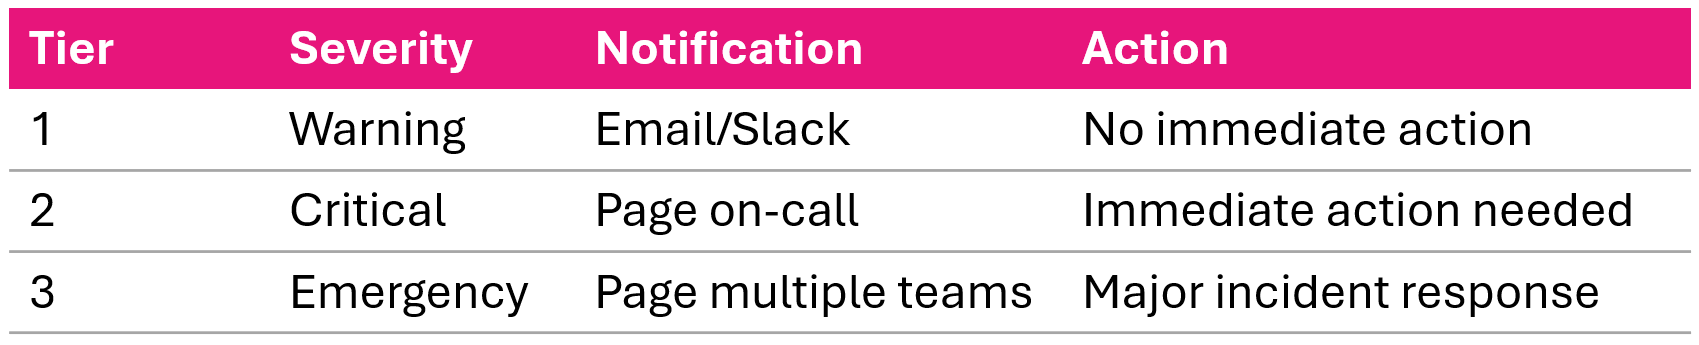
Wielopoziomowa strategia alarmowania


Wielopoziomowa odpowiedź na alarm: poziomy warning, critical i emergency kierowane do osobnych tematów SNS

Przykład: ostrzeżenie CPU przy 75%, stan krytyczny przy 90% — każdy z osobnym tematem SNS

Monitoring and Troubleshooting AWS

Alarmy wykrywania anomalii

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • Model uczenia maszynowego uczy się normalnego zachowania metryki
  • Tworzy dynamiczny przedział progu (konfigurowalny)
  • Dostosowuje się do wzorców dobowych i tygodniowych
  • Ogranicza ręczne strojenie progów
Monitoring and Troubleshooting AWS

Alarmy zasobów: Lambda i ALB

Alarmy Lambda
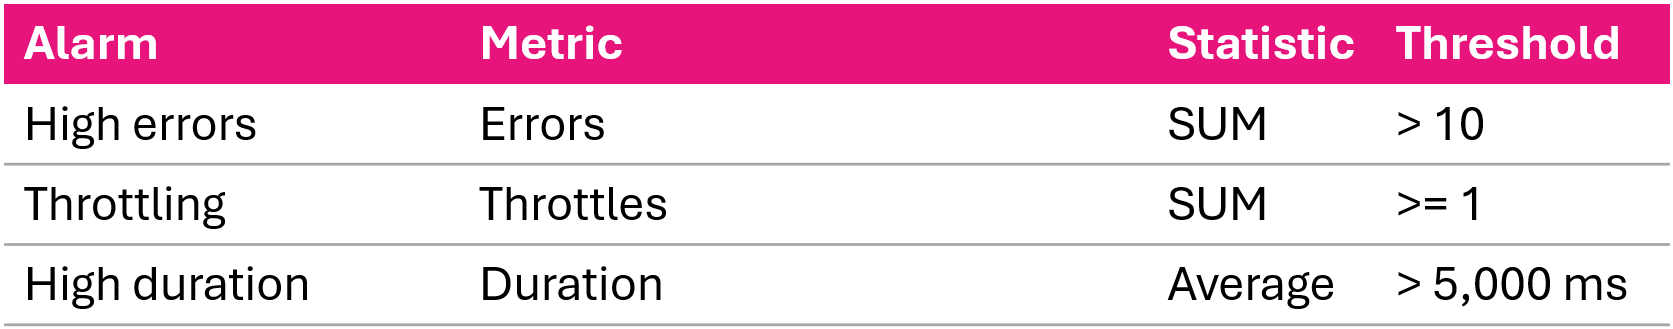
Zalecane alarmy Lambda monitorujące liczbę błędów, ograniczenia przepustowości i czas wykonania bliski limitowi

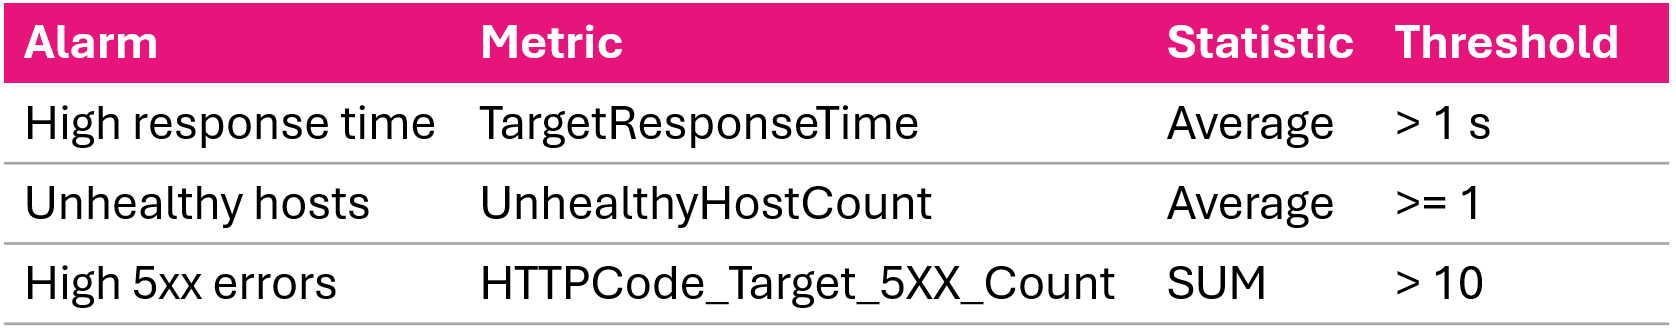
Alarmy ALB

Zalecane alarmy ALB monitorujące czas odpowiedzi, niedostępne hosty i liczbę błędów 5xx

Monitoring and Troubleshooting AWS

Dobre praktyki zarządzania alarmami

  • Nazewnictwo: <Service>-<Metric>-<Resource>-<Severity>
  • Opisy: co jest monitorowane, próg, wskazówki diagnostyczne, linki do runbooka
  • Tagi: Environment, Team, Severity
  • Przegląd miesięczny: dostosuj progi, usuń przestarzałe, zaktualizuj akcje
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Monitoring and Troubleshooting AWS

Podsumowanie

  • Trzy stany alarmu: OK, ALARM, INSUFFICIENT_DATA
  • Strategie ewaluacji: kolejne, częściowe i pojedyncze naruszenia
  • Alarmy złożone łączą wiele alarmów operatorami AND, OR, NOT
  • Cztery strategie doboru progu: statystyczna, pojemności, SLA, szybkość zmian
  • Wielopoziomowe alarmowanie: warning → critical → emergency
  • Alarmy zasobów dla Lambda (błędy, ograniczenia, czas wykonania) i ALB (5xx, opóźnienia)
Monitoring and Troubleshooting AWS

Czas na praktykę!

Monitoring and Troubleshooting AWS

Preparing Video For Download...