Bảng điều khiển sức khỏe ứng dụng

Giám sát và Khắc phục sự cố trên AWS

John Q. Martin

Principal Consultant

Thiết kế dashboard: thứ bậc thông tin
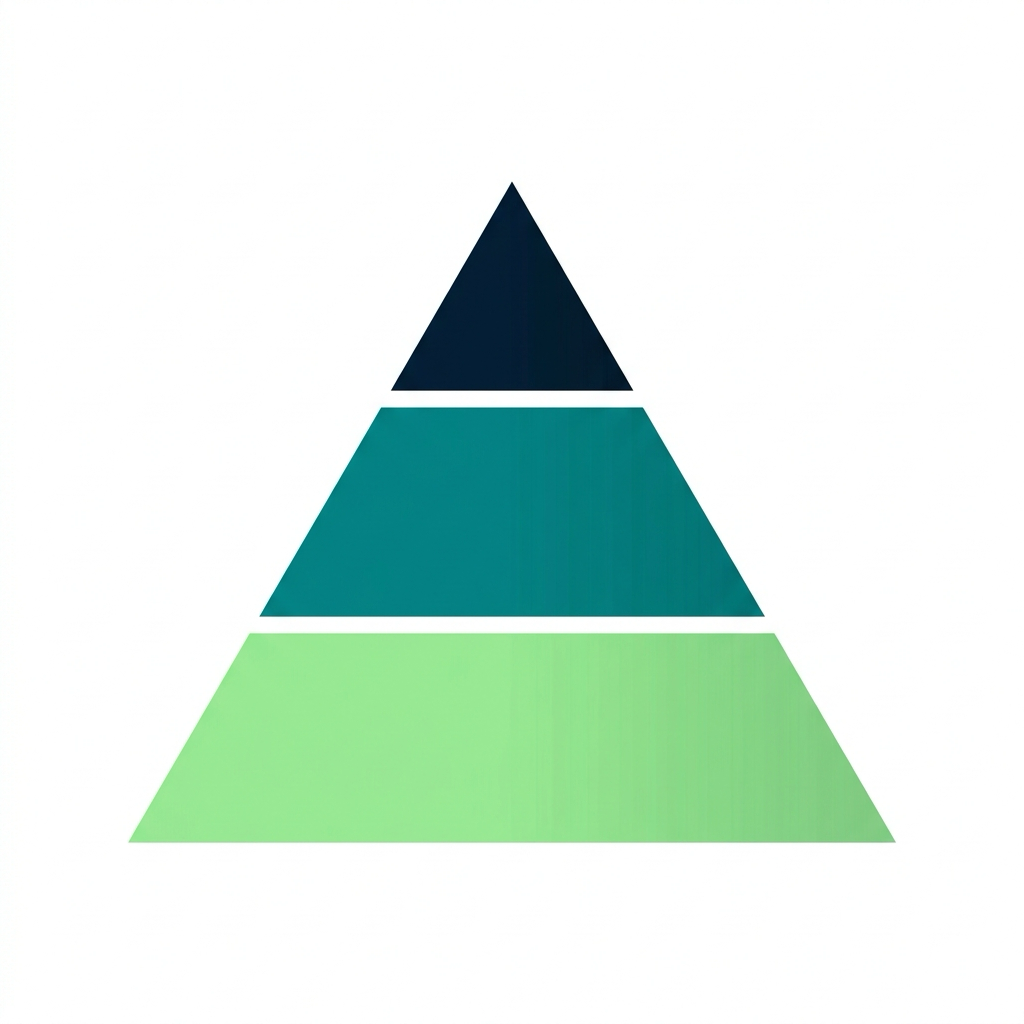
 

Kim tự tháp ba tầng: đỉnh trên hẹp màu tối, tầng giữa rộng hơn màu teal, đáy dưới rộng nhất màu xanh lá

Như bệnh viện: tiếp nhận → buồng bệnh → bác sĩ chuyên khoa


Trên cùng - Tóm tắt điều hành

  • Sức khỏe hệ thống tổng thể
  • Chỉ số kinh doanh chính, SLA, sự cố hiện tại

Giữa - Sức khỏe dịch vụ

  • Tỉ lệ lỗi, phân vị độ trễ, thông lượng

Dưới - Chẩn đoán chi tiết

  • Traces, logs, mức sử dụng tài nguyên, sức khỏe phụ thuộc
Giám sát và Khắc phục sự cố trên AWS

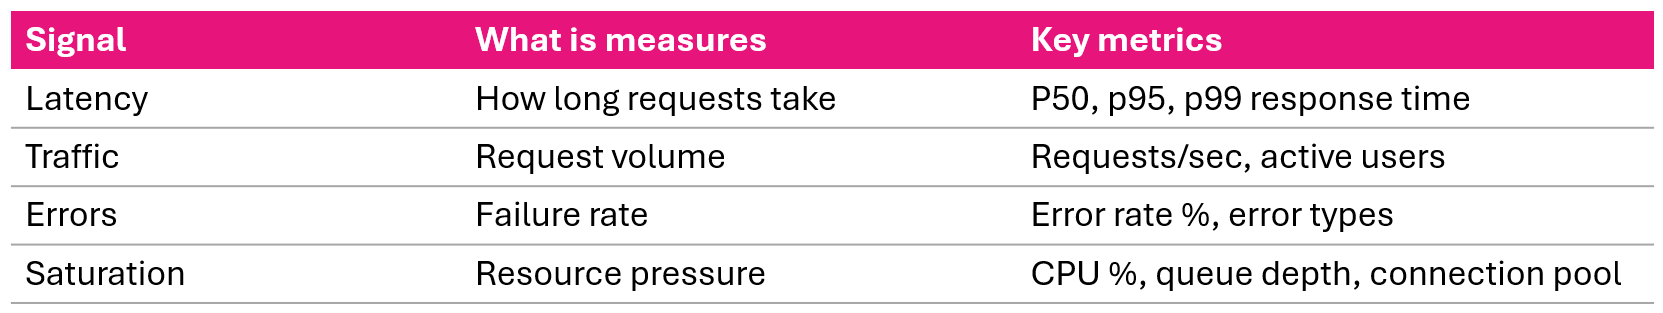
Bốn tín hiệu vàng


Bốn tín hiệu vàng của giám sát: độ trễ, lưu lượng, lỗi và bão hòa

Bao phủ đủ bốn yếu tố này là bạn đã xử lý phần lớn vấn đề sẽ gặp.

Giám sát và Khắc phục sự cố trên AWS

Phương pháp RED


RED cho dịch vụ xử lý request:
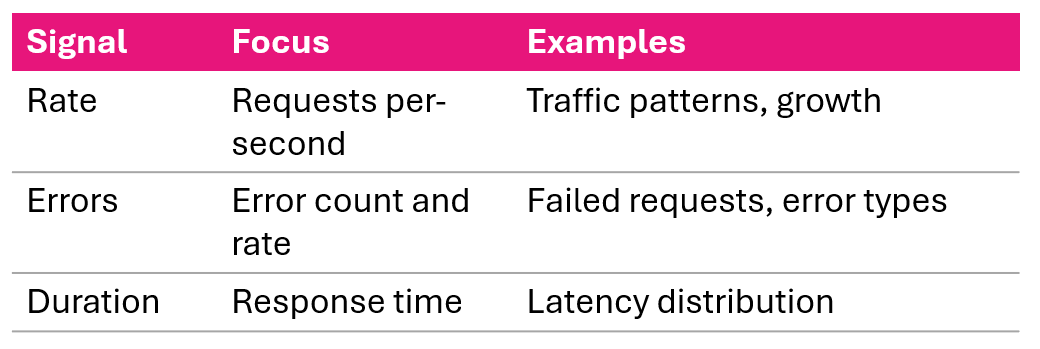
Mẫu phương pháp RED hiển thị rate, errors và duration cho dịch vụ dựa trên request


Liên hệ với các tín hiệu vàng:

  • RED là tập con trọng tâm của bốn tín hiệu vàng
  • Thiết kế cho dịch vụ xử lý yêu cầu người dùng
  • Thêm bão hòa (tín hiệu vàng thứ 4) để giám sát hạ tầng

Dùng RED làm điểm khởi đầu, thêm bão hòa để chẩn đoán sâu hơn.

Giám sát và Khắc phục sự cố trên AWS

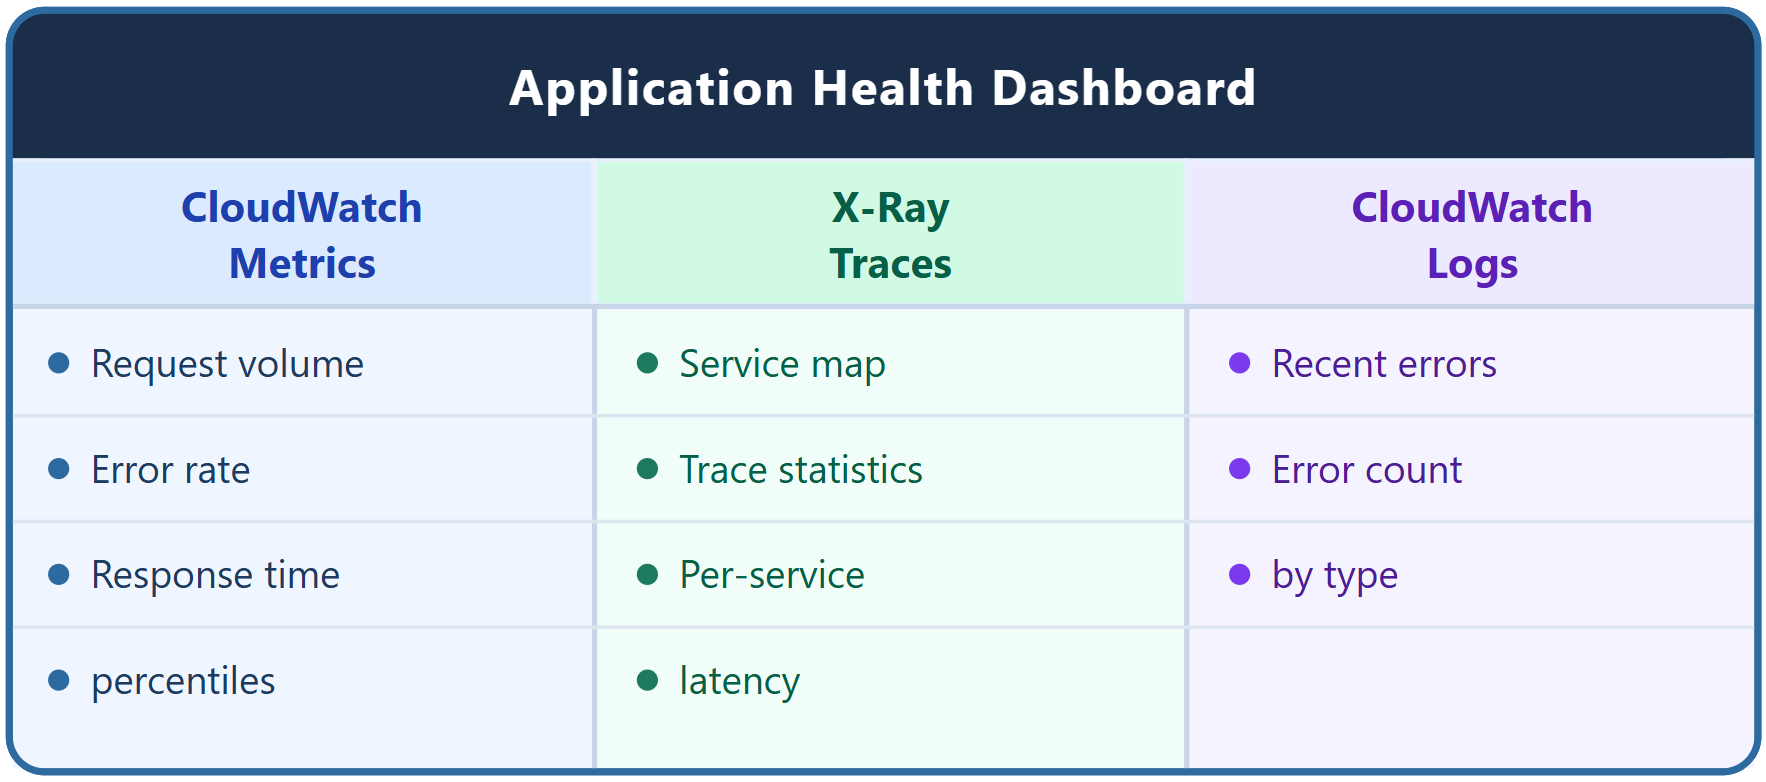
Ba nguồn dữ liệu


Sơ đồ ba nguồn dữ liệu cho dashboard: CloudWatch metrics, X-Ray traces và CloudWatch Logs

Giám sát và Khắc phục sự cố trên AWS

Widget CloudWatch metrics

Khối lượng request:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

Tỉ lệ lỗi (metric math):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

Phân vị thời gian phản hồi:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • Khối lượng request từ ALB RequestCount
  • Tỉ lệ lỗi dùng metric math - errors / invocations x 100
  • Thời gian phản hồi theo phân vị p50, p95, p99
Giám sát và Khắc phục sự cố trên AWS

Widget X-Ray và logs


Widget X-Ray:

  • Service map - sơ đồ ứng dụng với chỉ báo sức khỏe
  • Trace statistics - thời gian phản hồi trung bình, tỉ lệ lỗi, tỉ lệ sự cố
  • Service latency - so sánh thời gian phản hồi theo dịch vụ


Widget CloudWatch Logs:

Truy vấn lỗi gần đây:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

Đếm lỗi theo loại:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
Giám sát và Khắc phục sự cố trên AWS

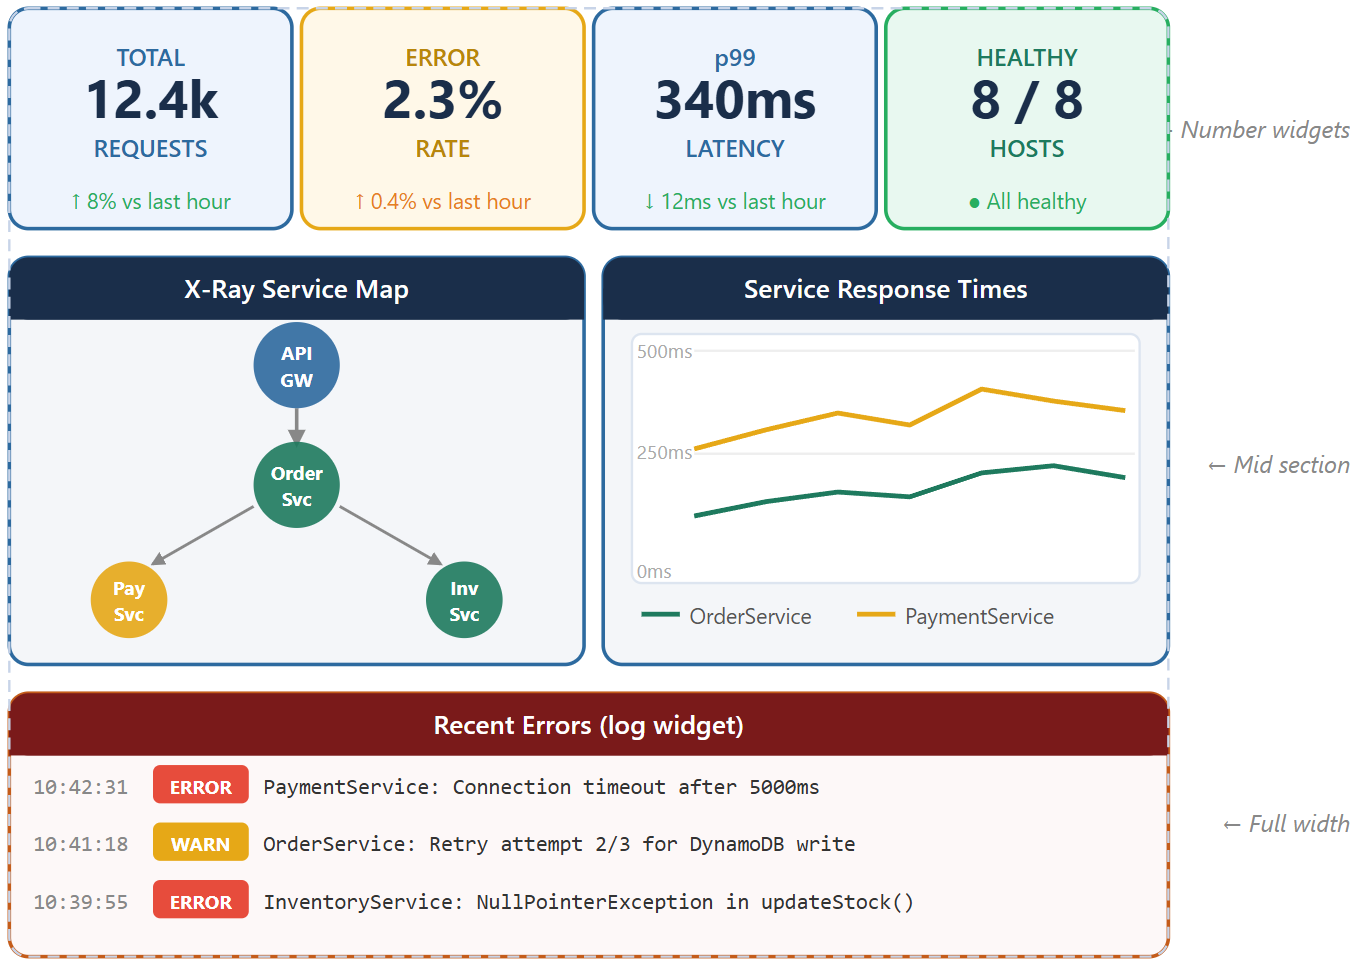
Bố cục dashboard hoàn chỉnh


Bố cục dashboard sức khỏe với widget tóm tắt bên trên, service map ở giữa và logs lỗi bên dưới

Giám sát và Khắc phục sự cố trên AWS

Quy trình xử lý sự cố


Bảng phân loại ưu tiên ở phòng cấp cứu với các dải màu và ống nghe

Như phân loại cấp cứu: ổn định → chẩn đoán → điều trị → xác minh

  1. Nhận diện - chỉ báo đỏ/vàng, đột biến lỗi
  2. Khoanh vùng - dịch vụ nào? khi nào? xấu đi không?
  3. Liên hệ - lỗi + độ trễ, lưu lượng + tài nguyên
  4. Đi sâu - service map → traces → logs
  5. Gốc rễ - phụ thuộc, DB, bộ nhớ, cấu hình
  6. Khắc phục - circuit breaker, scale, rollback, failover
  7. Xác minh - tỉ lệ lỗi bình thường, map xanh, cảnh báo sạch
Giám sát và Khắc phục sự cố trên AWS

Kịch bản 1: đột biến lưu lượng

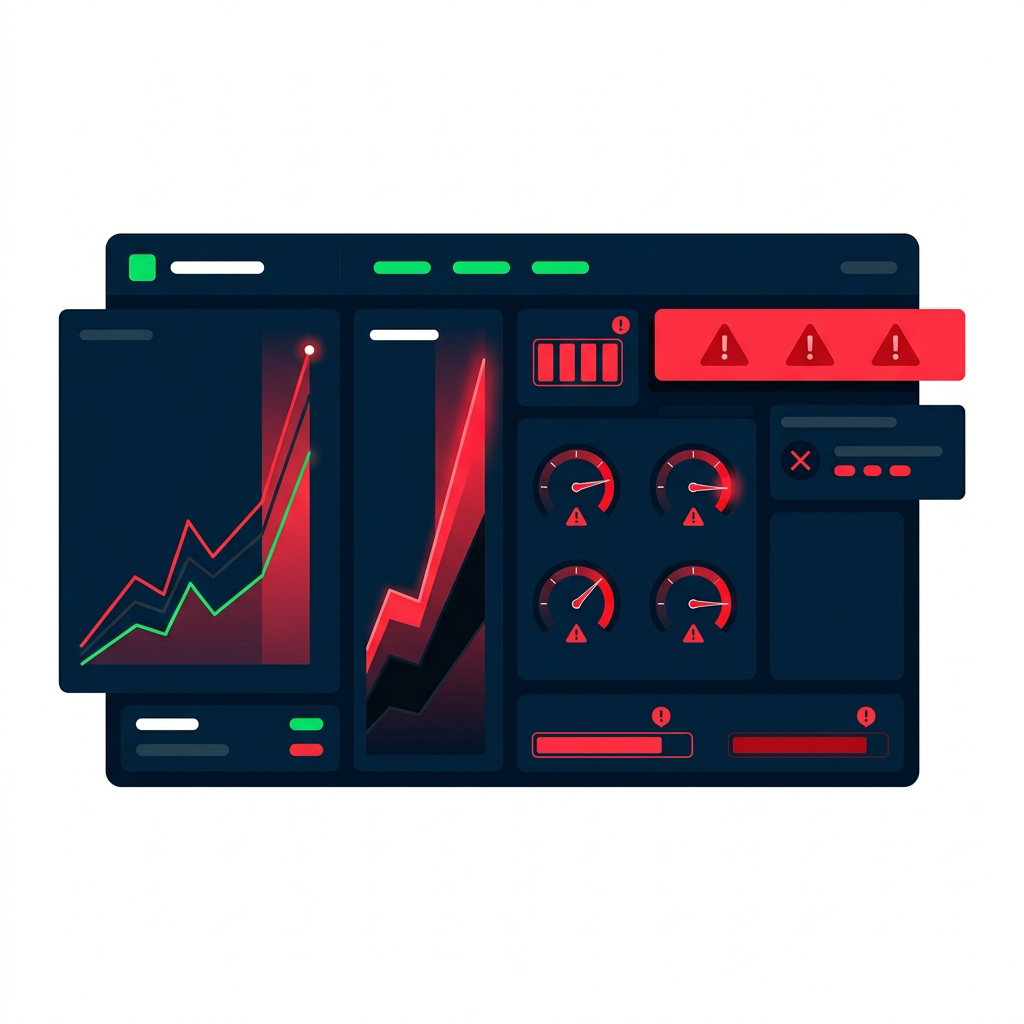
Dashboard giám sát khi tăng đột biến lưu lượng: biểu đồ đường vọt lên, đồng hồ kẹt vùng đỏ, banner cảnh báo đỏ

Những gì bạn thấy trên dashboard:

  • Khối lượng request gấp 10× bình thường
  • Tỉ lệ lỗi 25%
  • Độ trễ 3000ms
  • CPU 95%

Phân tích: Tài nguyên quá tải do lưu lượng tăng đột biến


Hành động:

  • Scale out ngay
  • Bật auto-scaling
  • Triển khai rate limiting
  • Thêm caching để giảm tải backend
Giám sát và Khắc phục sự cố trên AWS

Kịch bản 2: nghẽn cổ chai ở cơ sở dữ liệu
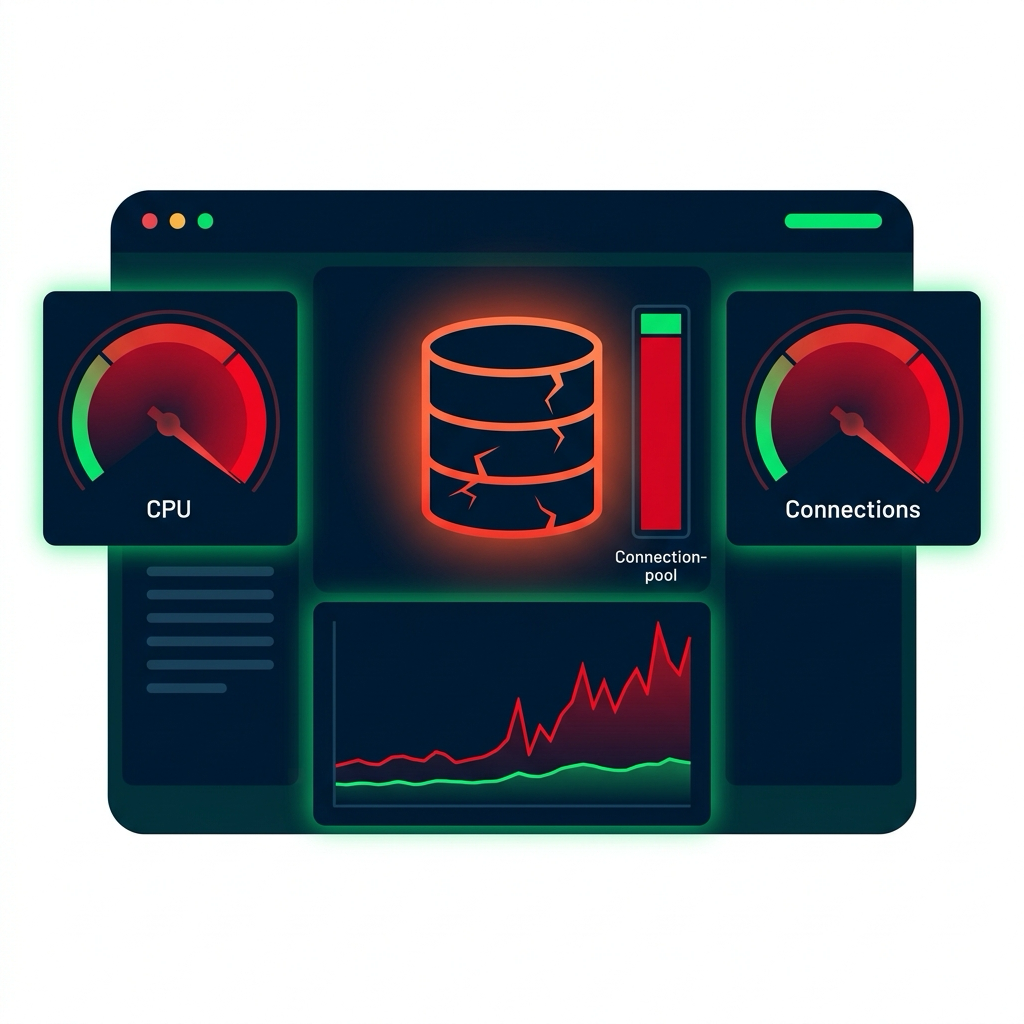
Dashboard giám sát cho thấy nút thắt cổ chai ở cơ sở dữ liệu: biểu tượng DB đỏ nứt, đồng hồ CPU và kết nối chạm đỏ, biểu đồ độ trễ truy vấn leo dốc, thanh pool kết nối gần đầy

Những gì bạn thấy trên dashboard:

  • CPU DB 95%
  • Kết nối DB 95/100
  • Độ trễ truy vấn 5000ms
  • Độ trễ ứng dụng 5500ms

Phân tích: Cơ sở dữ liệu là nút thắt; truy vấn chậm làm cạn pool kết nối


Hành động:

  • Xác định truy vấn chậm trong logs
  • Thêm chỉ mục, tối ưu truy vấn
  • Tăng kích thước pool kết nối
  • Scale cơ sở dữ liệu
Giám sát và Khắc phục sự cố trên AWS

Kịch bản 3: sụp đổ dây chuyền


Những gì bạn thấy trên service map:
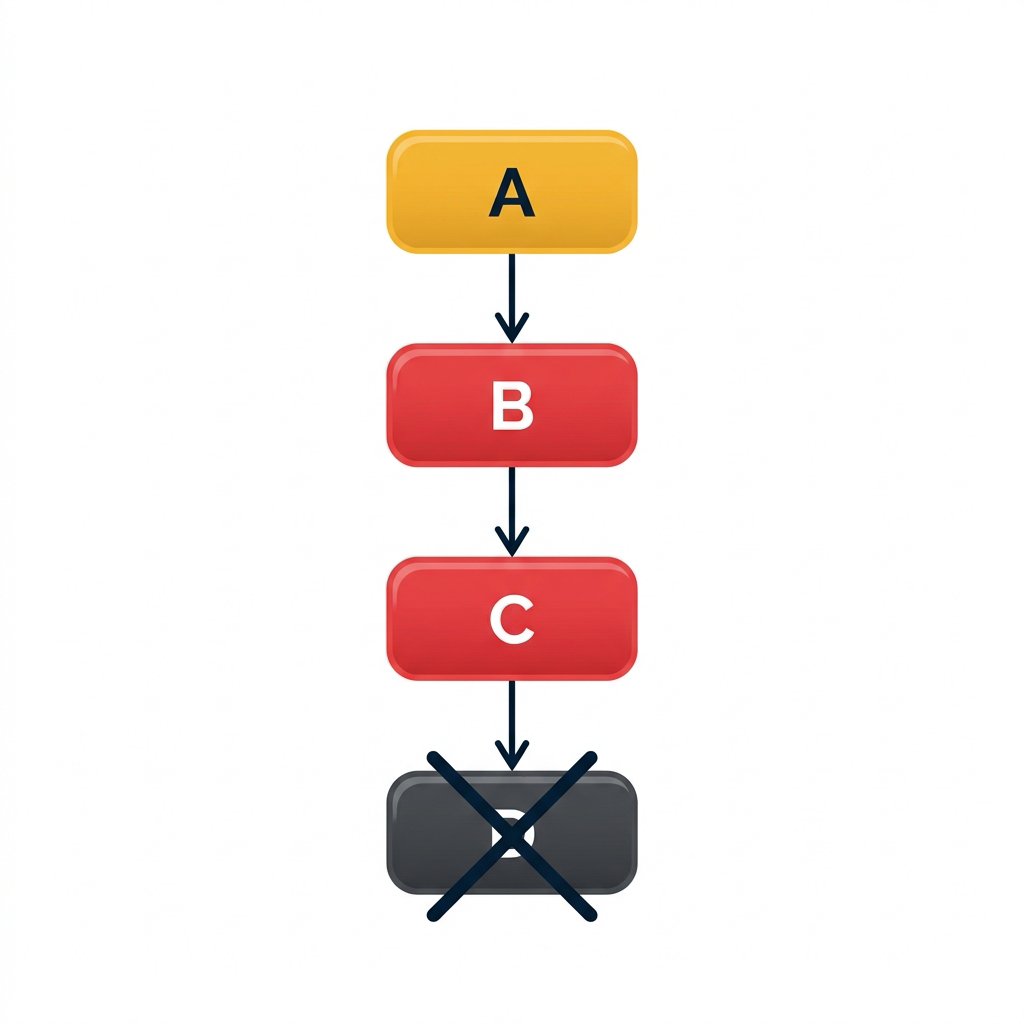
Chuỗi sụp đổ trên service map: nút A màu hổ phách với lỗi client, B và C đỏ với lỗi server, D tối và tắt hoàn toàn, mũi tên dồn theo chuỗi


Phân tích:

Một vấn đề nhỏ ở Service A lan theo chuỗi phụ thuộc

Hành động:

  • Circuit breaker để chặn hiệu ứng dây chuyền
  • Timeout ở mỗi lớp dịch vụ
  • Cơ chế dự phòng cho phụ thuộc lỗi
  • Sửa nguyên nhân gốc ở Service A
Giám sát và Khắc phục sự cố trên AWS

Thực hành tốt cho dashboard


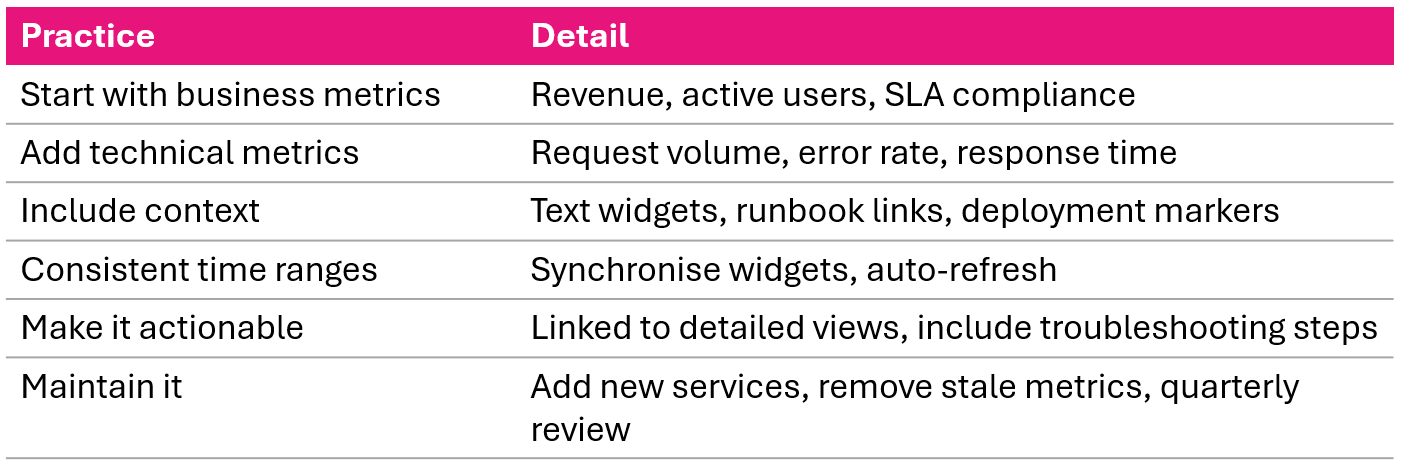
Sáu thực hành tốt được khuyến nghị cho dashboard theo dõi sức khỏe ứng dụng

Giám sát và Khắc phục sự cố trên AWS

Tổng kết video và hoàn thành khóa học

  • Thiết kế theo thứ bậc thông tin và bốn tín hiệu vàng
  • Kết hợp CloudWatch metrics, X-Ray traces và logs trong một màn hình
  • Quy trình 7 bước xử lý sự cố: nhận diện → khoanh vùng → liên hệ → đi sâu → gốc rễ → khắc phục → xác minh

Giờ bạn có thể:

  • Giám sát bằng CloudWatch metrics, logs và dashboards
  • Cấu hình cảnh báo và thông báo với SNS và SQS
  • Triển khai distributed tracing với X-Ray
  • Xây dựng dashboard sức khỏe ứng dụng để vận hành xuất sắc
Giám sát và Khắc phục sự cố trên AWS

Bảng điều khiển sức khỏe ứng dụng

Giám sát và Khắc phục sự cố trên AWS

Preparing Video For Download...