Phân tích trace và service map

Giám sát và Khắc phục sự cố trên AWS

John Q. Martin

Principal Consultant

Service map là gì?


Tự động tạo từ dữ liệu trace của bạn: không cần cấu hình thủ công
Bảng giờ tàu với các dòng dịch vụ, mỗi dòng có đèn trạng thái màu: xanh đúng giờ, vàng trễ, đỏ dừng

Nhìn nhanh: xanh = đúng giờ · vàng = trễ · đỏ = dừng


Cách truy cập:

  • X-Ray console → Service map
  • Áp dụng bộ lọc
  • Nhấp vào nút → xem chi tiết phân rã
Giám sát và Khắc phục sự cố trên AWS

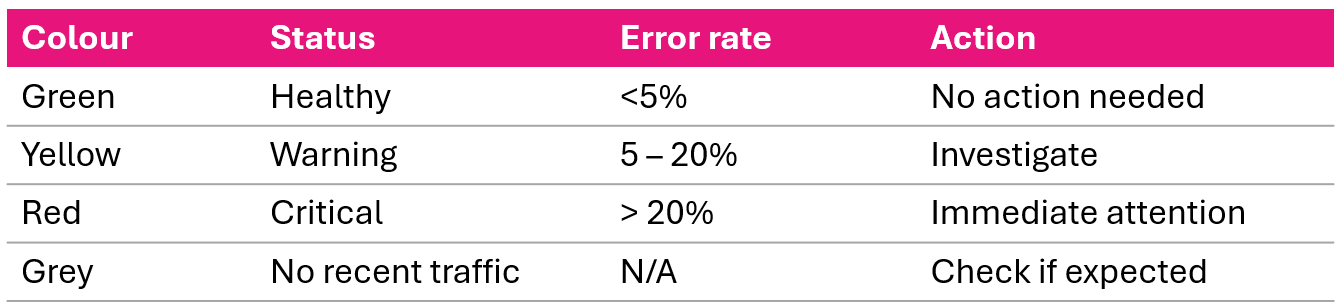
Mã màu của service map


Chú giải màu service map: xanh gọi thành công, vàng lỗi phía client, đỏ lỗi phía server, tím throttling, xám không có lưu lượng

Khi mở service map, hãy xem ngay mọi thứ không phải màu xanh.

Nhấp vào bất kỳ nút nào để xem: phân bố thời gian phản hồi, phân rã trạng thái HTTP, loại lỗi.

Giám sát và Khắc phục sự cố trên AWS

Cách đọc service map


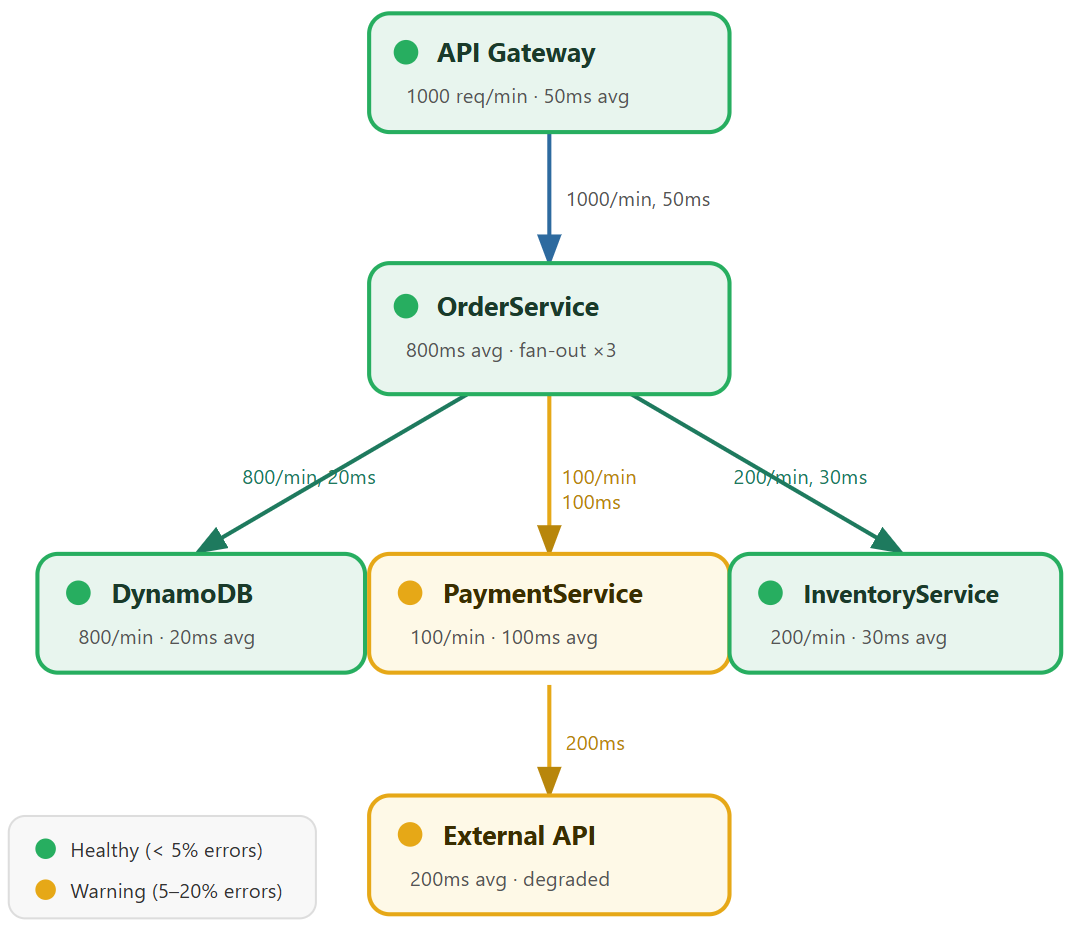
Service map với API Gateway và OrderService tỏa nhánh tới DynamoDB Inventory và một dịch vụ Payment màu vàng

Giám sát và Khắc phục sự cố trên AWS

Phân tích đường găng


Đường găng = chuỗi gọi dịch vụ dài nhất

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Tổng: 400ms

External API = 50% tổng độ trễ


Nên làm gì với điều này:

  • External API là mục tiêu tối ưu hóa
  • Tùy chọn: thêm caching, đặt timeout + fallback, đàm phán SLA

So sánh đường khác:

OrderService -> DynamoDB
Tổng: 120ms (nhanh)
Giám sát và Khắc phục sự cố trên AWS

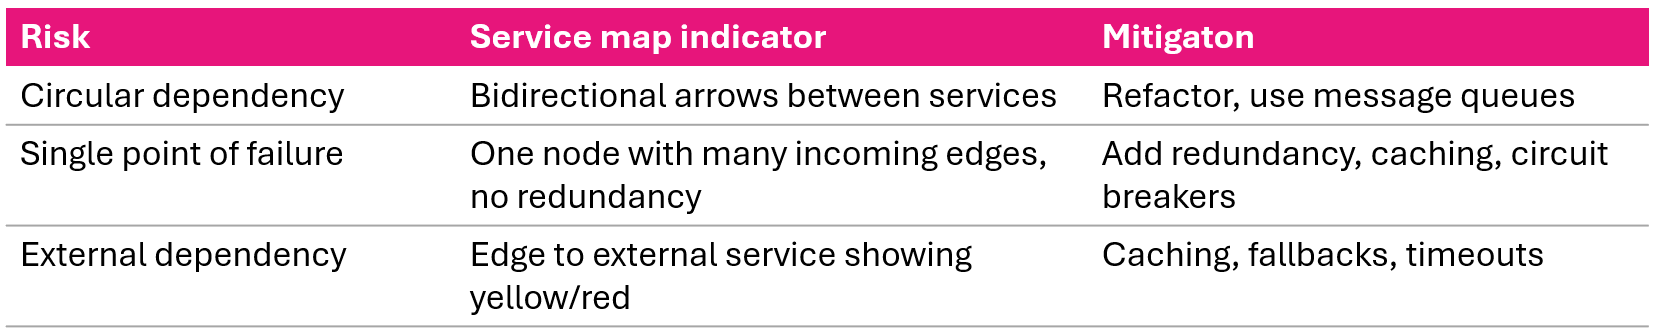
Rủi ro phụ thuộc


Rủi ro phụ thuộc trên service map: vòng phụ thuộc, điểm lỗi đơn, và phụ thuộc ngoài rủi ro

Giám sát và Khắc phục sự cố trên AWS

Hiểu dòng thời gian trace


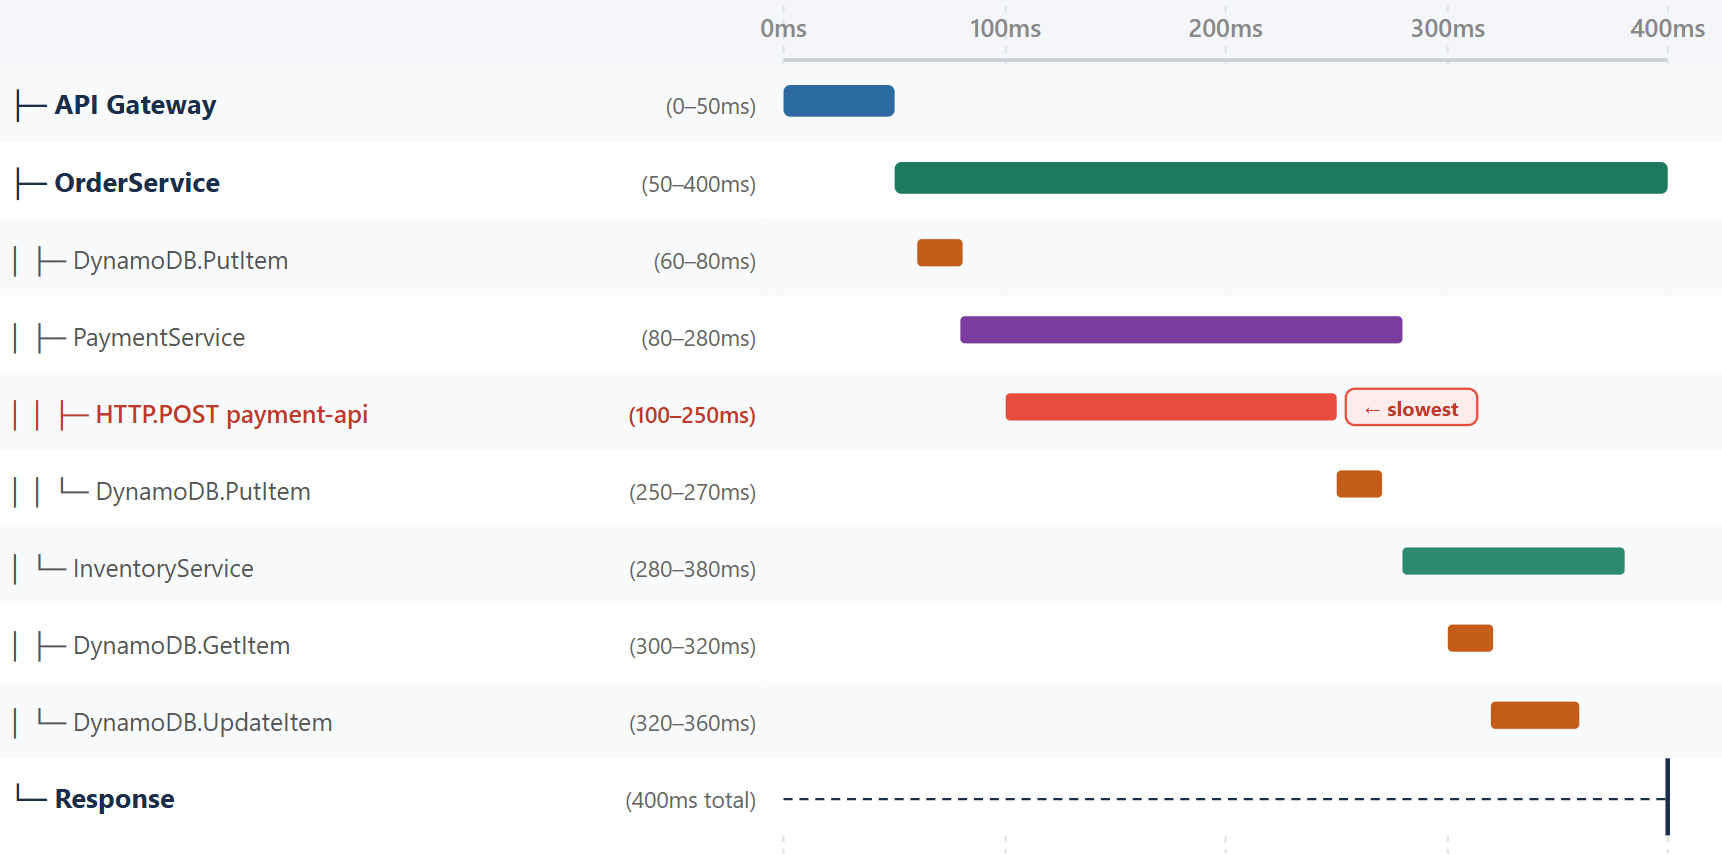
Dòng thời gian trace với các tiểu đoạn theo trục thời gian, cho thấy cuộc gọi payment-api là thao tác dài nhất


  • Trục ngang thời gian: lúc bắt đầu và thời lượng thao tác
  • Trục dọc phân cấp dịch vụ: tiểu đoạn thụt vào dưới cha
  • HTTP.POST tới payment-api (100–250ms) = thao tác đơn lẻ dài nhất
Giám sát và Khắc phục sự cố trên AWS

Mẫu 1: Nút thắt tuần tự


Trước (tuần tự - 80ms):

Query 1 (10-30ms)
         -> Query 2 (30-50ms)
                  -> Query 3 (50-70ms)
                           -> Query 4 (70-90ms)


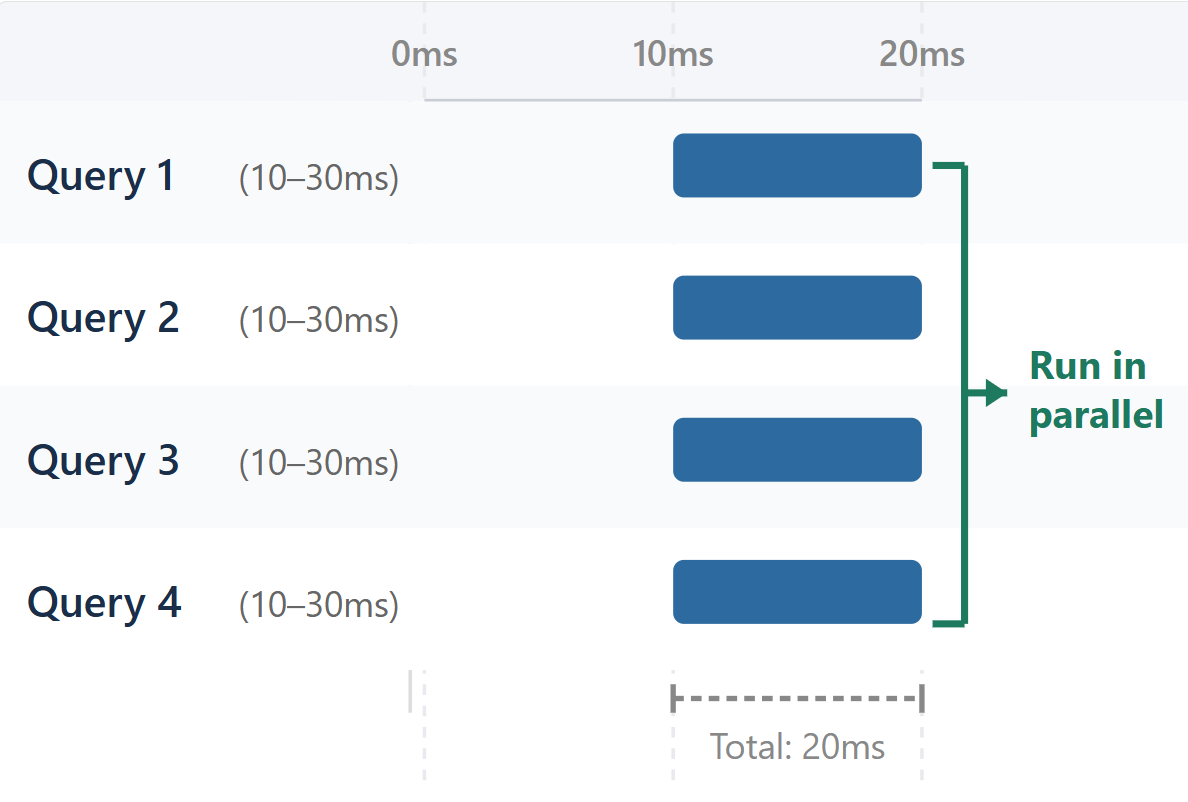
Sau (song song - 20ms):

Dòng thời gian 4 truy vấn chạy song song chồng lấp, hoàn tất trong 20ms

Giám sát và Khắc phục sự cố trên AWS

Mẫu 2: Truy vấn N+1 và dịch vụ nói nhiều


Vấn đề truy vấn N+1:

Lấy danh sách user       (10-20ms)
Lấy chi tiết user 1      (20-30ms)
Lấy chi tiết user 2      (30-40ms)
... ×100 truy vấn tuần tự

Cách khắc phục: gộp truy vấn, eager loading


Dịch vụ nói nhiều:

  • 50 cuộc gọi nhỏ giữa hai dịch vụ thay vì 1 cuộc gọi gộp
  • Mỗi cuộc gọi: thiết lập kết nối + tuần tự hóa + khứ hồi
  • 50× chi phí đội thêm

Cách khắc phục: gộp yêu cầu, hàng đợi thông điệp, caching

Giám sát và Khắc phục sự cố trên AWS

Mẫu 3: Cold start và sự cố dây chuyền
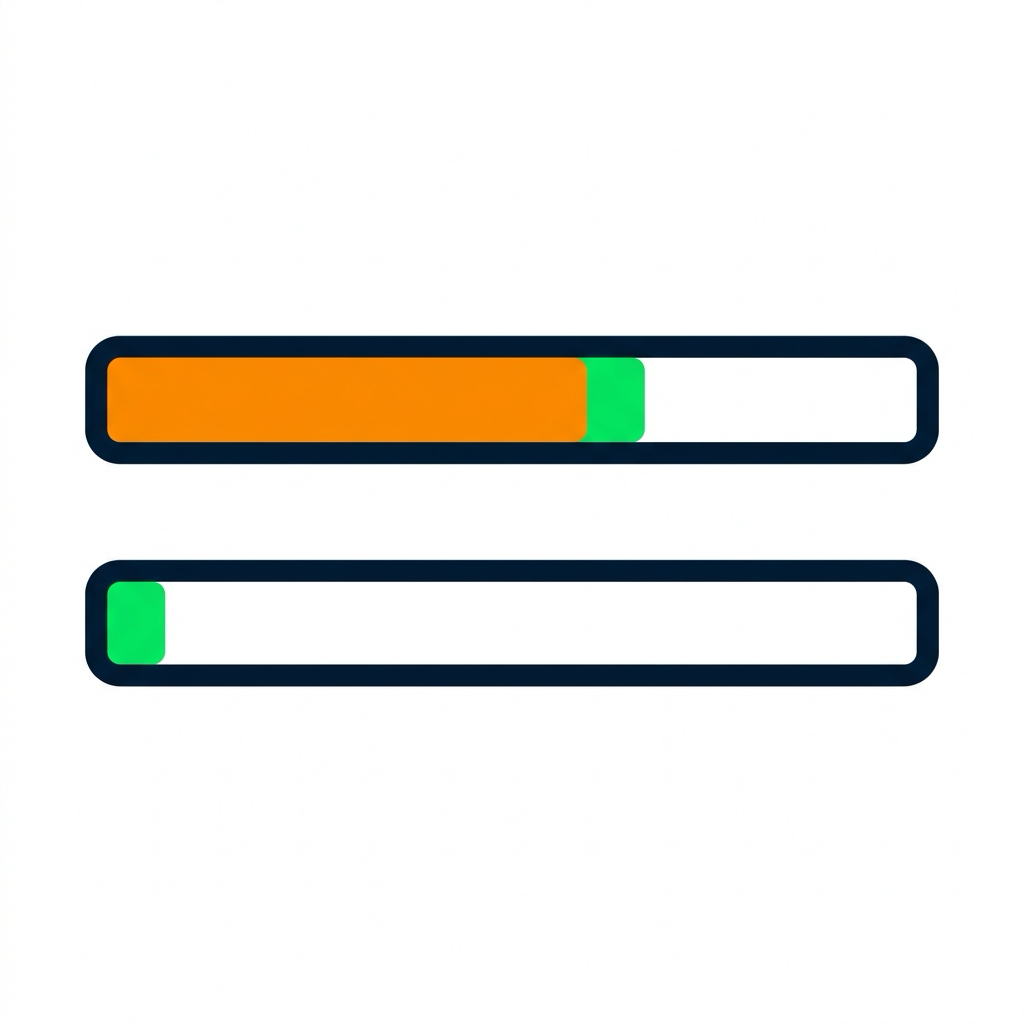
 

Hai thanh thời gian: cold start có khối khởi tạo màu cam lớn rồi khối handler màu xanh nhỏ; warm start chỉ có khối handler xanh nhỏ

Lambda Cold Start:

  • Cold: 3000ms (khởi tạo 2500ms + handler 500ms)
  • Warm: 500ms (chỉ handler)
  • Thể hiện bằng đoạn khởi tạo lớn ở lần gọi đầu

Khắc phục: provisioned concurrency, tối ưu khởi tạo


Sự cố dây chuyền:

Service A [Error]
  -> Service B [Timeout 5s]
    -> Service C [Timeout 5s]
      -> Database [Timeout 5s]

Các khối timeout xếp chồng theo phân cấp trace

Khắc phục: timeout, circuit breaker, fallback

Giám sát và Khắc phục sự cố trên AWS

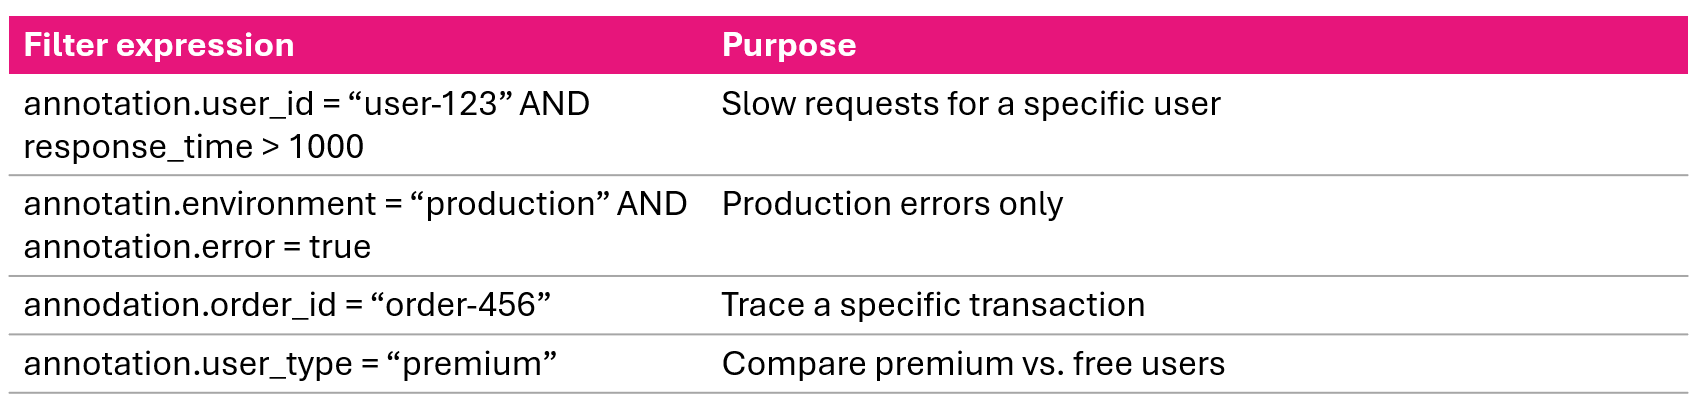
Lọc trace bằng annotations

X-Ray console lọc trace theo cặp khóa–giá trị annotation

So sánh nhóm:

  • Người dùng premium trung bình 200ms vs. miễn phí 150ms → tính năng premium làm tăng độ trễ
  • EU West chậm gấp 3 lần US East → vấn đề truy cập dữ liệu xuyên vùng
Giám sát và Khắc phục sự cố trên AWS

Quy trình phân tích trace


  1. Xác định - lọc: response_time > 1000ms, sắp xếp theo thời lượng
  2. Phân tích - tìm thao tác dài nhất, nút thắt tuần tự, cơ hội song song
  3. Gắn nhãn - kiểm tra annotations theo ngữ cảnh nghiệp vụ: user ID, order ID, môi trường
  4. Rà soát - xem metadata: chi tiết yêu cầu, thông báo lỗi
  5. Đối chiếu - tham chiếu chéo với CloudWatch Logs
  6. Chẩn đoán - nguyên nhân gốc: truy vấn chậm, timeout, thuật toán, cạn tài nguyên
  7. Sửa - tối ưu code, thêm caching, chạy song song, mở rộng
  8. Xác minh - so sánh trace trước/sau, theo dõi độ trễ và tỷ lệ lỗi
Giám sát và Khắc phục sự cố trên AWS

Tạo cảnh báo từ dữ liệu X-Ray


# Cảnh báo độ trễ cao
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# Cảnh báo số lỗi cao
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
Giám sát và Khắc phục sự cố trên AWS

Tóm tắt video


  • Service map - sơ đồ kiến trúc tự động: nút (dịch vụ), cạnh (kết nối), màu sức khỏe
  • Mã màu - xanh (thành công), vàng (4xx), đỏ (lỗi 5xx), tím (429), xám (không lưu lượng)
  • Đường găng - chuỗi gọi dài nhất, chỉ ra mục tiêu tối ưu hóa
  • Dòng thời gian trace - lộ nút thắt tuần tự, truy vấn N+1, cold start, sự cố dây chuyền
  • Annotations - lọc và nhóm trace theo ngữ cảnh nghiệp vụ
  • Quy trình - 8 bước: xác định → phân tích → gắn nhãn → rà soát → đối chiếu → chẩn đoán → sửa → xác minh
Giám sát và Khắc phục sự cố trên AWS

Phân tích trace và service map

Giám sát và Khắc phục sự cố trên AWS

Preparing Video For Download...