Cảnh báo và thông báo CloudWatch

Giám sát và Khắc phục sự cố trên AWS

John Q. Martin

Principal Consultant

CloudWatch Alarms là gì
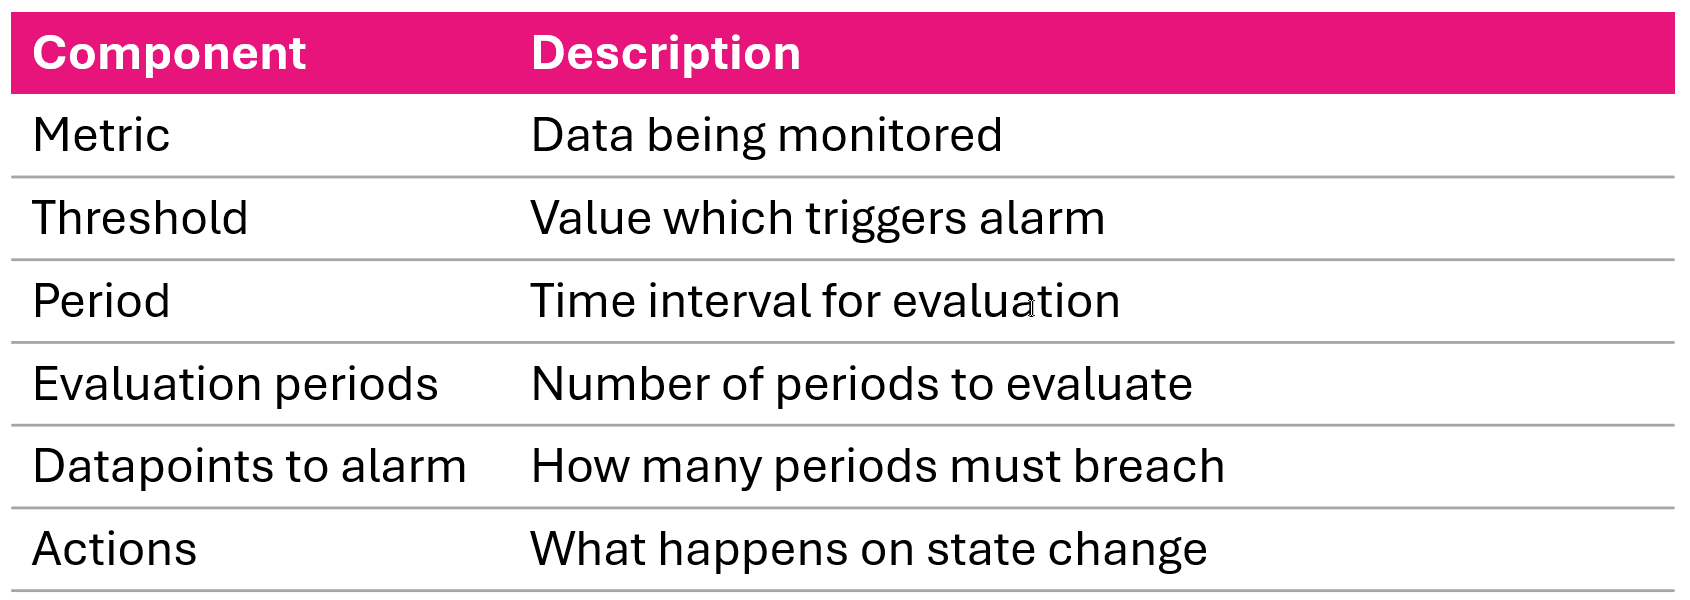
 

Khái niệm chính

  • Theo dõi một chỉ số trong một khoảng thời gian
  • Thực hiện hành động khi chỉ số vượt ngưỡng


Sáu thành phần chính của CloudWatch alarm: metric, threshold, period, evaluation periods, datapoints to alarm và actions

Giám sát và Khắc phục sự cố trên AWS

Trạng thái cảnh báo

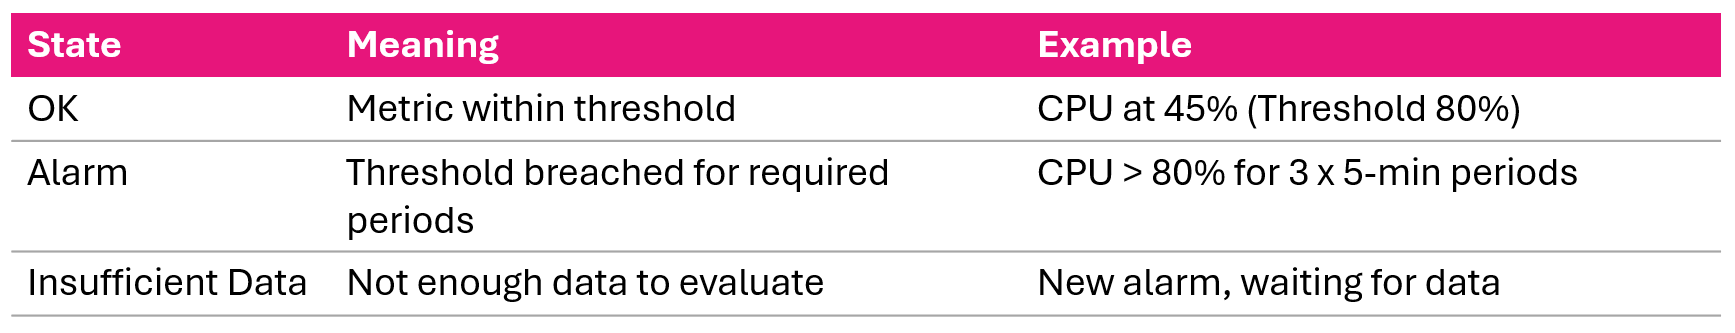
Ba trạng thái của CloudWatch alarm: OK, ALARM và INSUFFICIENT_DATA

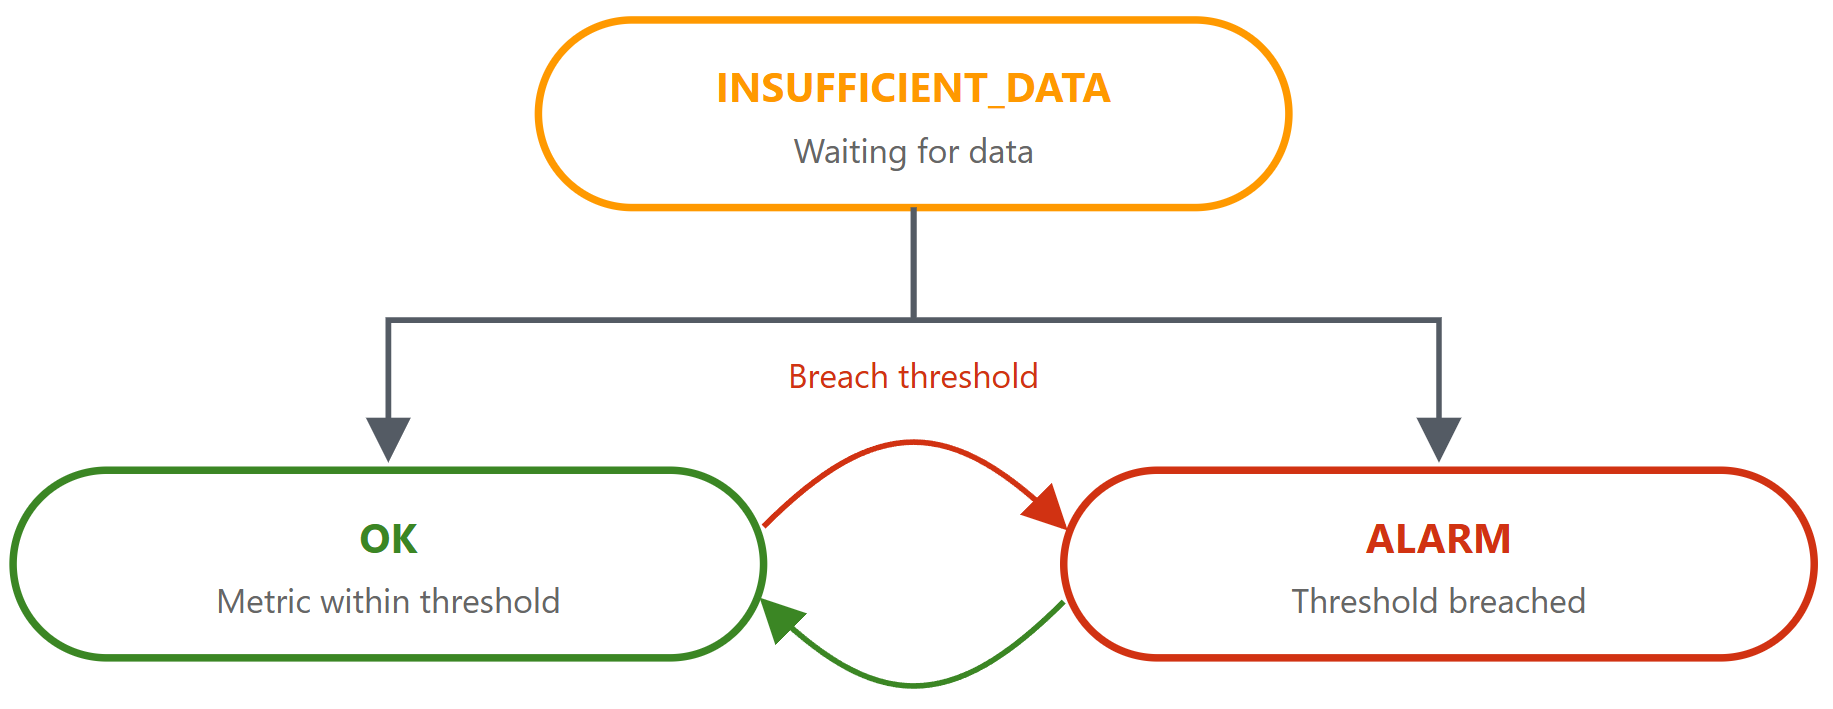
Sơ đồ cách CloudWatch alarm chuyển trạng thái khi dữ liệu metric đến

Giám sát và Khắc phục sự cố trên AWS

Đánh giá cảnh báo


  1. Thu thập điểm dữ liệu theo khoảng thời gian đặt trước
  2. Áp dụng thống kê (Average, Sum, Max, Min) theo period
  3. So sánh kết quả với ngưỡng
  4. Đếm số period vi phạm
  5. Đổi trạng thái nếu đạt ngưỡng datapoints-to-alarm


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Giám sát và Khắc phục sự cố trên AWS

Chiến lược đánh giá


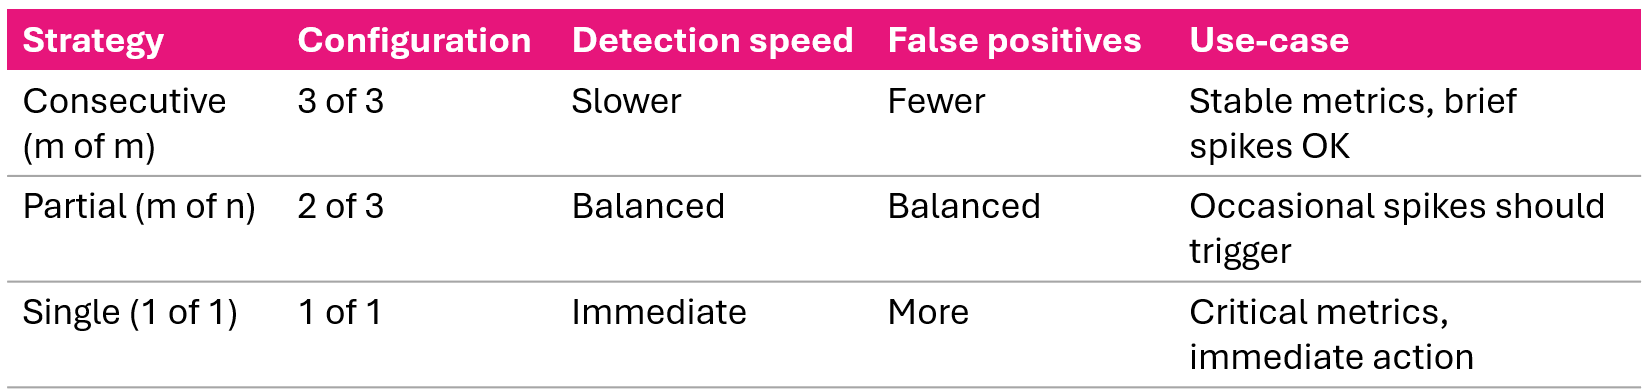
Ba chiến lược đánh giá cảnh báo: consecutive, partial và single breach cùng mức nhạy tương ứng

Giám sát và Khắc phục sự cố trên AWS

Loại và kích hoạt hành động cảnh báo


Kích hoạt hành động

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Loại hành động

  • Thông báo SNS
  • Auto Scaling
  • Hành động EC2 (stop/terminate/reboot/recover)
  • Systems Manager
Giám sát và Khắc phục sự cố trên AWS

Hành vi khi thiếu dữ liệu


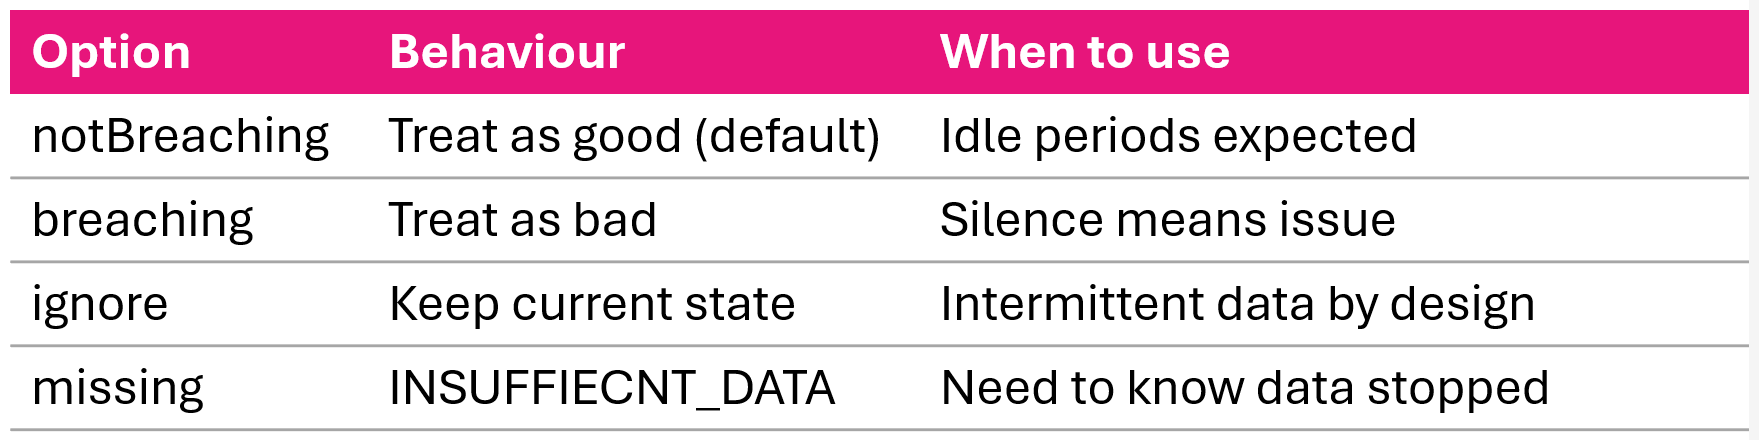
Tùy chọn hành vi khi thiếu dữ liệu: notBreaching, breaching, ignore và missing

Giám sát và Khắc phục sự cố trên AWS

Tạo cảnh báo chuẩn: AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Giám sát và Khắc phục sự cố trên AWS

Cảnh báo tổng hợp: là gì và vì sao

Vấn đề

  • Nhiều cảnh báo liên quan kích hoạt riêng lẻ = mệt mỏi vì cảnh báo

Giải pháp

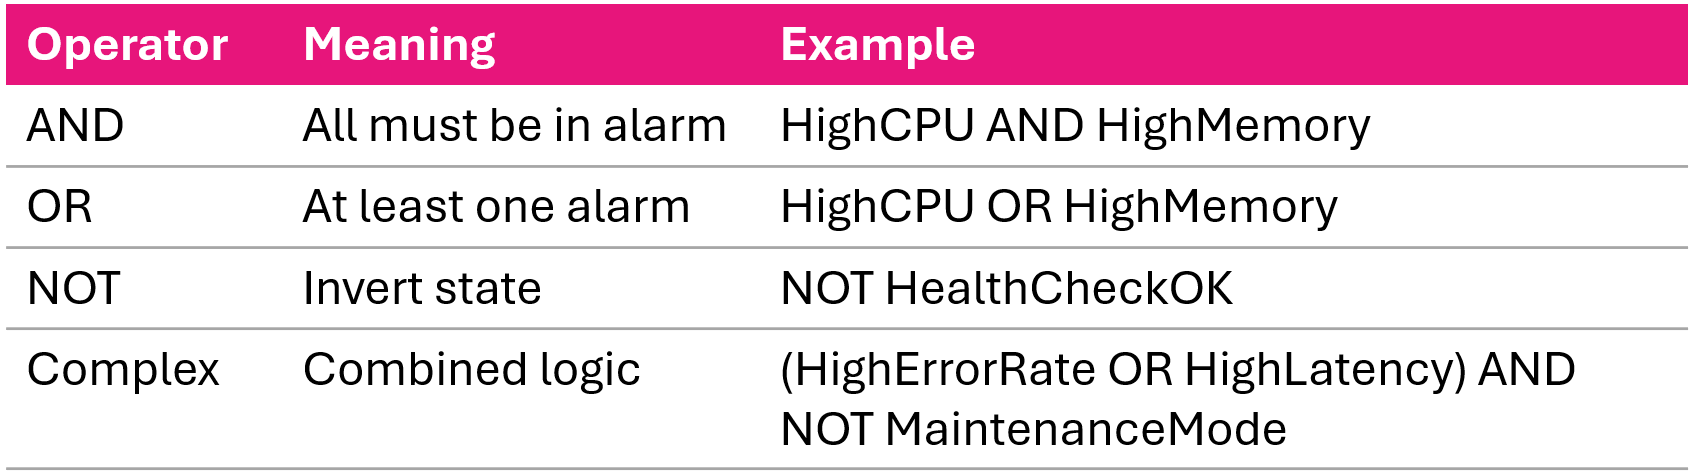
  • Kết hợp cảnh báo bằng toán tử logic

Logic cảnh báo tổng hợp kết hợp các alarm con bằng toán tử AND, OR và NOT

Giám sát và Khắc phục sự cố trên AWS

Tạo cảnh báo tổng hợp: AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Ví dụ quy tắc phức tạp
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Giám sát và Khắc phục sự cố trên AWS

Chiến lược chọn ngưỡng

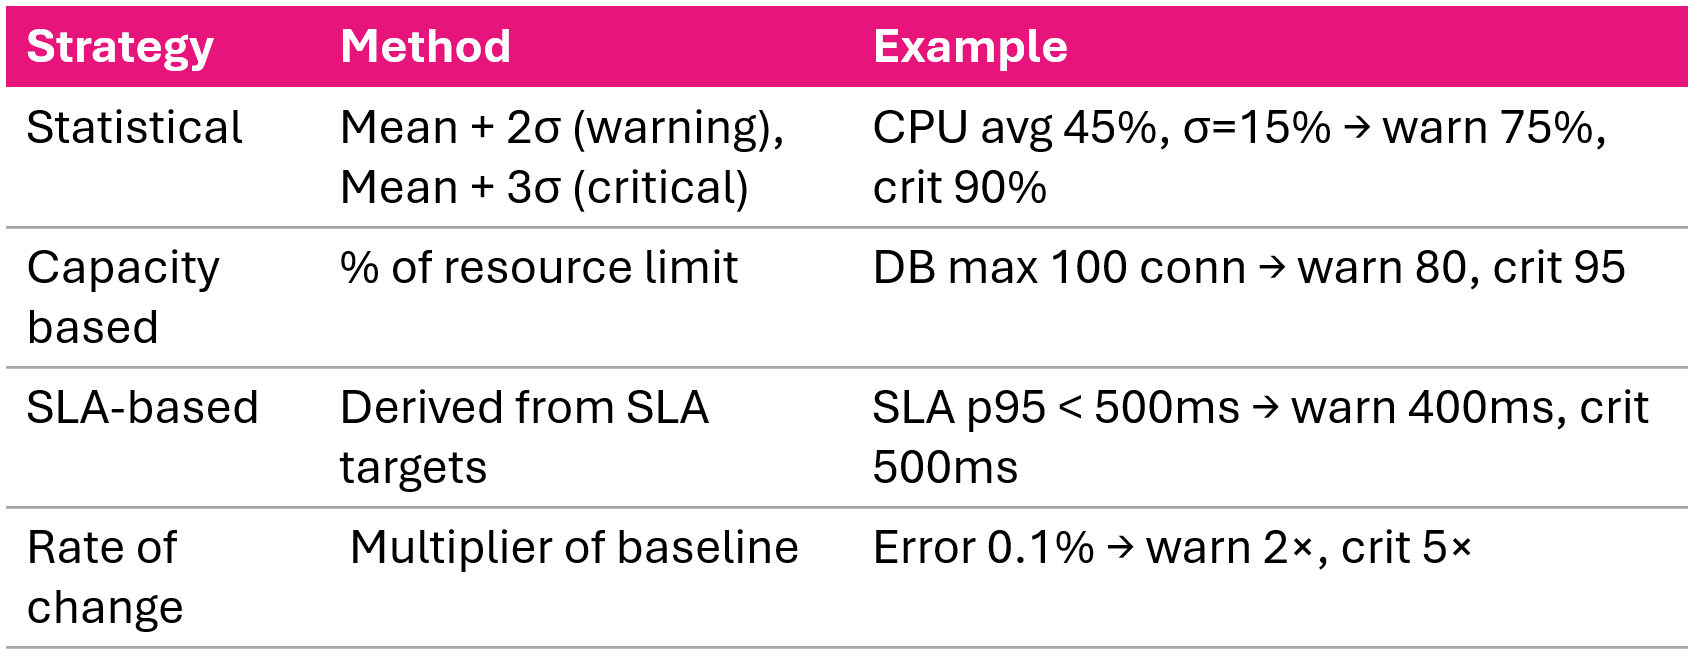
Bốn chiến lược chọn ngưỡng: lệch so với đường cơ sở, giới hạn năng lực, mục tiêu SLA và tốc độ thay đổi

Giám sát và Khắc phục sự cố trên AWS

Chiến lược cảnh báo nhiều tầng


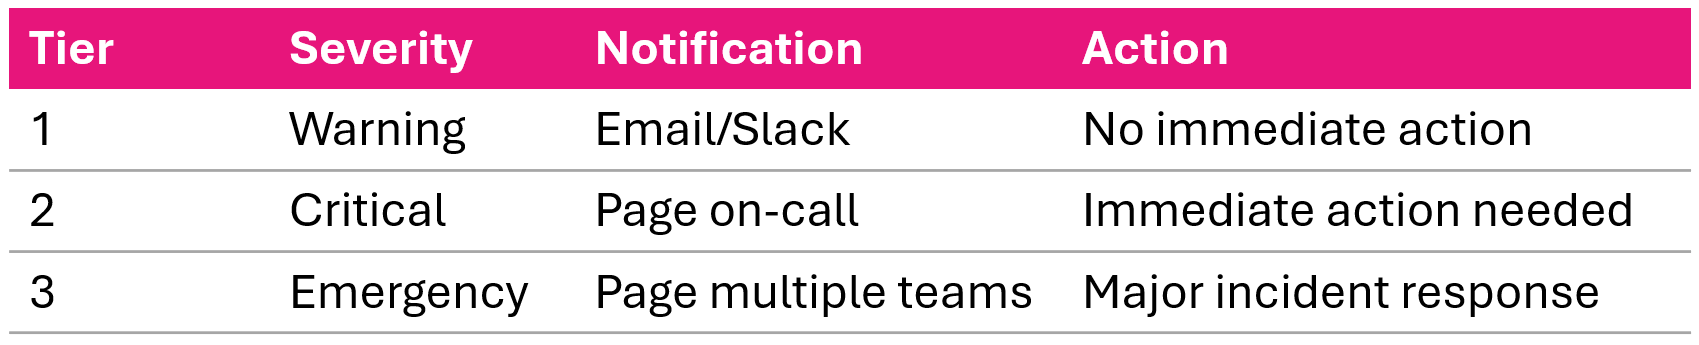
Phản ứng cảnh báo nhiều tầng với các mức warning, critical và emergency được định tuyến đến các chủ đề SNS riêng

Ví dụ: Cảnh báo CPU mức Warning tại 75%, Critical tại 90%, mỗi mức dùng SNS topic khác nhau

Giám sát và Khắc phục sự cố trên AWS

Cảnh báo phát hiện bất thường

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • Mô hình Machine Learning học hành vi bình thường của metric
  • Tạo dải ngưỡng động (có thể cấu hình)
  • Thích ứng với mẫu hằng ngày/hằng tuần
  • Giảm tinh chỉnh ngưỡng thủ công
Giám sát và Khắc phục sự cố trên AWS

Cảnh báo tài nguyên: Lambda và ALB

Cảnh báo Lambda
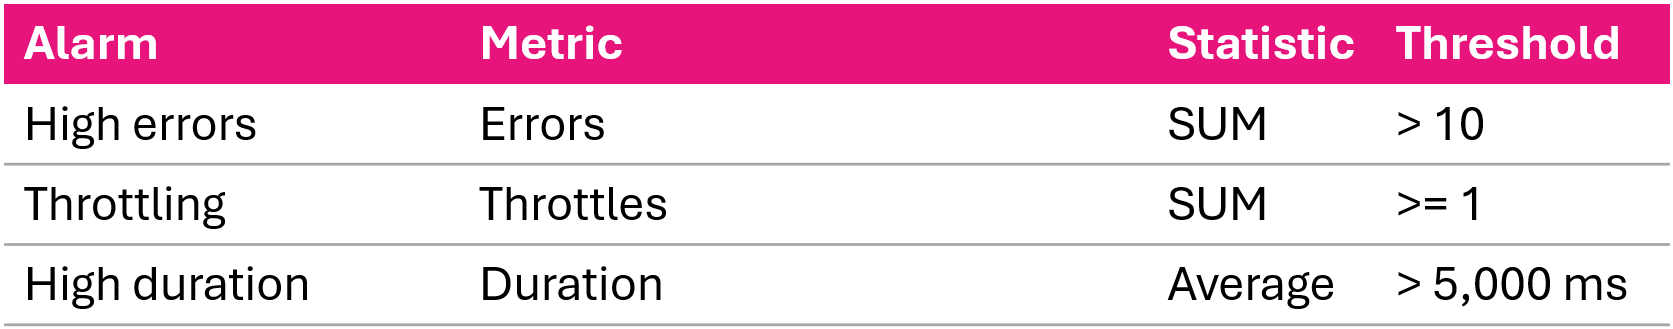
Cảnh báo Lambda khuyến nghị: theo dõi số lỗi, throttles và thời lượng cao gần giới hạn timeout

Cảnh báo ALB

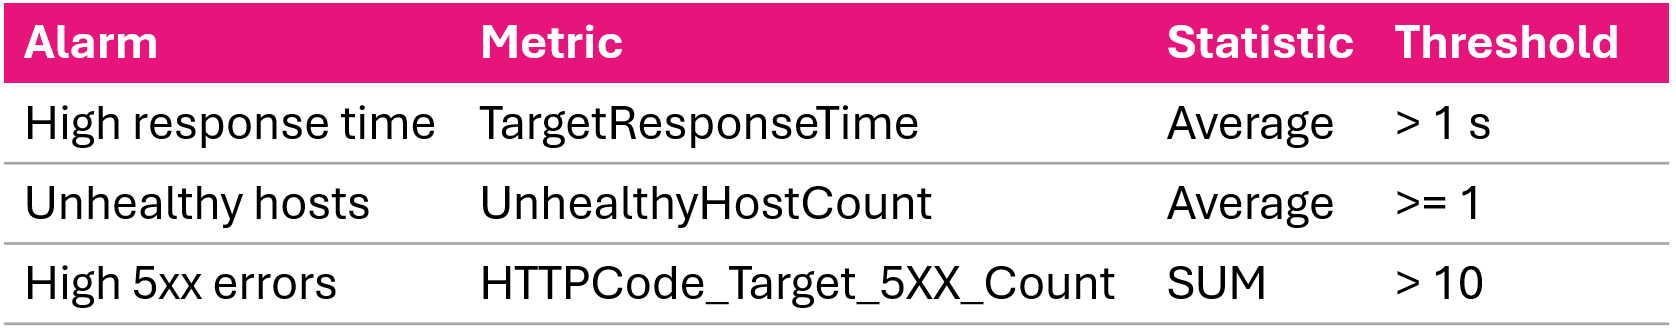
Cảnh báo ALB khuyến nghị: theo dõi thời gian phản hồi của target, host không khỏe và số lỗi 5xx

Giám sát và Khắc phục sự cố trên AWS

Thực hành khuyến nghị để quản lý cảnh báo

  • Quy tắc đặt tên: <Service>-<Metric>-<Resource>-<Severity>
  • Mô tả: theo dõi gì, ngưỡng, gợi ý xử lý sự cố, liên kết runbook
  • Thẻ: Environment, Team, Severity
  • Rà soát hàng tháng: chỉnh ngưỡng, bỏ cảnh báo lỗi thời, cập nhật hành động
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Giám sát và Khắc phục sự cố trên AWS

Tóm tắt video

  • Ba trạng thái cảnh báo: OK, ALARM, INSUFFICIENT_DATA
  • Chiến lược đánh giá: consecutive, partial, single breach
  • Cảnh báo tổng hợp kết hợp nhiều cảnh báo bằng AND, OR, NOT
  • Bốn chiến lược ngưỡng: thống kê, năng lực, SLA, tốc độ thay đổi
  • Cảnh báo nhiều tầng: warning → critical → emergency
  • Cảnh báo tài nguyên cho Lambda (errors, throttles, duration) và ALB (5xx, latency)
Giám sát và Khắc phục sự cố trên AWS

Cùng luyện tập nào!

Giám sát và Khắc phục sự cố trên AWS

Preparing Video For Download...