Uygulama sağlık panoları

AWS'i İzleme ve Sorun Giderme

John Q. Martin

Principal Consultant

Pano tasarımı: bilgi hiyerarşisi
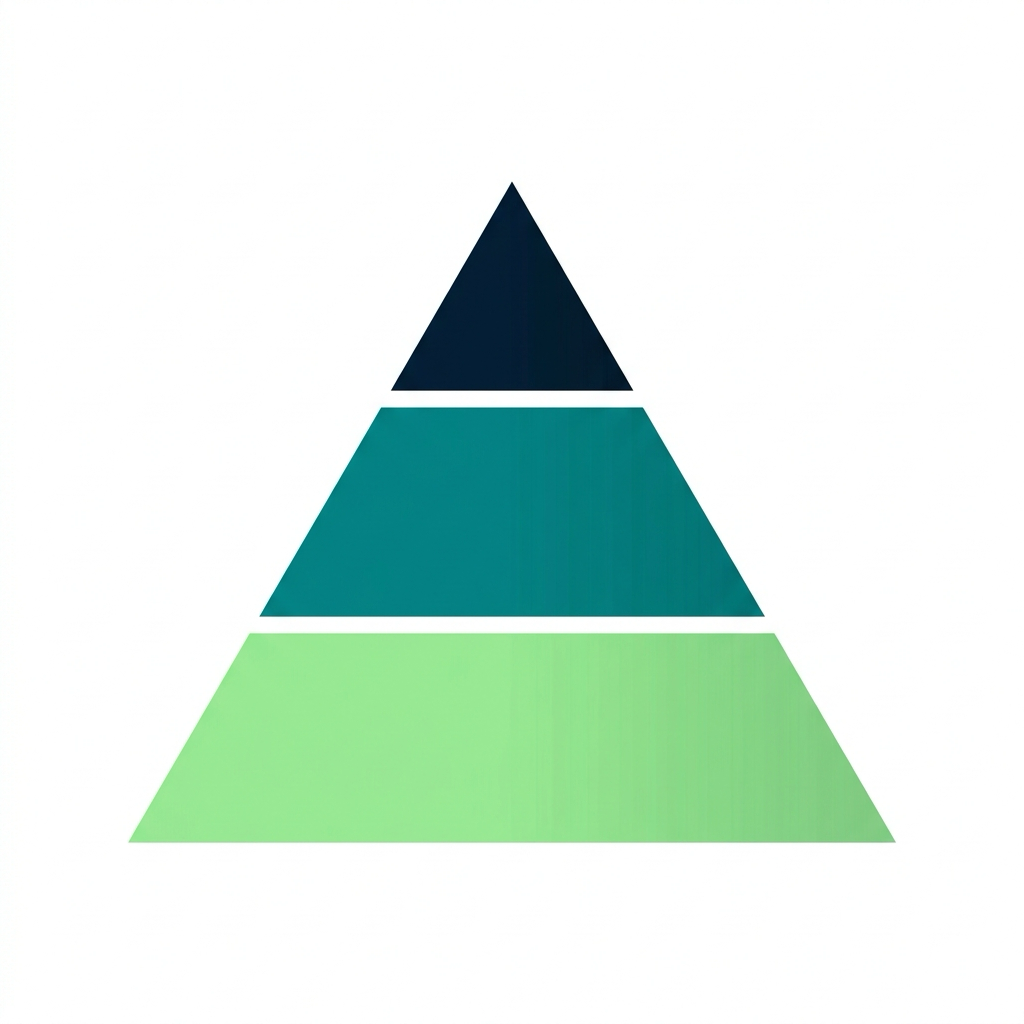
 

Üç katmanlı piramit: dar koyu üst katman, daha geniş camgöbeği orta katman ve en geniş yeşil alt katman

Hastane gibi: kayıt → servis → uzman


Üst - Yönetici Özeti

  • Genel sistem sağlığı
  • Temel iş metrikleri, SLA, güncel olaylar

Orta - Servis Sağlığı

  • Hata oranları, gecikme yüzdelikleri, throughput

Alt - Ayrıntılı Tanılama

  • İzler, günlükler, kaynak kullanımı, bağımlılık sağlığı
AWS'i İzleme ve Sorun Giderme

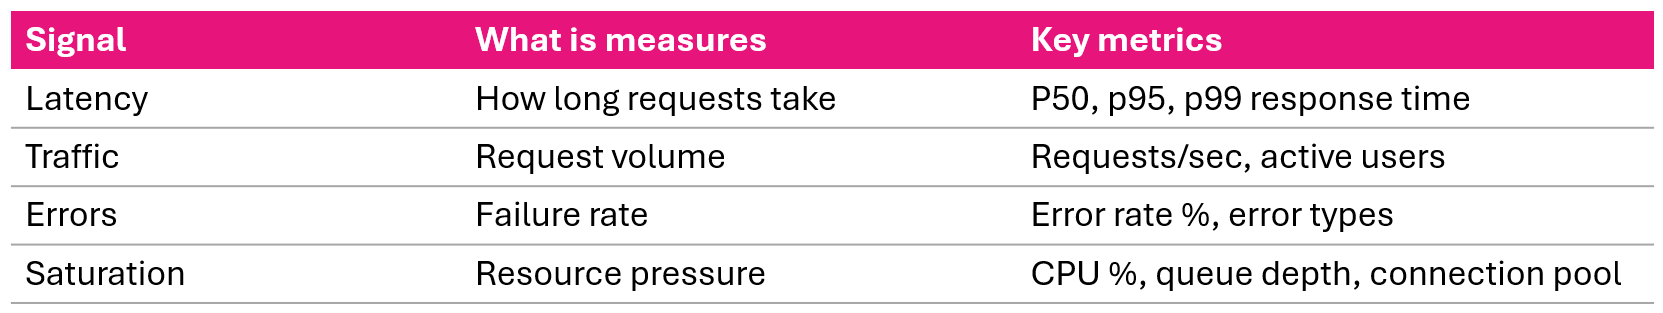
Dört altın sinyal


İzleme için dört altın sinyal: gecikme, trafik, hatalar ve doyum

Bu dördünü kapsarsan, karşılaşacağın sorunların büyük çoğunluğunu kapsarsın.

AWS'i İzleme ve Sorun Giderme

RED yöntemi


İstek odaklı servisler için RED:
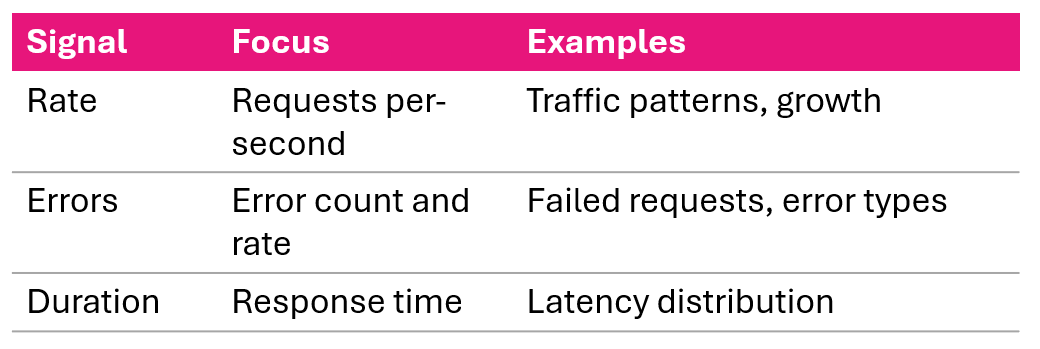
RED yöntemi deseni: istek odaklı servisler için rate errors ve duration


Altın sinyallerle ilişki:

  • RED, dört altın sinyalin odaklı bir alt kümesidir
  • Kullanıcı isteklerini işleyen servisler için tasarlanmıştır
  • Altyapı izlemesi için doyum (4. altın sinyal) eklenir

Başlangıç olarak RED'i kullan, daha derin tanı için doyumu ekle.

AWS'i İzleme ve Sorun Giderme

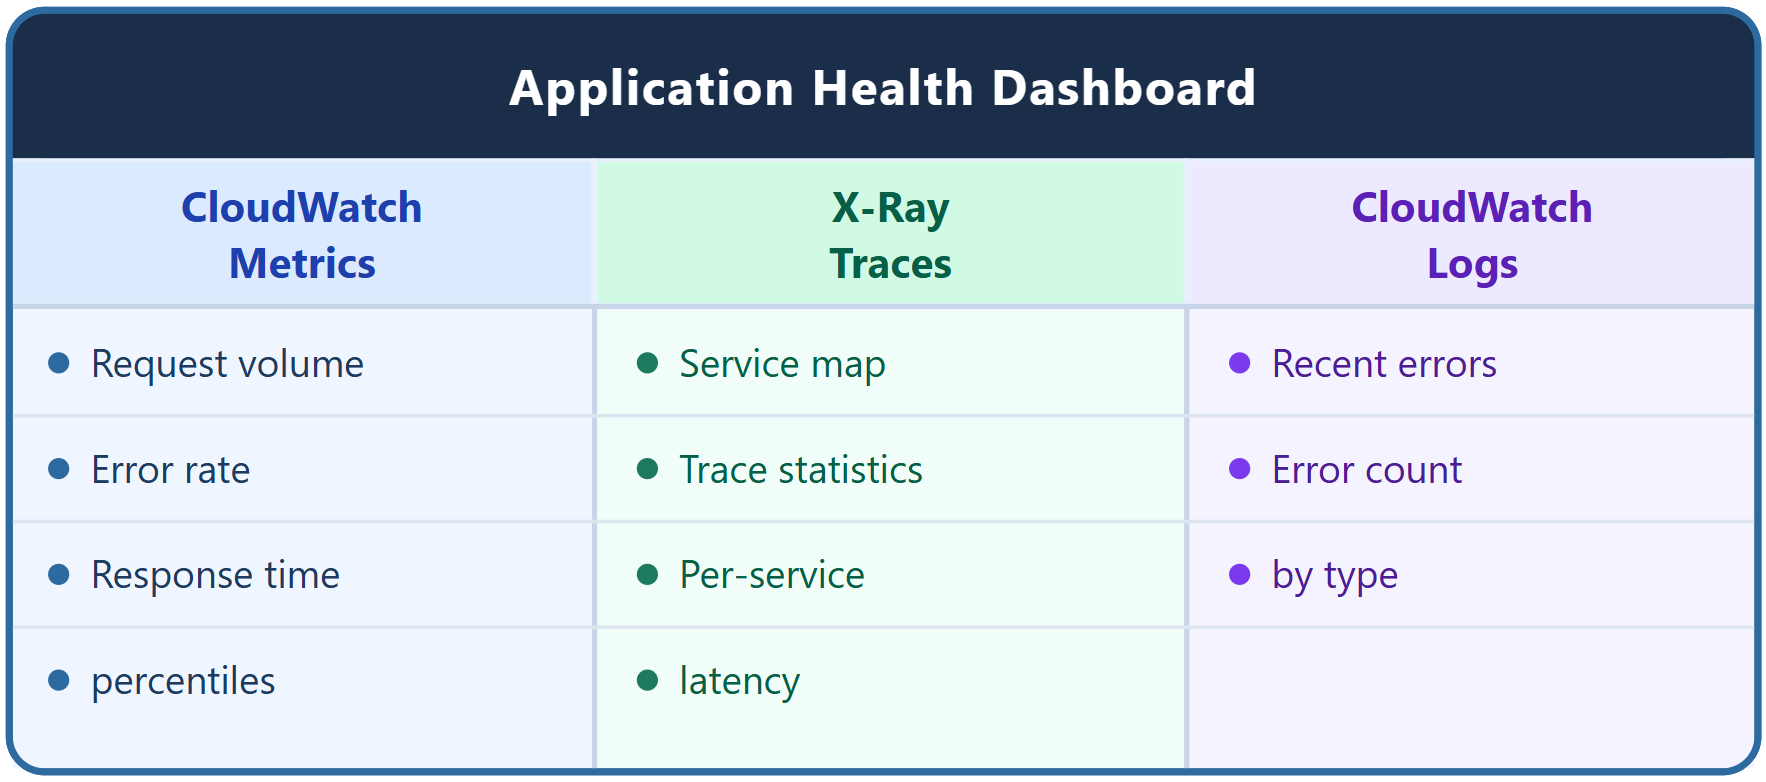
Üç veri kaynağı


Üç pano veri kaynağı diyagramı: CloudWatch metrikleri, X-Ray izleri ve CloudWatch Logs

AWS'i İzleme ve Sorun Giderme

CloudWatch metrik widget'ları

İstek hacmi:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

Hata oranı (metric math):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

Yanıt süresi yüzdelikleri:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • ALB RequestCount ile istek hacmi
  • Hata oranı metric math kullanır - errors / invocations x 100
  • Yanıt süresi p50, p95, p99 yüzdelikleri
AWS'i İzleme ve Sorun Giderme

X-Ray ve günlük widget'ları


X-Ray widget'ları:

  • Service map - sağlık göstergeleriyle uygulama topolojisi
  • Trace statistics - ortalama yanıt süresi, hata oranı, arıza oranı
  • Service latency - servis bazında yanıt süresi karşılaştırması


CloudWatch Logs widget'ları:

Son hatalar sorgusu:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

Türe göre hata sayısı:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
AWS'i İzleme ve Sorun Giderme

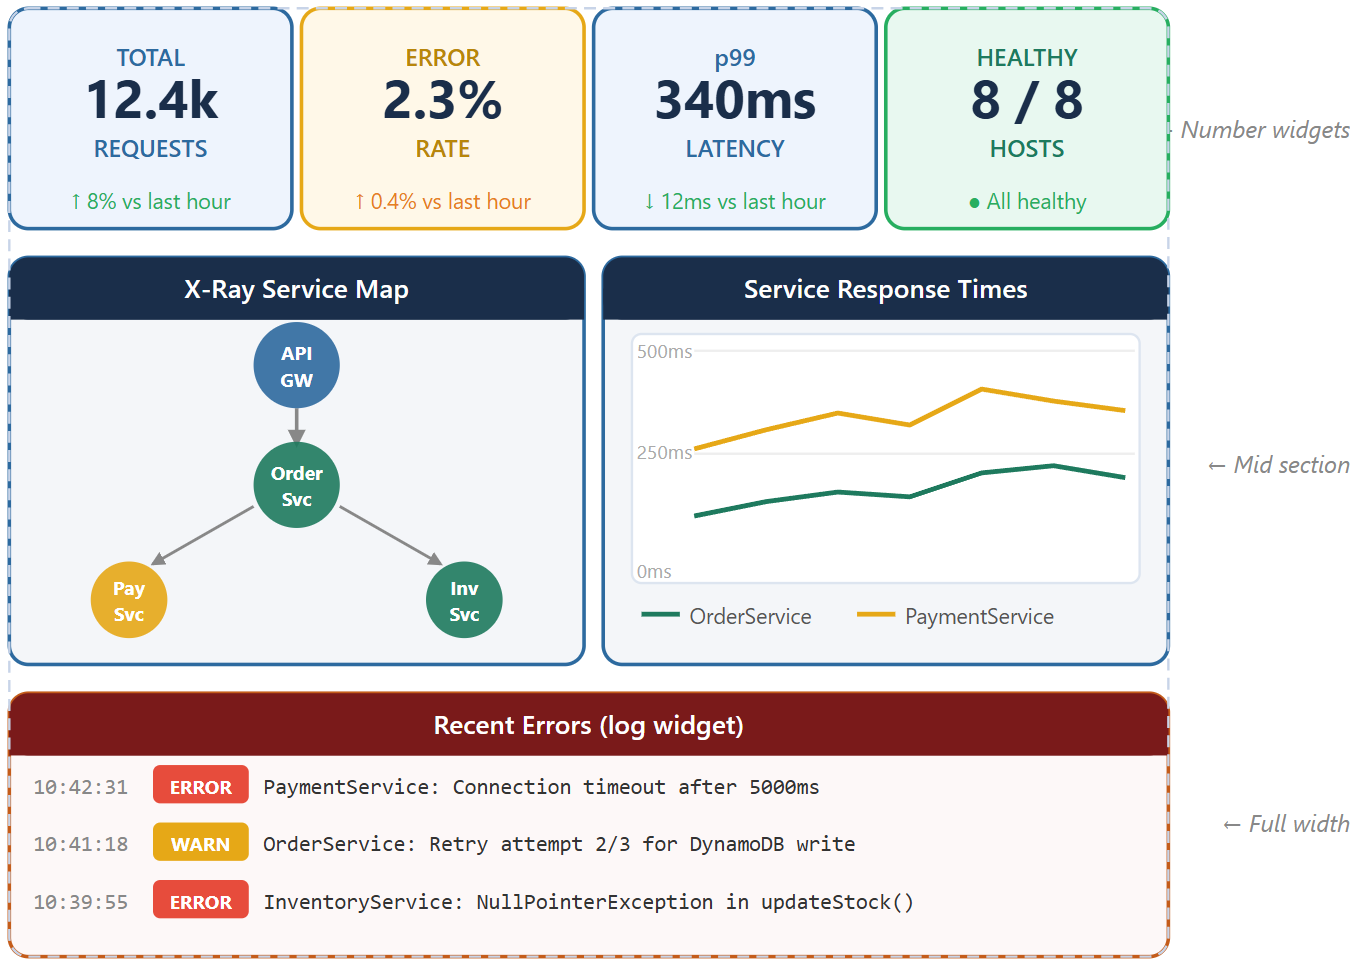
Tam pano düzeni


Sağlık panosu düzeni: üstte özet widget'lar, ortada servis haritası ve altta hata günlükleri

AWS'i İzleme ve Sorun Giderme

Olay sorun giderme iş akışı


Acil servis triyajı klipsi: renkli öncelik şeritleri ve stetoskop

Acil triyaj gibi: stabilize et → teşhis et → tedavi et → doğrula

  1. Belirle - kırmızı/sarı göstergeler, hata sıçramaları
  2. Kapsamı tanımla - hangi servisler? ne zaman? kötüleşiyor mu?
  3. İlişkilendir - hatalar + gecikme, trafik + kaynaklar
  4. Derine in - servis haritası → izler → günlükler
  5. Kök neden - bağımlılık, DB, bellek, yapılandırma
  6. Düzelt - devre kesici, ölçeklendir, geri al, failover
  7. Doğrula - hata oranı normal, harita yeşil, alarmlar temiz
AWS'i İzleme ve Sorun Giderme

Senaryo 1: ani trafik artışı

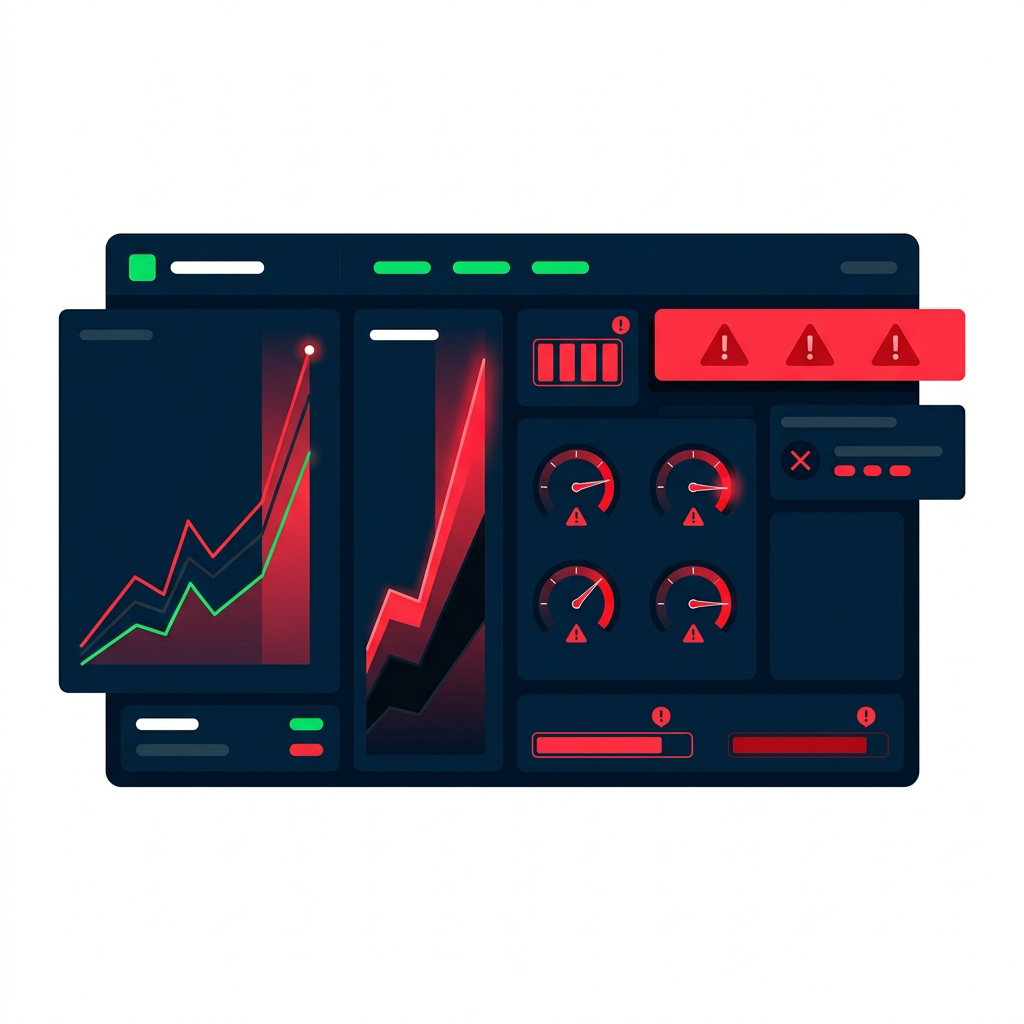
Trafik sıçraması sırasında izleme panosu: yukarı fırlayan çizgi grafikler, kırmızı bölgede sabitlenmiş göstergeler, kırmızı uyarı bantları

Panoda gördüklerin:

  • İstek hacmi normalin 10×'i
  • Hata oranı %25
  • Gecikme 3000ms
  • CPU %95

Analiz: Trafik dalgası kaynakları bunaltmış


Eylemler:

  • Hemen yatay ölçeklendir
  • Otomatik ölçeklendirmeyi etkinleştir
  • Oran sınırlama uygula
  • Arka ucu rahatlatmak için önbellekleme ekle
AWS'i İzleme ve Sorun Giderme

Senaryo 2: veritabanı darboğazı

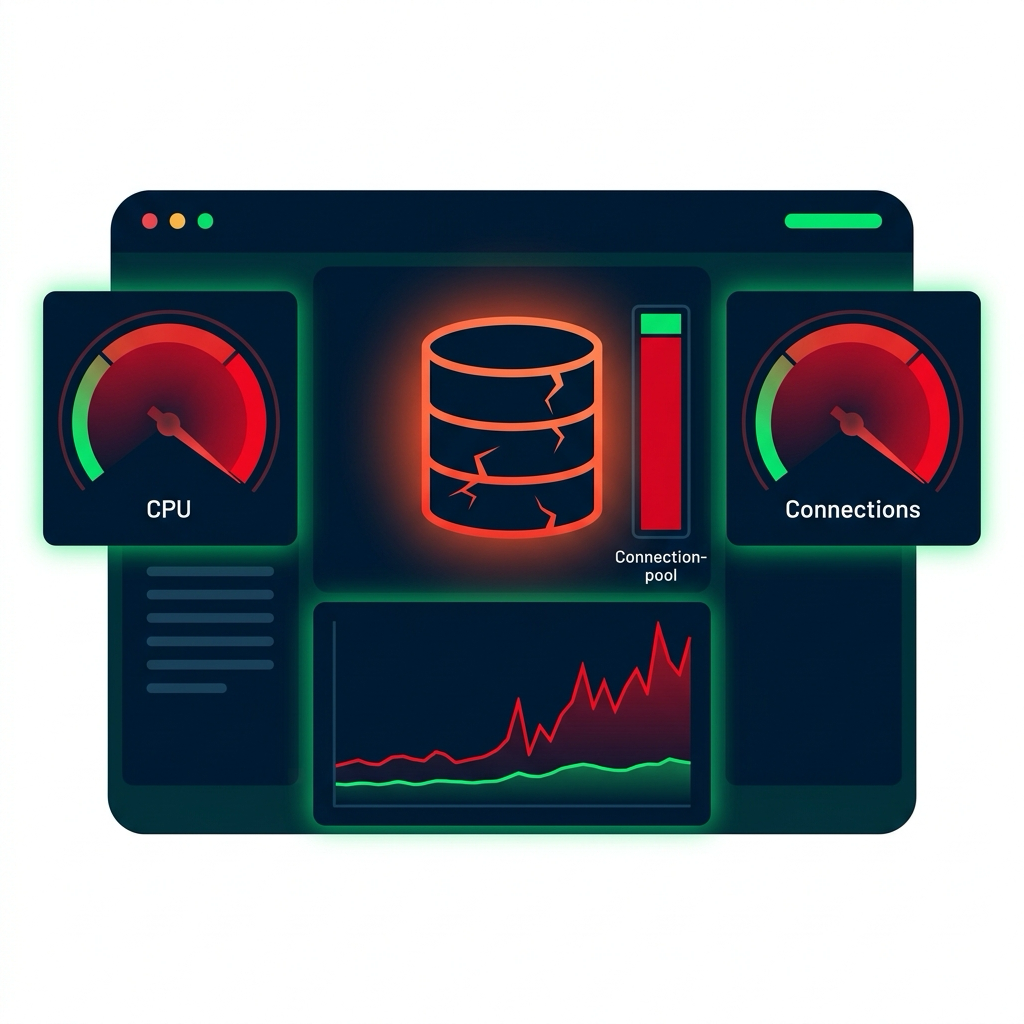
Veritabanı darboğazını gösteren izleme panosu: çatlamış kırmızı DB simgesi, CPU ve bağlantı göstergeleri kırmızıda, hızla tırmanan sorgu gecikmesi grafiği, neredeyse dolu bağlantı havuzu çubuğu

Panoda gördüklerin:

  • DB CPU %95
  • DB bağlantıları 95/100
  • Sorgu gecikmesi 5000ms
  • Uygulama gecikmesi 5500ms

Analiz: Darboğaz veritabanı; yavaş sorgular bağlantı havuzunu tüketiyor


Eylemler:

  • Günlüklerde yavaş sorguları bul
  • Dizin ekle, sorguları iyileştir
  • Bağlantı havuzu boyutunu artır
  • Veritabanını ölçeklendir
AWS'i İzleme ve Sorun Giderme

Senaryo 3: zincirleme arıza


Servis haritasında gördüklerin:
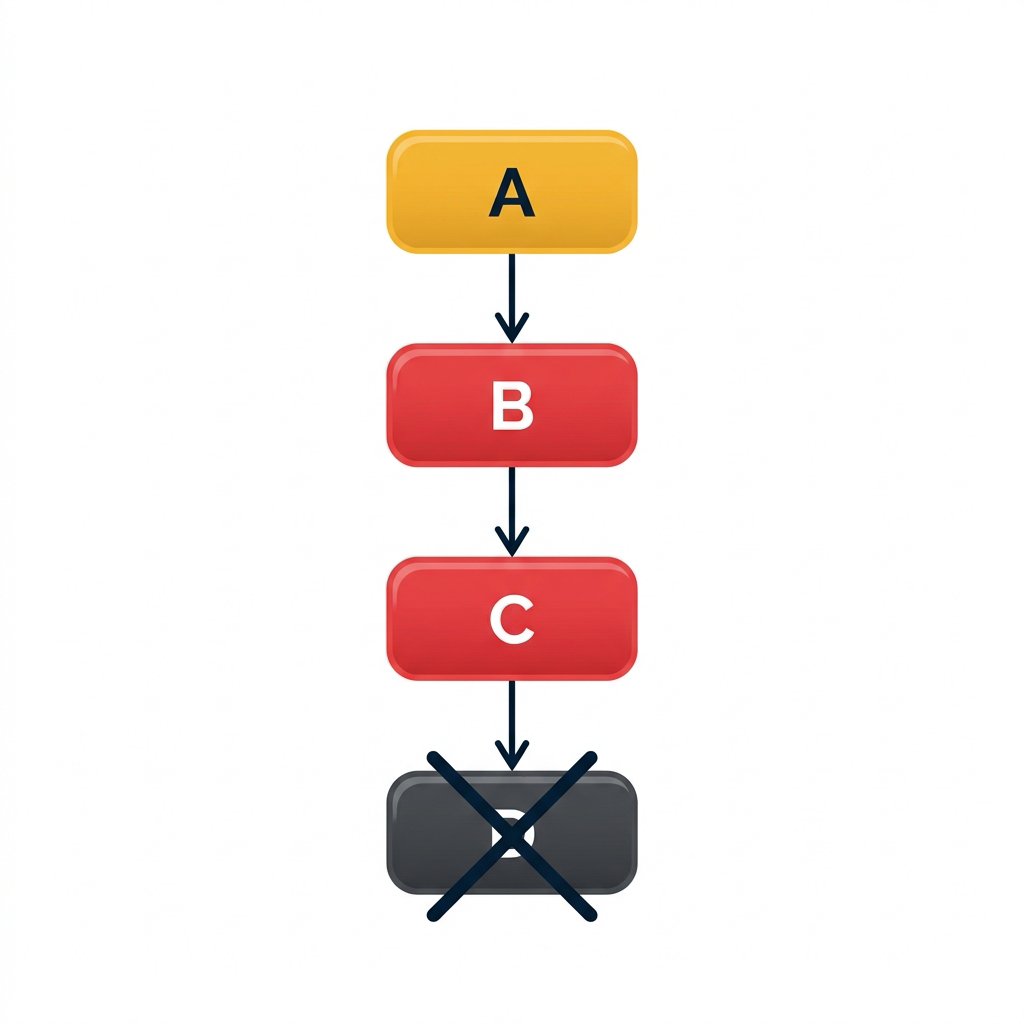
Servis haritası zincirleme: A düğümü kehribar rengi müşteri hatalarıyla, B ve C kırmızı sunucu arızalarıyla, D koyu ve tamamen kapalı, oklar zincir boyunca aşağı akıyor


Analiz:

Servis A'daki küçük bir sorun bağımlılık zincirinde yayıldı

Eylemler:

  • Zincirlemeyi durdurmak için devre kesiciler
  • Her servis katmanında zaman aşımları
  • Başarısız bağımlılıklar için geri dönüş mekanizmaları
  • Kök nedeni Servis A'da düzelt
AWS'i İzleme ve Sorun Giderme

Pano en iyi uygulamaları


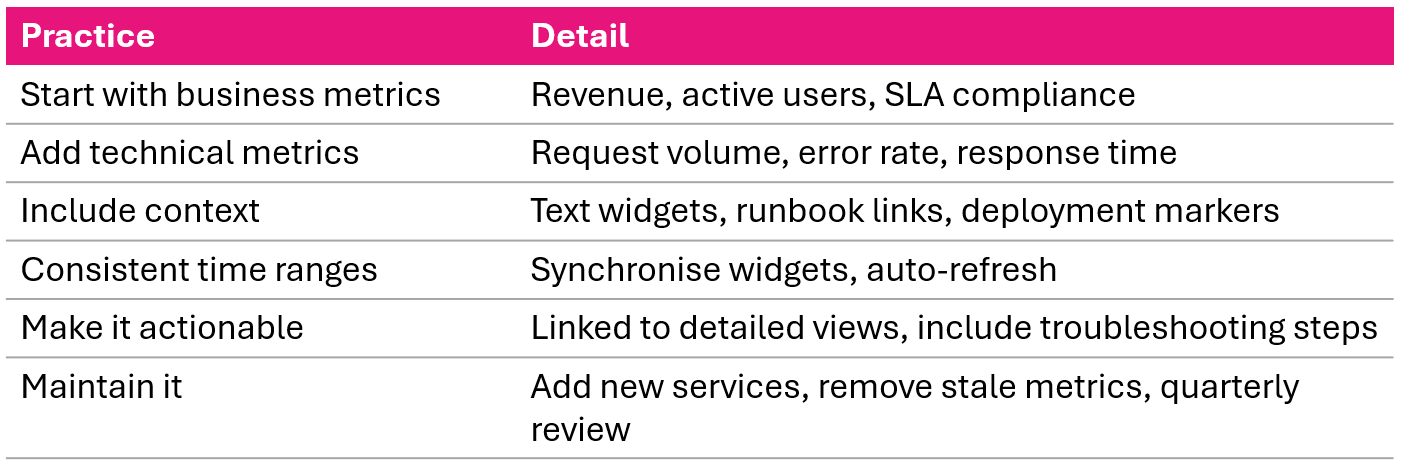
Uygulama sağlığı izlemesi için altı önerilen pano en iyi uygulaması

AWS'i İzleme ve Sorun Giderme

Video özeti ve kurs tamamlandı

  • Bilgi hiyerarşisi ve dört altın sinyalle tasarla
  • CloudWatch metrikleri, X-Ray izleri ve günlükleri tek görünümde birleştir
  • Yedi adımlı olay akışı: belirle → kapsamla → ilişkilendir → derine in → kök neden → düzelt → doğrula

Artık şunları yapabilirsin:

  • CloudWatch metrikleri, günlükler ve panolarla izleme
  • SNS ve SQS ile alarmlar ve bildirimler yapılandırma
  • X-Ray ile dağıtık izleme uygulama
  • Operasyonel mükemmellik için uygulama sağlık panoları oluşturma
AWS'i İzleme ve Sorun Giderme

Uygulama sağlık panoları

AWS'i İzleme ve Sorun Giderme

Preparing Video For Download...