Dashboardy pro zdraví aplikace

Monitoring and Troubleshooting AWS

John Q. Martin

Principal Consultant

Návrh dashboardu: hierarchie informací
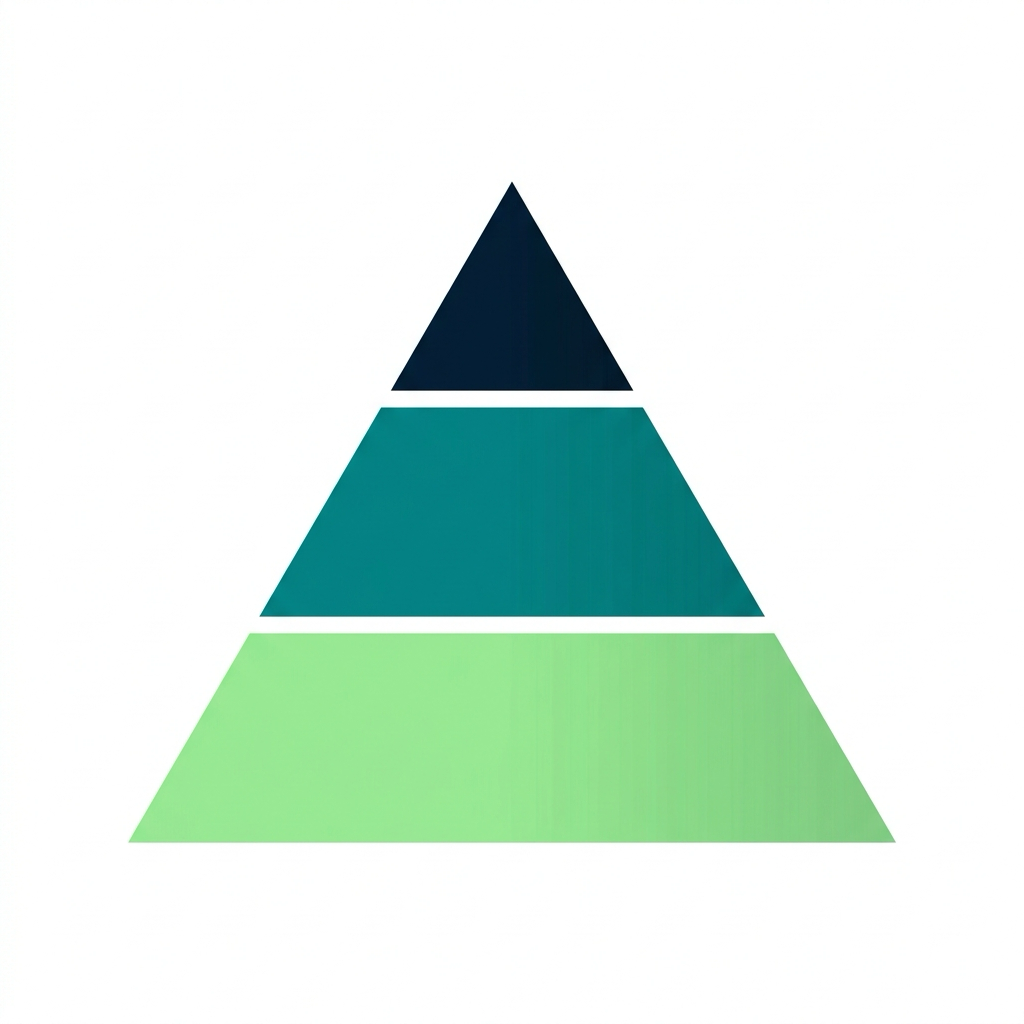
 

Tříúrovňová pyramida: úzká tmavá horní vrstva, širší tyrkysová střední vrstva a nejširší zelená spodní vrstva

Jako v nemocnici: recepce → oddělení → specialista


Nahoře – přehled pro management

  • Celkový stav systému
  • Klíčové obchodní metriky, SLA, aktuální incidenty

Uprostřed – stav služeb

  • Chybovost, percentily latence, propustnost

Dole – podrobná diagnostika

  • Traces, logy, využití prostředků, závislosti
Monitoring and Troubleshooting AWS

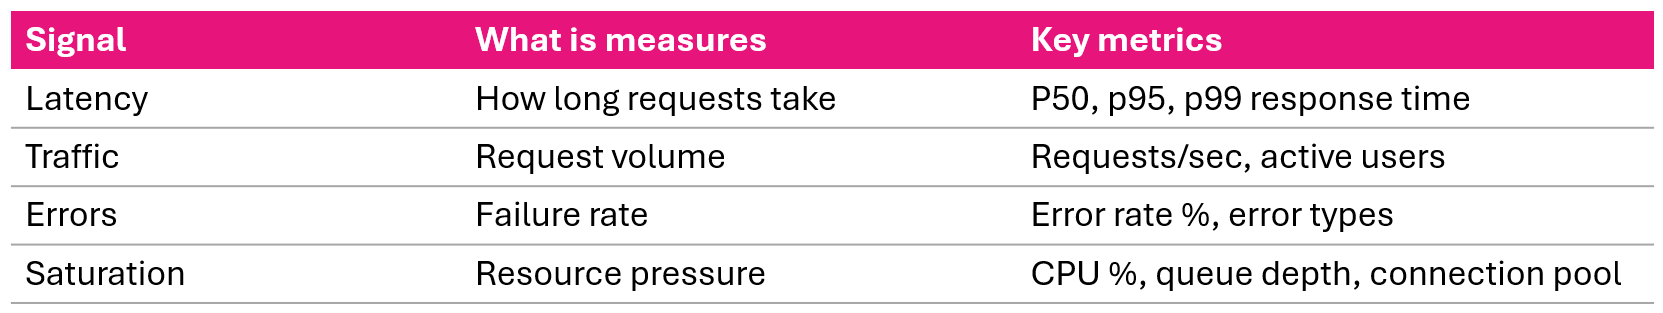
Čtyři zlaté signály


Čtyři zlaté signály monitorování: latence, provoz, chyby a saturace

Tyto čtyři signály pokrývají naprostou většinu problémů, na které narazíš.

Monitoring and Troubleshooting AWS

Metoda RED


RED pro služby zpracovávající požadavky:
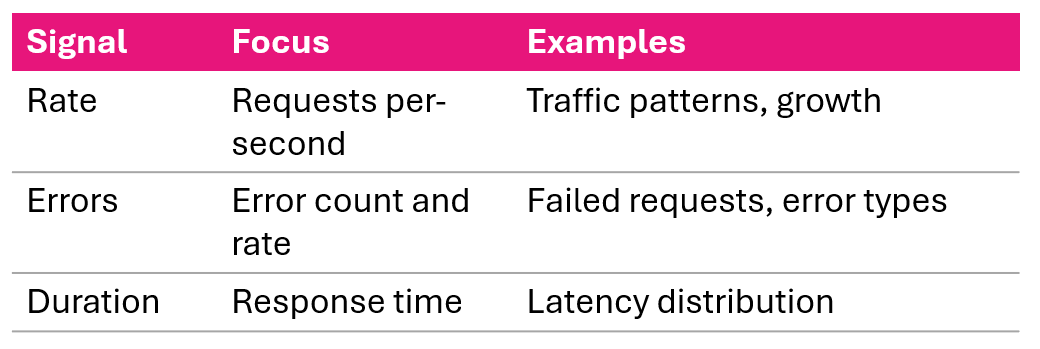
Vzor metody RED zobrazující rate, errors a duration pro služby zpracovávající požadavky


Vztah ke zlatým signálům:

  • RED je zaměřená podmnožina čtyř zlatých signálů
  • Navržena pro služby, které zpracovávají uživatelské požadavky
  • Saturace (4. zlatý signál) doplňuje infrastrukturní monitoring

Začni s RED a pro hlubší diagnostiku přidej saturaci.

Monitoring and Troubleshooting AWS

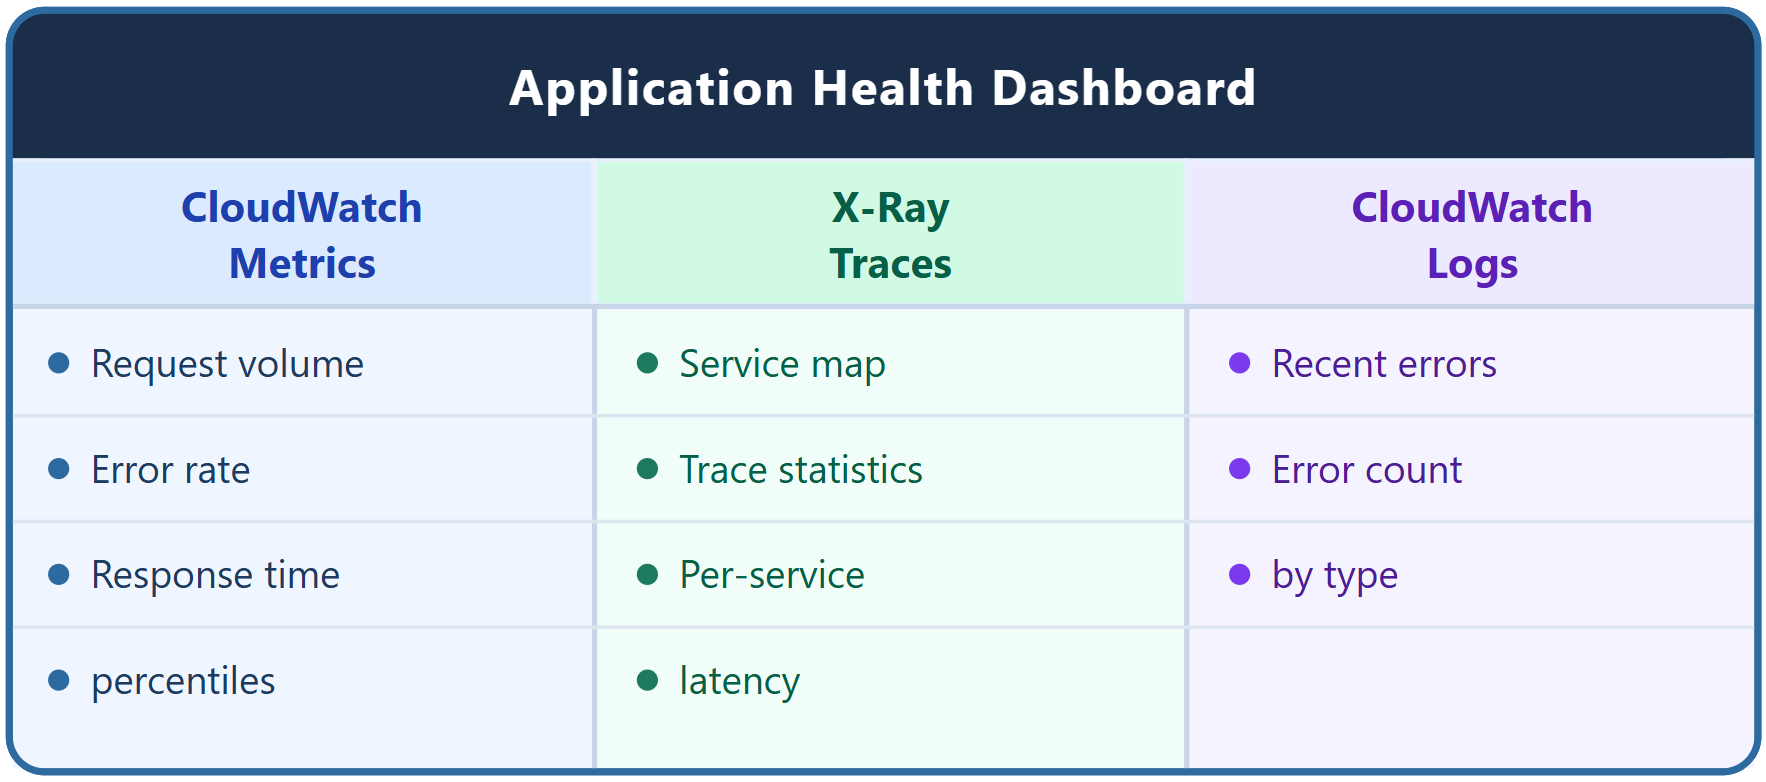
Tři zdroje dat


Diagram tří zdrojů dat dashboardu: CloudWatch metriky, X-Ray traces a CloudWatch Logs

Monitoring and Troubleshooting AWS

Widgety CloudWatch metrik

Objem požadavků:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

Chybovost (metric math):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

Percentily doby odezvy:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • Objem požadavků z ALB RequestCount
  • Chybovost využívá metric math – errors / invocations × 100
  • Doba odezvy jako percentily p50, p95, p99
Monitoring and Troubleshooting AWS

Widgety X-Ray a logů


Widgety X-Ray:

  • Mapa služeb – topologie aplikace s indikátory stavu
  • Statistiky traces – průměrná doba odezvy, chybovost, fault rate
  • Latence služeb – porovnání doby odezvy jednotlivých služeb


Widgety CloudWatch Logs:

Dotaz na poslední chyby:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

Počet chyb podle typu:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
Monitoring and Troubleshooting AWS

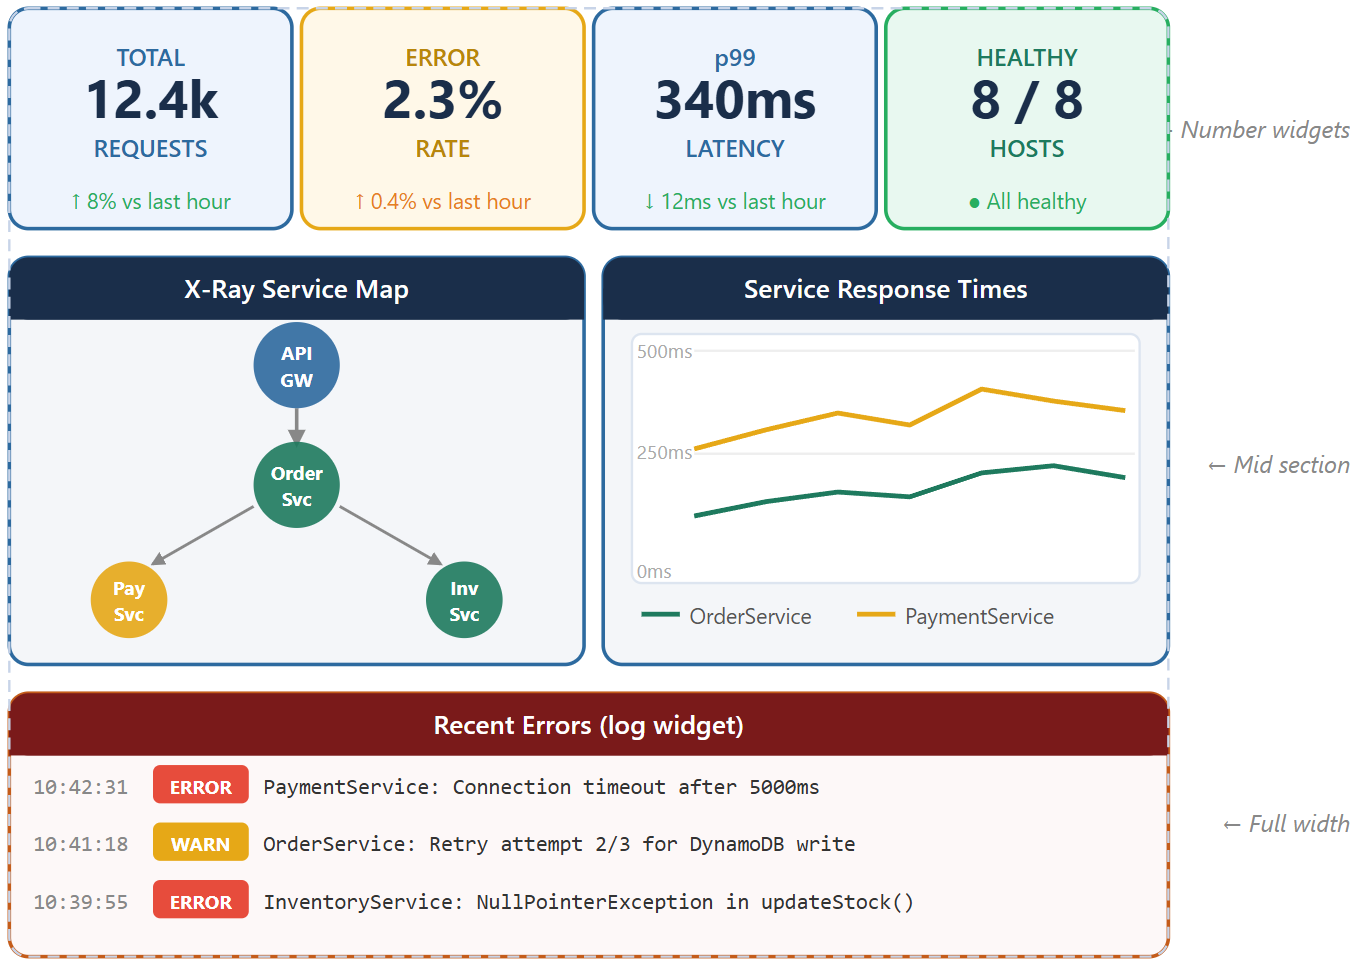
Kompletní rozložení dashboardu


Rozložení health dashboardu: souhrnné widgety nahoře, mapa služeb uprostřed a logy chyb dole

Monitoring and Troubleshooting AWS

Postup při řešení incidentu


Třídící formulář z urgentního příjmu s barevnými prioritními pruhy a stetoskopem

Jako triage na urgenci: stabilizuj → diagnostikuj → léč → ověř

  1. Identifikuj – červené/žluté indikátory, špičky chyb
  2. Rozsah – které služby? kdy? zhoršuje se to?
  3. Koreluj – chyby + latence, provoz + zdroje
  4. Zanoř se – mapa služeb → traces → logy
  5. Příčina – závislost, DB, paměť, konfigurace
  6. Oprav – circuit breaker, škálování, rollback, failover
  7. Ověř – chybovost normální, mapa zelená, alarmy smazány
Monitoring and Troubleshooting AWS

Scénář 1: náhlý nárůst provozu

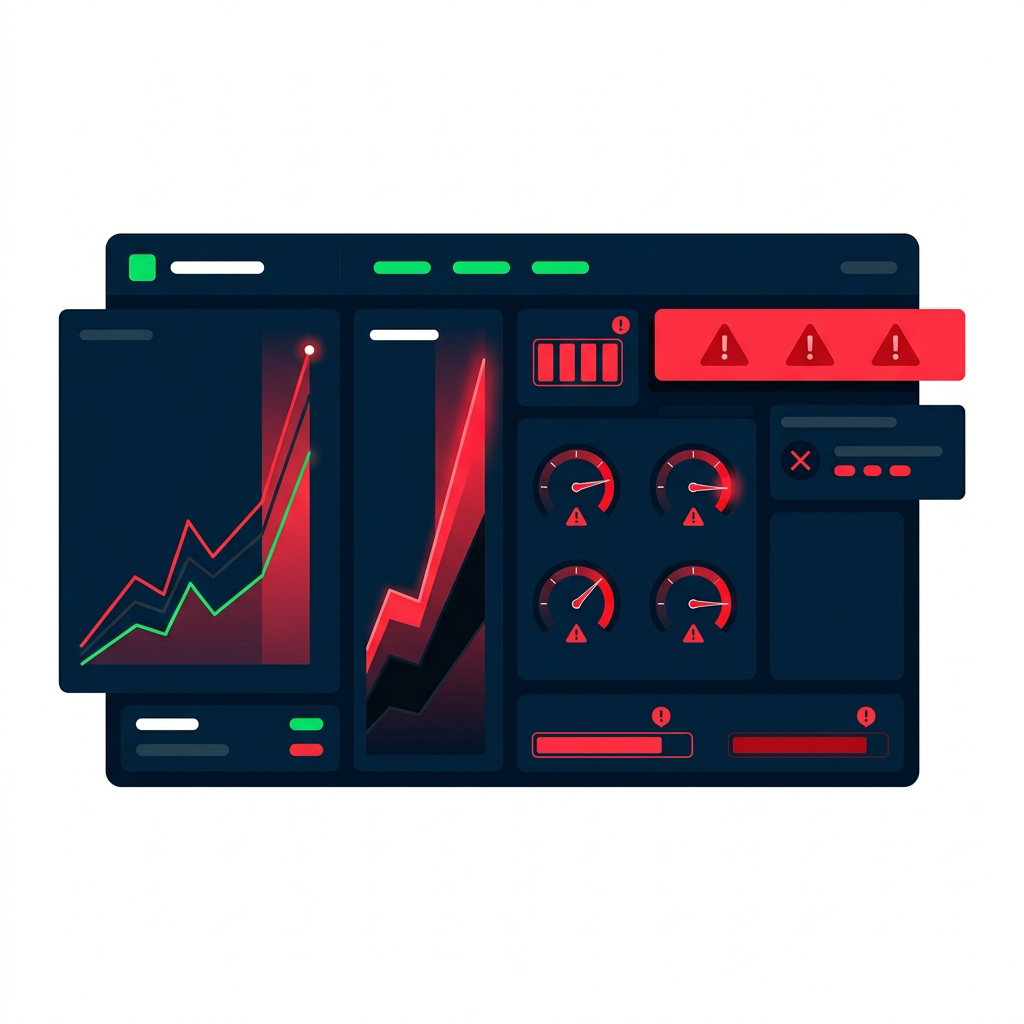
Monitorovací dashboard během nárazového nárůstu provozu: čárové grafy prudce stoupají, ručičky přístrojů v červené zóně, červené alarmové bannery

Co vidíš na dashboardu:

  • Objem požadavků 10× normál
  • Chybovost 25 %
  • Latence 3 000 ms
  • CPU 95 %

Analýza: Zdroje přetíženy nárazovým nárůstem provozu


Akce:

  • Okamžitě horizontálně škáluj
  • Zapni auto-scaling
  • Zaveď rate limiting
  • Přidej caching pro snížení zátěže backendu
Monitoring and Troubleshooting AWS

Scénář 2: databázové úzké místo

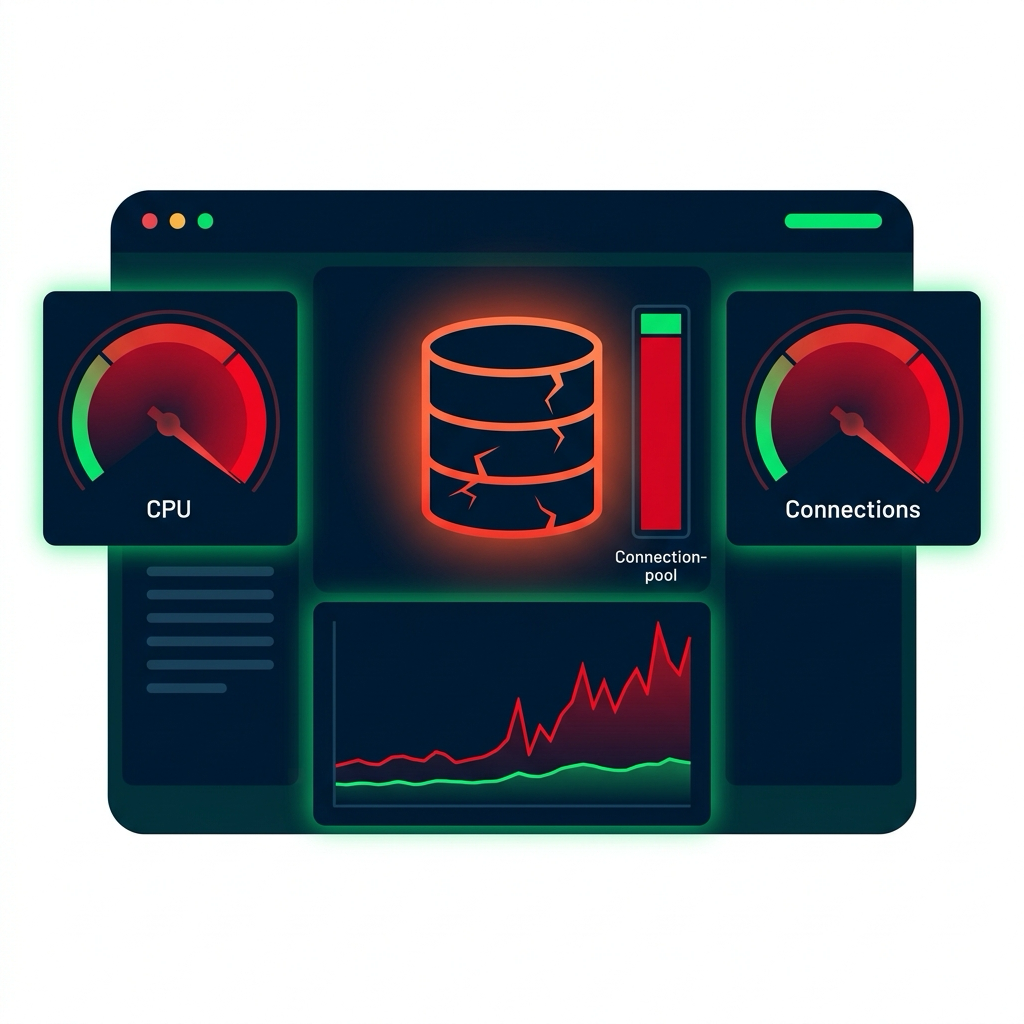
Monitorovací dashboard zobrazující databázové úzké místo: prasklá červená ikona databáze, ukazatele CPU a připojení v červené, strmě rostoucí graf latence dotazů, connection pool téměř plný

Co vidíš na dashboardu:

  • CPU databáze 95 %
  • Připojení DB 95/100
  • Latence dotazů 5 000 ms
  • Latence aplikace 5 500 ms

Analýza: Databáze je úzké místo – pomalé dotazy vyčerpávají connection pool


Akce:

  • Identifikuj pomalé dotazy v lozích
  • Přidej indexy, optimalizuj dotazy
  • Zvětši connection pool
  • Škáluj databázi
Monitoring and Troubleshooting AWS

Scénář 3: kaskádové selhání


Co vidíš na mapě služeb:
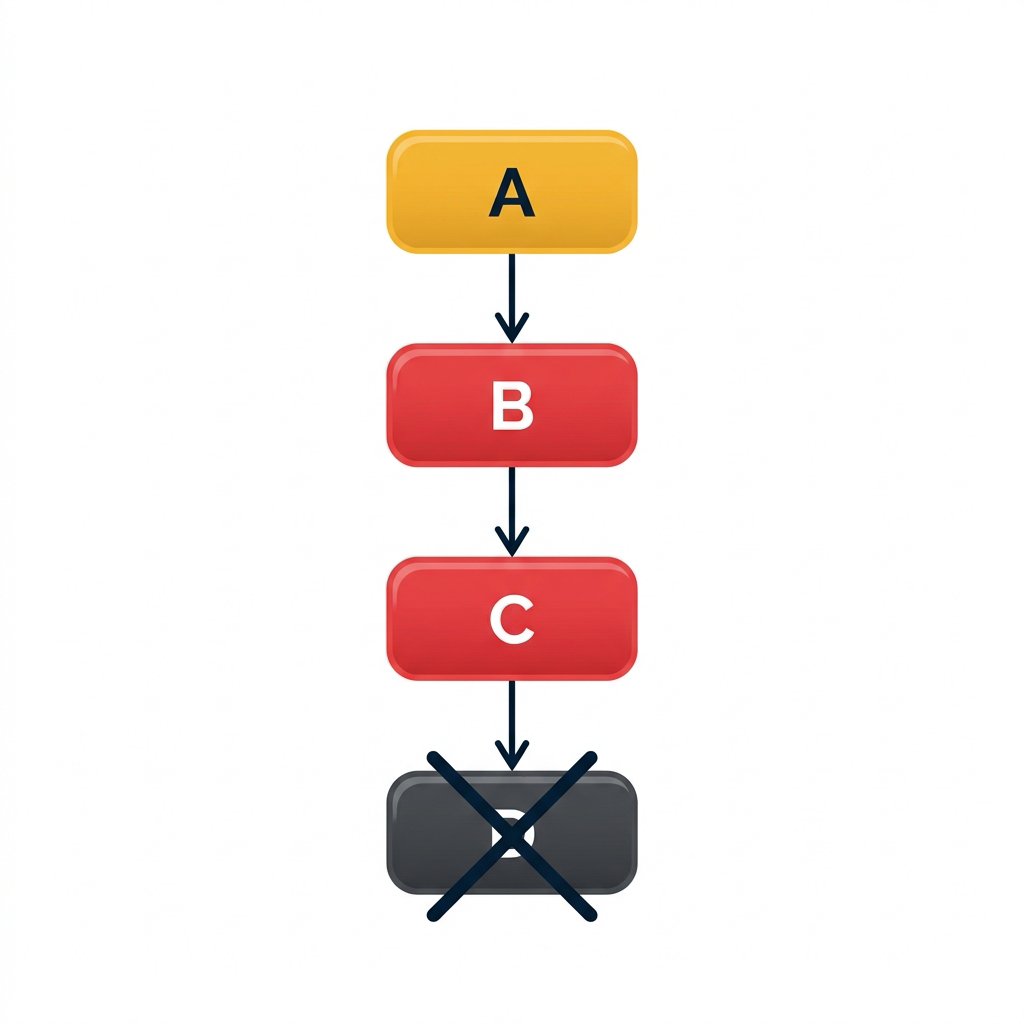
Kaskáda na mapě služeb: uzel A oranžový s chybami klienta, B a C červené s chybami serveru, D tmavý a zcela nedostupný, šipky sledují řetězec závislostí


Analýza:

Malý problém ve službě A se rozšířil celým řetězcem závislostí

Akce:

  • Circuit breakery k zastavení kaskády
  • Timeouty na každé úrovni služby
  • Fallback mechanismy pro selhané závislosti
  • Oprav příčinu ve službě A
Monitoring and Troubleshooting AWS

Doporučené postupy pro dashboardy


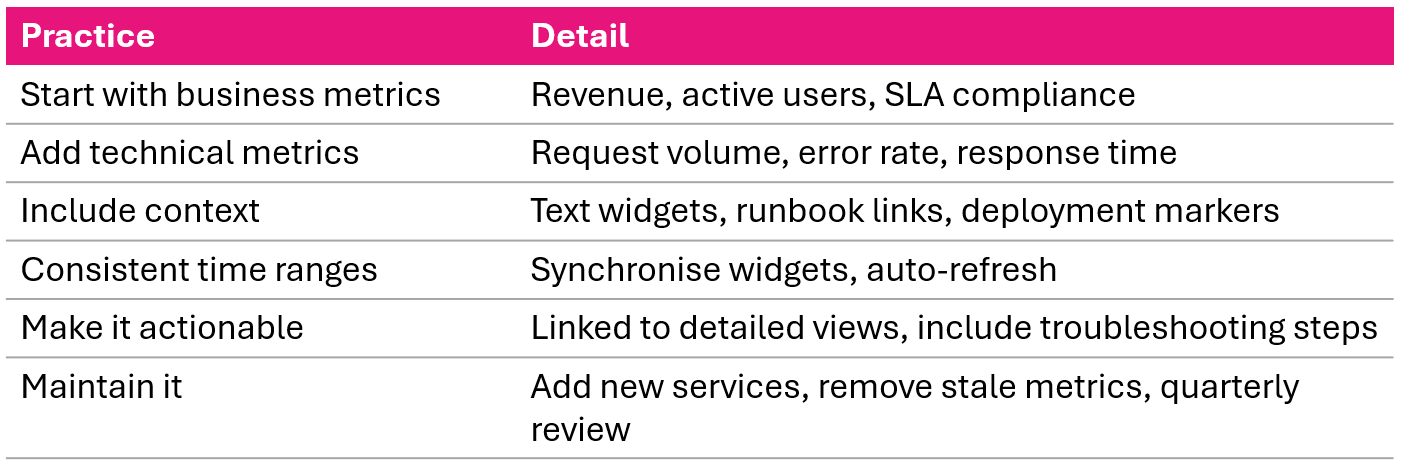
Šest doporučených postupů pro dashboardy monitorování zdraví aplikace

Monitoring and Troubleshooting AWS

Shrnutí videa a dokončení kurzu

  • Navrhuj pomocí hierarchie informací a čtyř zlatých signálů
  • Kombinuj CloudWatch metriky, X-Ray traces a logy v jednom pohledu
  • Sedmikrokový postup při incidentu: identifikuj → rozsah → koreluj → zanoř se → příčina → oprav → ověř

Teď umíš:

  • Monitorovat pomocí CloudWatch metrik, logů a dashboardů
  • Konfigurovat alarmy a notifikace přes SNS a SQS
  • Implementovat distribuované trasování s X-Ray
  • Sestavit dashboardy zdraví aplikace pro provozní excelenci
Monitoring and Troubleshooting AWS

Dashboardy pro zdraví aplikace

Monitoring and Troubleshooting AWS

Preparing Video For Download...