Analýza tras a map služeb

Monitoring and Troubleshooting AWS

John Q. Martin

Principal Consultant

Co je mapa služeb?


Automaticky generovaná z dat tras: žádné ruční nastavení
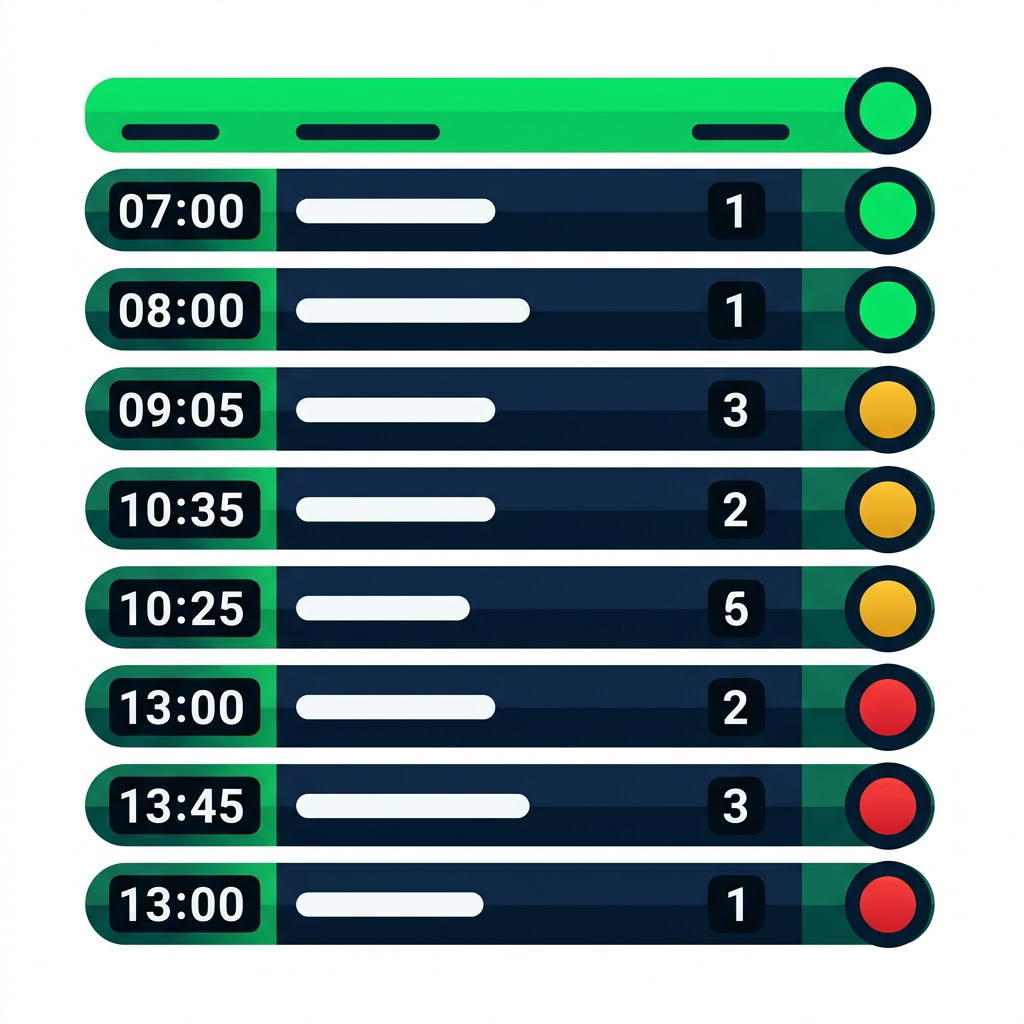
Odjezdová tabule vlaku s řádky služeb, každá s barevným stavovým světlem: zelená pro včas, oranžová pro zpoždění, červená pro zastaveno

Na první pohled: zelená = v pořádku · oranžová = zpoždění · červená = zastaveno


Přístup:

  • Konzola X-Ray → Service map
  • Použij filtry
  • Klikni na uzel → podrobný přehled
Monitoring and Troubleshooting AWS

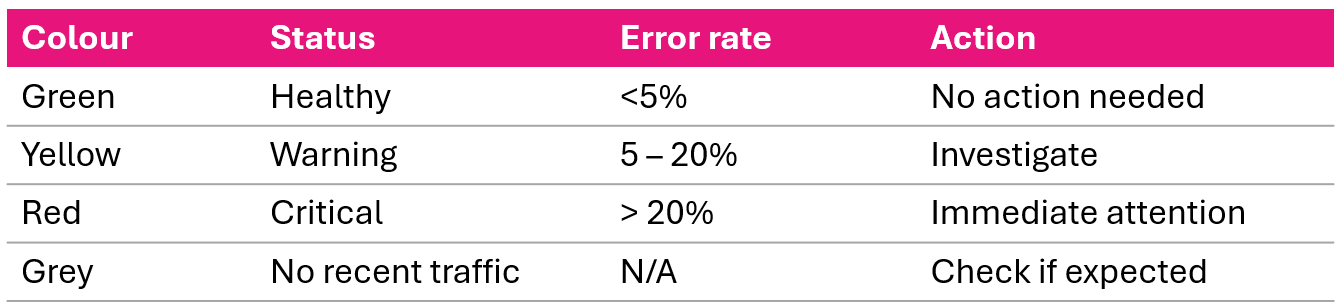
Barevné kódování mapy služeb


Legenda barev mapy služeb: zelená úspěšná volání, žlutá chyby klienta, červená chyby serveru, fialová omezení, šedá žádný provoz

Když otevřeš mapu služeb, zaměř se hned na vše, co není zelené.

Klikni na libovolný uzel a zobrazí se: rozložení doby odezvy, přehled stavů HTTP, typy chyb.

Monitoring and Troubleshooting AWS

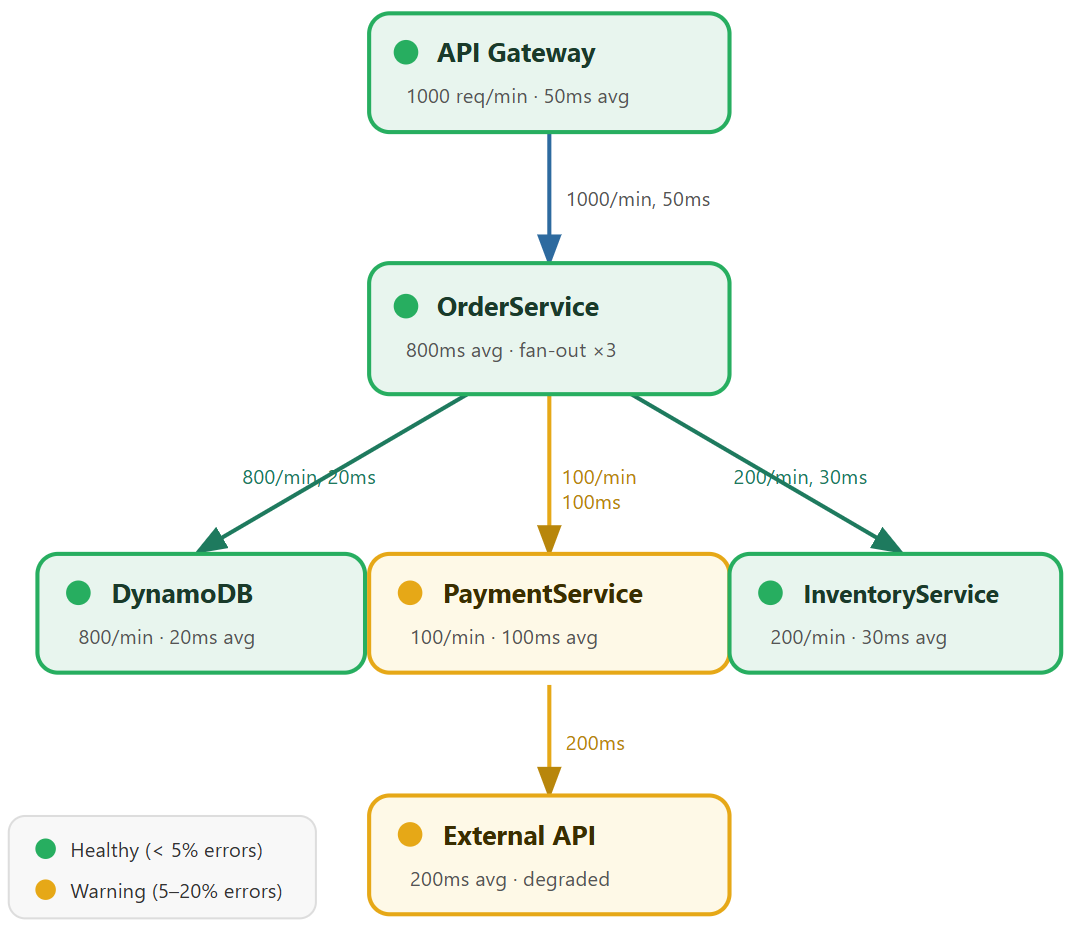
Čtení mapy služeb


Mapa služeb s API Gateway a OrderService rozvětvující se do DynamoDB Inventory a žluté služby Payment

Monitoring and Troubleshooting AWS

Analýza kritické cesty


Kritická cesta = nejdelší řetězec volání služeb

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Total: 400ms

External API = 50 % celkové latence


Co s tím udělat:

  • External API je cíl optimalizace
  • Možnosti: přidat caching, zavést timeout + fallback, dojednat SLA

Porovnej alternativní cestu:

OrderService -> DynamoDB
Total: 120ms (fast)
Monitoring and Troubleshooting AWS

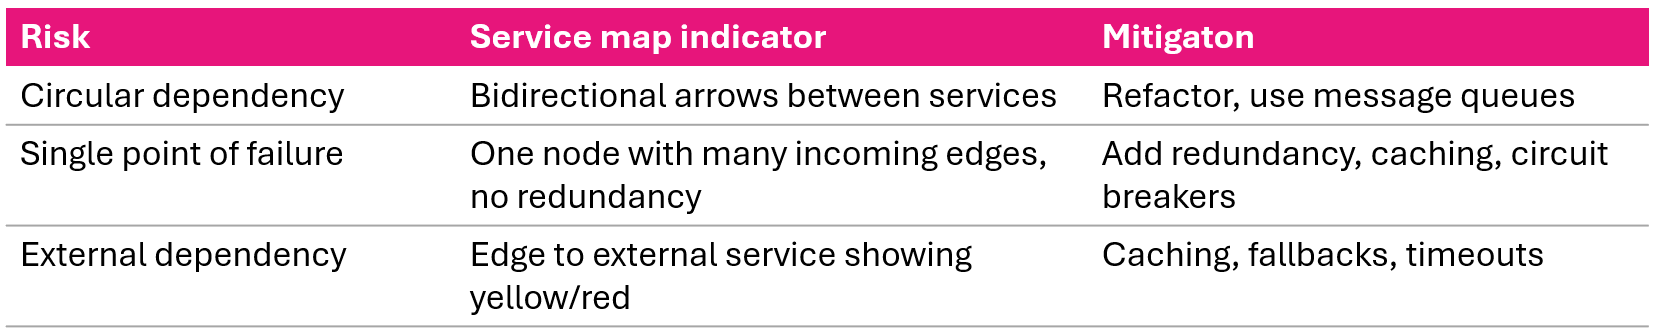
Rizika závislostí


Rizika závislostí v mapě služeb: kruhové závislosti, jediné body selhání a rizikové externí závislosti

Monitoring and Troubleshooting AWS

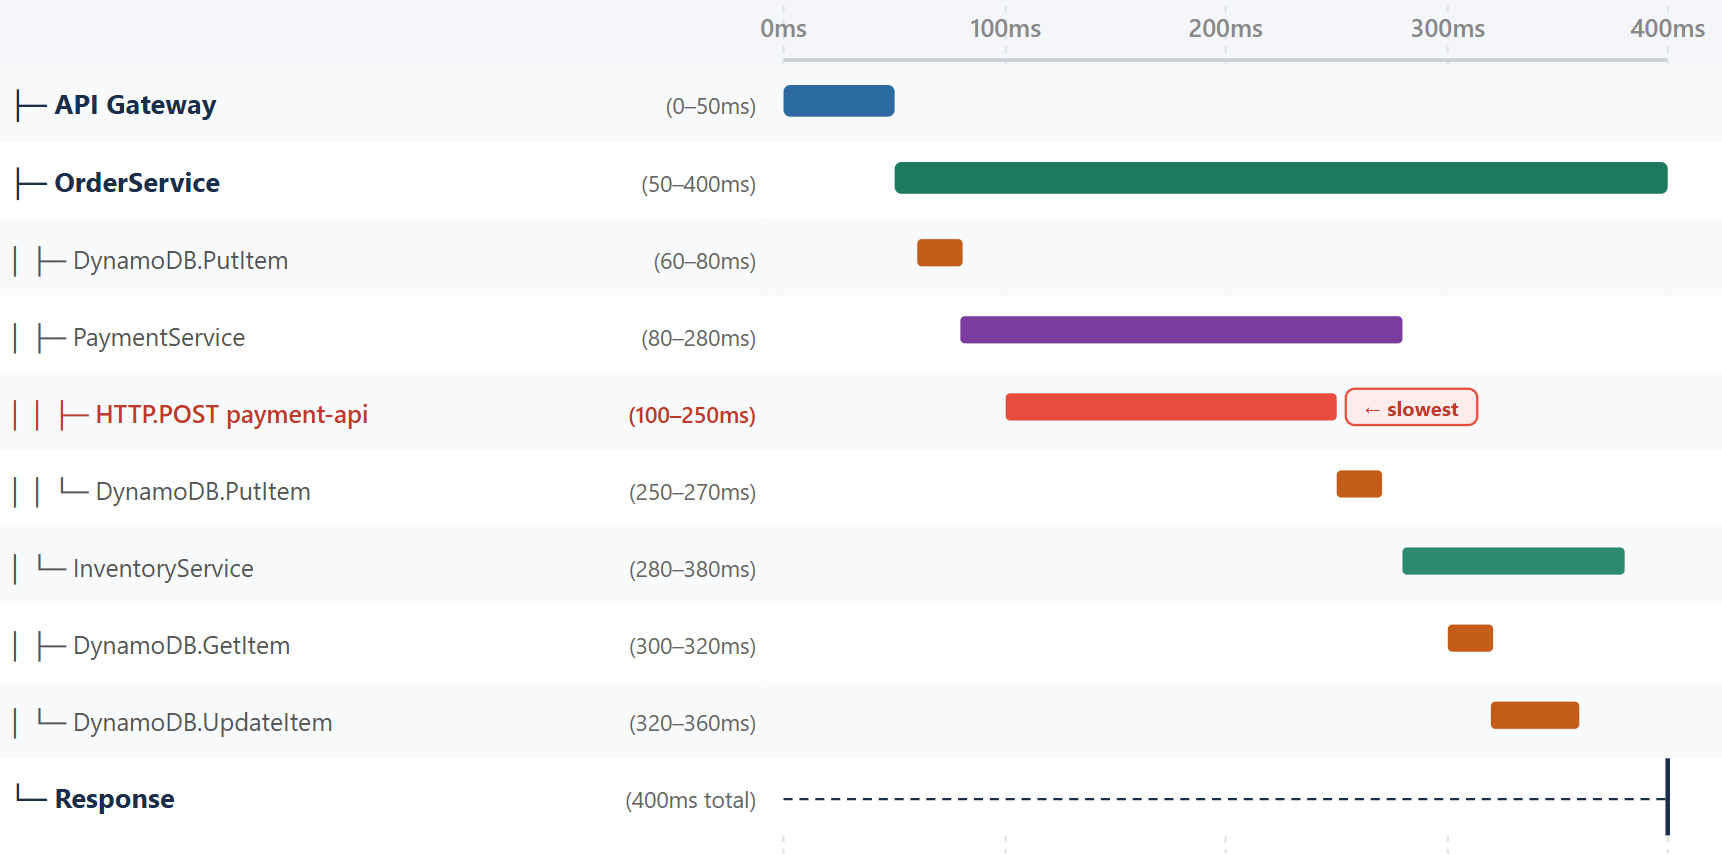
Pochopení časových os tras


Časová osa trasy s podsegmenty podél časové osy ukazující volání payment-api jako nejdelší operaci


  • Vodorovná osa čas: kdy operace začaly a jak dlouho trvaly
  • Svislá osa hierarchie služeb: podsegmenty odsazené pod nadřazenými
  • HTTP.POST na payment-api (100–250 ms) = jediná nejdelší operace
Monitoring and Troubleshooting AWS

Vzor 1: Sekvenční úzká hrdla


Před (sekvenčně – 80 ms):

Query 1 (10-30ms)
         -> Query 2 (30-50ms)
                  -> Query 3 (50-70ms)
                           -> Query 4 (70-90ms)


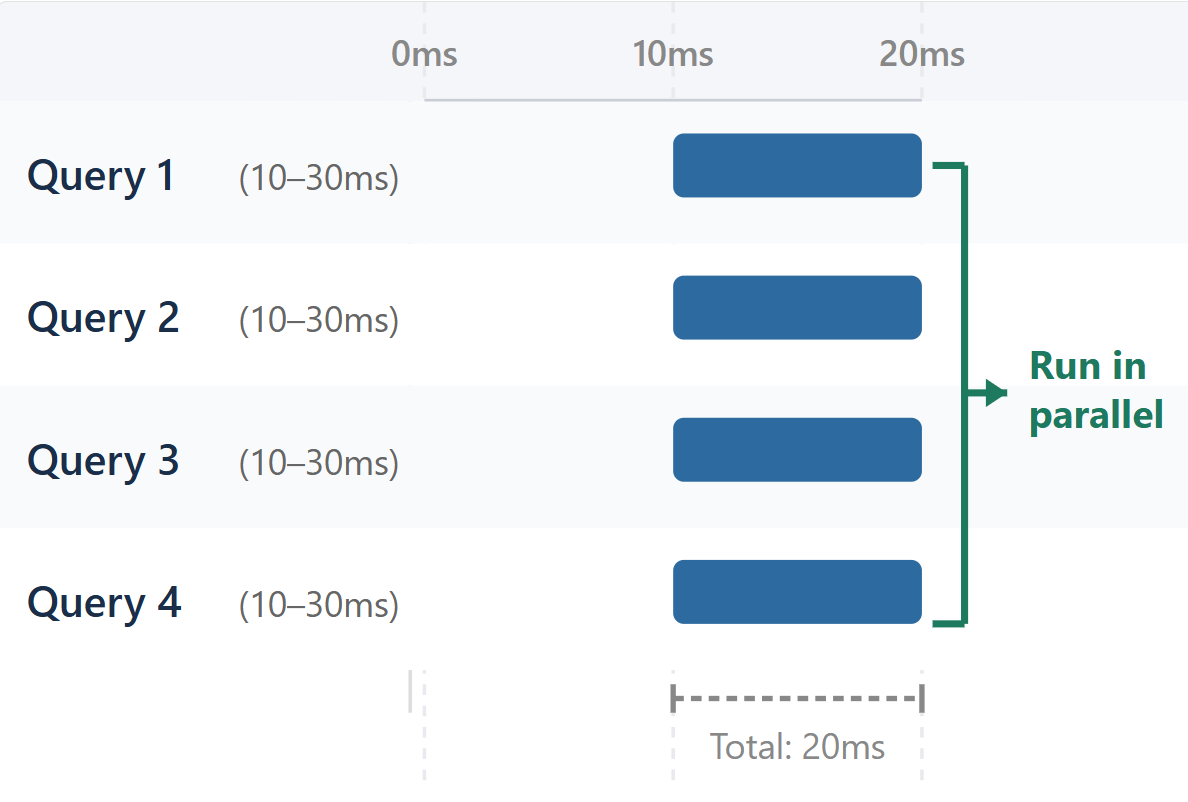
Po (paralelně – 20 ms):

Časová osa trasy čtyř dotazů běžících paralelně s překryvem, dokončených za 20 ms

Monitoring and Troubleshooting AWS

Vzor 2: N+1 dotazy a příliš komunikující služby


Problém N+1 dotazů:

Get user list       (10-20ms)
Get user 1 details  (20-30ms)
Get user 2 details  (30-40ms)
... ×100 sequential queries

Řešení: dávkové dotazy, eager loading


Příliš komunikující služby:

  • 50 malých volání mezi dvěma službami místo 1 dávky
  • Každé volání: navázání spojení + serializace + round-trip
  • 50× větší režie

Řešení: dávkové požadavky, fronty zpráv, caching

Monitoring and Troubleshooting AWS

Vzor 3: Cold starty a kaskádová selhání
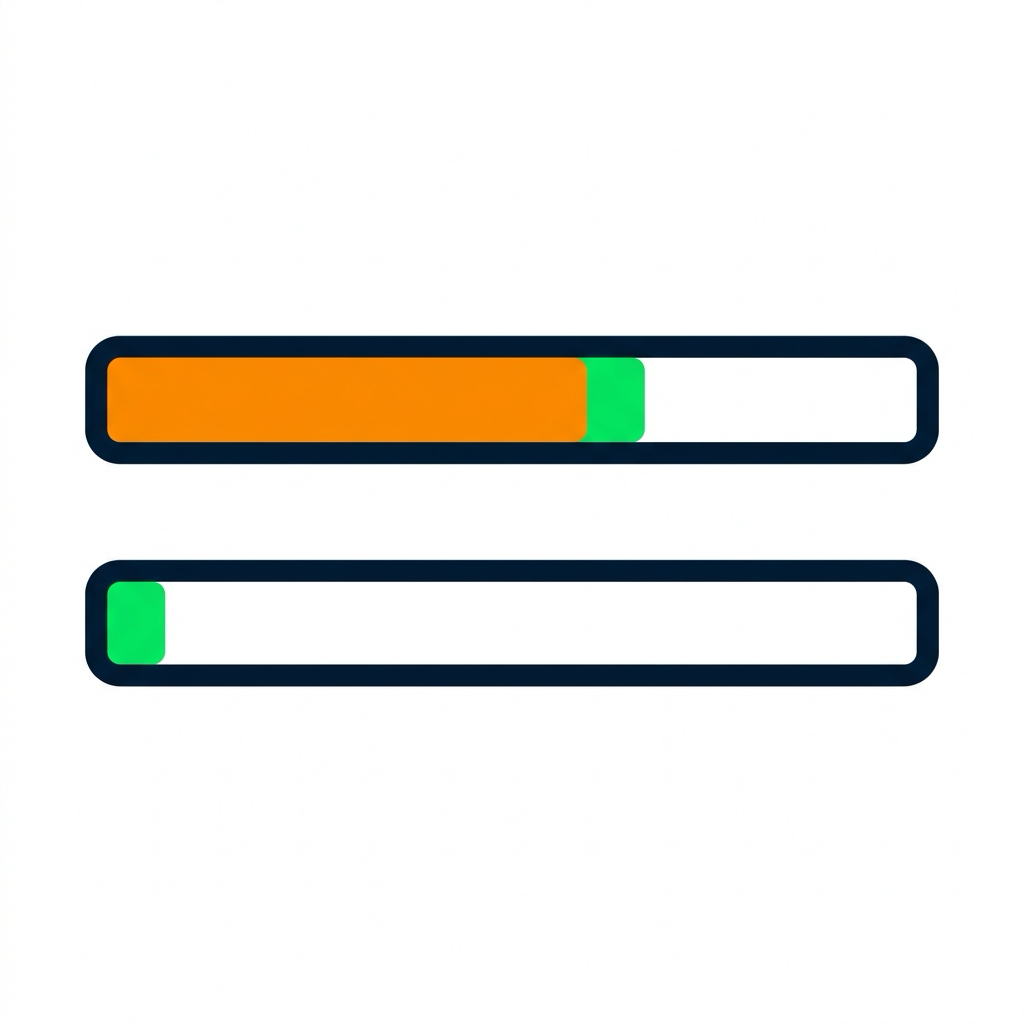
 

Dva pruhy časové osy: cold start má velký oranžový inicializační blok a malý zelený handler; warm start má jen malý zelený handler

Lambda Cold Start:

  • Cold: 3 000 ms (2 500 ms init + 500 ms handler)
  • Warm: 500 ms (pouze handler)
  • Zobrazí se jako velký init segment při prvním spuštění

Řešení: provisioned concurrency, optimalizace inicializace


Kaskádové selhání:

Service A [Error]
  -> Service B [Timeout 5s]
    -> Service C [Timeout 5s]
      -> Database [Timeout 5s]

Shodné bloky timeoutu naskládané v hierarchii tras

Řešení: timeouty, circuit breakers, fallbacky

Monitoring and Troubleshooting AWS

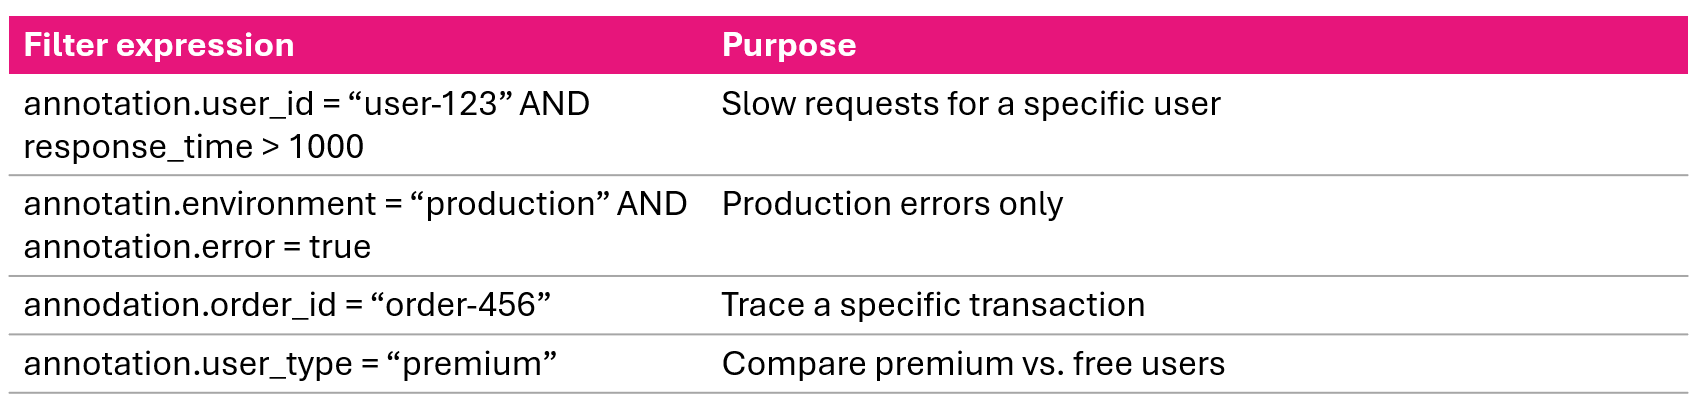
Filtrování tras pomocí anotací

Konzola X-Ray filtrující trasy podle párů klíč–hodnota anotací

Porovnej skupiny:

  • Prémiový uživatelé průměrně 200 ms vs. bezplatní průměrně 150 ms → prémiové funkce přidávají latenci
  • EU West 3× pomalejší než US East → problém s přístupem k datům napříč regiony
Monitoring and Troubleshooting AWS

Pracovní postup analýzy tras


  1. Identifikuj – filtr: response_time > 1000ms, seřaď podle doby trvání
  2. Analyzuj – najdi nejdelší operace, sekvenční úzká hrdla, příležitosti pro paralelizaci
  3. Anotuj – zkontroluj anotace pro obchodní kontext: ID uživatele, ID objednávky, prostředí
  4. Zkontroluj – prozkoumej metadata: podrobnosti požadavku, chybové zprávy
  5. Koreluj – cross-reference s CloudWatch Logs
  6. Diagnostikuj – kořenová příčina: pomalý dotaz, timeout, algoritmus, vyčerpání zdrojů
  7. Oprav – optimalizuj kód, přidej caching, paralelizuj, škáluj
  8. Ověř – porovnej trasy před/po, sleduj latenci a míru chyb
Monitoring and Troubleshooting AWS

Vytváření upozornění z dat X-Ray


# High latency alarm
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# High error count alarm
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
Monitoring and Troubleshooting AWS

Shrnutí videa


  • Mapy služeb – automaticky generované diagramy architektury: uzly (služby), hrany (spojení), barevně kódovaný stav
  • Barevné kódování – zelená (úspěch), žlutá (4xx), červená (chyby 5xx), fialová (429), šedá (žádný provoz)
  • Kritická cesta – nejdelší řetězec volání, určuje cíl optimalizace
  • Časové osy tras – odhalují sekvenční úzká hrdla, N+1 dotazy, cold starty, kaskádová selhání
  • Anotace – filtrování a seskupování tras podle obchodního kontextu
  • Postup – osm kroků: identifikuj → analyzuj → anotuj → zkontroluj → koreluj → diagnostikuj → oprav → ověř
Monitoring and Troubleshooting AWS

Analýza tras a map služeb

Monitoring and Troubleshooting AWS

Preparing Video For Download...