Alarmy a notifikace CloudWatch

Monitoring and Troubleshooting AWS

John Q. Martin

Principal Consultant

Co jsou alarmy CloudWatch
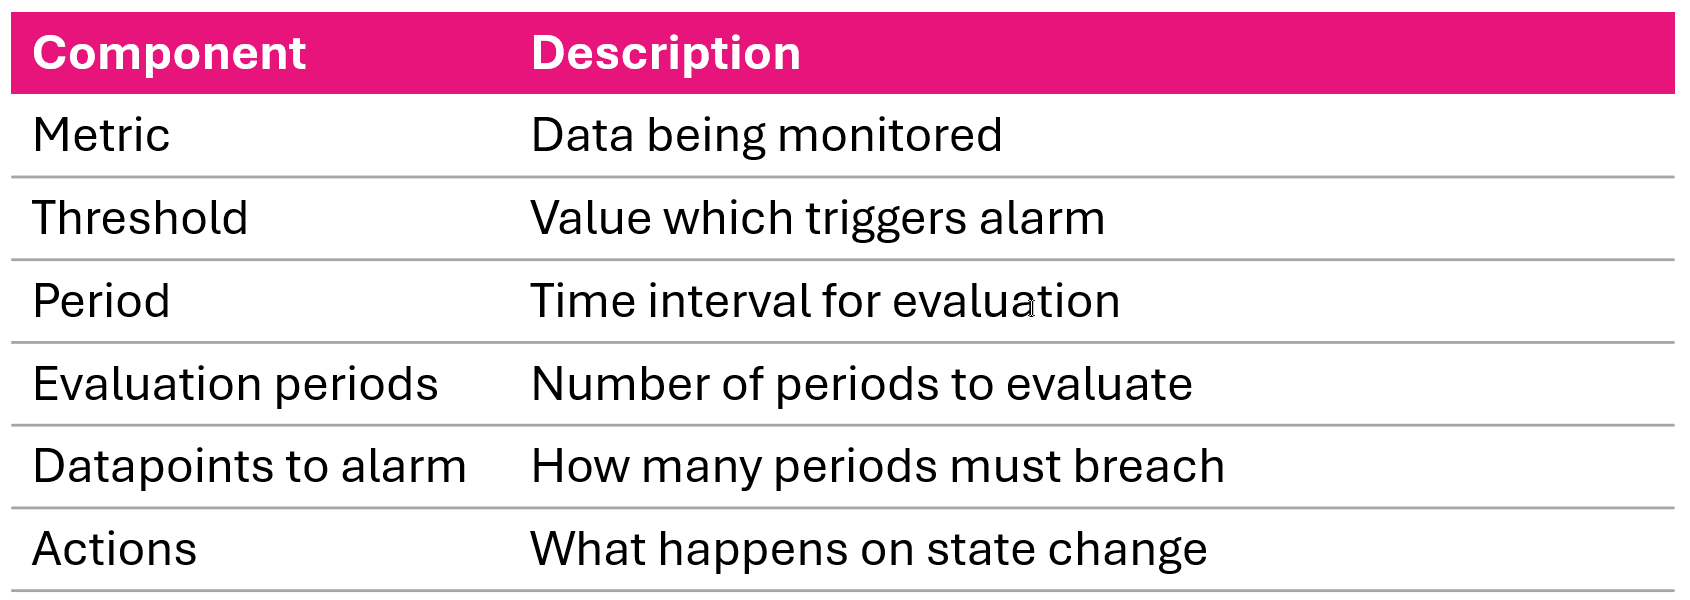
 

Klíčové pojmy

  • Sleduje jednu metriku v průběhu časového období
  • Provede akci, když metrika překročí prahovou hodnotu


Šest základních komponent alarmu CloudWatch: metrika, práh, perioda, počet vyhodnocovacích period, datové body pro alarm a akce

Monitoring and Troubleshooting AWS

Stavy alarmu

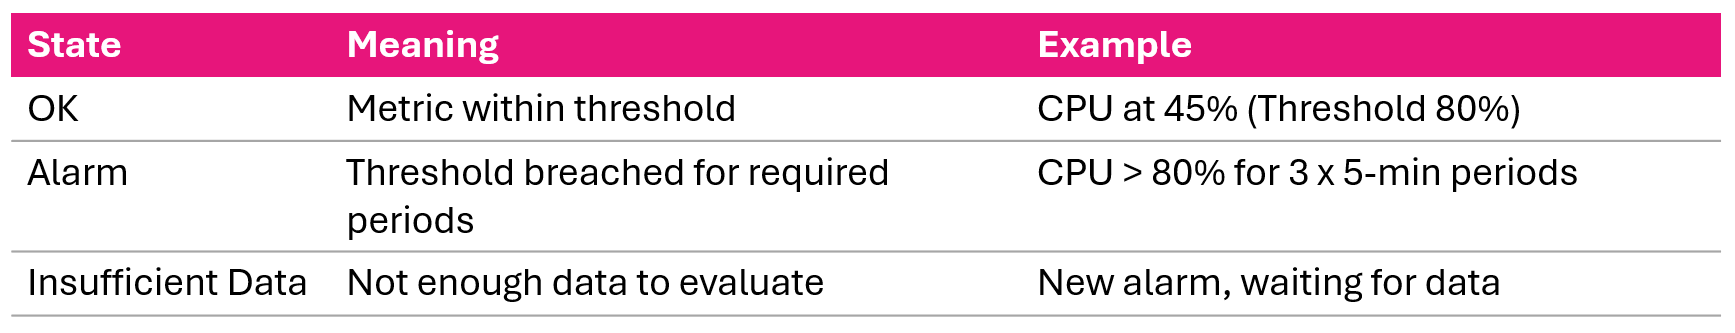
Tři stavy alarmu CloudWatch: OK, ALARM a INSUFFICIENT_DATA

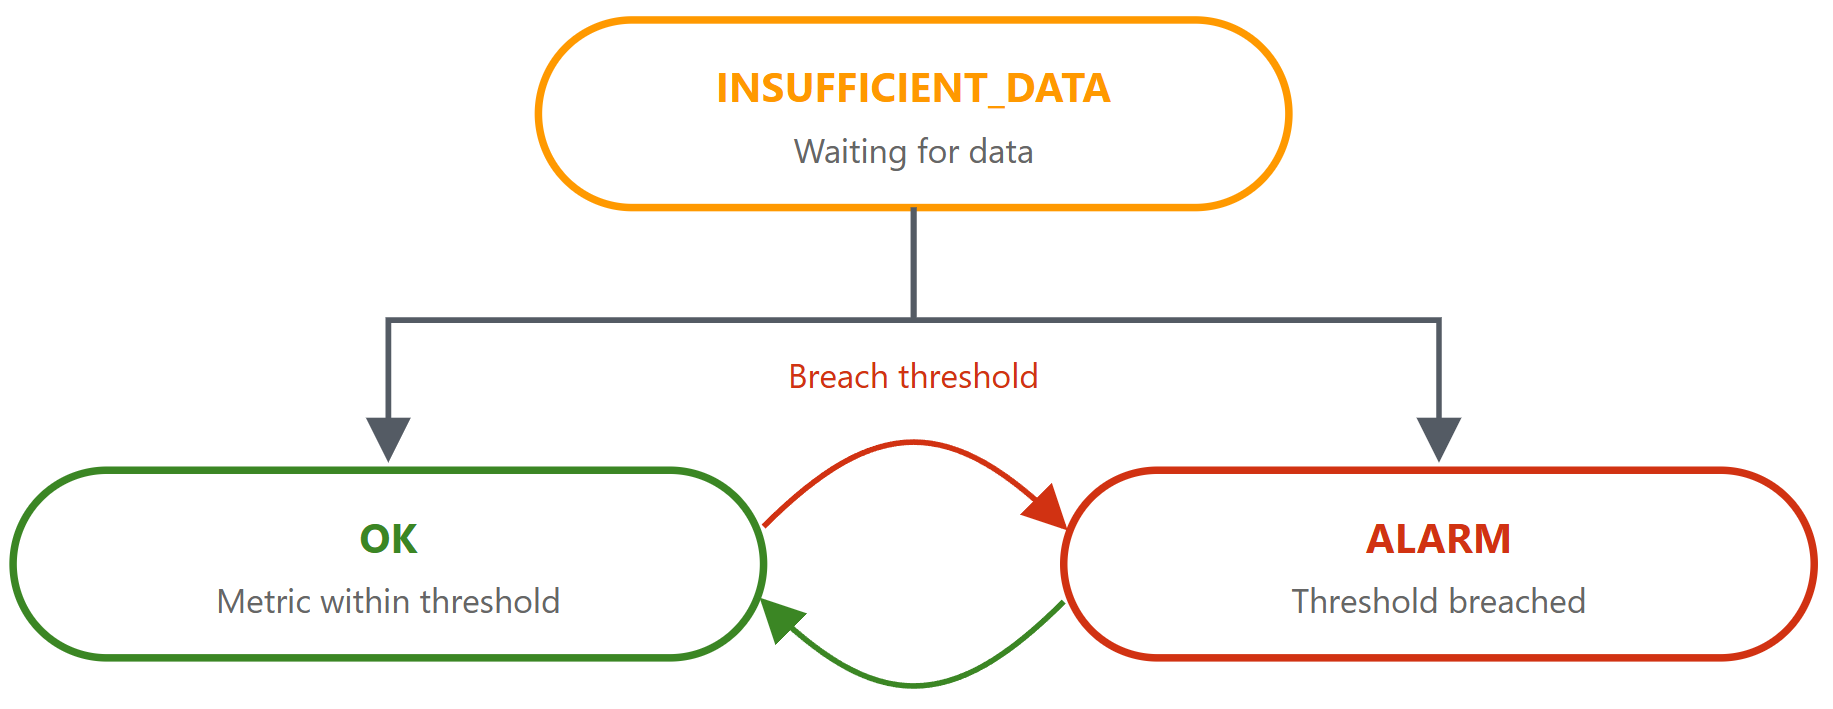
Diagram přechodů alarmu CloudWatch mezi stavy při příchodu nových dat metriky

Monitoring and Troubleshooting AWS

Vyhodnocení alarmu


  1. Sbírá datové body v zadaných intervalech
  2. Aplikuje statistiku (průměr, součet, max, min) za periodu
  3. Porovná výsledek s prahem
  4. Spočítá vyhodnocovací periody s překročením
  5. Změní stav, pokud je splněn práh datových bodů pro alarm


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Monitoring and Troubleshooting AWS

Strategie vyhodnocení


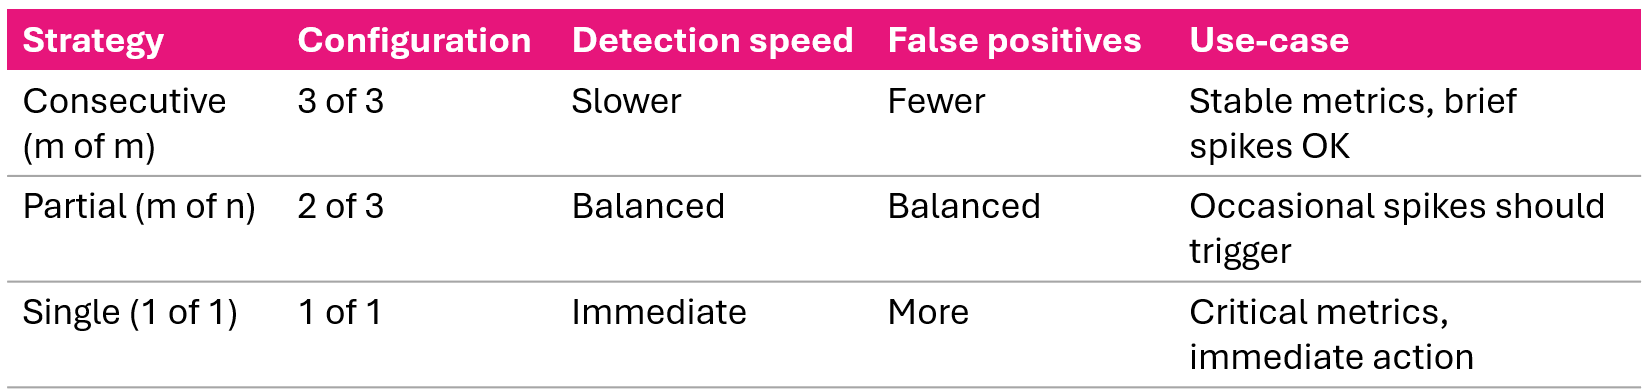
Tři strategie vyhodnocení alarmu: po sobě jdoucí, částečné a jednorázové překročení s jejich citlivostními kompromisy

Monitoring and Troubleshooting AWS

Typy a spouštěče akcí alarmu


Spouštěče akcí

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Typy akcí

  • SNS notifikace
  • Auto Scaling
  • Akce EC2 (stop/terminate/reboot/recover)
  • Systems Manager
Monitoring and Troubleshooting AWS

Chování při chybějících datech


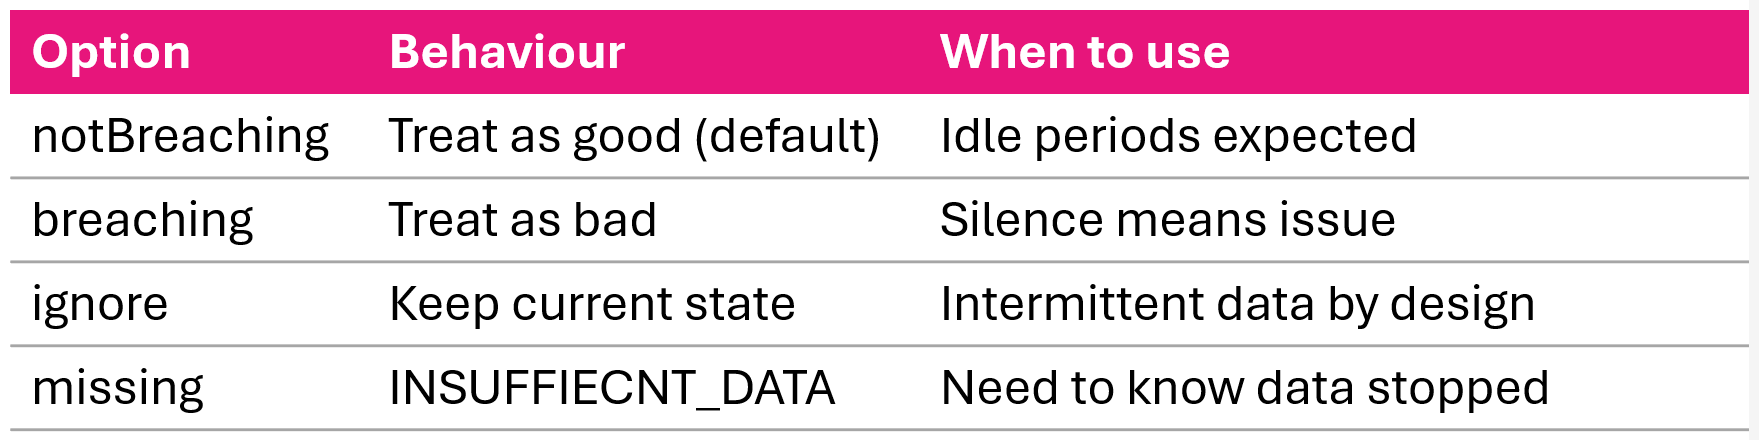
Možnosti chování alarmu při chybějících datech: notBreaching, breaching, ignore a missing

Monitoring and Troubleshooting AWS

Vytvoření standardního alarmu: AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Monitoring and Troubleshooting AWS

Složené alarmy: co to je a proč je používat
Problém

  • Několik souvisejících alarmů se spouští zvlášť = zahlcení upozorněními

Řešení

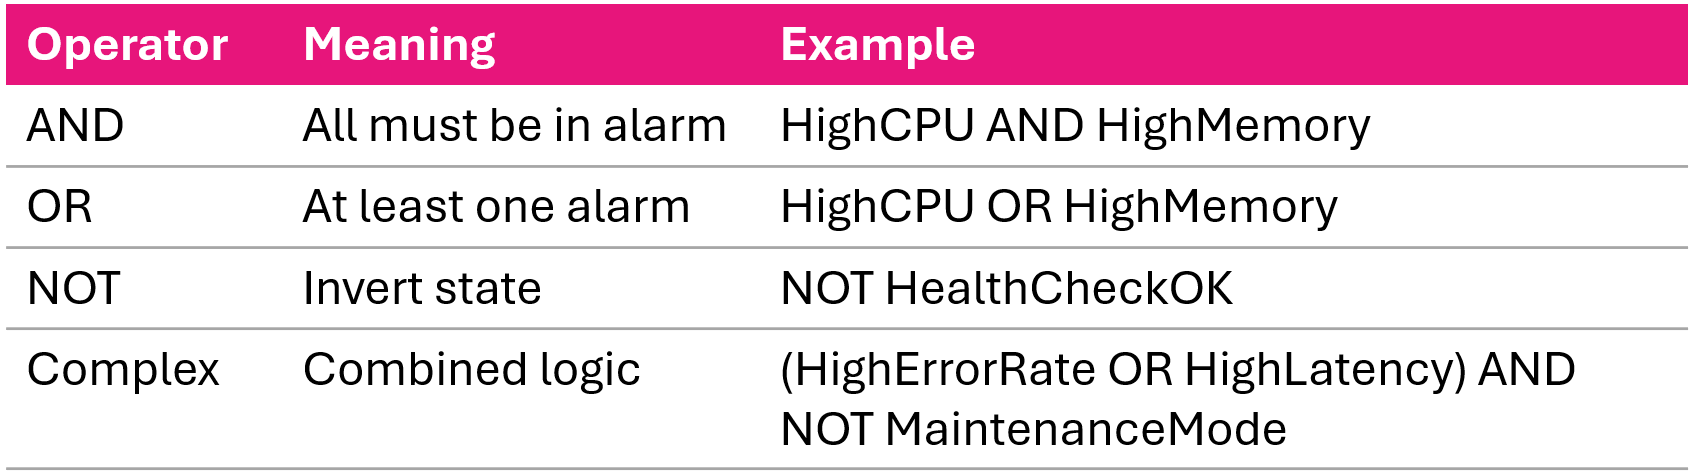
  • Kombinuj alarmy pomocí logických operátorů

Logika složeného alarmu kombinující dílčí alarmy operátory AND, OR a NOT

Monitoring and Troubleshooting AWS

Vytvoření složeného alarmu: AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Příklad složeného pravidla
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Monitoring and Troubleshooting AWS

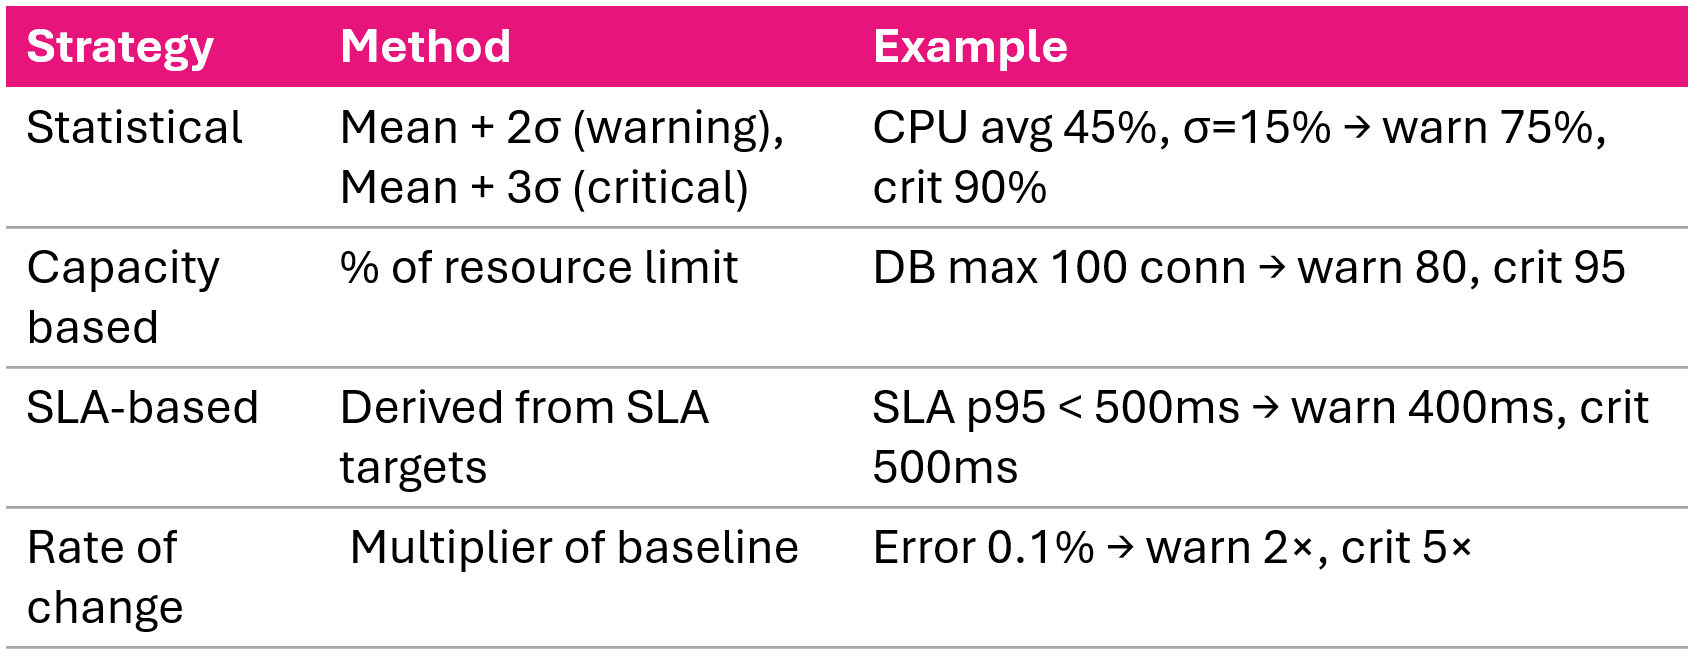
Strategie výběru prahové hodnoty

Čtyři strategie výběru prahu: odchylka od základní úrovně, kapacitní limity, cíle SLA a rychlost změny

Monitoring and Troubleshooting AWS

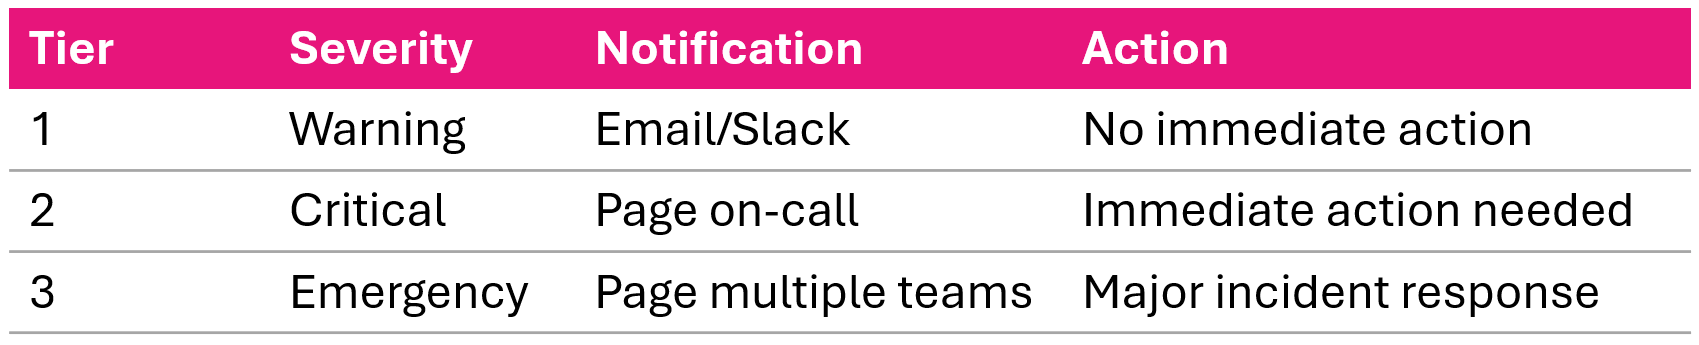
Víceúrovňová strategie alarmů


Víceúrovňová reakce na alarm s úrovněmi varování, kritickou a nouzovou, směrovanými do samostatných SNS témat

Příklad: varování CPU při 75 %, kritická úroveň při 90 %, každá s jiným SNS tématem

Monitoring and Troubleshooting AWS

Alarmy s detekcí anomálií

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • ML model se naučí normální chování metriky
  • Vytvoří dynamické pásmo prahů (konfigurovatelné)
  • Přizpůsobí se denním a týdenním vzorcům
  • Snižuje potřebu ručního nastavování prahů
Monitoring and Troubleshooting AWS

Alarmy pro prostředky: Lambda a ALB

Alarmy pro Lambda
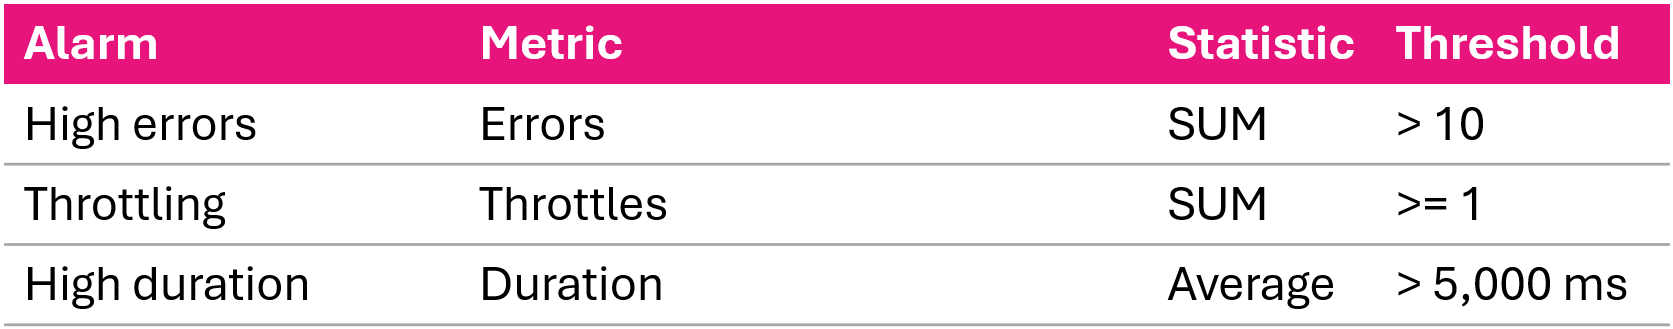
Doporučené alarmy pro Lambda sledující počet chyb, omezení a vysokou dobu běhu blízko limitu časového limitu

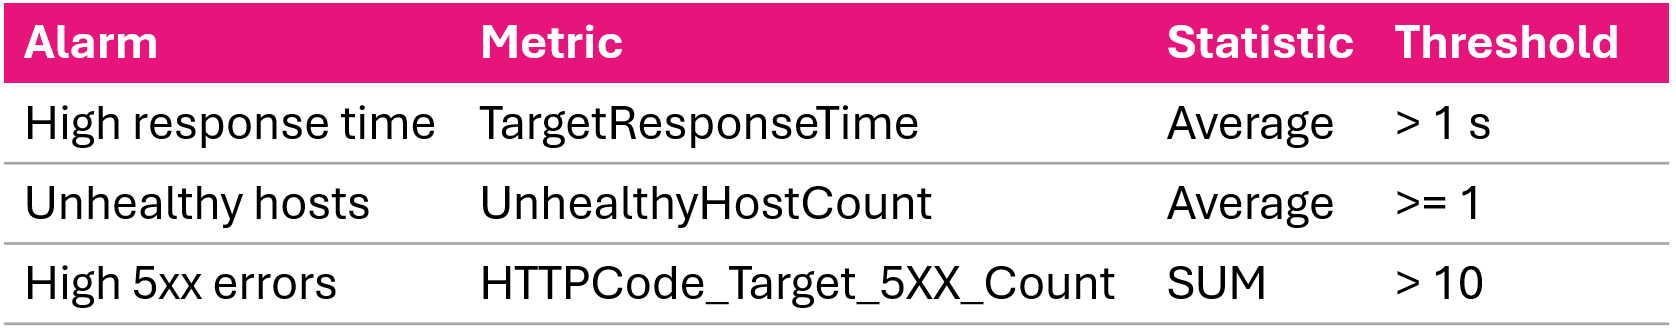
Alarmy pro ALB

Doporučené alarmy pro ALB sledující dobu odezvy cíle, nezdravé hostitele a počty chyb 5xx

Monitoring and Troubleshooting AWS

Doporučené postupy správy alarmů

  • Pojmenování: <Service>-<Metric>-<Resource>-<Severity>
  • Popisy: co se sleduje, práh, tipy pro řešení problémů, odkazy na runbook
  • Štítky: prostředí, tým, závažnost
  • Měsíční revize: uprav prahy, odstraň zastaralé alarmy, aktualizuj akce
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Monitoring and Troubleshooting AWS

Shrnutí videa

  • Tři stavy alarmu: OK, ALARM, INSUFFICIENT_DATA
  • Strategie vyhodnocení: po sobě jdoucí, částečné a jednorázové překročení
  • Složené alarmy kombinují více alarmů pomocí AND, OR, NOT
  • Čtyři prahové strategie: statistická, kapacitní, SLA, rychlost změny
  • Víceúrovňové alertování: varování → kritická → nouzová
  • Alarmy prostředků pro Lambda (chyby, omezení, doba běhu) a ALB (5xx, latence)
Monitoring and Troubleshooting AWS

Pojďme cvičit!

Monitoring and Troubleshooting AWS

Preparing Video For Download...