Анализ журналов с помощью Logs Insights
Мониторинг и устранение неполадок в AWS

John Q. Martin
Principal Consultant
Структура запроса Logs Insights
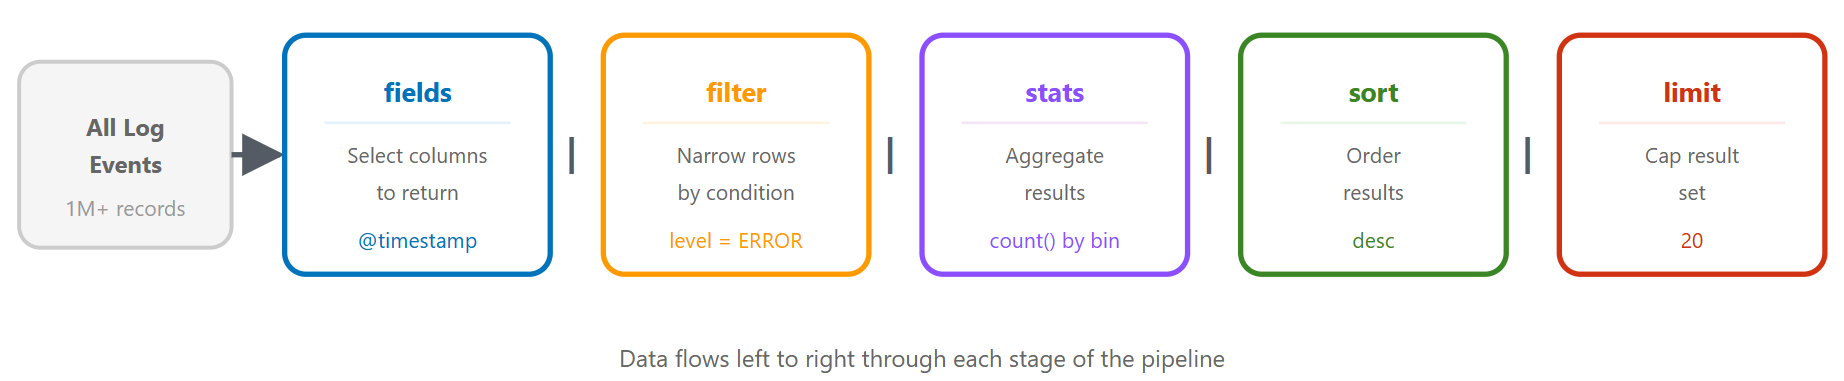
Языки запросов: один запрос, три способа
CloudWatch Logs Insights QL
fields @timestamp, @message, level
| filter level = "ERROR"
| filter @timestamp > ago(1h)
| sort @timestamp desc
| limit 20
OpenSearch PPL
source = `/aws/lambda/my-function`
| where level = 'ERROR' and @timestamp > ago(1h)
| fields @timestamp, @message, level
| sort - @timestamp
| head 20
Языки запросов: OpenSearch SQL
OpenSearch SQL
SELECT `@timestamp`, `@message`, level
FROM `/aws/lambda/my-function`
WHERE level = 'ERROR'
  AND `@timestamp` > ago(1h)
ORDER BY `@timestamp` DESC
LIMIT 20
- Стандартный синтаксис SELECT / FROM / WHERE
- Поддержка JOIN между группами журналов
- Выбирайте то, что удобнее вашей команде
Сценарий 1: обнаружение всплесков ошибок
fields @timestamp, @message, level
| filter level = "ERROR"
| stats count() as error_count by bin(5m)
| sort @timestamp desc
Расширенный вариант: группировка по типу ошибки
fields @timestamp, error_type, error_message
| filter level = "ERROR"
| stats count() as count by error_type, bin(5m)
| sort count desc
Сценарий 2: медленные API-эндпоинты
fields @timestamp, endpoint, response_time, status_code
| filter response_time > 1000
| stats avg(response_time) as avg_time,
        max(response_time) as max_time,
        count() as slow_requests
        by endpoint
| sort avg_time desc
Детализация
fields @timestamp, endpoint, response_time, user_id, request_id
| filter endpoint = "/api/users" and response_time > 1000
| sort response_time desc
| limit 20
Сценарий 3: неудачные попытки аутентификации
fields @timestamp, user_id, ip_address, action
| filter action = "login_failed"
| stats count() as failed_attempts by user_id, ip_address
| sort failed_attempts desc
| limit 50
Анализ по времени
fields @timestamp, user_id, ip_address
| filter action = "login_failed"
| stats count() as attempts by ip_address, bin(1h)
| filter attempts > 10
| sort attempts desc
Сценарии 4 & 5: таймауты БД и утечки памяти
Таймауты базы данных
fields @timestamp, @message
| filter @message like /database/ and @message like /timeout|error|failed/
| parse @message "timeout after * seconds" as timeout_duration
| stats count() as timeout_count,
        avg(timeout_duration) as avg_timeout
        by bin(5m)
Обнаружение утечек памяти
fields @timestamp, memory_used_mb, heap_size_mb
| stats avg(memory_used_mb) as avg_memory,
        max(memory_used_mb) as max_memory
        by bin(1h)
| sort @timestamp asc
Сценарий 6: трассировка запросов
fields @timestamp, @message, request_id, service, action
| filter request_id = "abc123def456"
| sort @timestamp asc
Трассировка через несколько сервисов
fields @timestamp, service, action, duration_ms, status
| filter request_id = "abc123def456"
| sort @timestamp asc
| display @timestamp, service, action, duration_ms, status
Продвинутые техники: parse и Regex
Разбор неструктурированных журналов
fields @timestamp, @message
| parse @message "[*] User * failed to access resource * from IP *"
    as level, user, resource, ip
Разбор с помощью регулярных выражений
| parse @message /Request completed in (?<duration>\d+)ms with status (?<status>\d+)/
Продвинутые техники: вычисляемые поля
fields @timestamp, requests, errors
| fields error_rate = (errors / requests) * 100

fields @timestamp, status_code
| fields status_category =
    case(status_code < 300, "success",
         status_code < 500, "client_error",
         status_code >= 500, "server_error")
| stats count() as request_count by status_category
Оптимизация запросов
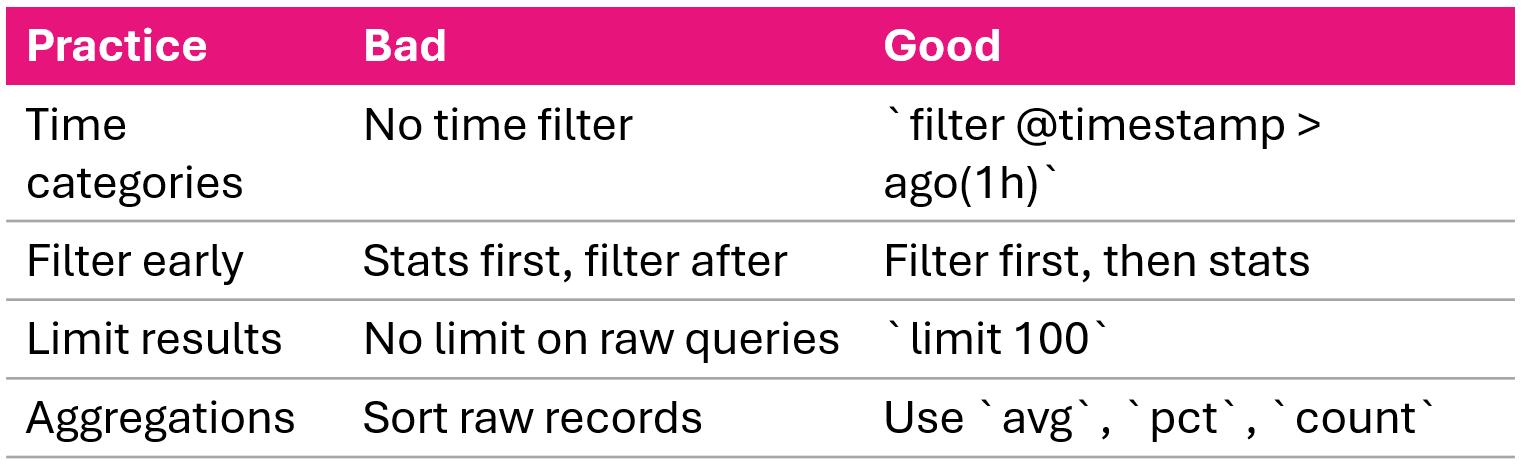
Обнаружение аномалий и корреляция
Статистическое обнаружение аномалий
- Вычислите базовые показатели: среднее и стандартное отклонение за 7 дней
- Сравните текущий период с базовыми показателями
- Отметьте значения, превышающие 2 стандартных отклонения, как аномальные
Корреляция частоты ошибок
fields @timestamp, level
| stats count() as total_requests,
        sum(case(level = "ERROR", 1, 0)) as errors
        by bin(5m)
| fields error_rate = (errors / total_requests) * 100
Итоги
- CloudWatch Logs Insights: интерактивный сервис запросов без необходимости в инфраструктуре
- Три языка запросов: Logs Insights QL, OpenSearch PPL, OpenSearch SQL
- Шесть сценариев диагностики: всплески ошибок, медленные эндпоинты, сбои аутентификации, таймауты БД, утечки памяти, трассировка запросов
- Продвинутые техники:
parseдля неструктурированного текста,bin()для временных рядов,pct()для перцентилей - Корреляция и обнаружение аномалий: анализ частоты ошибок, сравнение со статистической базой
- От анализа к автоматизации: фильтры метрик и оповещения замыкают цикл
Давайте потренируемся!
Мониторинг и устранение неполадок в AWS

