Дашборды работоспособности приложений

Мониторинг и устранение неполадок в AWS

John Q. Martin

Principal Consultant

Дизайн дашборда: иерархия информации
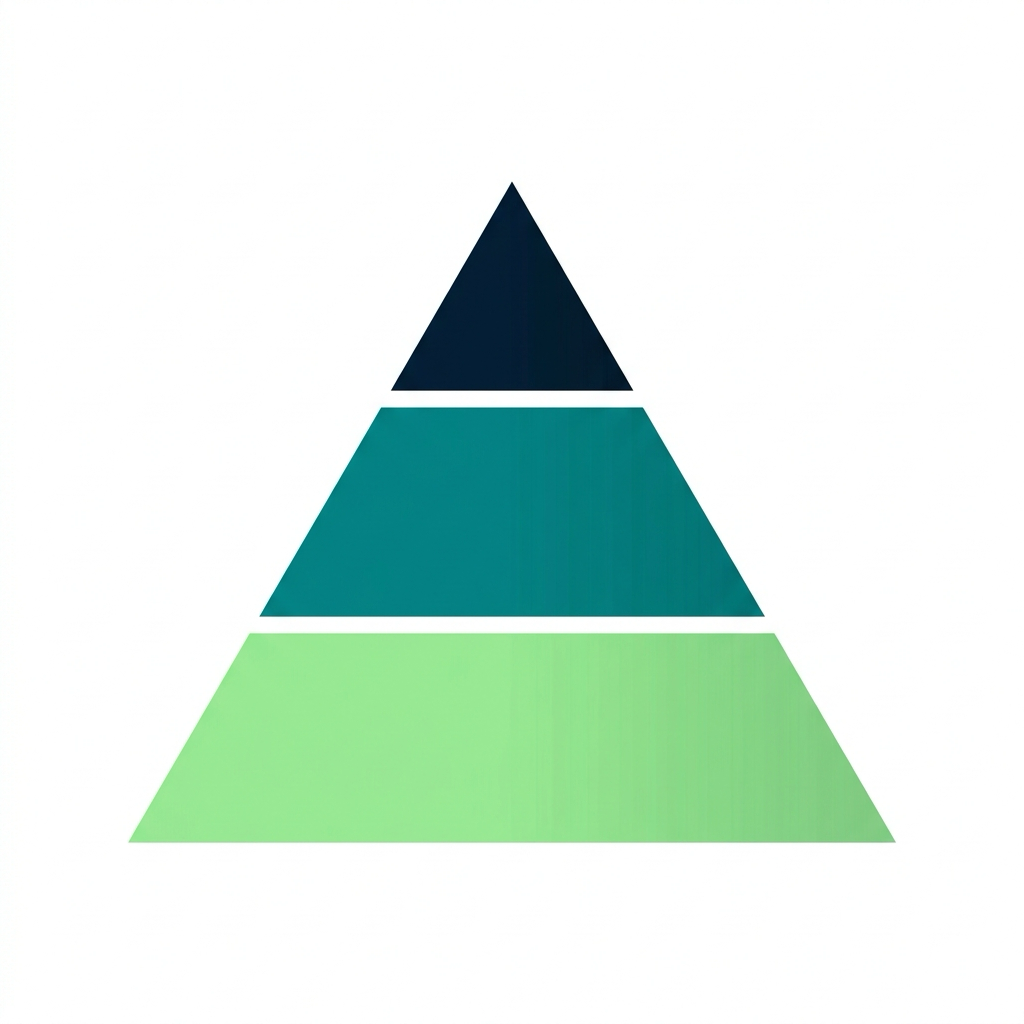
 

Трёхуровневая пирамида: узкий тёмный верхний уровень, более широкий бирюзовый средний и самый широкий зелёный нижний

Как в больнице: регистратура → палата → консультант


Верх — сводка для руководства

  • Общее состояние системы
  • Ключевые бизнес-метрики, SLA, текущие инциденты

Середина — работоспособность сервисов

  • Частота ошибок, процентили задержки, пропускная способность

Низ — детальная диагностика

  • Трассировки, логи, использование ресурсов, состояние зависимостей
Мониторинг и устранение неполадок в AWS

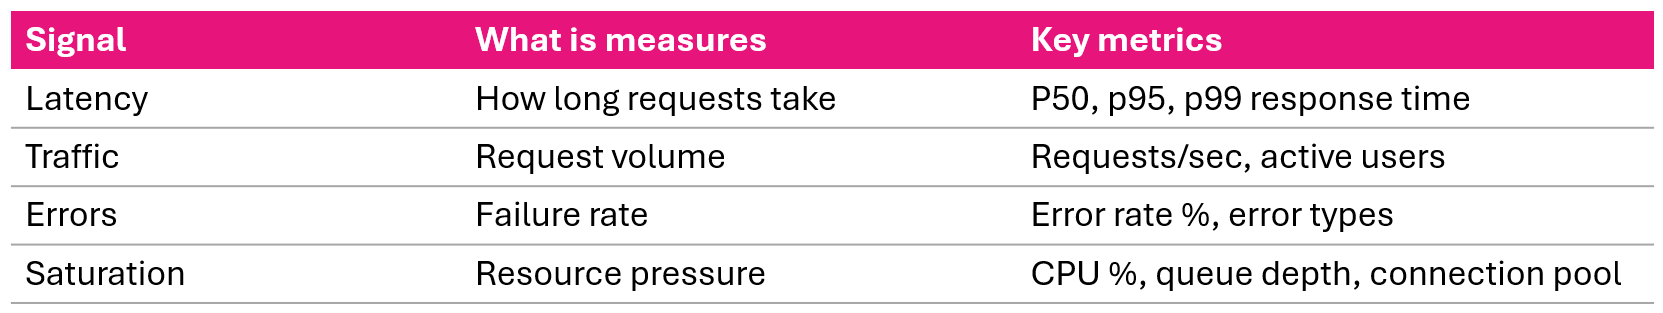
Четыре золотых сигнала


Четыре золотых сигнала мониторинга: задержка, трафик, ошибки и насыщение

Эти четыре сигнала охватывают подавляющее большинство проблем, с которыми вы столкнётесь.

Мониторинг и устранение неполадок в AWS

Метод RED


RED для сервисов, обрабатывающих запросы:
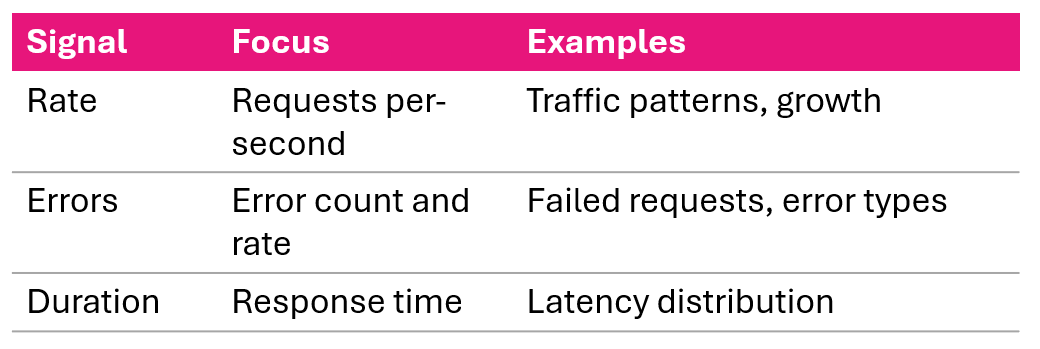
Паттерн RED: частота запросов, ошибки и длительность для сервисов, обрабатывающих запросы


Связь с золотыми сигналами:

  • RED — сфокусированное подмножество четырёх золотых сигналов
  • Разработан для сервисов, обрабатывающих пользовательские запросы
  • Насыщение (4-й золотой сигнал) добавляется для мониторинга инфраструктуры

Используйте RED как отправную точку, а насыщение — для углублённой диагностики.

Мониторинг и устранение неполадок в AWS

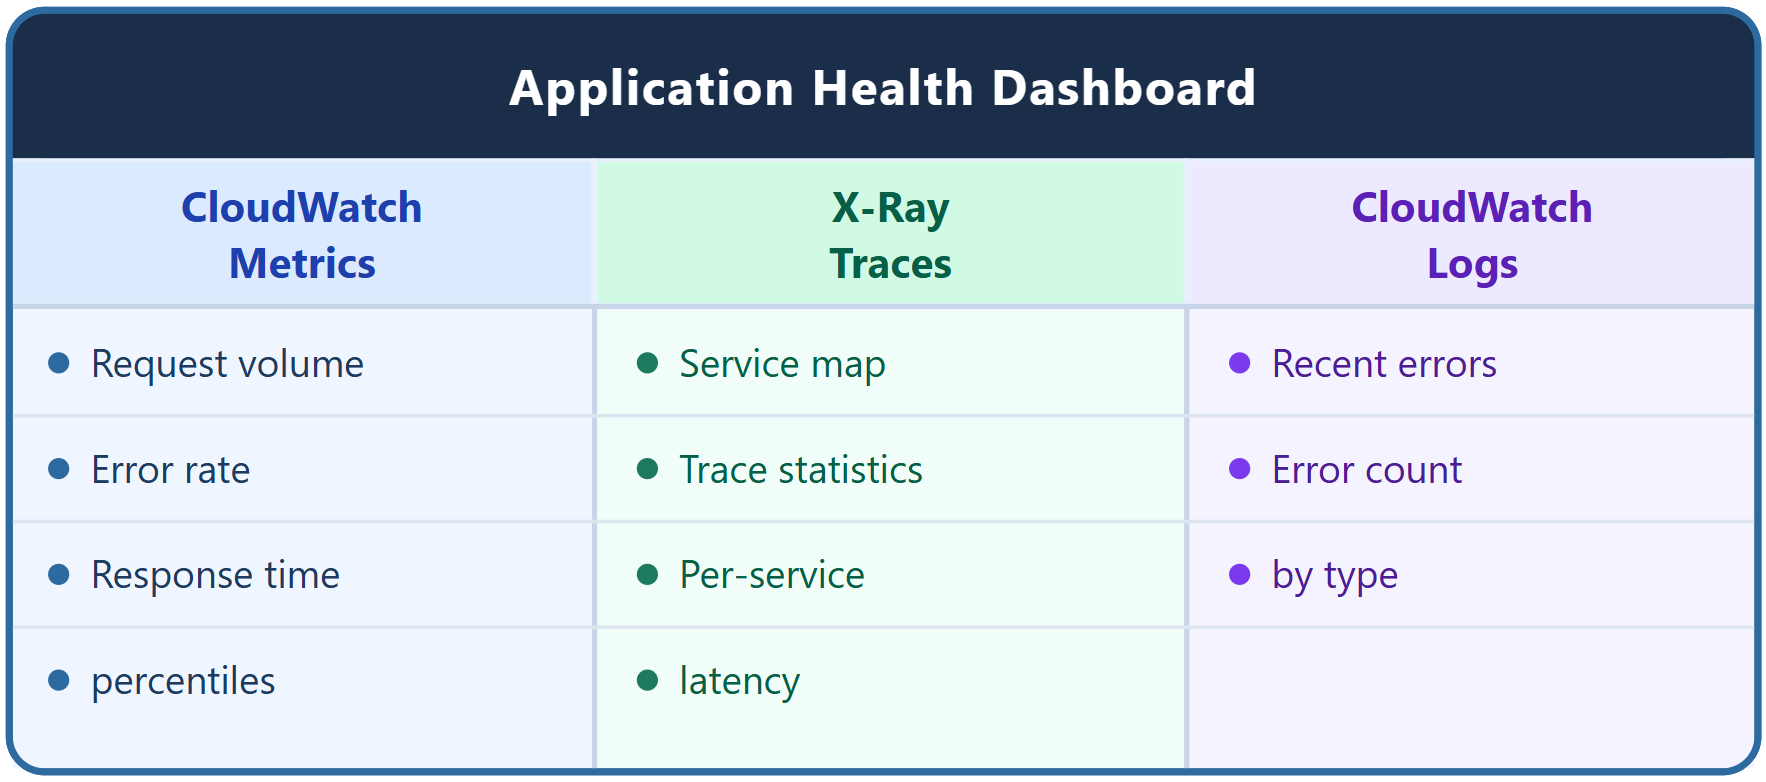
Три источника данных


Диаграмма трёх источников данных для дашборда: метрики CloudWatch, трассировки X-Ray и CloudWatch Logs

Мониторинг и устранение неполадок в AWS

Виджеты метрик CloudWatch

Объём запросов:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

Частота ошибок (метрическая математика):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

Процентили времени отклика:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • Объём запросов из ALB RequestCount
  • Частота ошибок вычисляется через метрическую математику — errors / invocations × 100
  • Время отклика в процентилях p50, p95, p99
Мониторинг и устранение неполадок в AWS

Виджеты X-Ray и логов


Виджеты X-Ray:

  • Карта сервисов — топология приложения с индикаторами работоспособности
  • Статистика трассировок — среднее время отклика, частота ошибок и сбоев
  • Задержка сервисов — сравнение времени отклика по отдельным сервисам


Виджеты CloudWatch Logs:

Запрос последних ошибок:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

Количество ошибок по типу:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
Мониторинг и устранение неполадок в AWS

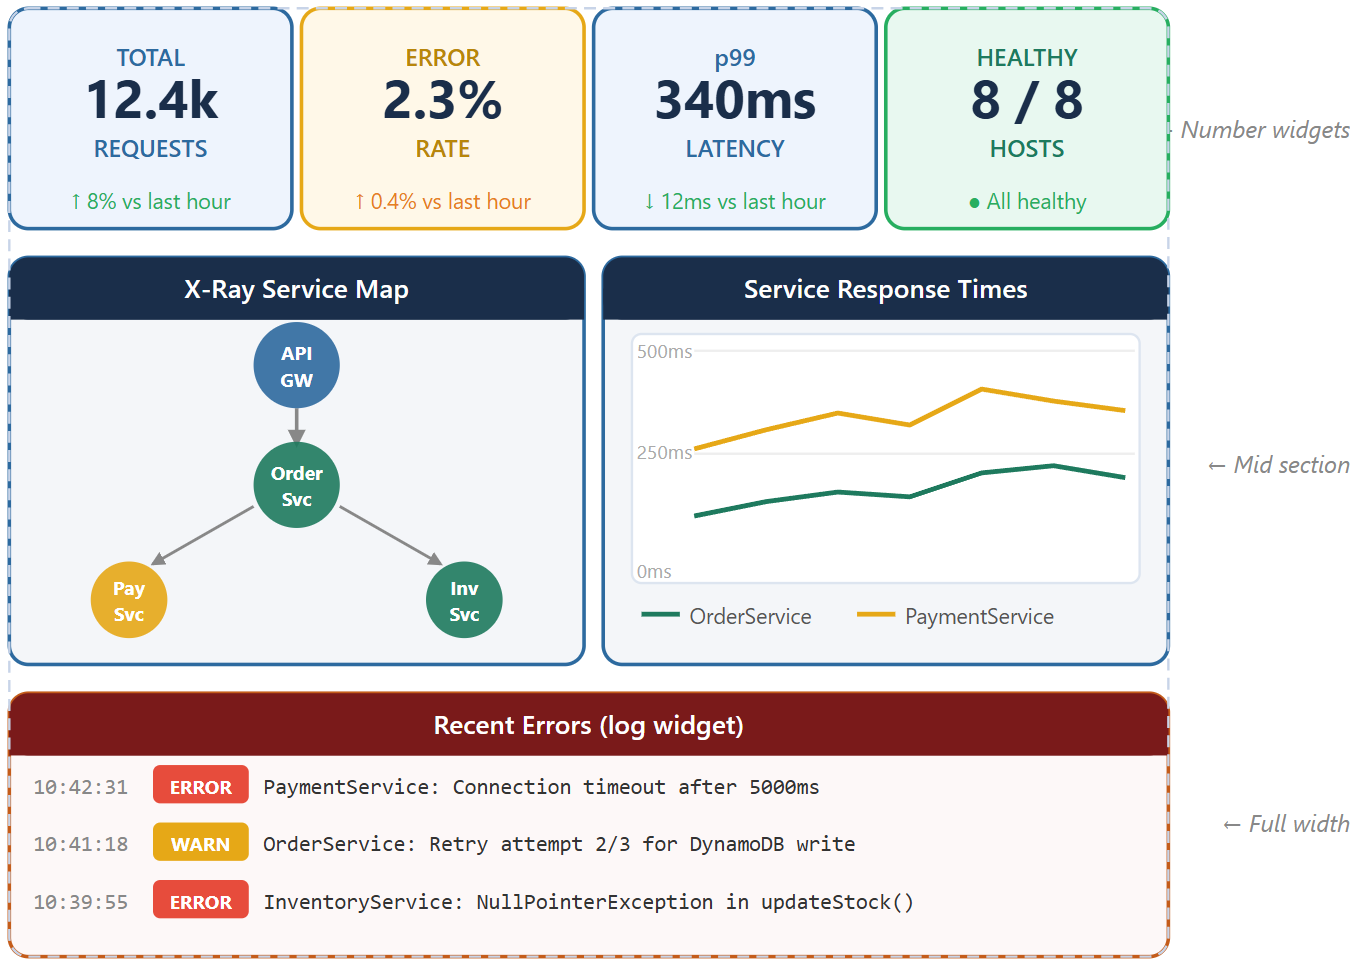
Полный макет дашборда


Макет дашборда работоспособности: сводные виджеты вверху, карта сервисов в центре, журнал ошибок внизу

Мониторинг и устранение неполадок в AWS

Процесс устранения инцидентов


Карта с приоритетами сортировки в приёмном отделении: цветовые полосы и стетоскоп

Как сортировка в скорой: стабилизировать → диагностировать → лечить → проверить

  1. Выявить — красные/жёлтые индикаторы, всплески ошибок
  2. Определить масштаб — какие сервисы? когда? ситуация ухудшается?
  3. Сопоставить — ошибки + задержка, трафик + ресурсы
  4. Углубиться — карта сервисов → трассировки → логи
  5. Найти причину — зависимость, БД, память, конфигурация
  6. Устранить — автоматический выключатель, масштабирование, откат, переключение
  7. Проверить — частота ошибок в норме, карта зелёная, тревоги сняты
Мониторинг и устранение неполадок в AWS

Сценарий 1: внезапный всплеск трафика

Дашборд мониторинга во время всплеска трафика: графики резко идут вверх, стрелки приборов в красной зоне, красные баннеры оповещений

Что видно на дашборде:

  • Объём запросов в 10× выше нормы
  • Частота ошибок 25%
  • Задержка 3000 мс
  • CPU 95%

Анализ: ресурсы перегружены из-за всплеска трафика


Действия:

  • Немедленно масштабировать горизонтально
  • Включить автомасштабирование
  • Ввести ограничение частоты запросов
  • Добавить кэширование для снижения нагрузки на бэкенд
Мониторинг и устранение неполадок в AWS

Сценарий 2: узкое место в базе данных

Дашборд мониторинга с узким местом базы данных: треснувший красный значок БД, датчики CPU и соединений в красной зоне, резко растущий график задержки запросов, пул соединений почти заполнен

Что видно на дашборде:

  • CPU БД 95%
  • Соединения с БД 95/100
  • Задержка запросов 5000 мс
  • Задержка приложения 5500 мс

Анализ: узкое место — база данных; медленные запросы исчерпывают пул соединений


Действия:

  • Найти медленные запросы в логах
  • Добавить индексы, оптимизировать запросы
  • Увеличить размер пула соединений
  • Масштабировать базу данных
Мониторинг и устранение неполадок в AWS

Сценарий 3: каскадный сбой


Что видно на карте сервисов:
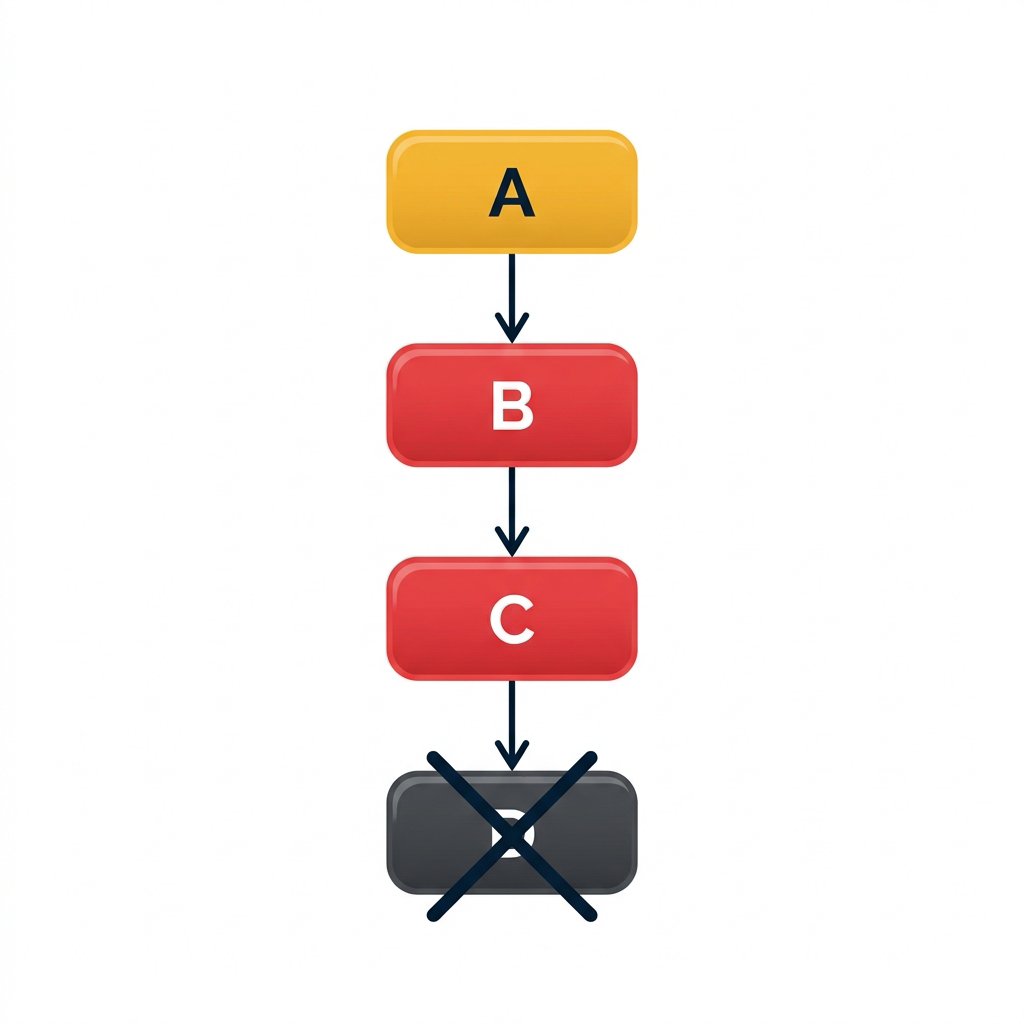
Каскад на карте сервисов: узел A янтарный с клиентскими ошибками, B и C красные со сбоями сервера, D тёмный и полностью недоступный, стрелки идут вниз по цепочке


Анализ:

Небольшая проблема в сервисе A распространилась по цепочке зависимостей

Действия:

  • Автоматические выключатели для остановки каскада
  • Тайм-ауты на каждом уровне сервисов
  • Резервные механизмы для отказавших зависимостей
  • Устранение первопричины в сервисе A
Мониторинг и устранение неполадок в AWS

Рекомендации по дашбордам


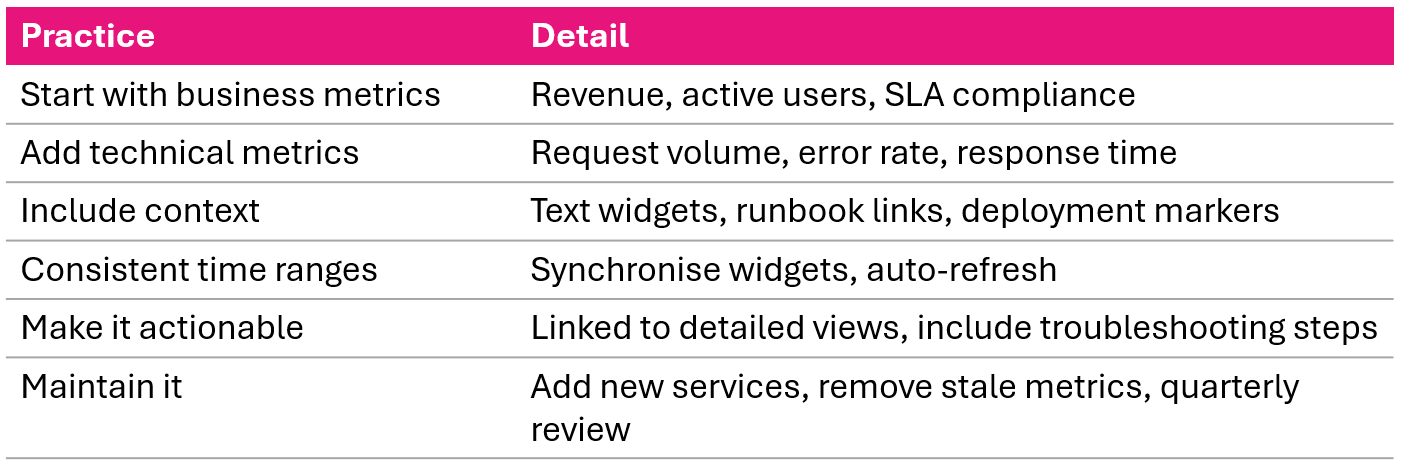
Шесть рекомендуемых практик построения дашбордов для мониторинга работоспособности приложений

Мониторинг и устранение неполадок в AWS

Итоги видео и завершение курса

  • Проектируйте дашборды на основе иерархии информации и четырёх золотых сигналов
  • Объединяйте метрики CloudWatch, трассировки X-Ray и логи в одном представлении
  • Семишаговый процесс устранения инцидентов: выявить → определить масштаб → сопоставить → углубиться → найти причину → устранить → проверить

Теперь вы умеете:

  • Вести мониторинг с помощью метрик CloudWatch, логов и дашбордов
  • Настраивать оповещения и уведомления через SNS и SQS
  • Реализовывать распределённую трассировку с X-Ray
  • Создавать дашборды работоспособности приложений для операционного совершенства
Мониторинг и устранение неполадок в AWS

Дашборды работоспособности приложений

Мониторинг и устранение неполадок в AWS

Preparing Video For Download...