Анализ трассировок и карт сервисов
Мониторинг и устранение неполадок в AWS

John Q. Martin
Principal Consultant
Что такое карта сервисов?
Создаётся автоматически из данных трассировок: ручная настройка не нужна
С первого взгляда: зелёный = в норме · жёлтый = задержка · красный = остановлен
Цветовое кодирование карты сервисов
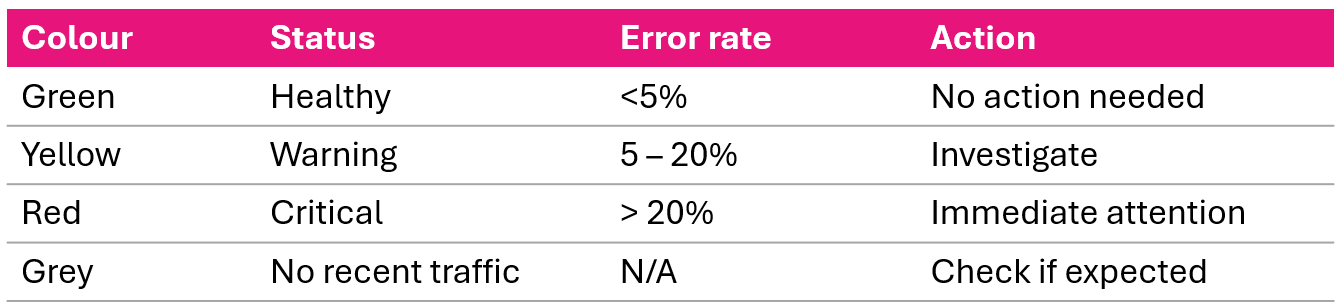
Открыв карту сервисов, сразу обращайте внимание на всё, что не окрашено в зелёный.
Нажмите на любой узел, чтобы увидеть: распределение времени отклика, разбивку по HTTP-статусам, типы ошибок.
Чтение карты сервисов
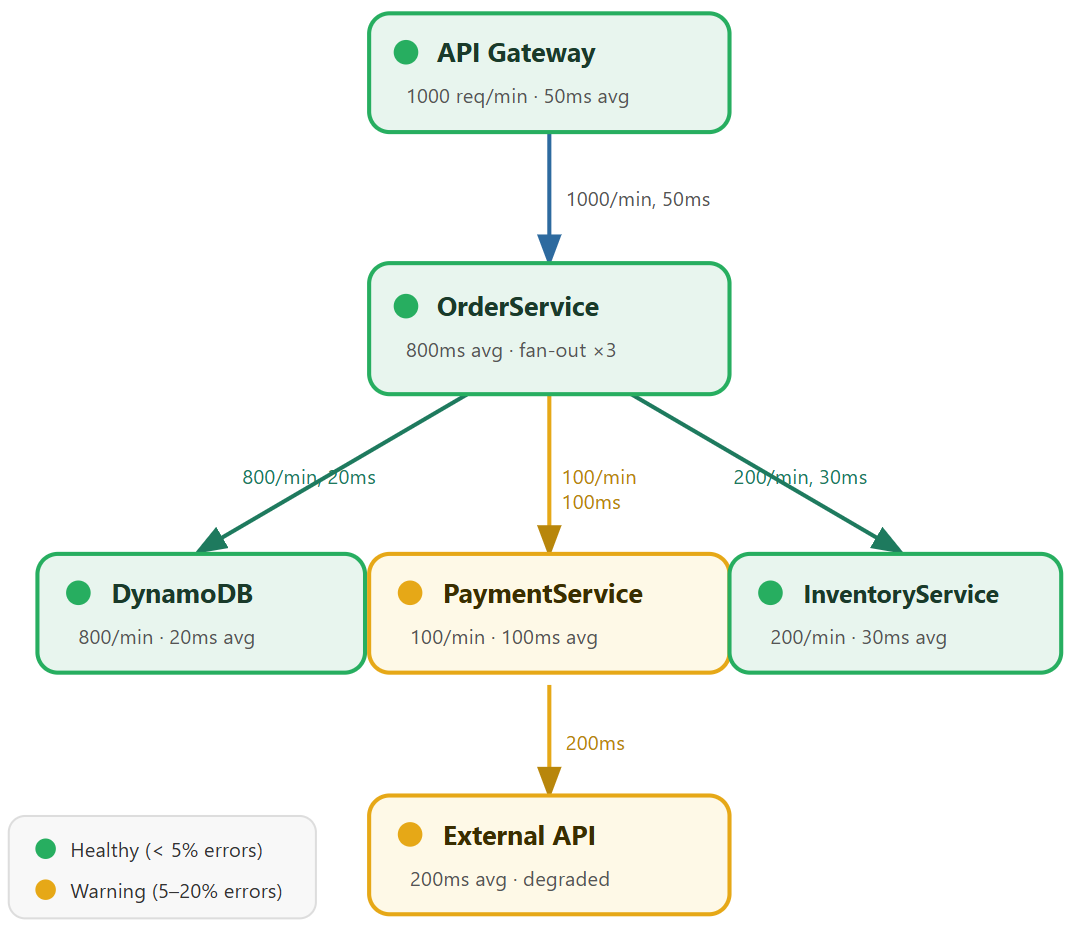
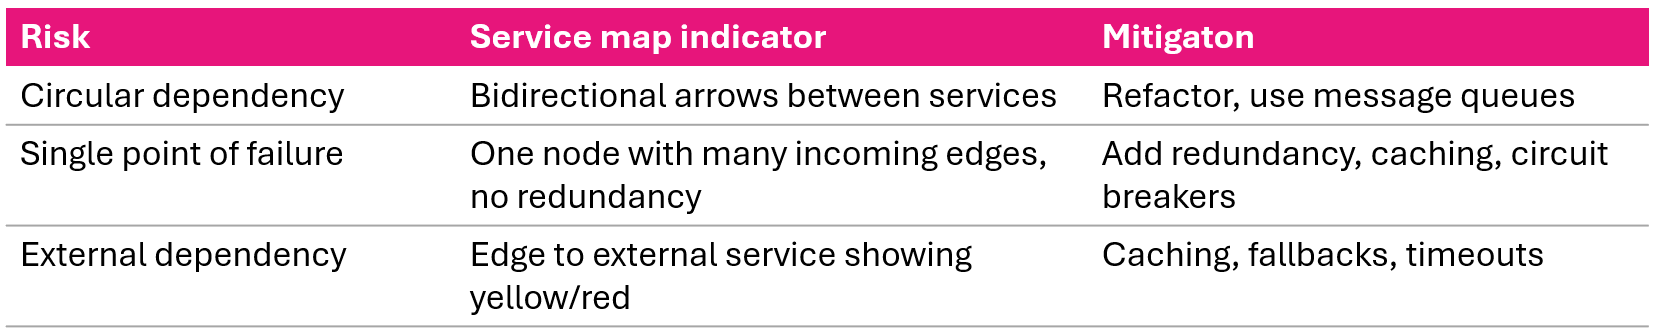
Риски зависимостей
Работа с временными шкалами трассировок
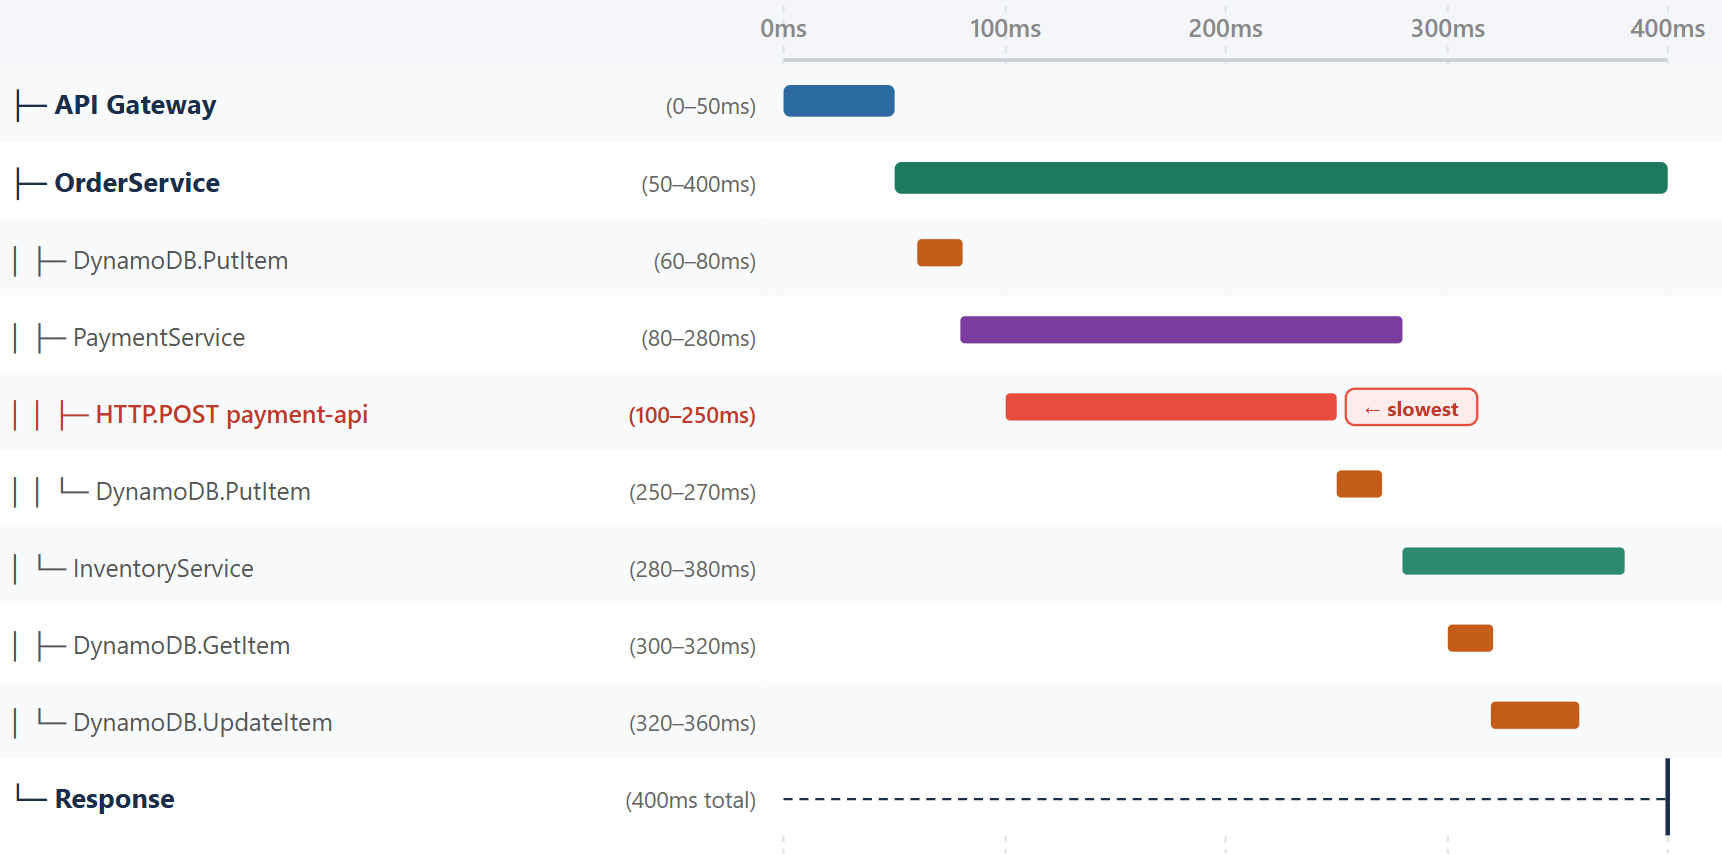
Паттерн 1: последовательные узкие места
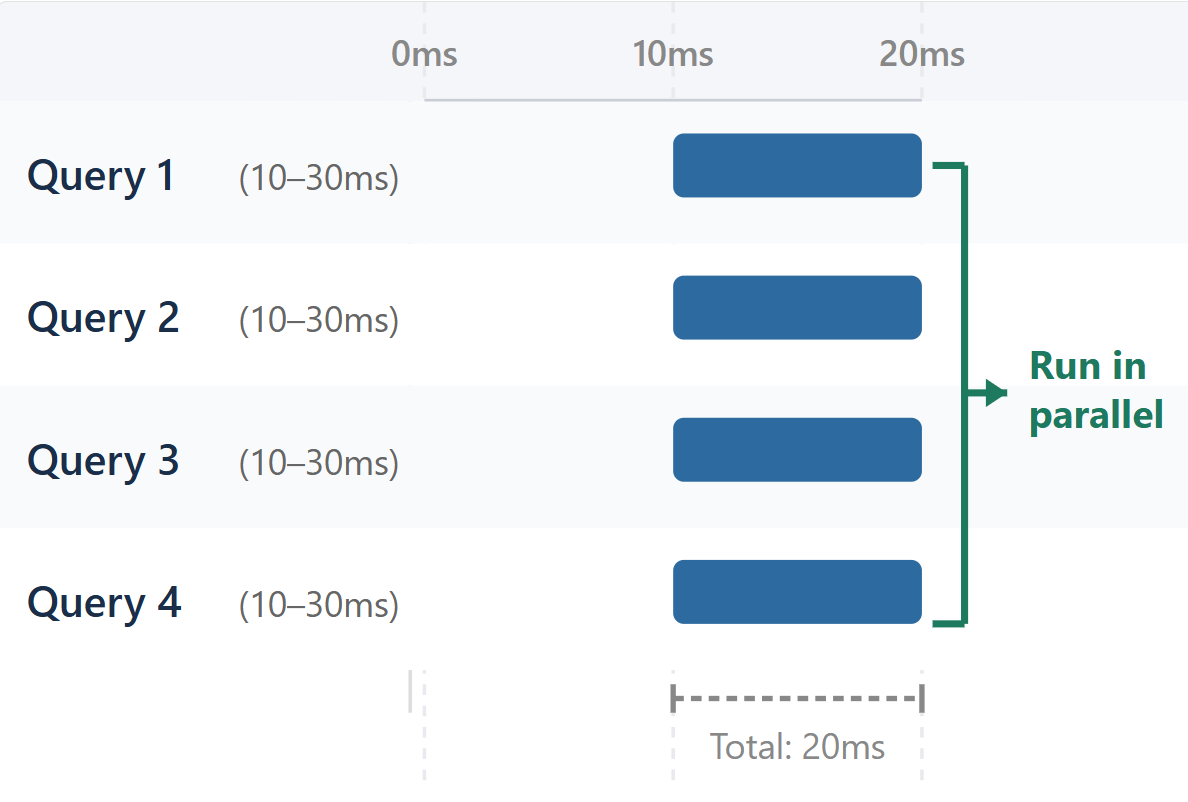
После (параллельно — 20 мс):
Паттерн 3: холодные старты и каскадные сбои
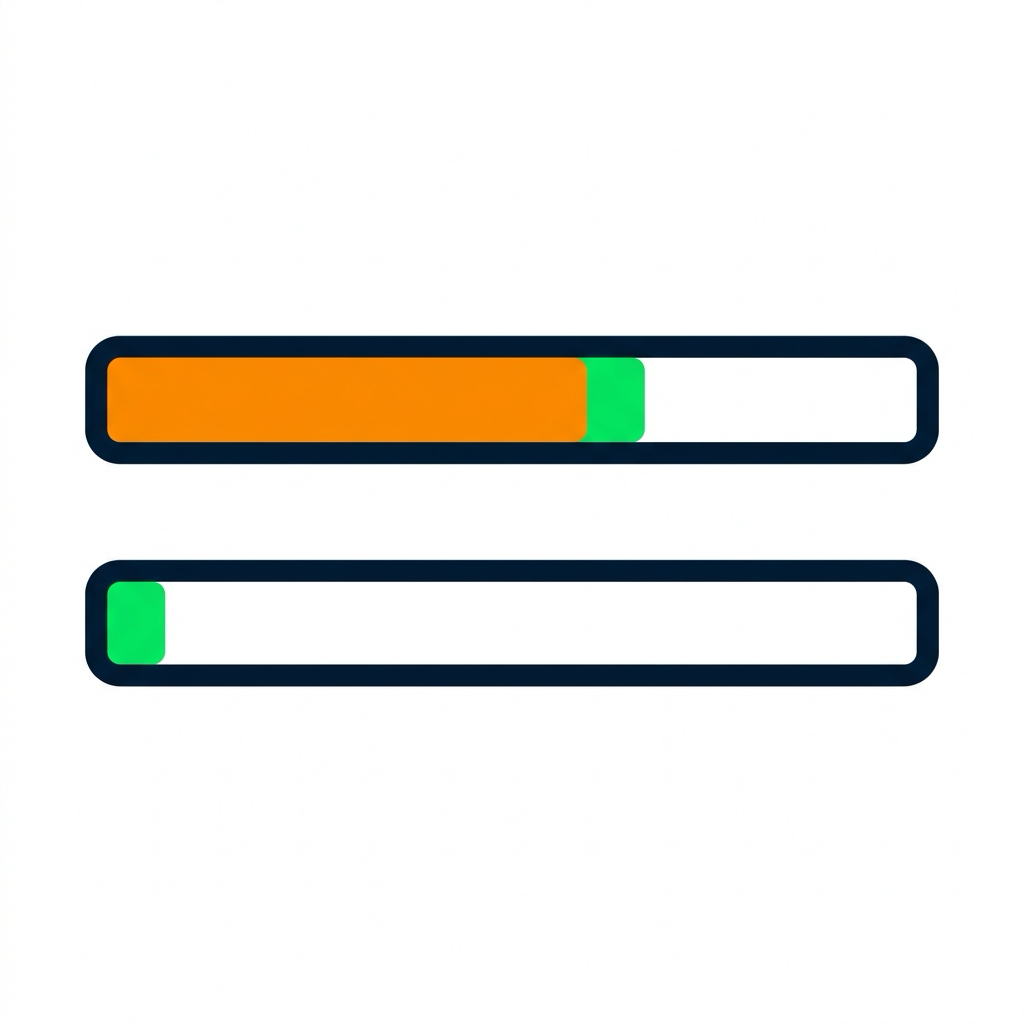
Холодный старт Lambda:
- Холодный: 3000 мс (2500 мс инициализация + 500 мс обработчик)
- Тёплый: 500 мс (только обработчик)
- При первом вызове виден крупный сегмент инициализации
Решение: выделенная конкурентность, оптимизация инициализации
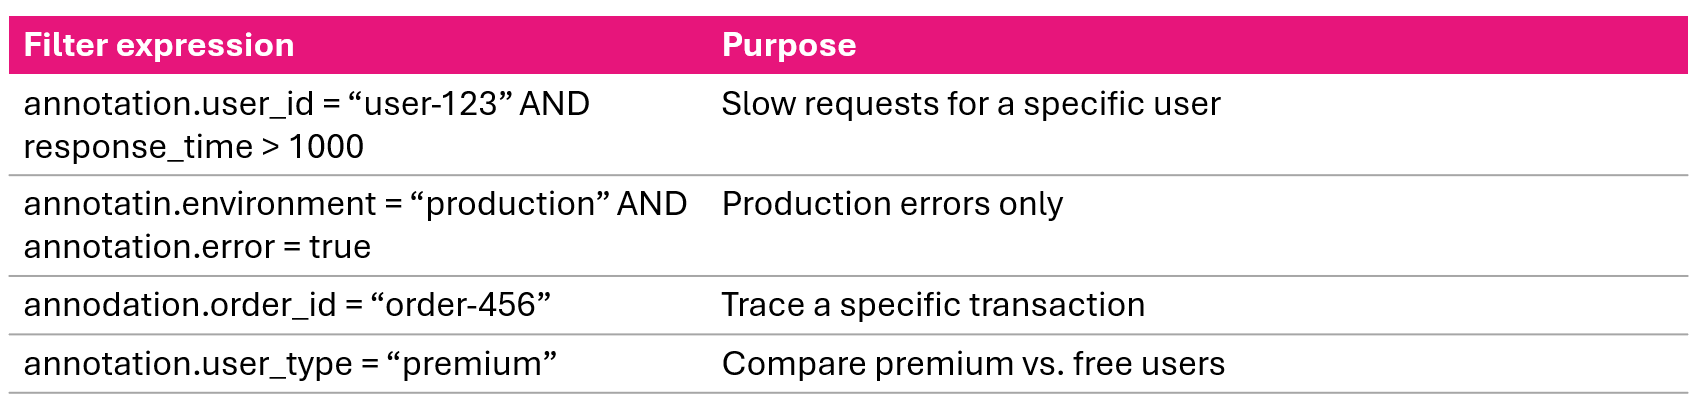
Фильтрация трассировок с помощью аннотаций