애플리케이션 상태 대시보드

AWS 모니터링 및 문제 해결

John Q. Martin

Principal Consultant

대시보드 설계: 정보의 계층 구조
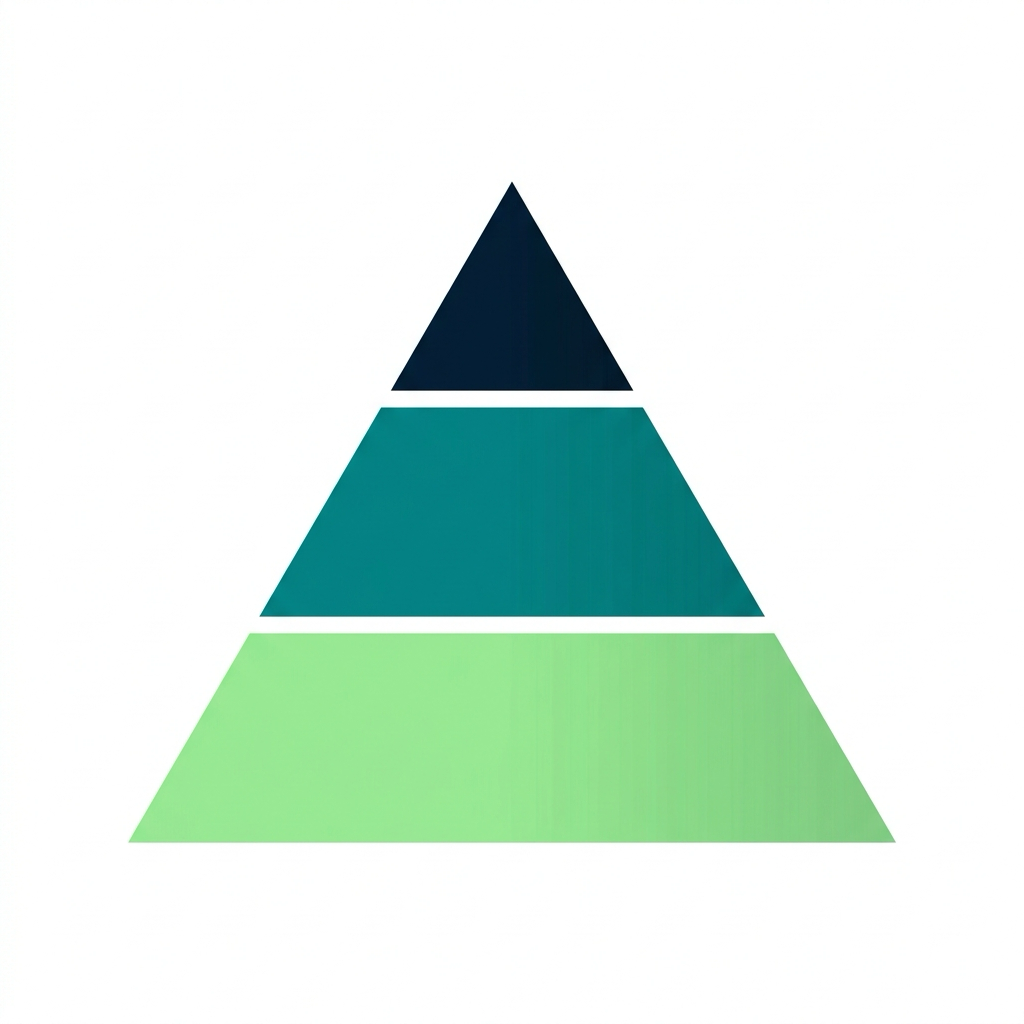
 

좁은 어두운 색 상단, 넓은 청록색 중간, 가장 넓은 초록색 하단으로 구성된 3단 피라미드

병원과 비슷합니다: 접수 → 병동 → 전문의


상단 - 경영진 요약

  • 전체 시스템 상태
  • 주요 비즈니스 지표, SLA, 현재 인시던트

중간 - 서비스 상태

  • 오류율, 지연 시간 백분위수, 처리량

하단 - 세부 진단

  • 추적(Trace), 로그, 리소스 사용률, 종속성 상태
AWS 모니터링 및 문제 해결

4가지 골든 시그널


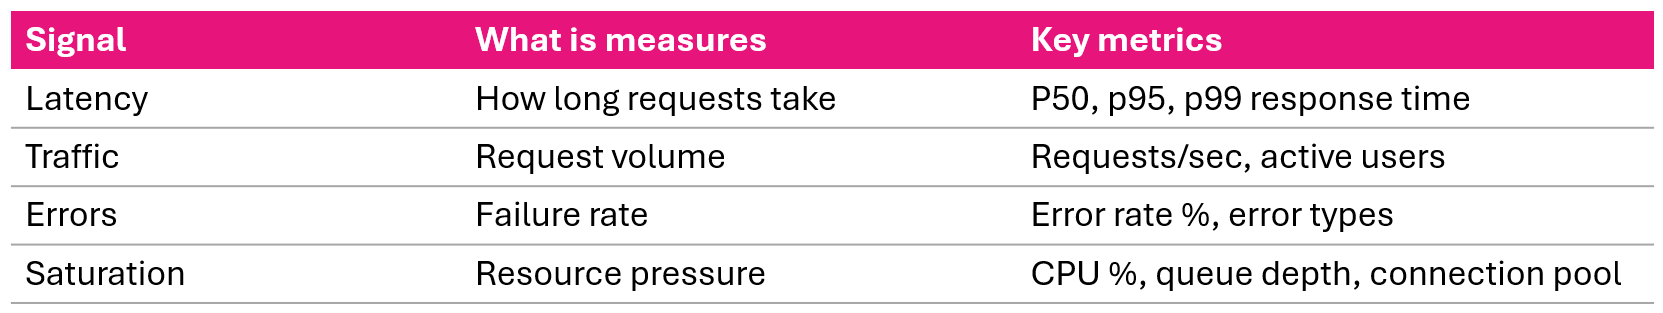
모니터링의 4가지 골든 시그널인 지연 시간, 트래픽, 오류, 포화도

이 네 가지만 다루면 발생할 수 있는 대부분의 문제를 파악할 수 있습니다.

AWS 모니터링 및 문제 해결

RED 방법


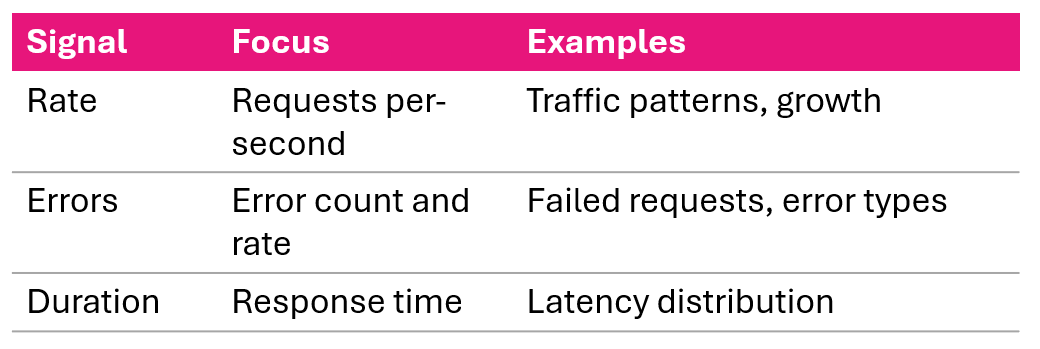
요청 기반 서비스를 위한 RED:

요청 기반 서비스의 비율(Rate), 오류(Errors), 지속 시간(Duration)을 보여주는 RED 방법 패턴


골든 시그널과의 관계:

  • RED는 4가지 골든 시그널 중 핵심 요소만 모은 것입니다
  • 사용자 요청을 처리하는 서비스를 위해 설계되었습니다
  • 인프라 모니터링을 위해 포화도(4번째 골든 시그널)가 추가됩니다

RED를 출발점으로 삼고, 더 깊은 진단을 위해 포화도를 추가하세요.

AWS 모니터링 및 문제 해결

세 가지 데이터 소스


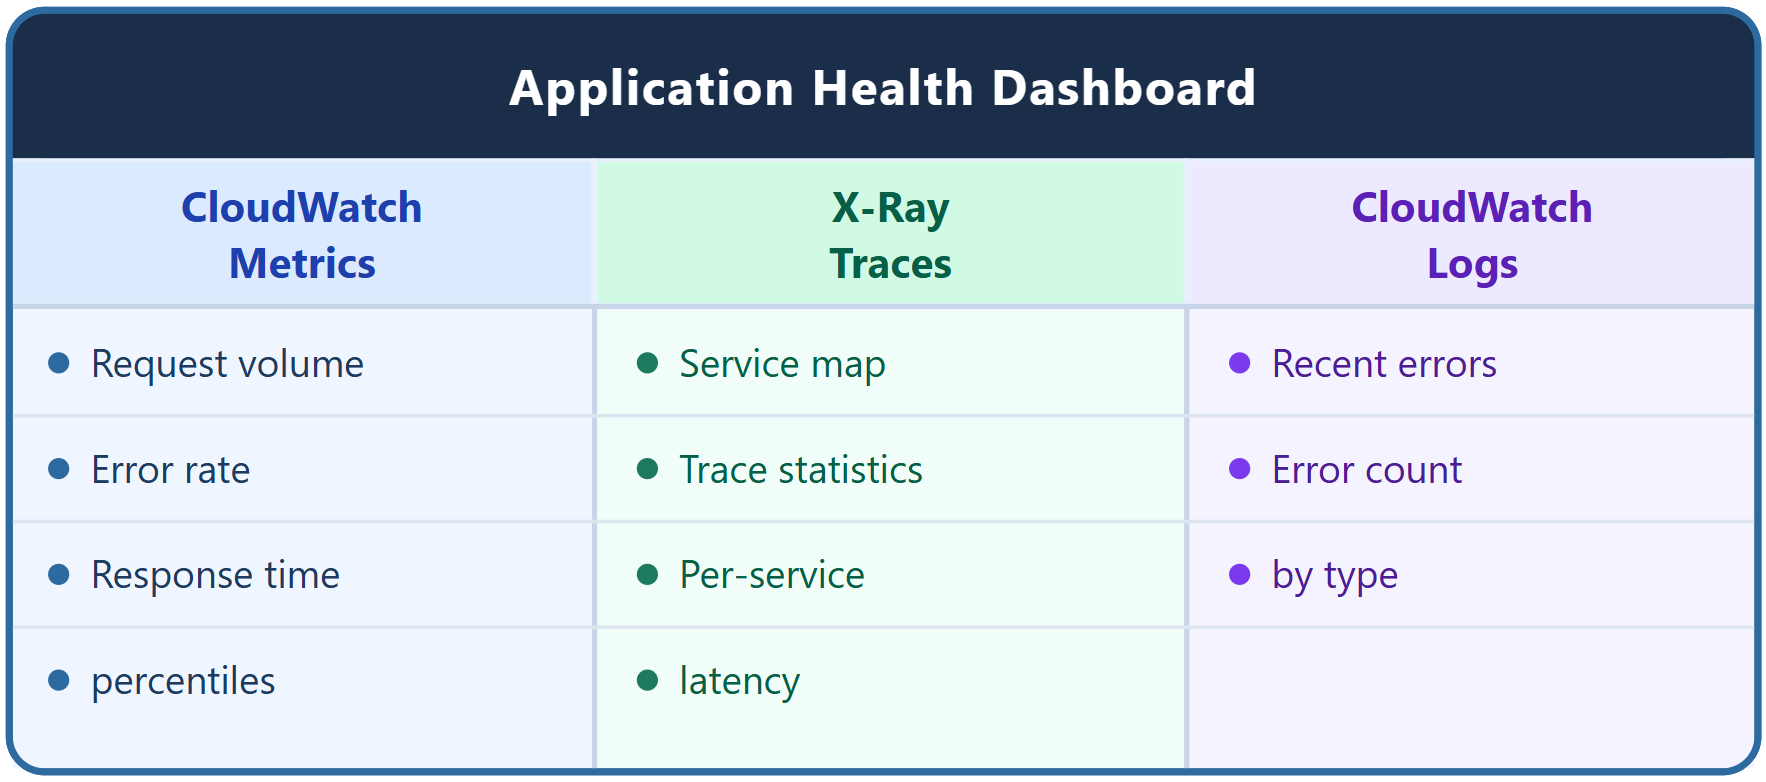
CloudWatch 지표, X-Ray 추적, CloudWatch Logs라는 세 가지 대시보드 데이터 소스를 보여주는 다이어그램

AWS 모니터링 및 문제 해결

CloudWatch 지표 위젯

요청량:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

오류율(메트릭 수식):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

응답 시간 백분위수:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • ALB RequestCount에서 가져온 요청량
  • 오류율은 메트릭 수식을 사용합니다 - errors / invocations x 100
  • p50, p95, p99 백분위수로 나타낸 응답 시간
AWS 모니터링 및 문제 해결

X-Ray 및 로그 위젯


X-Ray 위젯:

  • 서비스 맵 - 상태 지표가 표시된 애플리케이션 토폴로지
  • 추적 통계 - 평균 응답 시간, 오류율, 결함률
  • 서비스 지연 시간 - 서비스별 응답 시간 비교


CloudWatch Logs 위젯:

최근 오류 쿼리:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

유형별 오류 수:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
AWS 모니터링 및 문제 해결

완성된 대시보드 레이아웃


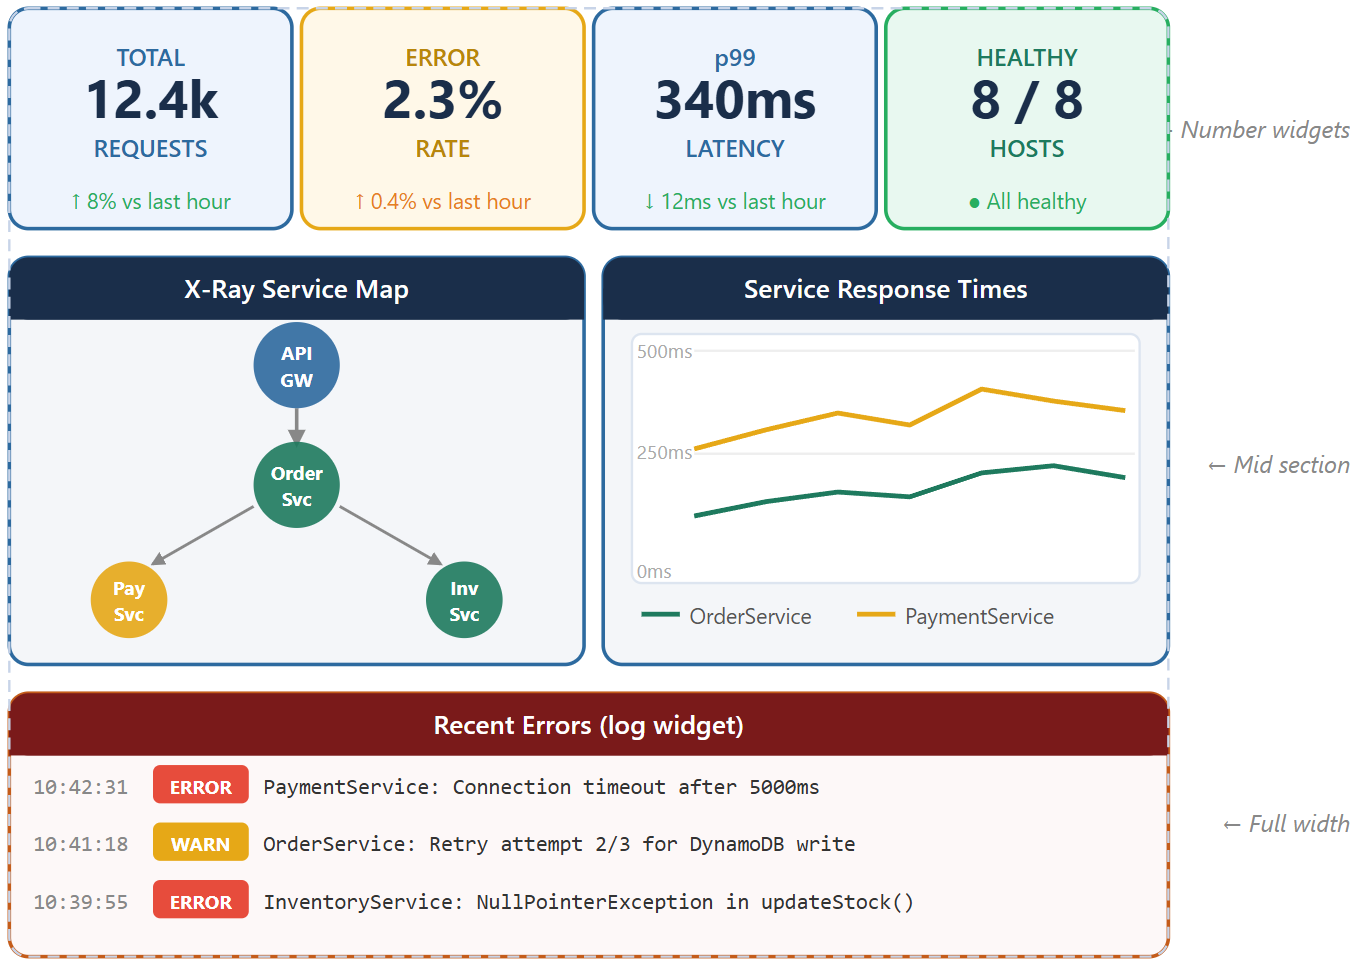
상단에 요약 위젯, 중간에 서비스 맵, 하단에 오류 로그가 배치된 상태 대시보드 레이아웃

AWS 모니터링 및 문제 해결

인시던트 문제 해결 워크플로


색상별 우선순위 구역과 청진기가 있는 응급실 중증도 분류 클립보드

응급실 중증도 분류와 비슷합니다: 안정화 → 진단 → 치료 → 확인

  1. 식별 - 빨간색/노란색 지표, 오류 급증
  2. 범위 파악 - 어떤 서비스인가? 언제부터인가? 악화되고 있는가?
  3. 연관 분석 - 오류 + 지연 시간, 트래픽 + 리소스
  4. 세부 조사 - 서비스 맵 → 추적 → 로그
  5. 근본 원인 파악 - 종속성, DB, 메모리, 설정
  6. 조치 - 서킷 브레이커, 확장, 롤백, 페일오버
  7. 확인 - 오류율 정상화, 맵 녹색, 알람 해제
AWS 모니터링 및 문제 해결

시나리오 1: 갑작스러운 트래픽 급증

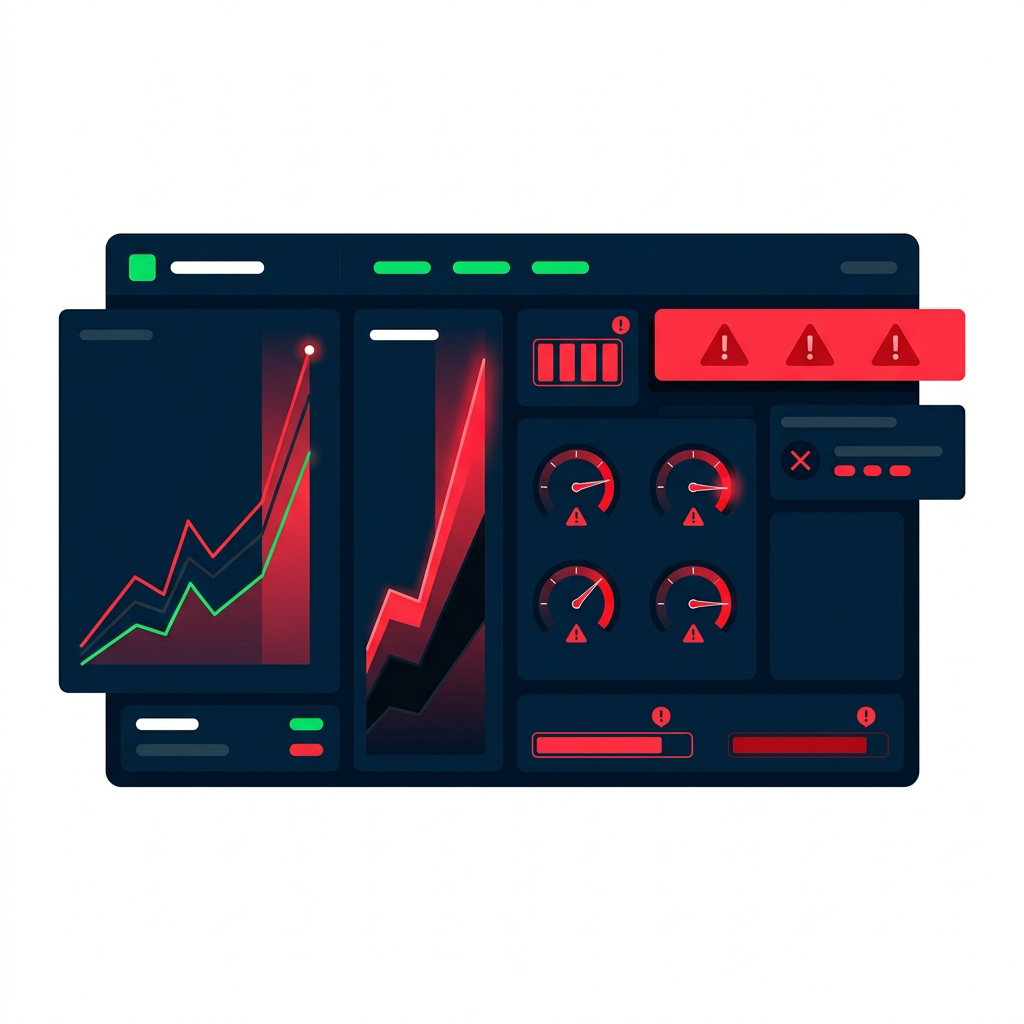
트래픽 급증 중인 모니터링 대시보드: 위로 치솟는 선 그래프, 빨간색 영역에 고정된 게이지, 빨간색 경고 배너

대시보드에서 확인할 수 있는 내용:

  • 요청량이 평소의 10배
  • 오류율 25%
  • 지연 시간 3000ms
  • CPU 95%

분석: 트래픽 급증으로 리소스가 과부하 상태입니다


조치 사항:

  • 즉시 스케일 아웃
  • 오토 스케일링 활성화
  • 속도 제한(Rate Limiting) 구현
  • 백엔드 부담을 줄이기 위한 캐싱 추가
AWS 모니터링 및 문제 해결

시나리오 2: 데이터베이스 병목 현상

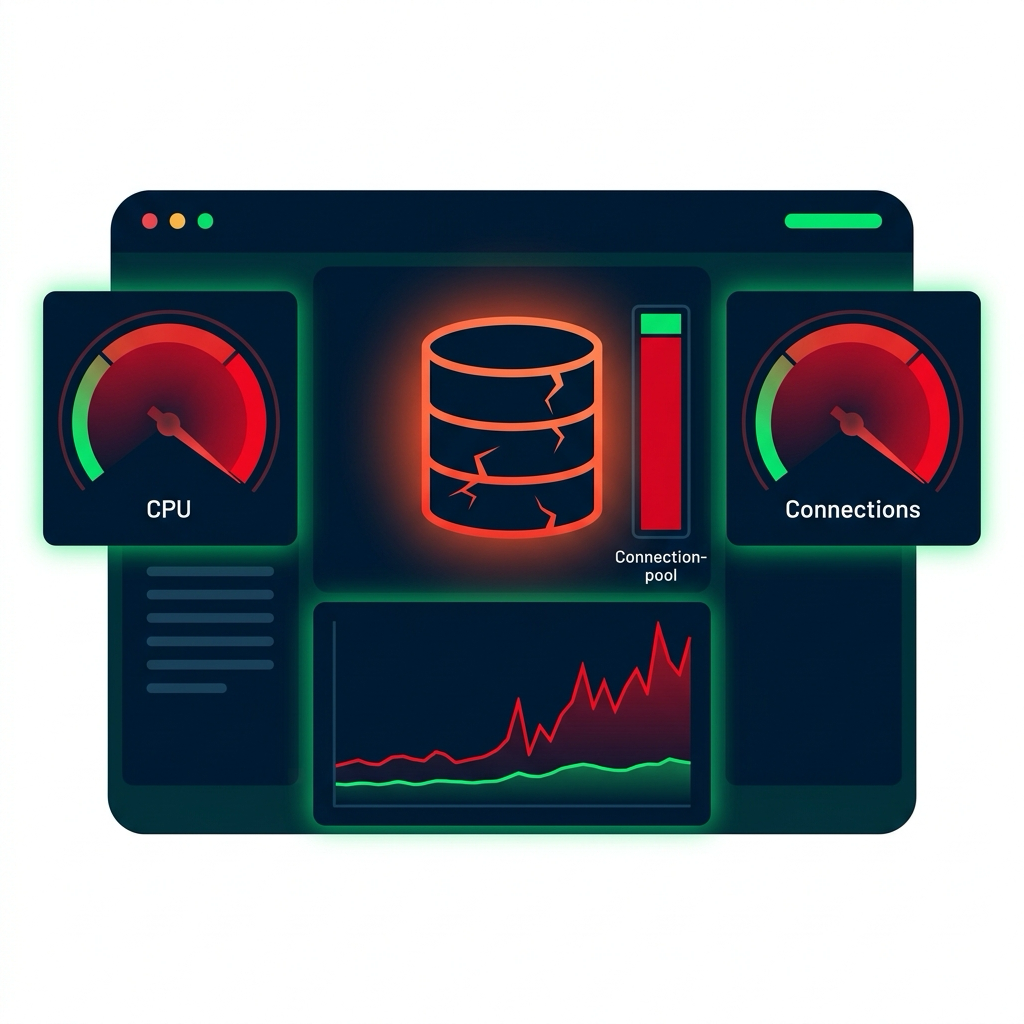
데이터베이스 병목 현상을 보여주는 모니터링 대시보드: 금이 간 빨간색 데이터베이스 아이콘, 최대치로 빨간색인 CPU 및 연결 게이지, 급격히 상승하는 쿼리 지연 시간 그래프, 거의 가득 찬 연결 풀 막대

대시보드에서 확인할 수 있는 내용:

  • DB CPU 95%
  • DB 연결 95/100
  • 쿼리 지연 시간 5000ms
  • 애플리케이션 지연 시간 5500ms

분석: 데이터베이스가 병목 지점이며, 느린 쿼리가 연결 풀을 고갈시키고 있습니다


조치 사항:

  • 로그에서 느린 쿼리 식별
  • 인덱스 추가, 쿼리 최적화
  • 연결 풀 크기 늘리기
  • 데이터베이스 확장
AWS 모니터링 및 문제 해결

시나리오 3: 연쇄 장애


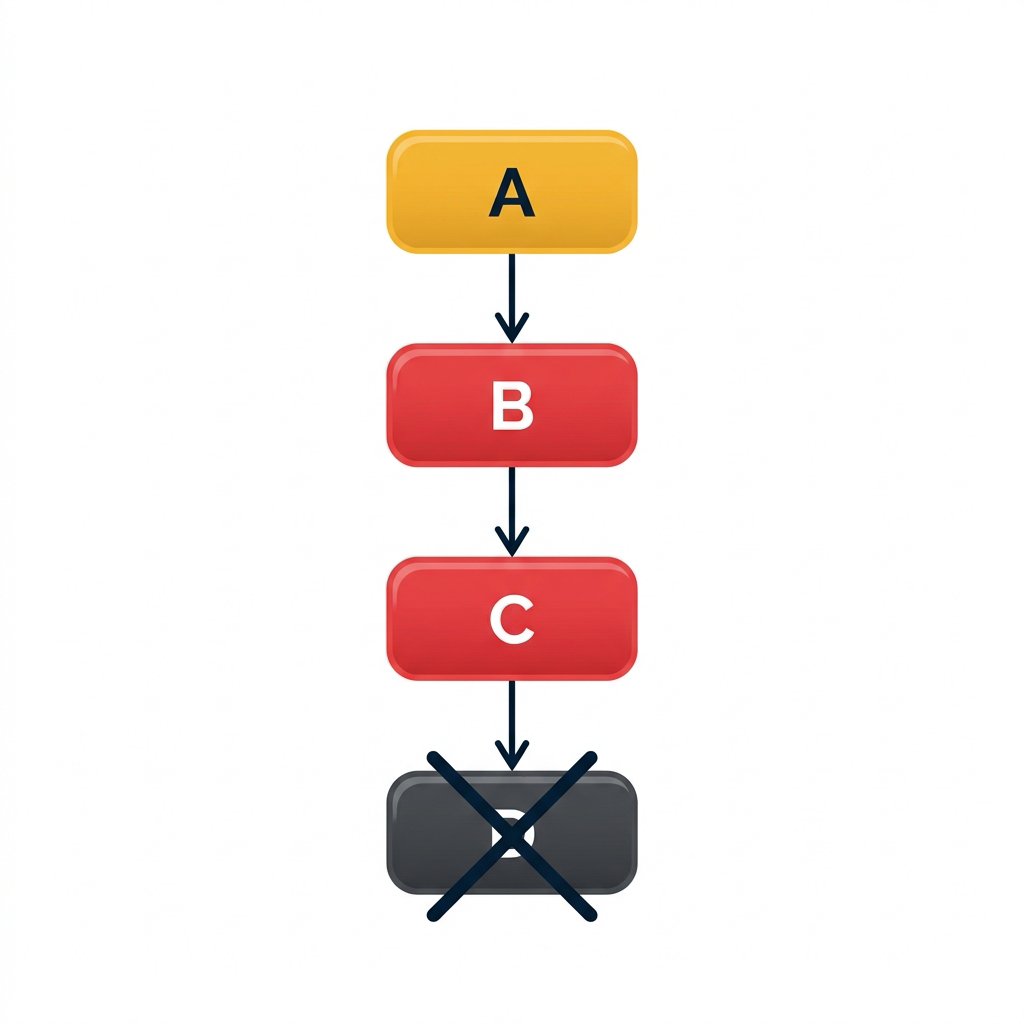
서비스 맵에서 확인할 수 있는 내용:

서비스 맵 연쇄 장애: 클라이언트 오류가 있는 주황색 노드 A, 서버 오류가 있는 빨간색 노드 B와 C, 완전히 다운된 어두운 노드 D, 체인을 따라 흐르는 화살표


분석:

Service A의 작은 문제가 종속성 체인을 따라 연쇄적으로 확산되었습니다

조치 사항:

  • 연쇄 장애를 막기 위한 서킷 브레이커
  • 각 서비스 단계에서의 타임아웃
  • 실패한 종속성을 위한 대체(Fallback) 메커니즘
  • Service A의 근본 원인 해결
AWS 모니터링 및 문제 해결

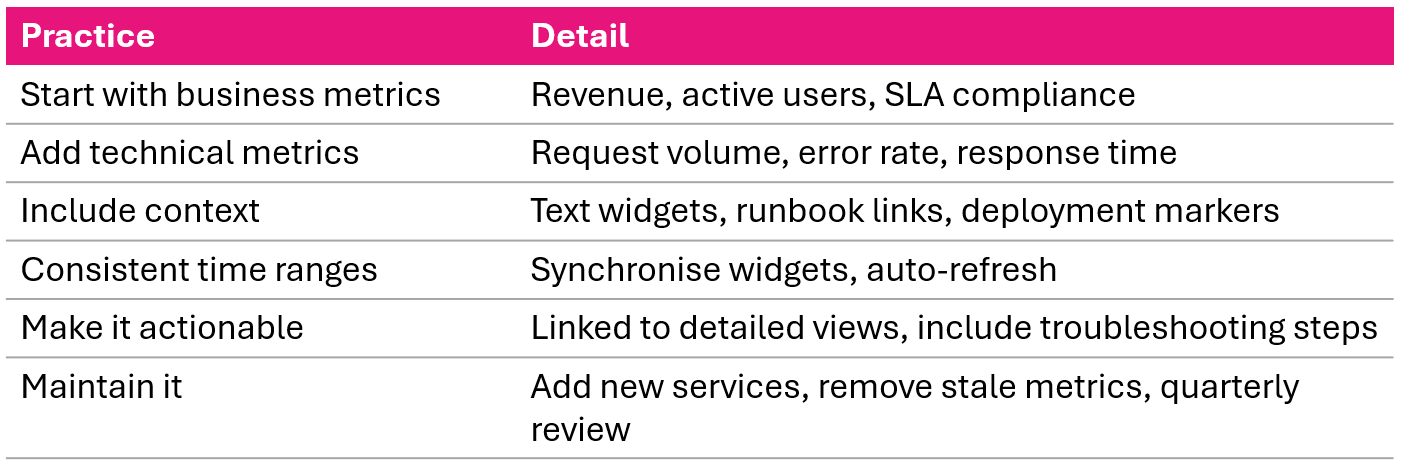
대시보드 모범 사례


애플리케이션 상태 모니터링을 위한 6가지 권장 대시보드 모범 사례

AWS 모니터링 및 문제 해결

영상 요약 및 강의 수료

  • 정보의 계층 구조와 4가지 골든 시그널을 활용한 설계
  • CloudWatch 지표, X-Ray 추적, 로그를 하나의 화면에 결합
  • 7단계 인시던트 워크플로: 식별 → 범위 파악 → 연관 분석 → 세부 조사 → 근본 원인 파악 → 조치 → 확인

이제 할 수 있는 것:

  • CloudWatch 지표, 로그, 대시보드로 모니터링하기
  • SNS와 SQS로 알람 및 알림 구성하기
  • X-Ray로 분산 추적 구현하기
  • 운영 우수성을 위한 애플리케이션 상태 대시보드 구축하기
AWS 모니터링 및 문제 해결

애플리케이션 상태 대시보드

AWS 모니터링 및 문제 해결

Preparing Video For Download...