ट्रेस और सर्विस मैप्स का विश्लेषण

Monitoring और Troubleshooting AWS

John Q. Martin

Principal Consultant

सर्विस मैप क्या है?


आपके ट्रेस डेटा से ऑटो-जनरेटेड: कोई मैन्युअल सेटअप नहीं
रेलवे डिपार्चर बोर्ड: सेवाओं की पंक्तियाँ, स्टेटस लाइट्स—हरा समय पर, एम्बर विलंबित, लाल रुका हुआ

एक नज़र में: green = समय पर · amber = विलंबित · red = रुका हुआ


ऐसे एक्सेस करें:

  • X-Ray कंसोल → Service map
  • filters लगाएँ
  • किसी node पर क्लिक करें → विस्तृत ब्रेकडाउन
Monitoring और Troubleshooting AWS

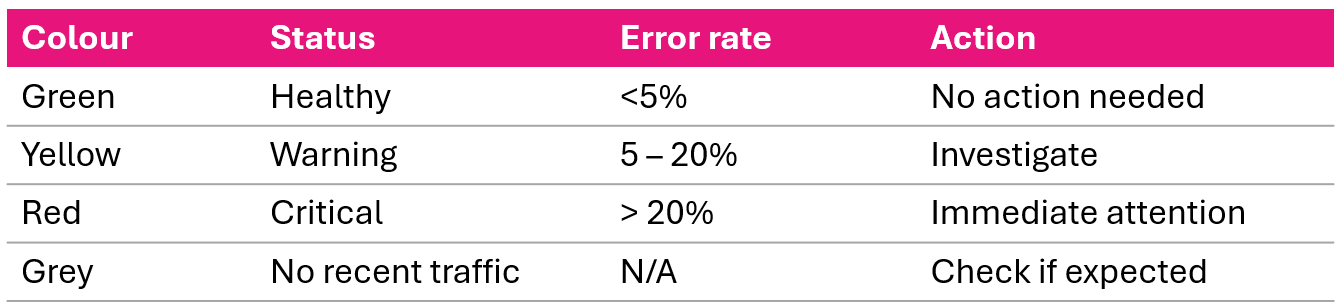
सर्विस मैप का रंग कोडिंग


सर्विस मैप कलर कोड कुंजी: हरा सफल कॉल, पीला क्लाइंट एरर, लाल सर्वर फॉल्ट, बैंगनी थ्रॉटलिंग, धूसर कोई ट्रैफिक नहीं

जब आप सर्विस मैप खोलें, तो सीधे उस पर जाएँ जो हरा नहीं है।

किसी भी node पर क्लिक करें: response time का वितरण, HTTP स्टेटस ब्रेकडाउन, एरर प्रकार।

Monitoring और Troubleshooting AWS

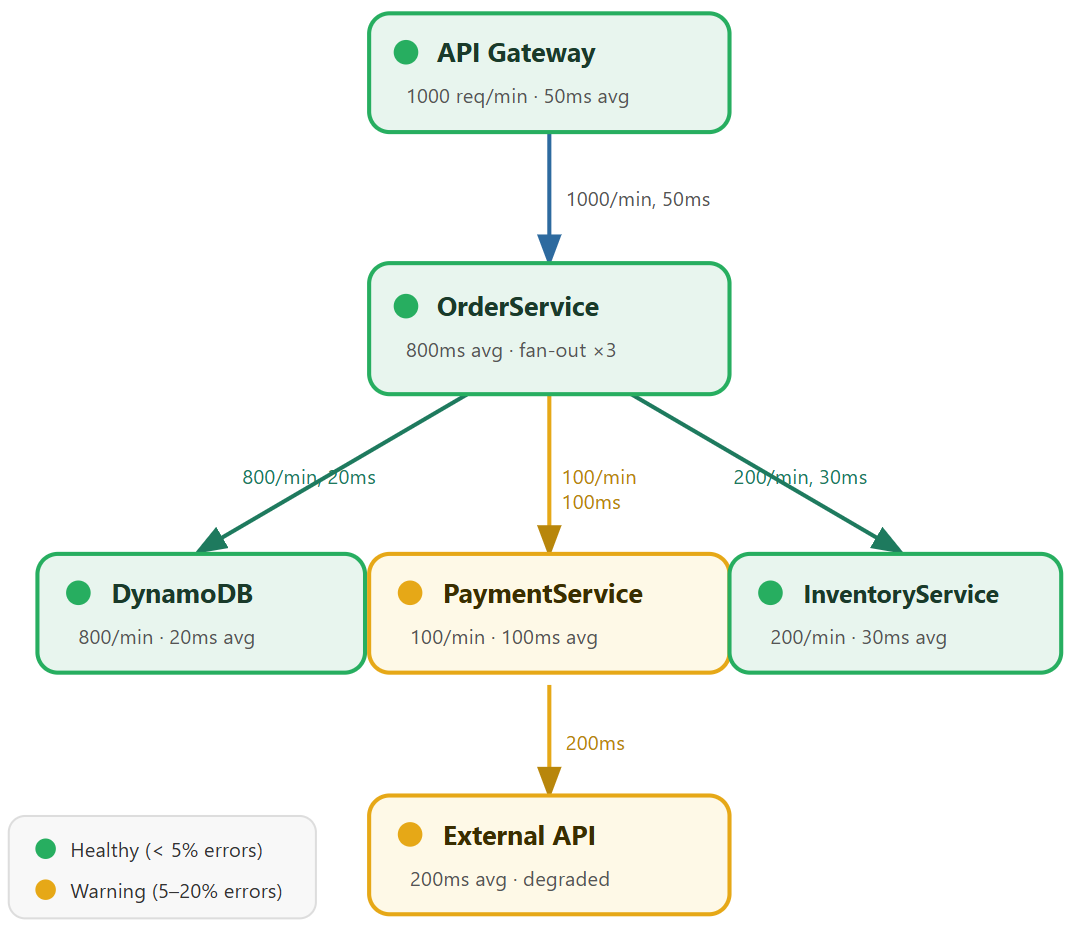
सर्विस मैप पढ़ना


सर्विस मैप: API Gateway और OrderService से DynamoDB Inventory तक फैन-आउट, और पीला Payment सेवा

Monitoring और Troubleshooting AWS

क्रिटिकल पाथ विश्लेषण


Critical path = सबसे लंबी सर्विस कॉल चेन

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Total: 400ms

External API = कुल latency का 50%


इससे क्या करें:

  • External API आपका optimization target है
  • विकल्प: caching जोड़ें, timeout + fallback लागू करें, SLAs पर बातचीत करें

वैकल्पिक पाथ की तुलना करें:

OrderService -> DynamoDB
Total: 120ms (fast)
Monitoring और Troubleshooting AWS

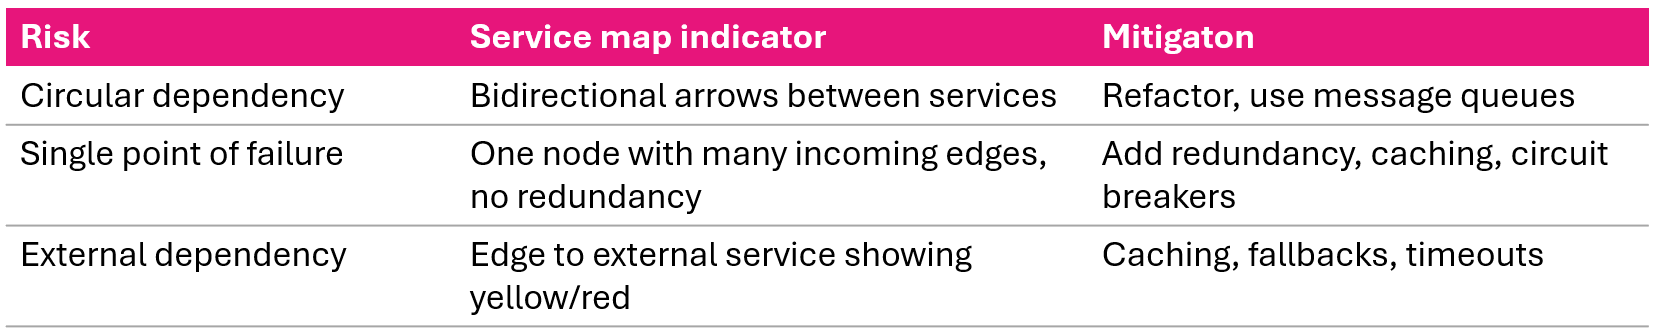
डिपेंडेंसी जोखिम


सर्विस मैप डिपेंडेंसी जोखिम: सर्कुलर डिपेंडेंसी, सिंगल प्वाइंट ऑफ फेल्योर, और जोखिम भरी बाहरी डिपेंडेंसी

Monitoring और Troubleshooting AWS

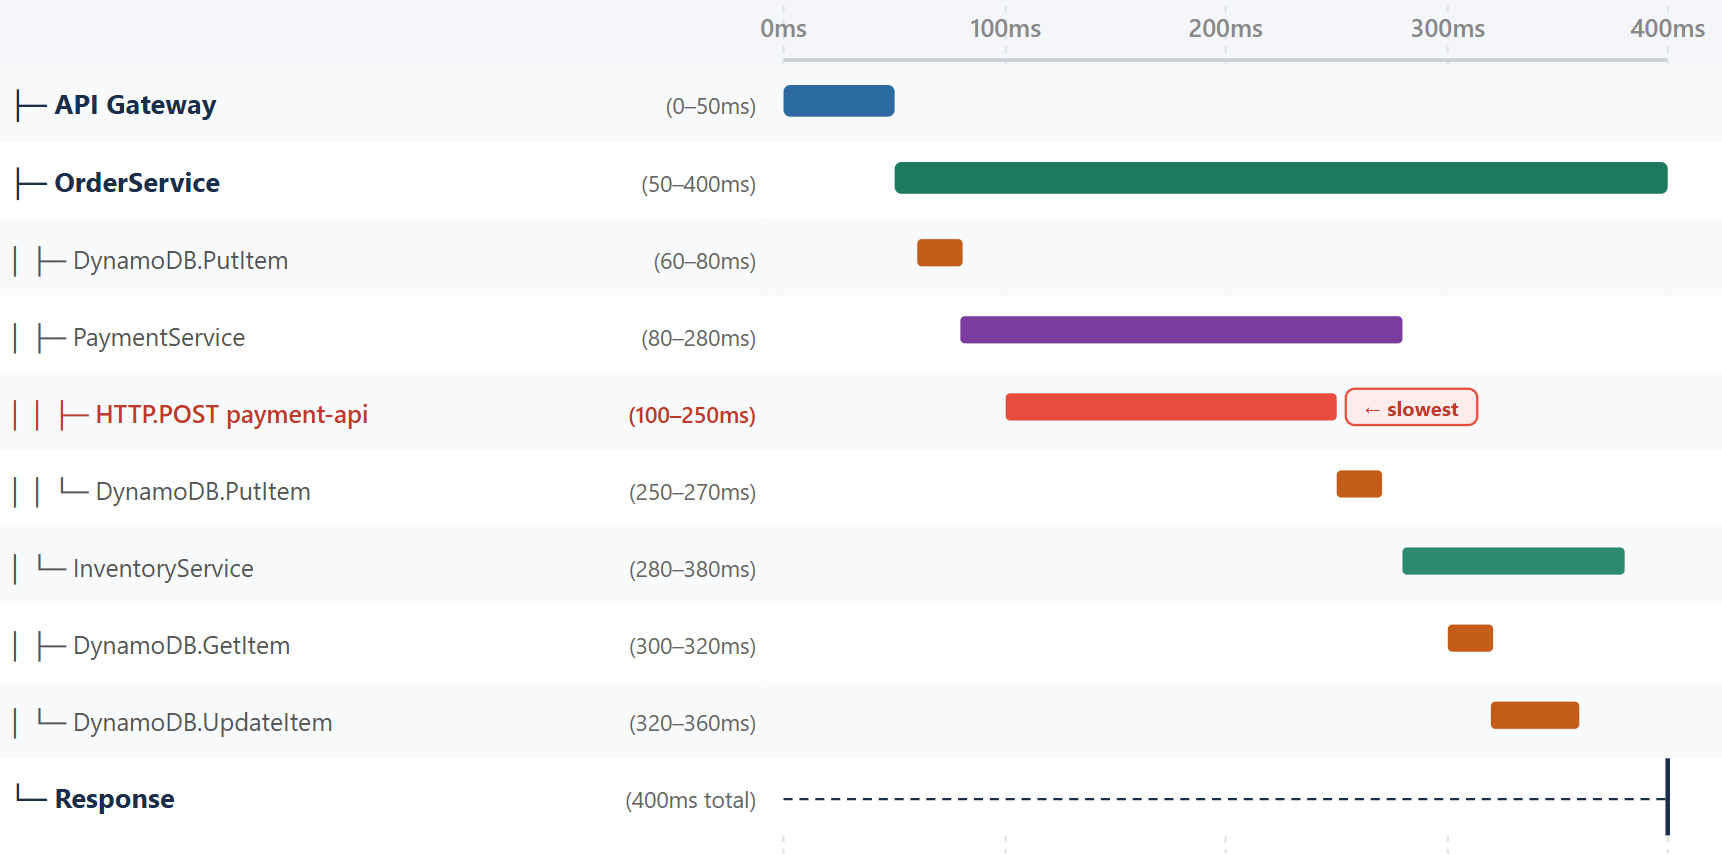
ट्रेस टाइमलाइन समझना


ट्रेस टाइमलाइन: समय-अक्ष पर सबसेगमेंट्स, payment-api कॉल सबसे लंबा ऑपरेशन


  • क्षैतिज अक्ष समय: ऑपरेशंस कब शुरू हुए और कितने समय चले
  • ऊर्ध्वाधर अक्ष सर्विस पदानुक्रम: subsegments पैरेंट्स के तहत इंडेंटेड
  • payment-api को HTTP.POST (100-250ms) = एकल सबसे लंबा ऑपरेशन
Monitoring और Troubleshooting AWS

पैटर्न 1: सीक्वेंशियल बॉटलनेक्स


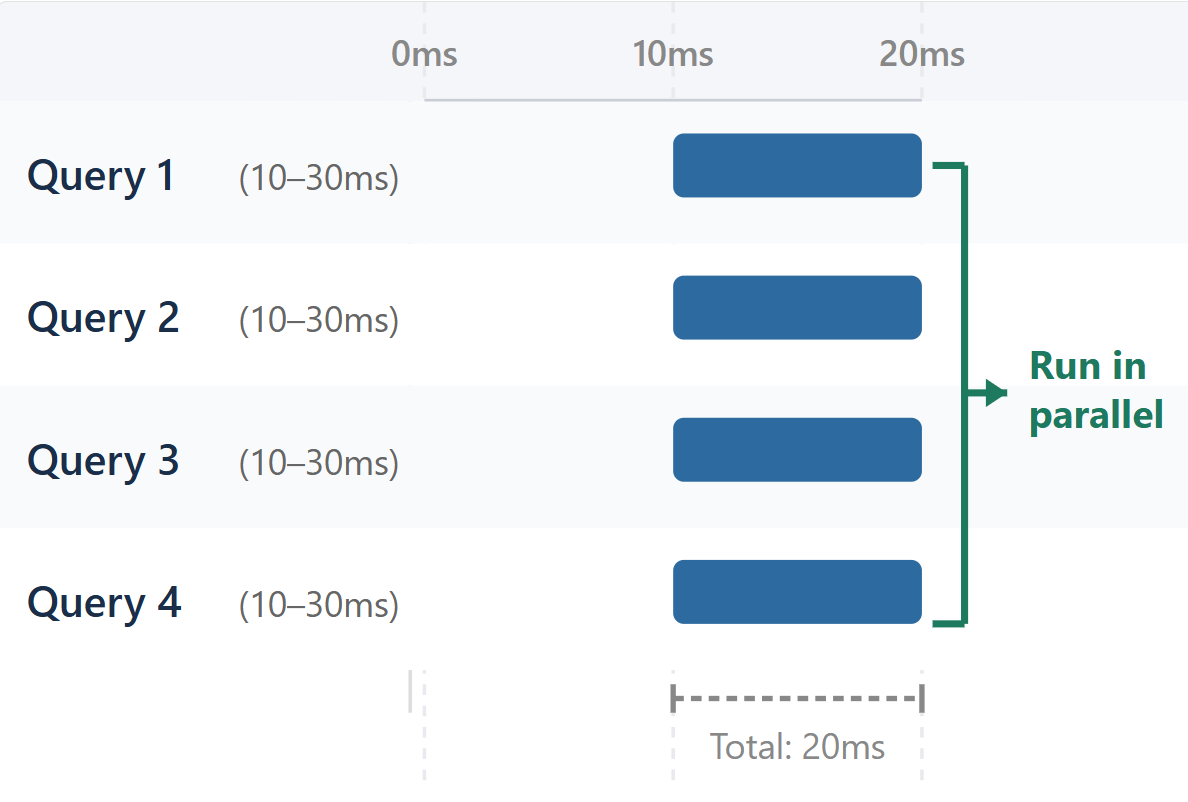
पहले (सीक्वेंशियल - 80ms):

Query 1 (10-30ms)
         -> Query 2 (30-50ms)
                  -> Query 3 (50-70ms)
                           -> Query 4 (70-90ms)


बाद में (पैरलल - 20ms):

चार क्वेरी पैरलल चलती हुई, ओवरलैप कर 20ms में पूरी

Monitoring और Troubleshooting AWS

पैटर्न 2: N+1 क्वेरी और chatty सेवाएँ


N+1 Query समस्या:

Get user list       (10-20ms)
Get user 1 details  (20-30ms)
Get user 2 details  (30-40ms)
... ×100 sequential queries

समाधान: बैच क्वेरी, eager लोडिंग


Chatty सेवाएँ:

  • 1 बैच की बजाय दो सेवाओं के बीच 50 छोटी कॉल्स
  • हर कॉल: कनेक्शन सेटअप + सीरियलाइज़ेशन + राउंड-ट्रिप
  • 50× ओवरहेड

समाधान: बैच रिक्वेस्ट, मैसेज क्यूज़, caching

Monitoring और Troubleshooting AWS

पैटर्न 3: कोल्ड स्टार्ट्स और cascading failures
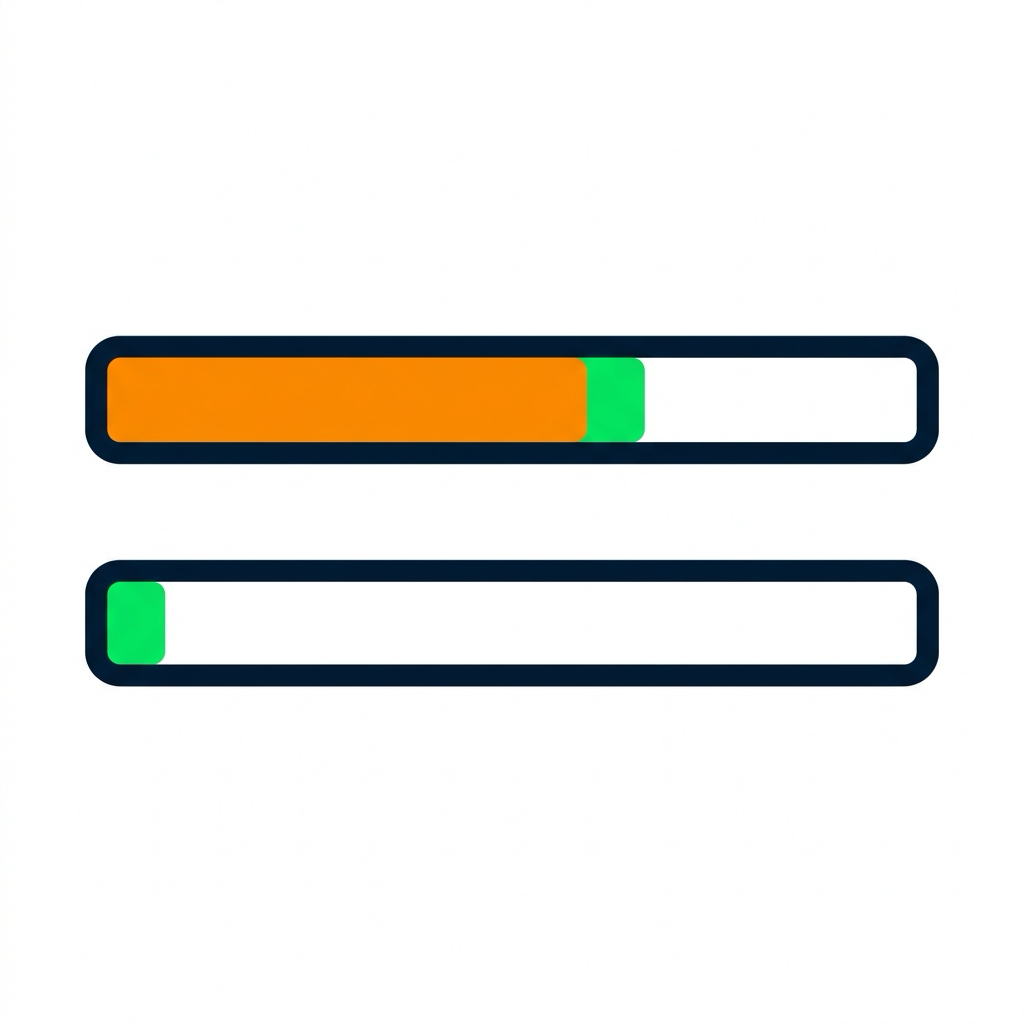
 

दो टाइमलाइन बार: कोल्ड स्टार्ट में बड़ा नारंगी initialization ब्लॉक फिर छोटा हरा हैंडलर; वॉर्म स्टार्ट में सिर्फ छोटा हरा हैंडलर

Lambda Cold Start:

  • Cold: 3000ms (2500ms init + 500ms handler)
  • Warm: 500ms (सिर्फ handler)
  • पहली invocation पर बड़ा init segment दिखता है

समाधान: provisioned concurrency, initialization ऑप्टिमाइज़ करें


Cascading Failure:

Service A [Error]
  -> Service B [Timeout 5s]
    -> Service C [Timeout 5s]
      -> Database [Timeout 5s]

टाइमआउट ब्लॉक्स ट्रेस hierarchy में स्टैक होते दिखेंगे

समाधान: timeouts, circuit breakers, fallbacks

Monitoring और Troubleshooting AWS

annotations के साथ ट्रेसेज़ फ़िल्टर करना
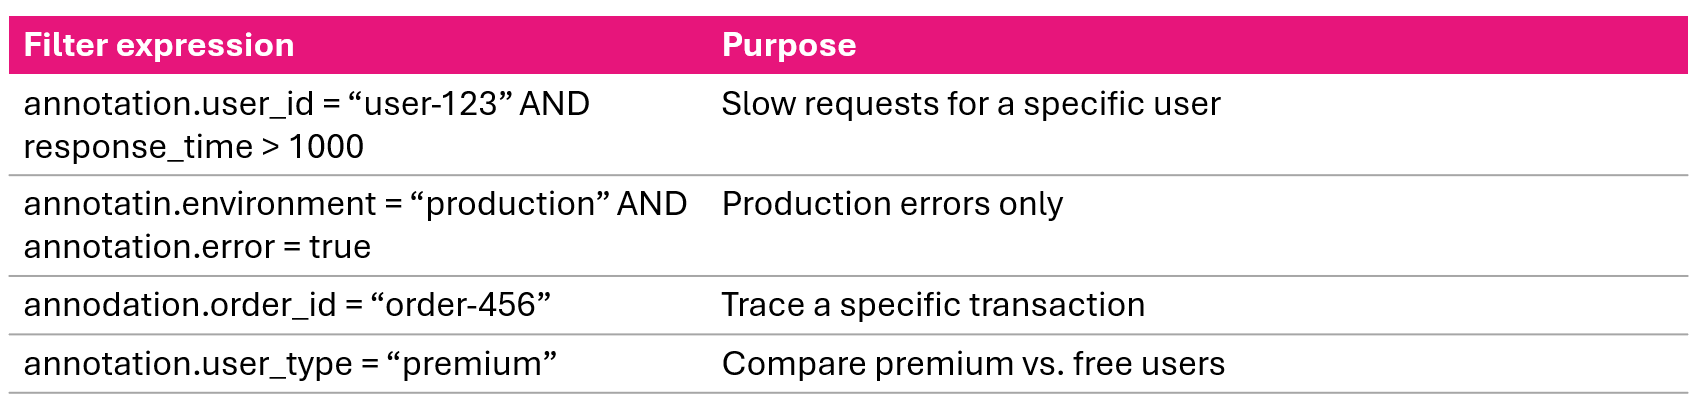
X-Ray कंसोल: annotation key-value जोड़ों से ट्रेसेज़ को फ़िल्टर करना

समूह तुलना करें:

  • प्रीमियम उपयोगकर्ता औसत 200ms बनाम फ्री उपयोगकर्ता औसत 150ms → प्रीमियम फीचर्स से latency बढ़ रही है
  • EU West US East से 3× धीमा → cross-region डेटा एक्सेस समस्या
Monitoring और Troubleshooting AWS

ट्रेस विश्लेषण वर्कफ़्लो


  1. Identify - फ़िल्टर: response_time > 1000ms, duration से sort करें
  2. Analyze - सबसे लंबे ऑपरेशंस, सीक्वेंशियल बॉटलनेक्स, पैरलल अवसर ढूँढें
  3. Annotate - बिज़नेस संदर्भ के annotations देखें: user ID, order ID, environment
  4. Review - मेटाडेटा जाँचें: रिक्वेस्ट विवरण, एरर मैसेजेस
  5. Correlate - CloudWatch Logs से क्रॉस-रेफरेंस करें
  6. Diagnose - मूल कारण: slow query, timeout, algorithm, resource exhaustion
  7. Fix - कोड ऑप्टिमाइज़ करें, caching जोड़ें, पैरललाइज़ करें, स्केल करें
  8. Verify - पहले/बाद के ट्रेसेज़ तुलना करें, latency और error rates मॉनिटर करें
Monitoring और Troubleshooting AWS

X-Ray डेटा से अलर्ट बनाना


# High latency अलार्म
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# High error count अलार्म
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
Monitoring और Troubleshooting AWS

वीडियो सारांश


  • Service maps - ऑटो-जनरेटेड आर्किटेक्चर डायग्राम: nodes (services), edges (connections), रंग-कोडेड हेल्थ
  • Color coding - हरा (success), पीला (4xx), लाल (5xx faults), बैंगनी (429), धूसर (no traffic)
  • Critical path - सबसे लंबी कॉल चेन, आपका optimization target चिन्हित करता है
  • Trace timelines - सीक्वेंशियल बॉटलनेक्स, N+1 क्वेरीज़, कोल्ड स्टार्ट्स, cascading failures दिखाते हैं
  • Annotations - बिज़नेस संदर्भ से ट्रेसेज़ फ़िल्टर/समूहित करें
  • Workflow - आठ चरण: identify → analyze → annotate → review → correlate → diagnose → fix → verify
Monitoring और Troubleshooting AWS

ट्रेस और सर्विस मैप्स का विश्लेषण

Monitoring और Troubleshooting AWS

Preparing Video For Download...