PySpark 入門
PySpark 入門

Benjamin Schmidt
Data Engineer
認識你的講師
- 近 10 年 PySpark 資料實務經驗
使用 PySpark 做機器學習、ETL 等多種任務
熱衷教學,帶你上手新工具!
-
什麼是 PySpark?
分散式資料處理:可在叢集上處理大型資料集
支援多種格式:CSV、Parquet、JSON
整合 SQL,可用 Python 與 SQL 查詢資料
為大規模運算最佳化、速度快
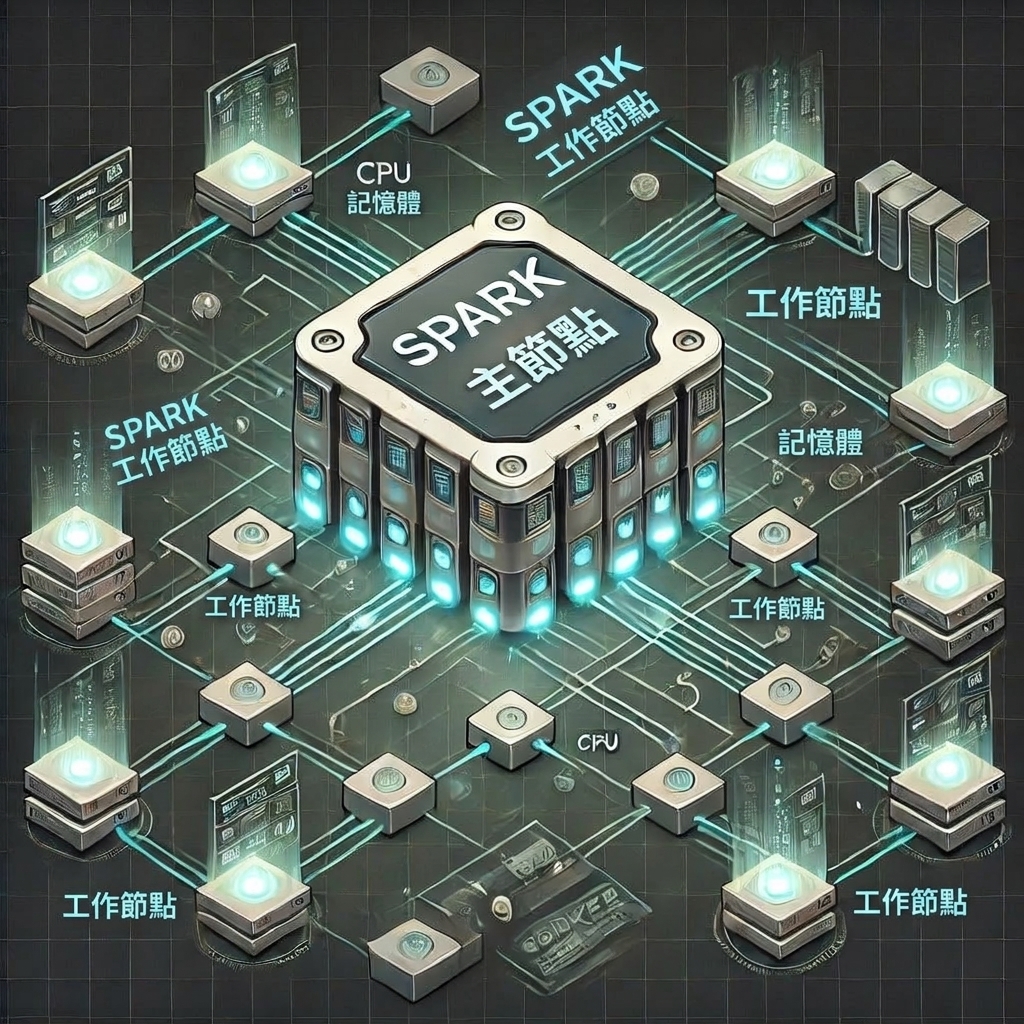
Spark 叢集
PySpark 入門
Benjamin Schmidt
Data Engineer
使用 PySpark 做機器學習、ETL 等多種任務
熱衷教學,帶你上手新工具!
-
分散式資料處理:可在叢集上處理大型資料集
支援多種格式:CSV、Parquet、JSON
整合 SQL,可用 Python 與 SQL 查詢資料
為大規模運算最佳化、速度快

