比較字串

用 Python 進行資料清理

Adel Nehme

VP of AI Curriculum, DataCamp

本章重點


第 4 章-記錄連結(Record linkage)

用 Python 進行資料清理

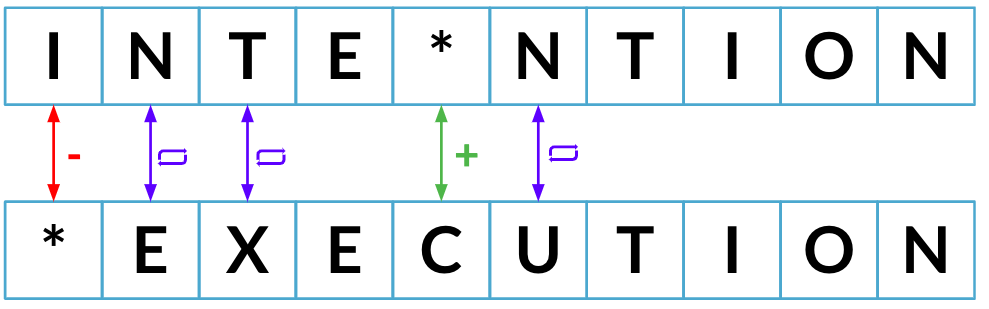
最小編輯距離

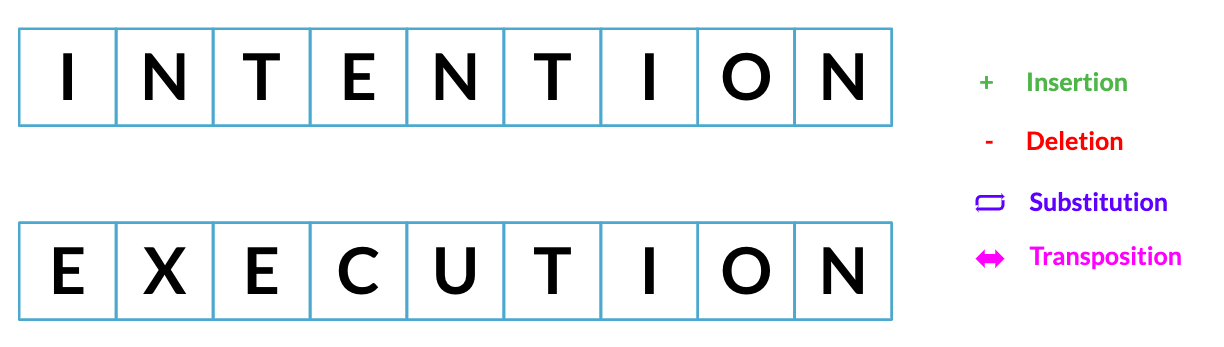
將一個字串轉為另一個字串所需的最少步驟

用 Python 進行資料清理

最小編輯距離

將一個字串轉為另一個字串所需的最少步驟

用 Python 進行資料清理

最小編輯距離

用 Python 進行資料清理

最小編輯距離

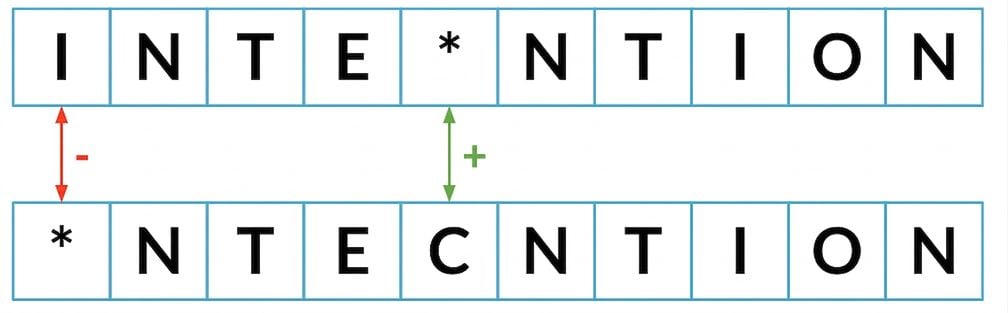
目前的最小編輯距離:2

用 Python 進行資料清理

最小編輯距離

最小編輯距離:5

用 Python 進行資料清理

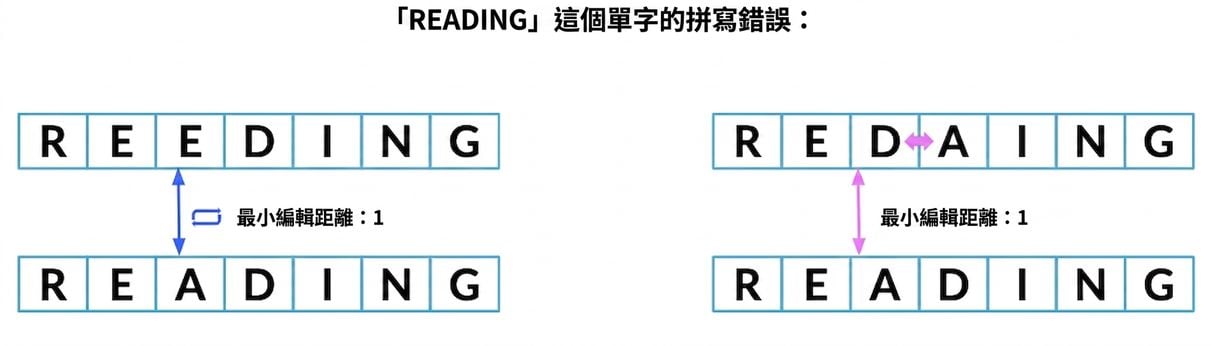
最小編輯距離


用 Python 進行資料清理

最小編輯距離的演算法

演算法 操作
Damerau-Levenshtein 插入、替換、刪除、換位
Levenshtein 插入、替換、刪除
Hamming 只有替換
Jaro distance 只有換位
... ...


可用套件:nltkthefuzztextdistance..

用 Python 進行資料清理

最小編輯距離的演算法

演算法 操作
Damerau-Levenshtein 插入、替換、刪除、換位
Levenshtein _插入_、_替換_、_刪除_
Hamming 只有替換
Jaro distance 只有換位
... ...


可用套件:thefuzz

用 Python 進行資料清理

簡單的字串比較

# 讓我們比較兩個字串
from thefuzz import fuzz

# 比較 reeding 與 reading fuzz.WRatio('Reeding', 'Reading')
86
用 Python 進行資料清理

局部字串與不同排序

# 局部字串比較
fuzz.WRatio('Houston Rockets', 'Rockets')
90
# 不同順序的局部字串比較
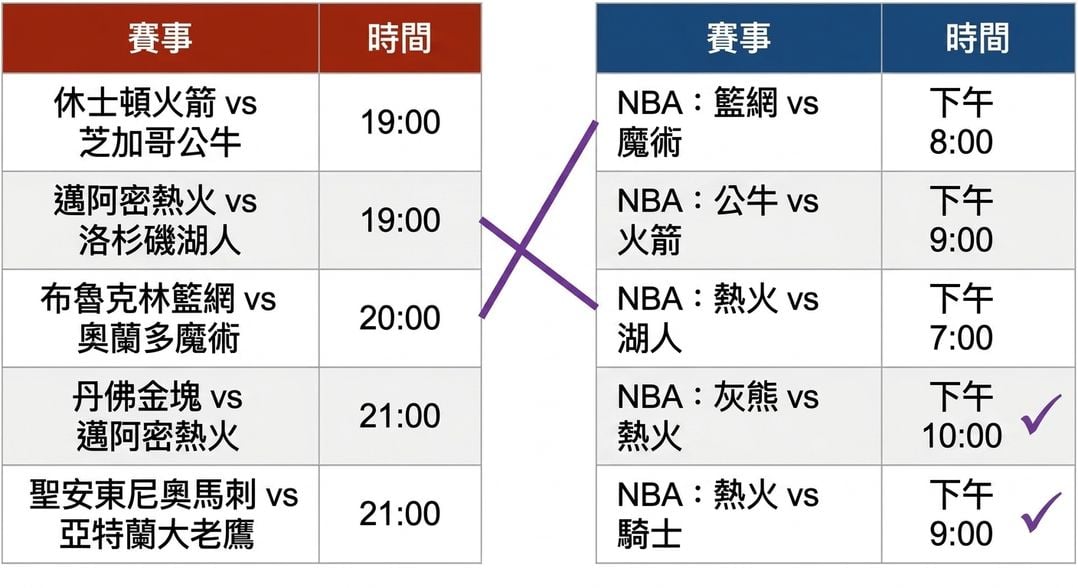
fuzz.WRatio('Houston Rockets vs Los Angeles Lakers', 'Lakers vs Rockets')
86
用 Python 進行資料清理

與陣列比對

# 匯入 process
from thefuzz import process

# 定義字串與可能比對的陣列
string = "Houston Rockets vs Los Angeles Lakers"
choices = pd.Series(['Rockets vs Lakers', 'Lakers vs Rockets', 
                     'Houson vs Los Angeles', 'Heat vs Bulls'])

process.extract(string, choices, limit = 2)
[('Rockets vs Lakers', 86, 0), ('Lakers vs Rockets', 86, 1)]
用 Python 進行資料清理

用字串相似度合併類別

第 2 章

使用 .replace()"eur" 合併為 "Europe"


如果變形太多怎麼辦?

"EU""eur""Europ""Europa""Erope""Evropa"...


                                                                                                字串相似度!

用 Python 進行資料清理

用字串比對合併類別

print(survey['state'].unique())
id          state
0      California
1            Cali
2      Calefornia
3      Calefornie
4      Californie
5       Calfornia
6      Calefernia
7        New York
8   New York City
...
categories
  state
0 California
1 New York
用 Python 進行資料清理

合併所有州名

# 對每個正確的類別
for state in categories['state']:

# 在有錯字的州名中找潛在相符 matches = process.extract(state, survey['state'], limit = survey.shape[0])
# 逐一檢查潛在相符 for potential_match in matches: # 若相似度高 if potential_match[1] >= 80:
# 用正確類別取代錯字 survey.loc[survey['state'] == potential_match[0], 'state'] = state
用 Python 進行資料清理

記錄連結(Record linkage)

record linkage

用 Python 進行資料清理

一起來練習吧!

用 Python 進行資料清理

Preparing Video For Download...