唯一性限制

用 Python 進行資料清理

Adel Nehme

VP of AI Curriculum, DataCamp

什麼是重複值?

所有欄位皆相同

first_name last_name address height weight
Justin Saddlemyer Boulevard du Jardin Botanique 3, Bruxelles 193 cm 87 kg
用 Python 進行資料清理

什麼是重複值?

大多數欄位相同

first_name last_name address height weight
Justin Saddlemyer Boulevard du Jardin Botanique 3, Bruxelles 193 cm 87 kg
Justin Saddlemyer Boulevard du Jardin Botanique 3, Bruxelles 194 cm 87 kg
用 Python 進行資料清理

為何會出現?

duplicate_1

用 Python 進行資料清理

為何會出現?

duplicate_2

用 Python 進行資料清理

為何會出現?

duplicate_3

用 Python 進行資料清理

如何找出重複值?

# Print the header
height_weight.head()
  first_name last_name                       address  height  weight
0       Lane     Reese              534-1559 Nam St.     181      64
1       Ivor    Pierce             102-3364 Non Road     168      66
2      Roary    Gibson   P.O. Box 344, 7785 Nisi Ave     191      99
3    Shannon    Little  691-2550 Consectetuer Street     185      65
4      Abdul       Fry                4565 Risus St.     169      65
用 Python 進行資料清理

如何找出重複值?

# Get duplicates across all columns
duplicates = height_weight.duplicated()
print(duplicates)
1       False
...     ....
22      True
23      False
...     ...
用 Python 進行資料清理

如何找出重複值?

# Get duplicate rows
duplicates = height_weight.duplicated()
height_weight[duplicates]
    first_name last_name                               address  height  weight
100       Mary     Colon                           4674 Ut Rd.     179      75
101       Ivor    Pierce                     102-3364 Non Road     168      88
102       Cole    Palmer                       8366 At, Street     178      91
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
用 Python 進行資料清理

如何找出重複列?

.duplicated() 方法

subset:要檢查重複的欄位名稱清單。

keep:保留重複中的「第一個」('first')、 「最後一個」('last')或「全部」(False)。

# Column names to check for duplication
column_names = ['first_name','last_name','address']
duplicates = height_weight.duplicated(subset = column_names, keep = False)
用 Python 進行資料清理

如何找出重複列?

# Output duplicate values
height_weight[duplicates]
    first_name last_name                               address  height  weight
1         Ivor    Pierce                     102-3364 Non Road     168      66
22        Cole    Palmer                       8366 At, Street     178      91
28     Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     195      83
37        Mary     Colon                           4674 Ut Rd.     179      75
100       Mary     Colon                           4674 Ut Rd.     179      75
101       Ivor    Pierce                     102-3364 Non Road     168      88
102       Cole    Palmer                       8366 At, Street     178      91
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
用 Python 進行資料清理

如何找出重複列?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')
    first_name last_name                               address  height  weight
22        Cole    Palmer                       8366 At, Street     178      91
102       Cole    Palmer                       8366 At, Street     178      91
28     Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     195      83
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
1         Ivor    Pierce                     102-3364 Non Road     168      66
101       Ivor    Pierce                     102-3364 Non Road     168      88
37        Mary     Colon                           4674 Ut Rd.     179      75
100       Mary     Colon                           4674 Ut Rd.     179      75
用 Python 進行資料清理

如何找出重複列?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')
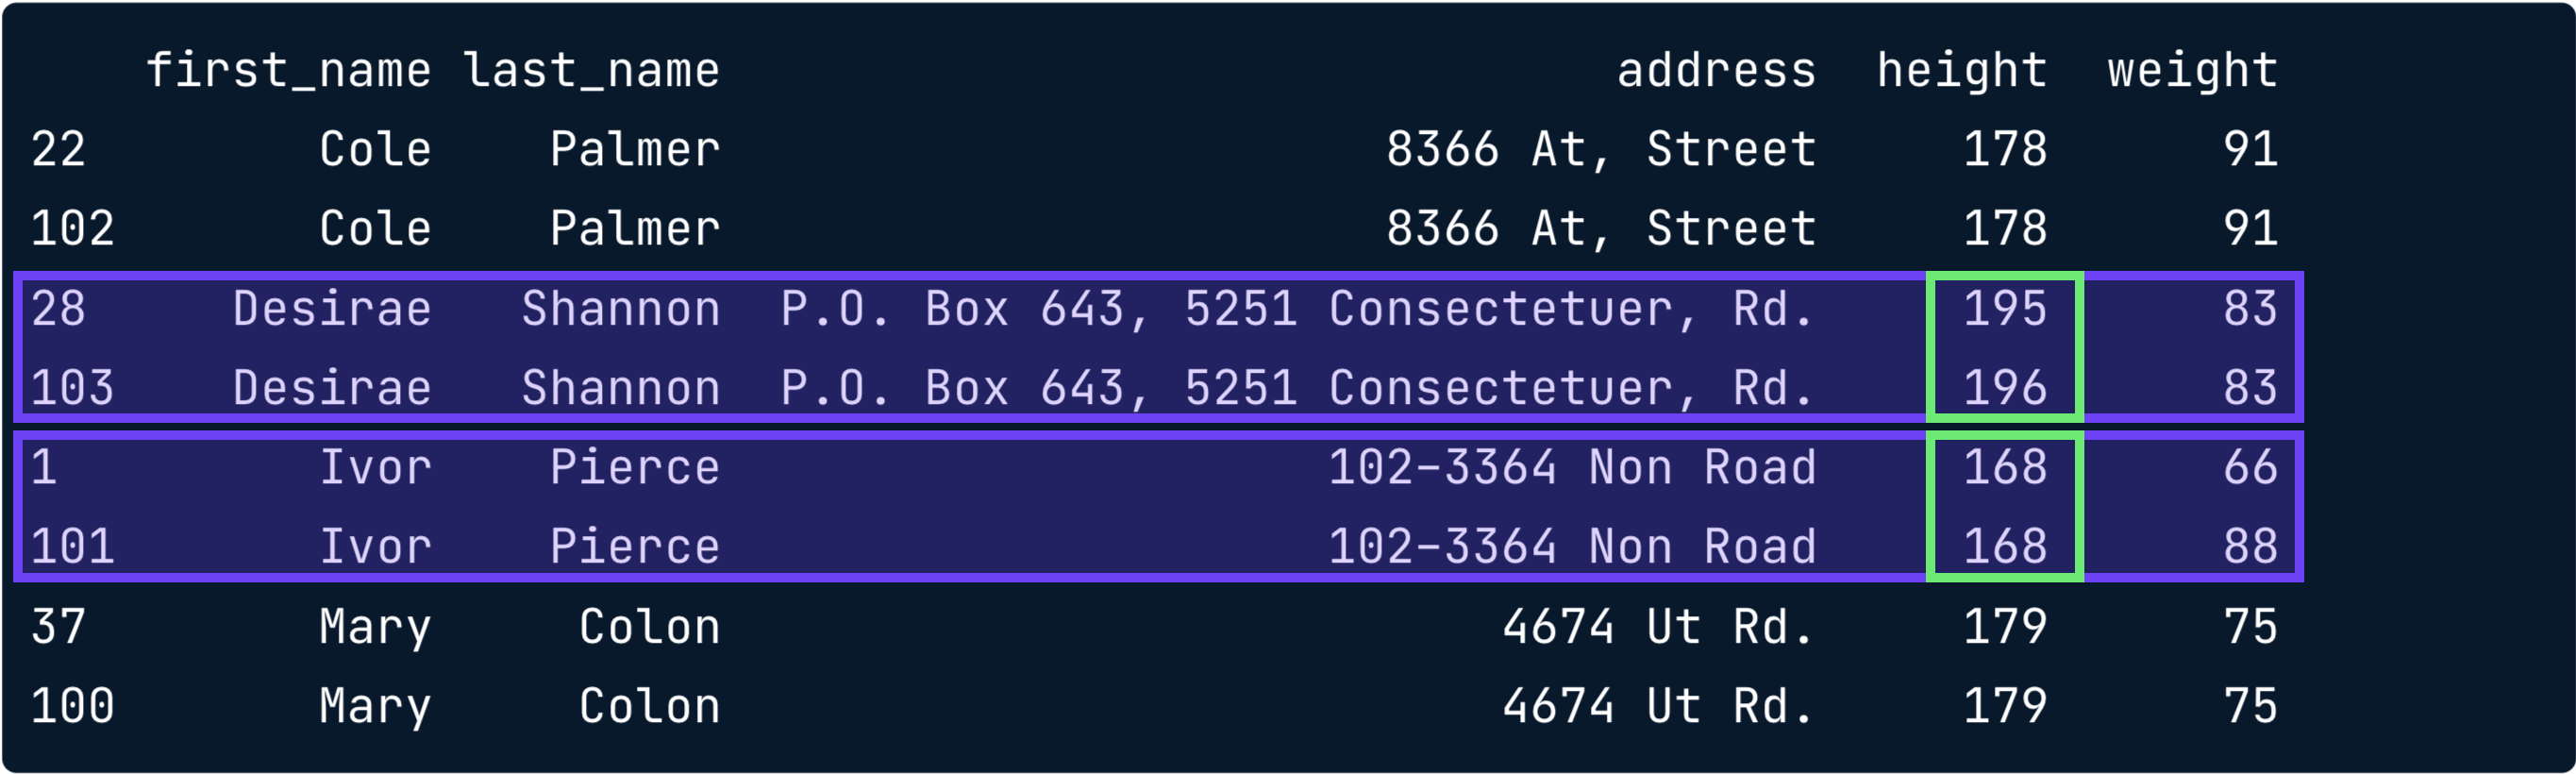
1_3_full_duplicates.png

用 Python 進行資料清理

如何找出重複列?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')

1_3_partial_duplicates.png

用 Python 進行資料清理

如何處理重複值?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')

1_3_full_duplicates.png

用 Python 進行資料清理

如何處理重複值?

.drop_duplicates() 方法

subset:要檢查重複的欄位名稱清單。

keep:保留重複中的「第一個」('first')、 「最後一個」('last')或「全部」(False)。

inplace:直接在 DataFrame 內刪除重複列,不建立新物件(True)。

# Drop duplicates
height_weight.drop_duplicates(inplace = True)
用 Python 進行資料清理

如何處理重複值?

# Output duplicate values
column_names = ['first_name','last_name','address']
duplicates = height_weight.duplicated(subset = column_names, keep = False)
height_weight[duplicates].sort_values(by = 'first_name')
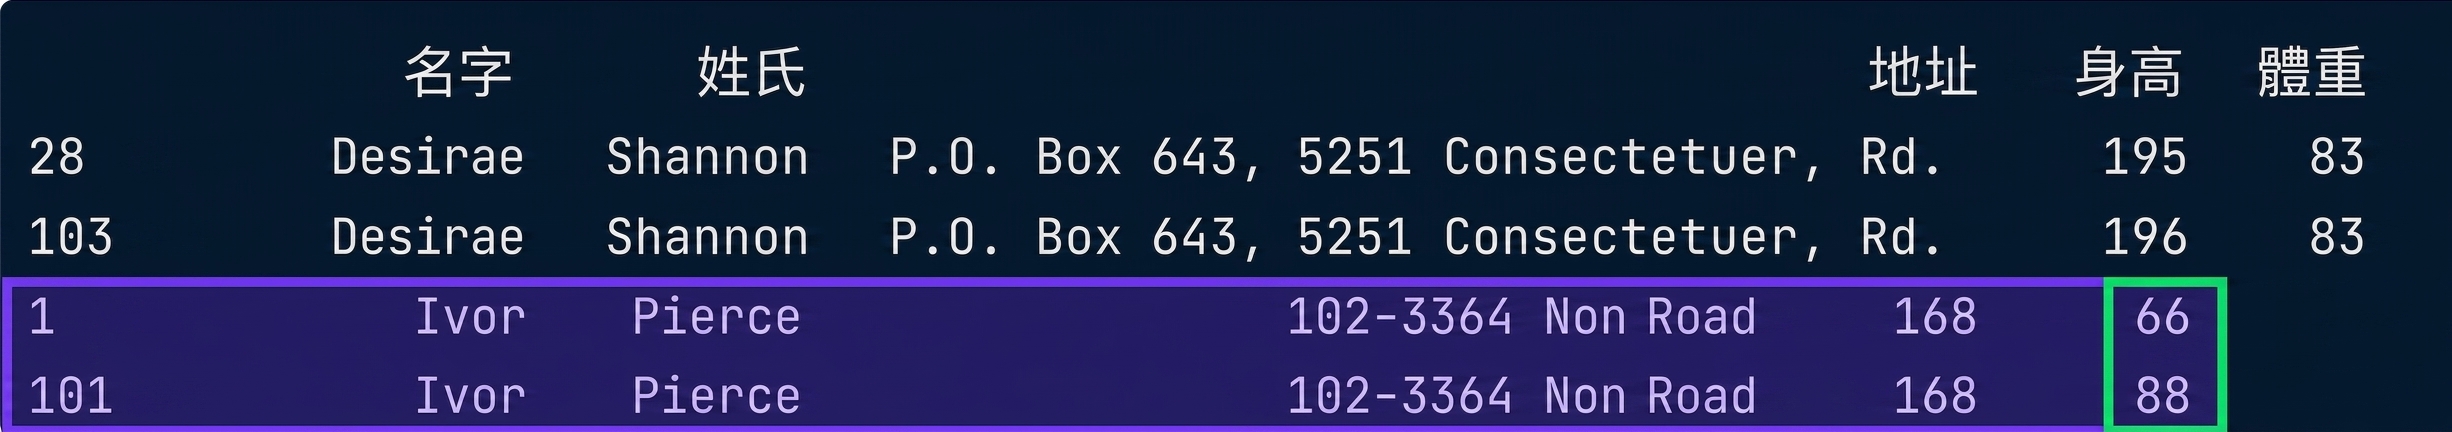
    first_name last_name                               address  height  weight
28     Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     195      83
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
1         Ivor    Pierce                     102-3364 Non Road     168      66
101       Ivor    Pierce                     102-3364 Non Road     168      88
用 Python 進行資料清理

如何處理重複值?

# Output duplicate values
column_names = ['first_name','last_name','address']
duplicates = height_weight.duplicated(subset = column_names, keep = False)
height_weight[duplicates].sort_values(by = 'first_name')

1_3_duplicate_aggregation.png

用 Python 進行資料清理

如何處理重複值?

.groupby().agg() 方法

# 依欄位群組並產生統計摘要
column_names = ['first_name','last_name','address']
summaries = {'height': 'max', 'weight': 'mean'}
height_weight = height_weight.groupby(by = column_names).agg(summaries).reset_index()

# 確認彙總已完成 duplicates = height_weight.duplicated(subset = column_names, keep = False) height_weight[duplicates].sort_values(by = 'first_name')
first_name    last_name    address    height    weight

用 Python 進行資料清理

一起來練習吧!

用 Python 進行資料清理

Preparing Video For Download...