為了更好的分群,轉換特徵

Unsupervised Learning in Python

Benjamin Wilson

Director of Research at lateral.io

皮埃蒙紅酒資料集

  • 來自 3 種皮埃蒙紅酒品種的 178 個樣本:Barolo、Grignolino、Barbera

  • 特徵量測化學成分,例如酒精含量

  • 視覺性質,如「顏色強度」

1 Source: https://archive.ics.uci.edu/ml/datasets/Wine
Unsupervised Learning in Python

對紅酒做分群

from sklearn.cluster import KMeans
model = KMeans(n_clusters=3)
labels = model.fit_predict(samples)
Unsupervised Learning in Python

叢集 vs. 品種

df = pd.DataFrame({'labels': labels, 
                       'varieties': varieties})
ct = pd.crosstab(df['labels'], df['varieties'])

print(ct)
varieties  Barbera  Barolo  Grignolino
labels                                
0               29      13          20
1                0      46           1
2               19       0          50
Unsupervised Learning in Python

特徵變異數

  • 紅酒特徵的變異數差很大!

  • 特徵的變異數衡量其數值的分散程度

feature     variance
alcohol         0.65
malic_acid      1.24
...
od280           0.50
proline     99166.71

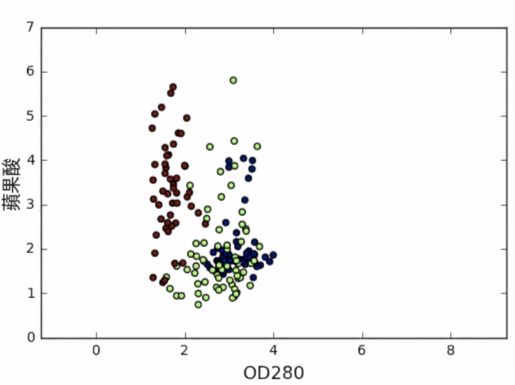
od280 變數 vs malic_acid 變數的散佈圖

Unsupervised Learning in Python

特徵變異數

  • 紅酒特徵的變異數差很大!

  • 特徵的變異數衡量其數值的分散程度

feature     variance
alcohol         0.65
malic_acid      1.24
...
od280           0.50
proline     99166.71

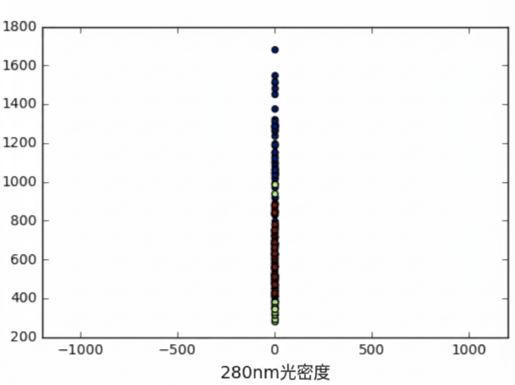
od280 變數 vs 觀測序號的散佈圖

Unsupervised Learning in Python

StandardScaler

  • 在 kmeans 中:特徵變異數 = 特徵影響力

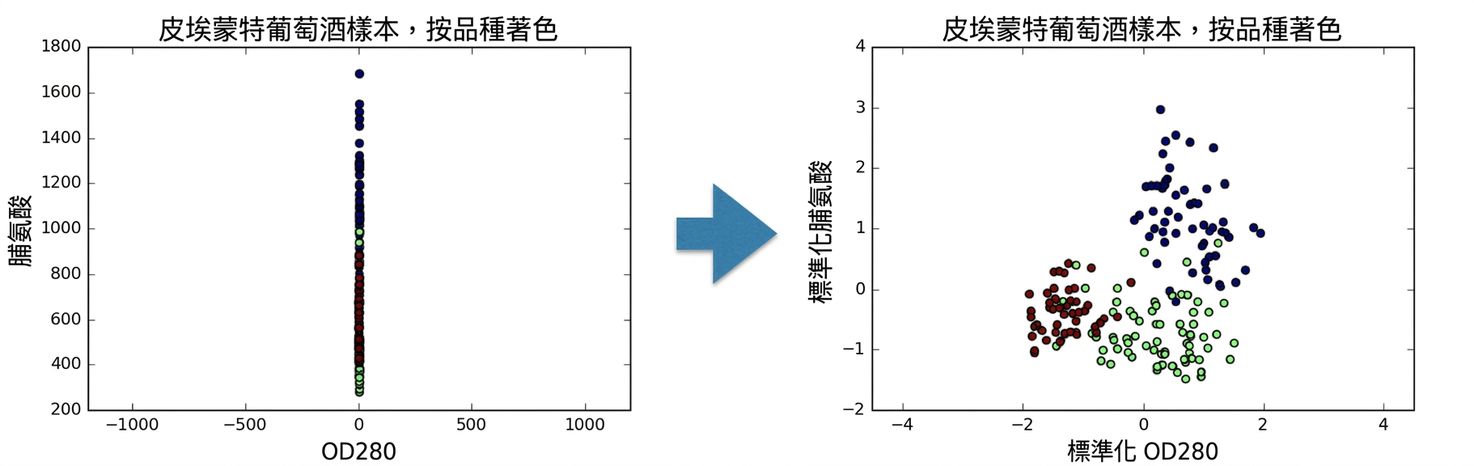
  • StandardScaler 將各特徵轉換為平均 0、變異數 1

  • 這些特徵稱為「標準化」

標準化後的 od280 與標準化後的 proline 散佈圖

Unsupervised Learning in Python

sklearn StandardScaler

from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
scaler.fit(samples) StandardScaler(copy=True, with_mean=True, with_std=True)
samples_scaled = scaler.transform(samples)
Unsupervised Learning in Python

相似的方法

  • StandardScalerKMeans 有相似的方法

  • StandardScalerfit()transform()

  • KMeansfit()predict()

Unsupervised Learning in Python

先 StandardScaler,再 KMeans

  • 需做兩步:先 StandardScaler,再 KMeans

  • sklearn pipeline 合併多步驟

  • 資料會依序流經各步驟

Unsupervised Learning in Python

Pipeline 串起多步驟

from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
scaler = StandardScaler()
kmeans = KMeans(n_clusters=3)

from sklearn.pipeline import make_pipeline
pipeline = make_pipeline(scaler, kmeans)
pipeline.fit(samples)
Pipeline(steps=...)
labels = pipeline.predict(samples)
Unsupervised Learning in Python

特徵標準化可提升分群效果

使用特徵標準化:

varieties  Barbera  Barolo  Grignolino
labels                                
0                0      59           3
1               48       0           3
2                0       0          65

未標準化的結果很差:

varieties  Barbera  Barolo  Grignolino
labels                                
0               29      13          20
1                0      46           1
2               19       0          50
Unsupervised Learning in Python

sklearn 前處理步驟

  • StandardScaler 是一個「前處理」步驟

  • 其他例子有 MaxAbsScalerNormalizer

Unsupervised Learning in Python

一起來練習吧!

Unsupervised Learning in Python

Preparing Video For Download...