R 統計學入門
Maggie Matsui
Content Developer, DataCamp
die <- c(1, 2, 3, 4, 5, 6)# 擲 5 次 sample_of_5 <- sample(die, 5, replace = TRUE) sample_of_5
1 3 4 1 1
mean(sample_of_5)
2.0

# 擲 5 次並取平均
sample(die, 5, replace = TRUE) %>% mean()
4.4
sample(die, 5, replace = TRUE) %>% mean()
3.8
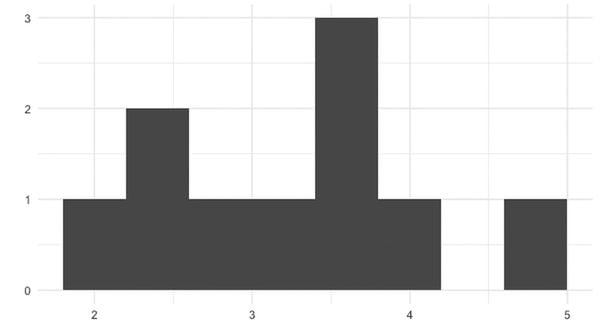
重複 10 次:
sample_means <- replicate(10, sample(die, 5, replace = TRUE) %>% mean())sample_means
3.8 4.0 3.8 3.6 3.2 4.8 2.6 3.0 2.6 2.0
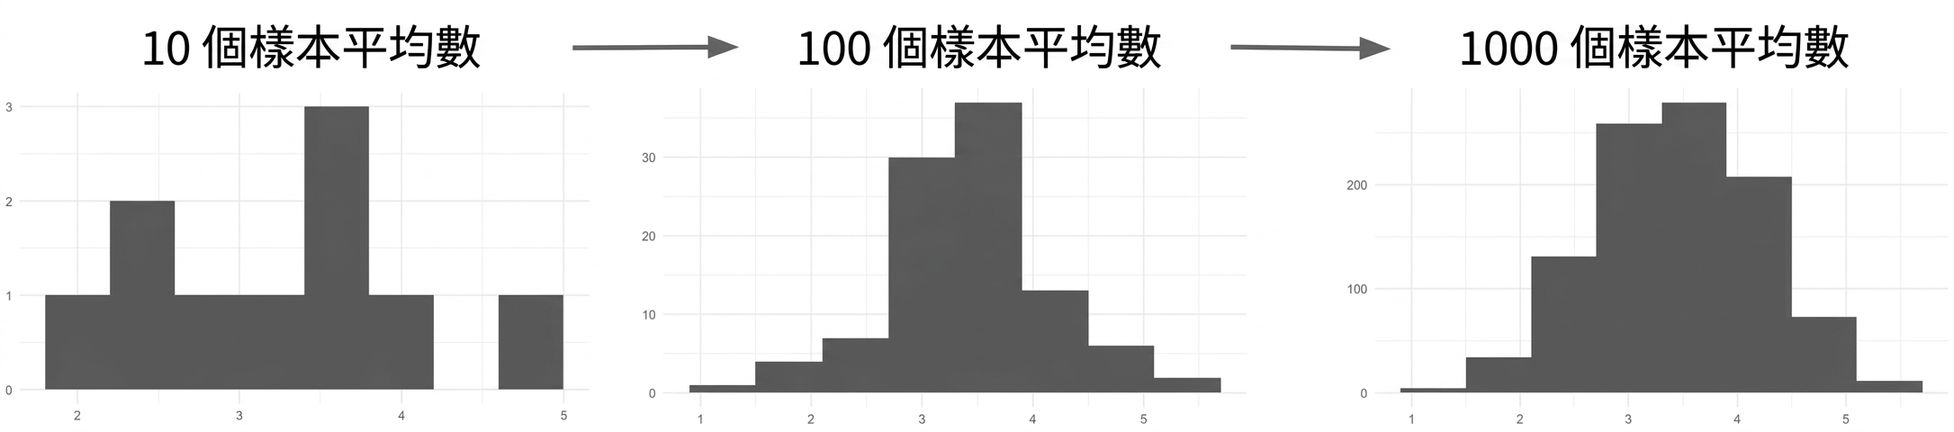
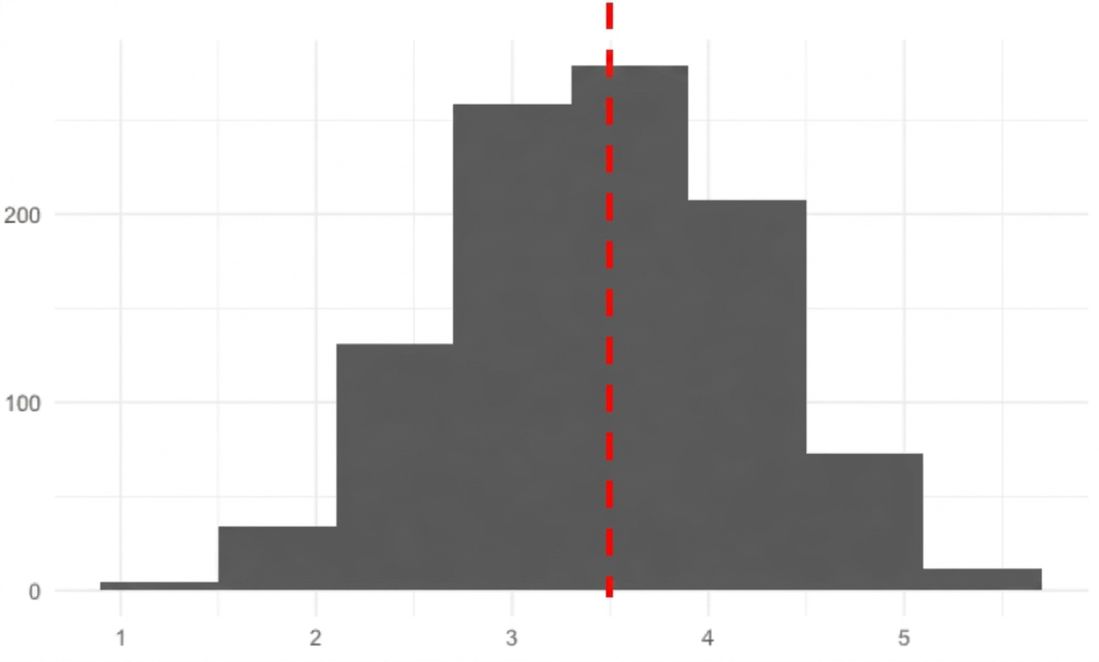
樣本平均的抽樣分配

replicate(100, sample(die, 5, replace = TRUE) %>% mean())
2.8 3.2 1.8 4.6 4.0 2.8 4.4 2.4 3.4 2.8 4.2 3.4 ... 2.2 3.8 3.6 3.8 4.4 4.8 2.4
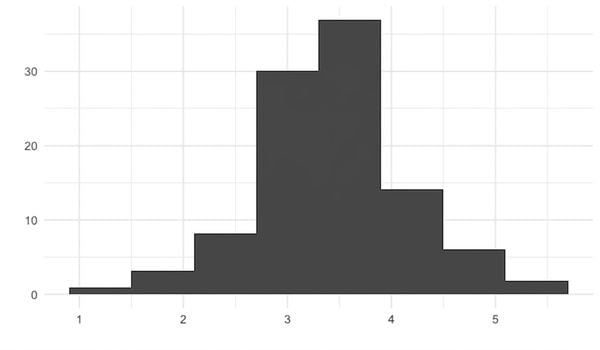
sample_means <- replicate(1000, sample(die, 5, replace = TRUE) %>% mean())
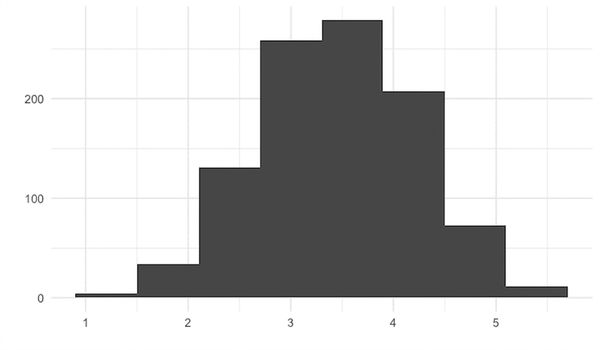
隨著重複次數增加,統計量的抽樣分配會更接近常態分配。

* 樣本需隨機且相互獨立
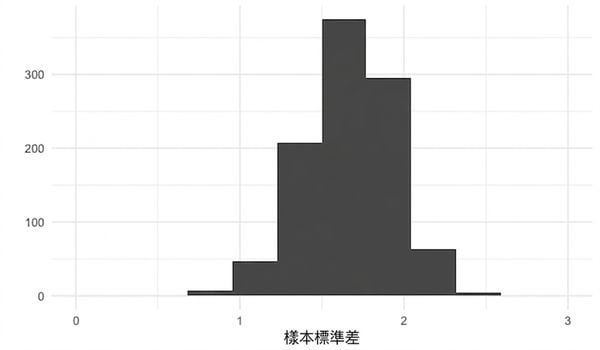
replicate(1000, sample(die, 5, replace = TRUE) %>% sd())
sales_team <- c("Amir", "Brian", "Claire", "Damian")sample(sales_team, 10, replace = TRUE)
"Claire" "Brian" "Brian" "Brian" "Damian" "Damian" "Brian" "Brian"
"Amir" "Amir"
sample(sales_team, 10, replace = TRUE)
"Amir" "Amir" "Claire" "Amir" "Amir" "Brian" "Amir" "Claire"
"Claire" "Claire"

# 估計骰子的期望值
mean(sample_means)
3.48
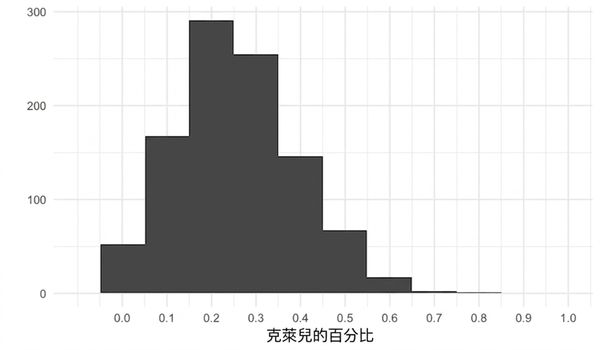
# 估計「Claire」的比例
mean(sample_props)
0.26
R 統計學入門