微調前的準備

Python 的 LLM 入門

Jasmin Ludolf

Senior Data Science Content Developer, DataCamp

Pipelines 與 Auto 類別

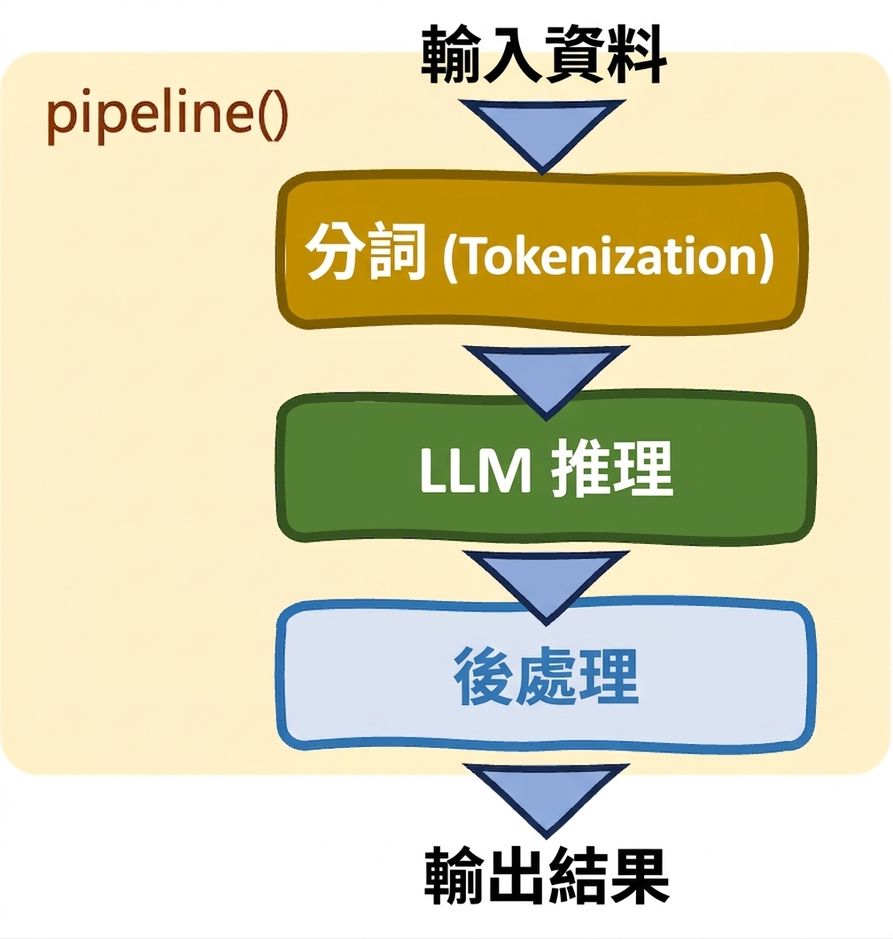
Pipelines: pipeline()

  • 簡化流程
  • 自動選模型與 tokenizer
  • 可控性有限

Hugging Face Transformers 的 pipelines

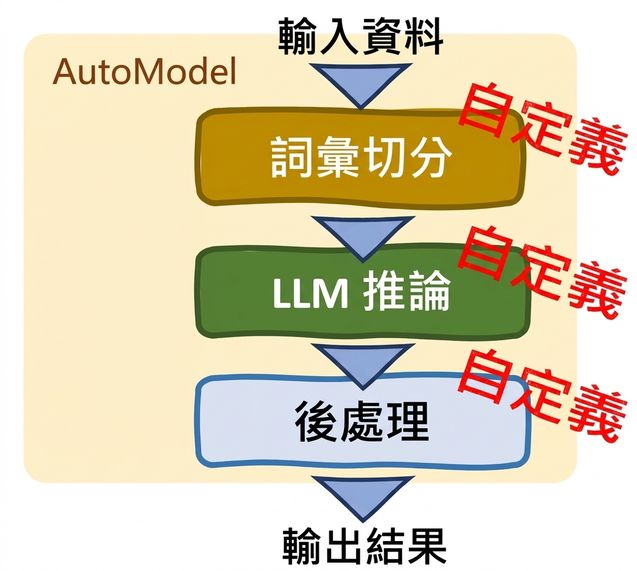
Auto 類別(AutoModel class)

  • 可自訂
  • 手動調整
  • 支援微調

Hugging Face Transformers 的 AutoModel 類別與自訂選項

Python 的 LLM 入門

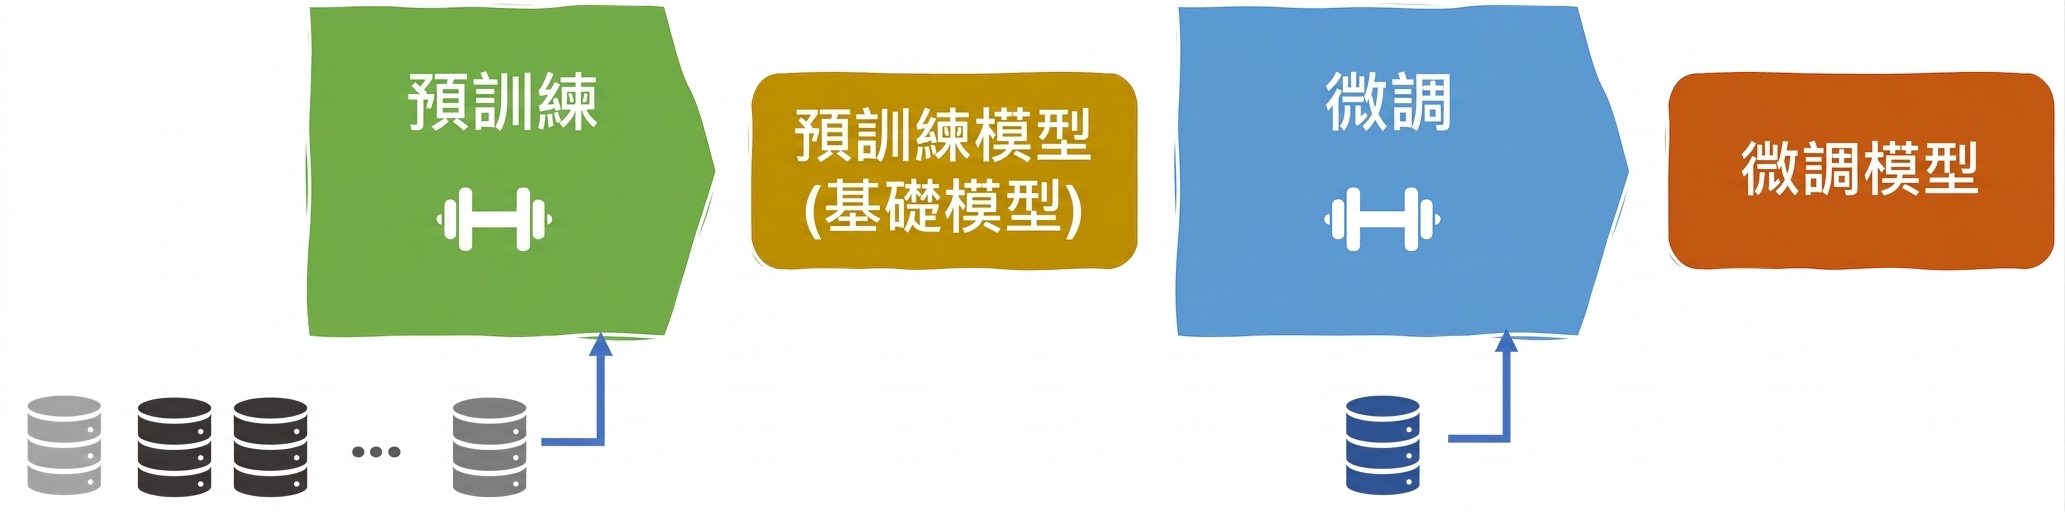
LLM 生命週期

LLM 生命週期

Pre-training

  • 廣泛資料
  • 學習通用模式
Python 的 LLM 入門

LLM 生命週期

LLM 生命週期

Pre-training                                                             Fine-tuning

  • 廣泛資料                                                          特定領域
  • 學習通用模式                                       專門任務
Python 的 LLM 入門

載入微調用的資料集

from datasets import load_dataset


train_data = load_dataset("imdb", split="train")
train_data = data.shard(num_shards=4, index=0)
test_data = load_dataset("imdb", split="test")
test_data = data.shard(num_shards=4, index=0)
  • load_dataset():從 Hugging Face hub 載入資料集
    • imdb:評論分類
Python 的 LLM 入門

Auto 類別

from transformers import AutoModel, AutoTokenizer

from transformers import AutoModelForSequenceClassification
model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased") tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
Python 的 LLM 入門

斷詞(Tokenization)

from transformers import AutoTokenizer, AutoModelForSequenceClassification
from datasets import load_dataset

train_data = load_dataset("imdb", split="train")
train_data = data.shard(num_shards=4, index=0)
test_data = load_dataset("imdb", split="test")
test_data = data.shard(num_shards=4, index=0)

model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased")
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")


# Tokenize the data tokenized_training_data = tokenizer(train_data["text"], return_tensors="pt", padding=True, truncation=True, max_length=64) tokenized_test_data = tokenizer(test_data["text"], return_tensors="pt", padding=True, truncation=True, max_length=64)
Python 的 LLM 入門

斷詞輸出

print(tokenized_training_data)
{'input_ids': tensor([[  101,  1045, 12524,  1045,  2572,  8025,  1011,  3756,  
2013,  2026, 2678,  3573,  2138,  1997,  2035,  1996,  6704,  2008,  5129,  2009, 
2043,  2009, 2001,  2034,  2207,  1999,  3476,  1012,  1045,  2036, ...
Python 的 LLM 入門

逐列斷詞

def tokenize_function(text_data):
    return tokenizer(text_data["text"], return_tensors="pt", padding=True, truncation=True, max_length=64)

# Tokenize in batches
tokenized_in_batches = train_data.map(tokenize_function, batched=True)

# Tokenize row by row tokenized_by_row = train_data.map(tokenize_function, batched=False)
Dataset({
    features: ['text', 'label', 'input_ids', 'token_type_ids', 'attention_mask'],
    num_rows: 1563
})
Python 的 LLM 入門

子詞斷詞(Subword)

  • 現代 tokenizer 常見
  • 單字拆成有意義的子片段


Unbelievably

Python 的 LLM 入門

子詞斷詞(Subword)

  • 現代 tokenizer 常見
  • 單字拆成有意義的子片段


「Unbelievably」被切為 un、believ、ably。

Python 的 LLM 入門

一起來練習吧!

Python 的 LLM 入門

Preparing Video For Download...