卷積神經網路

Intermediate Deep Learning with PyTorch

Michal Oleszak

Machine Learning Engineer

為何不用線性層?
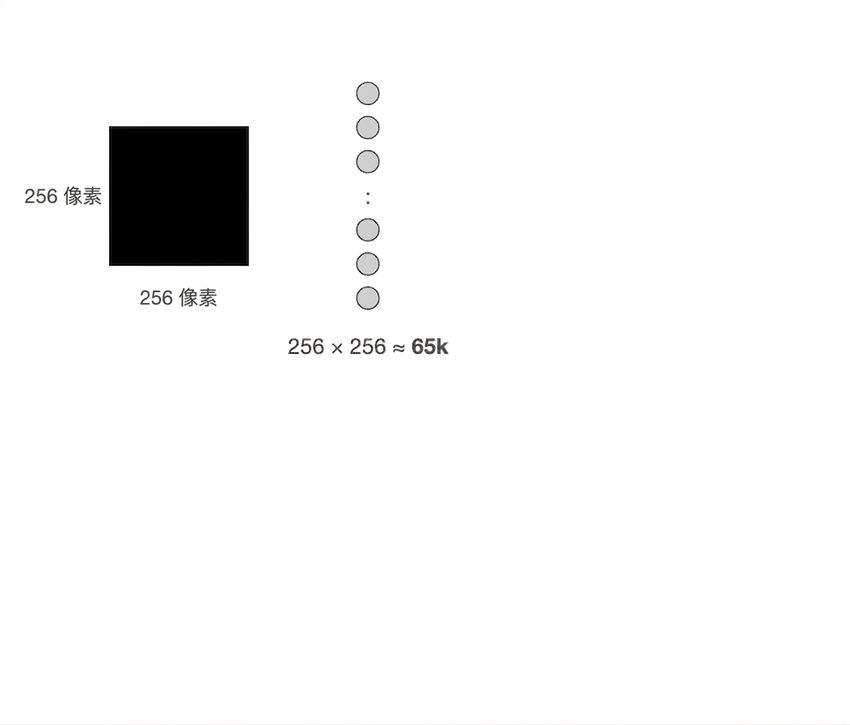
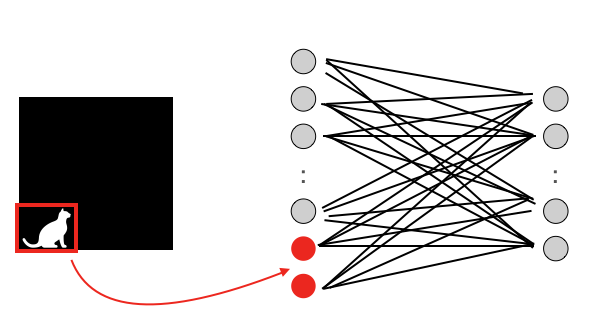
一個代表 256x256 灰階影像的黑色方塊。

Intermediate Deep Learning with PyTorch

為何不用線性層?

一張 256×256 的灰階影像約有 65k 個像素值。

Intermediate Deep Learning with PyTorch

為何不用線性層?

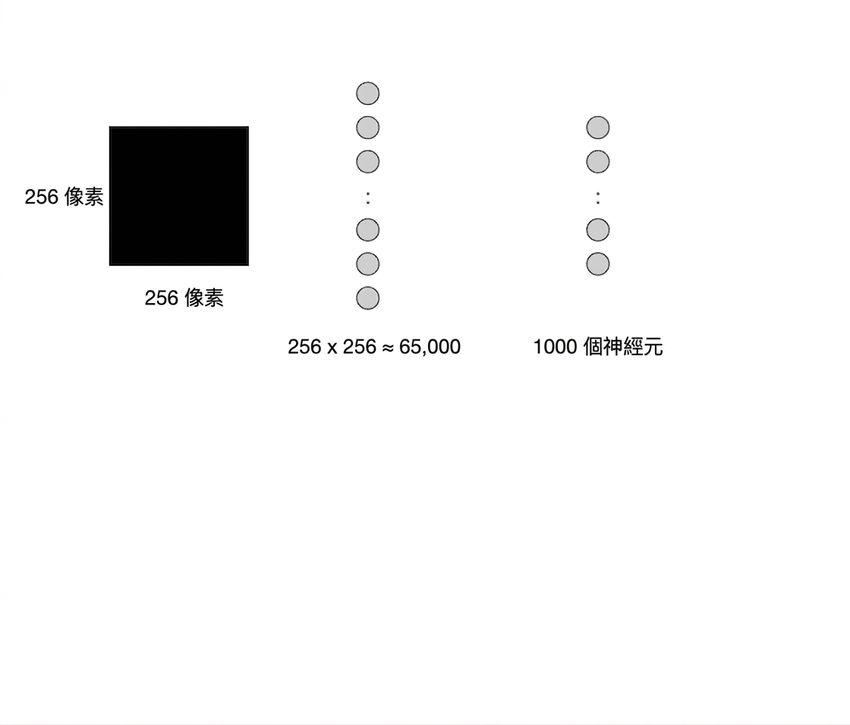
一個含 1000 個神經元的線性層處理 65k 個像素值。

Intermediate Deep Learning with PyTorch

為何不用線性層?

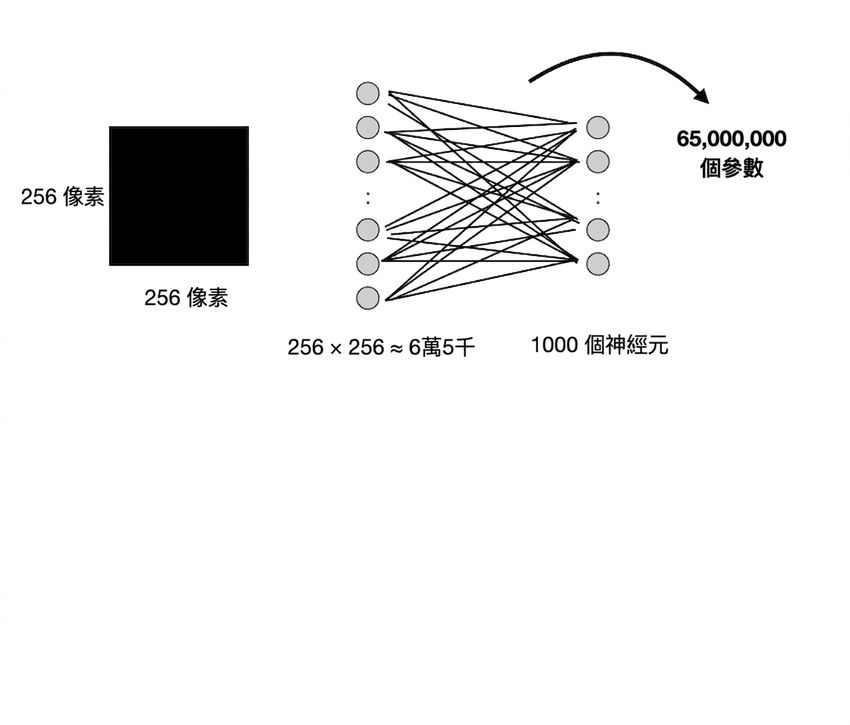
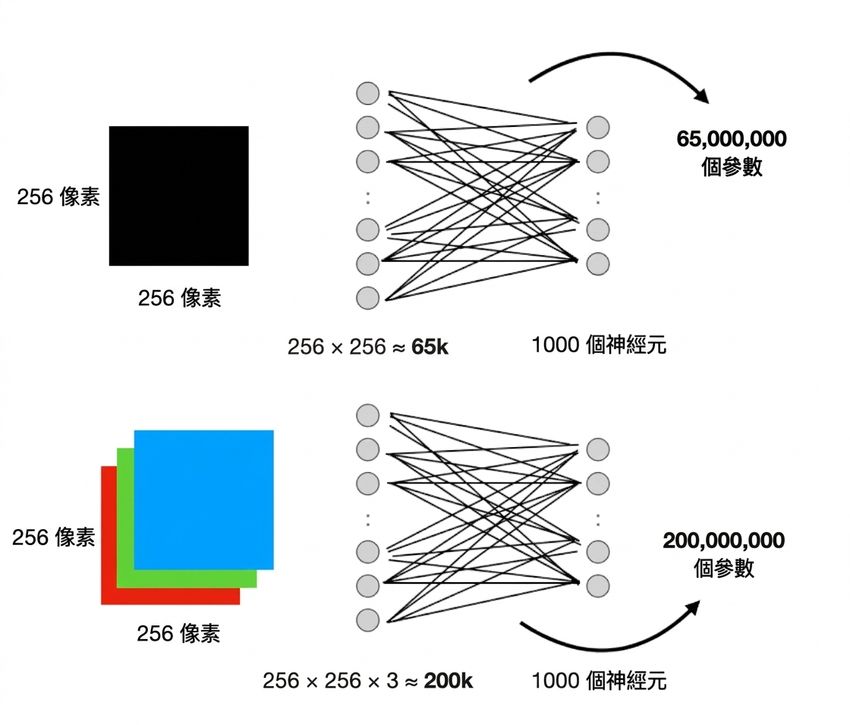
影像與該層之間共有 65m 個連結。

Intermediate Deep Learning with PyTorch

為何不用線性層?

對 RGB 彩色影像,連結數達 200m。

Intermediate Deep Learning with PyTorch

為何不用線性層?

  • 線性層:
    • 訓練慢
    • 容易過度擬合
    • 無法辨識空間模式
  • 更好的選擇:卷積層!

影像角落有貓,且只有讀取該區域的神經元會察覺到它

Intermediate Deep Learning with PyTorch

卷積層

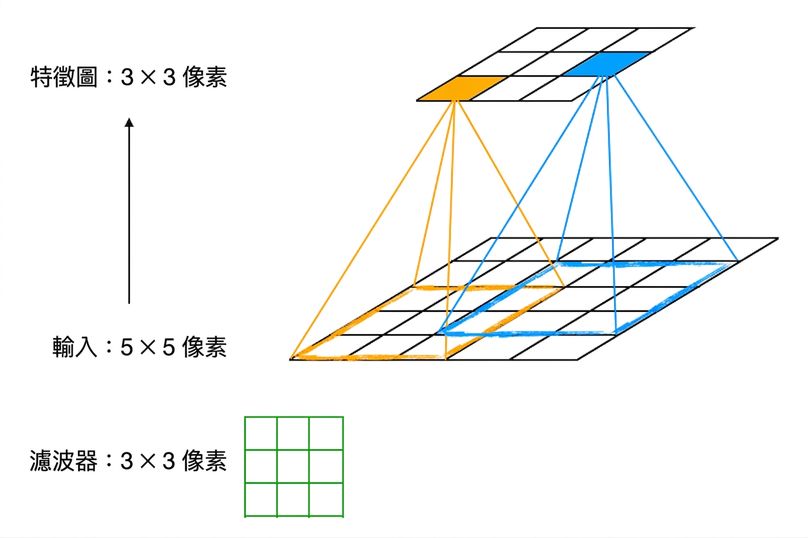
大小為 3×3 的濾鏡在 5×5 輸入上滑動,產生 3×3 的特徵圖。

  • 將含參數的濾鏡在輸入上滑動
  • 各位置執行卷積
  • 產生的特徵圖:
    • 保留輸入的空間模式
    • 參數少於線性層
  • 一個濾鏡 = 一張特徵圖
  • 對特徵圖套用活化函式
  • 合併所有特徵圖作為輸出
  • nn.Conv2d(3, 32, kernel_size=3)
Intermediate Deep Learning with PyTorch

卷積

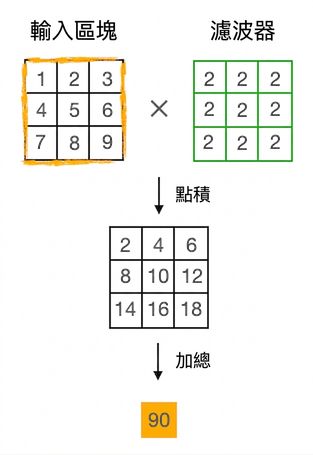
兩個 3×3 矩陣逐元素相乘,結果矩陣的所有數字再相加。

  1. 計算輸入區塊與濾鏡的內積
    • 左上元素:2 × 1 = 2
  2. 將結果總和
Intermediate Deep Learning with PyTorch

零填充(Zero-padding)

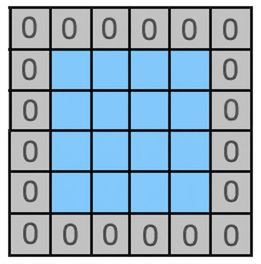
一張 4×4 影像外圍補上一圈數值為 0 的像素。

  • 在卷積層輸入外圍補零框
nn.Conv2d(
  3, 32, kernel_size=3, padding=1
)
  • 維持輸入與輸出張量的空間維度
  • 邊界像素與其他像素同等對待
Intermediate Deep Learning with PyTorch

最大池化(Max Pooling)

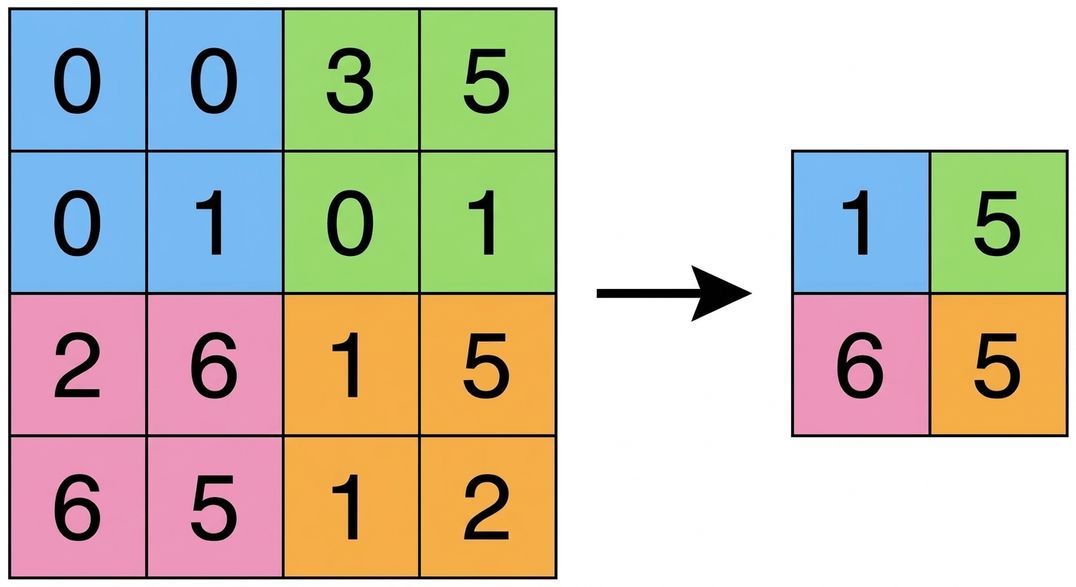
一個 4×4 矩陣被劃分為四個 2×2 區塊,經最大池化後成為 2×2 矩陣。

  • 以不重疊視窗在輸入上滑動
  • 各位置僅保留最大值
  • 卷積層後使用以縮減空間維度
  • nn.MaxPool2d(kernel_size=2)
Intermediate Deep Learning with PyTorch

卷積神經網路

class Net(nn.Module):
    def __init__(self, num_classes):
        super().__init__()

self.feature_extractor = nn.Sequential( nn.Conv2d(3, 32, kernel_size=3, padding=1), nn.ELU(), nn.MaxPool2d(kernel_size=2), nn.Conv2d(32, 64, kernel_size=3, padding=1), nn.ELU(), nn.MaxPool2d(kernel_size=2), nn.Flatten(), )
self.classifier = nn.Linear(64*16*16, num_classes)
def forward(self, x): x = self.feature_extractor(x) x = self.classifier(x) return x
  • feature_extractor:(卷積、活化、池化)重複兩次後攤平
  • classifier:單一線性層
  • forward():將輸入影像依序通過特徵擷取器與分類器
Intermediate Deep Learning with PyTorch

特徵擷取器輸出大小

self.feature_extractor = nn.Sequential(
  nn.Conv2d(3, 32, kernel_size=3, padding=1),
  nn.ELU(),
  nn.MaxPool2d(kernel_size=2),
  nn.Conv2d(32, 64, kernel_size=3, padding=1),
  nn.ELU(),
  nn.MaxPool2d(kernel_size=2),
  nn.Flatten(),
)
self.classifier = nn.Linear(64*16*16, num_classes)
`

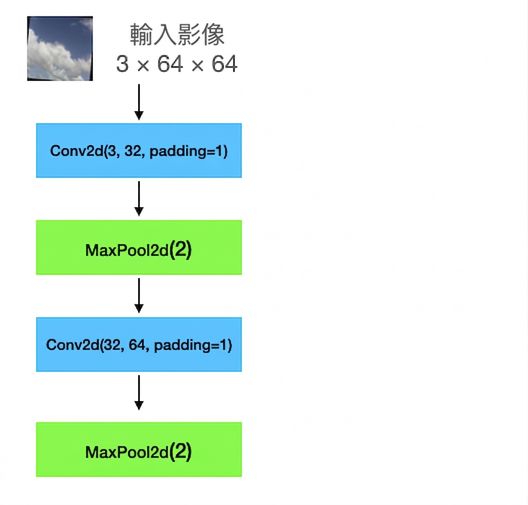
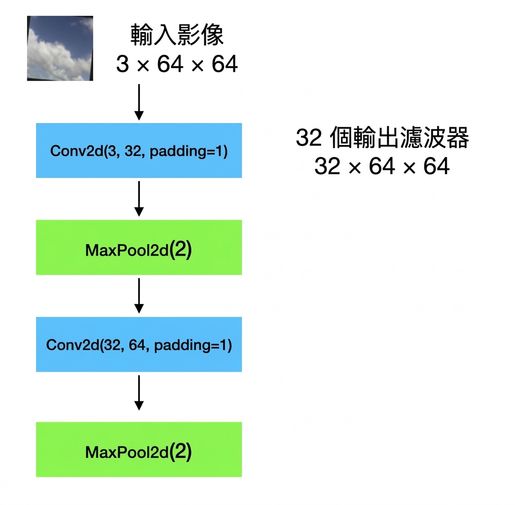
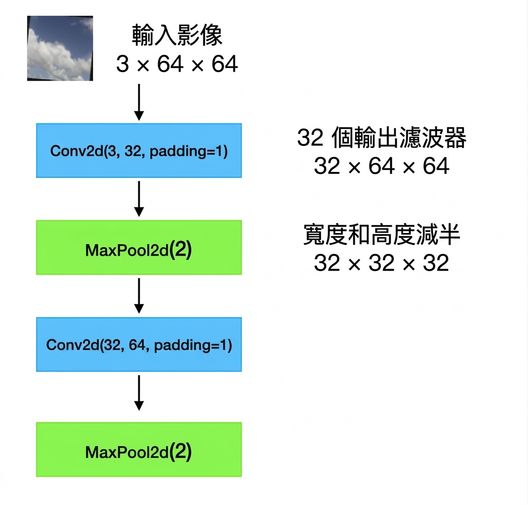
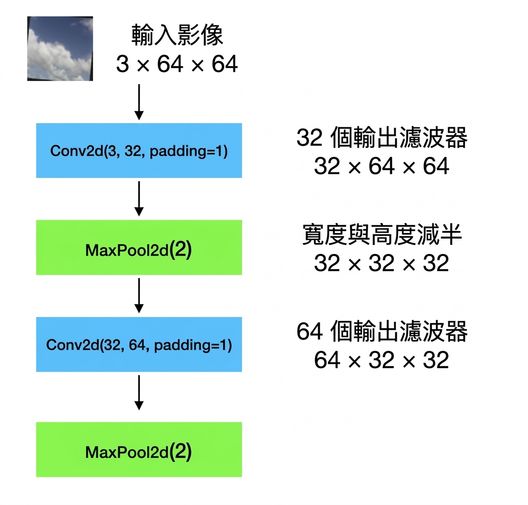
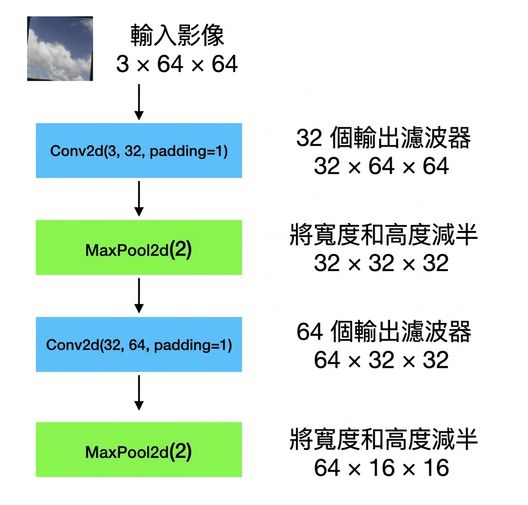
示意圖:輸入影像形狀為 3×64×64,依序通過一個卷積層、池化層、再一個卷積層與池化層。

Intermediate Deep Learning with PyTorch

特徵擷取器輸出大小

self.feature_extractor = nn.Sequential(
  nn.Conv2d(3, 32, kernel_size=3, padding=1),
  nn.ELU(),
  nn.MaxPool2d(kernel_size=2),
  nn.Conv2d(32, 64, kernel_size=3, padding=1),
  nn.ELU(),
  nn.MaxPool2d(kernel_size=2),
  nn.Flatten(),
)
self.classifier = nn.Linear(64*16*16, num_classes)
`

示意圖:輸入影像形狀為 3×64×64,依序通過一個卷積層、池化層、再一個卷積層與池化層。

Intermediate Deep Learning with PyTorch

特徵擷取器輸出大小

self.feature_extractor = nn.Sequential(
  nn.Conv2d(3, 32, kernel_size=3, padding=1),
  nn.ELU(),
  nn.MaxPool2d(kernel_size=2),
  nn.Conv2d(32, 64, kernel_size=3, padding=1),
  nn.ELU(),
  nn.MaxPool2d(kernel_size=2),
  nn.Flatten(),
)
self.classifier = nn.Linear(64*16*16, num_classes)
`

示意圖:輸入影像形狀為 3×64×64,依序通過一個卷積層、池化層、再一個卷積層與池化層。

Intermediate Deep Learning with PyTorch

特徵擷取器輸出大小

self.feature_extractor = nn.Sequential(
  nn.Conv2d(3, 32, kernel_size=3, padding=1),
  nn.ELU(),
  nn.MaxPool2d(kernel_size=2),
  nn.Conv2d(32, 64, kernel_size=3, padding=1),
  nn.ELU(),
  nn.MaxPool2d(kernel_size=2),
  nn.Flatten(),
)
self.classifier = nn.Linear(64*16*16, num_classes)
`

示意圖:輸入影像形狀為 3×64×64,依序通過一個卷積層、池化層、再一個卷積層與池化層。

Intermediate Deep Learning with PyTorch

特徵擷取器輸出大小

self.feature_extractor = nn.Sequential(
  nn.Conv2d(3, 32, kernel_size=3, padding=1),
  nn.ELU(),
  nn.MaxPool2d(kernel_size=2),
  nn.Conv2d(32, 64, kernel_size=3, padding=1),
  nn.ELU(),
  nn.MaxPool2d(kernel_size=2),
  nn.Flatten(),
)
self.classifier = nn.Linear(64*16*16, num_classes)
`

示意圖:輸入影像形狀為 3×64×64,依序通過一個卷積層、池化層、再一個卷積層與池化層。

Intermediate Deep Learning with PyTorch

一起來練習吧!

Intermediate Deep Learning with PyTorch

Preparing Video For Download...