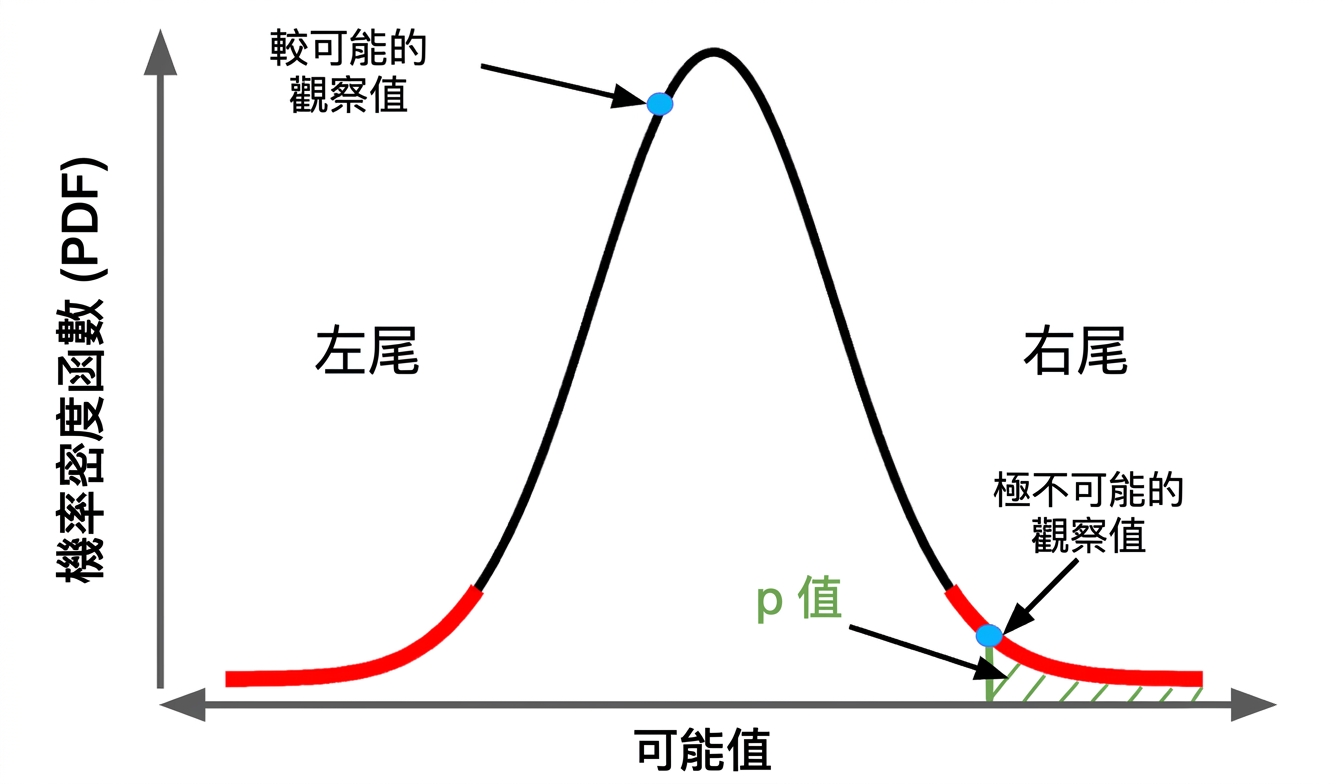
p 值

Python 中的假設檢定

James Chapman

Curriculum Manager, DataCamp

刑事審判

  • 兩種可能的真實情況:
    1. 被告確實犯案
    2. 被告未犯案
  • 兩種可能的裁決:
    1. 有罪
    2. 無罪
  • 一開始假定被告無罪
  • 檢方須提出「超越合理懷疑」的證據才能判有罪
Python 中的假設檢定

首次寫程式的年齡

  • age_first_code_cut 將 Stack Overflow 使用者首次寫程式的年齡分類
    • "adult" 代表 14 歲(含)之後才開始
    • "child" 代表 14 歲之前就開始
  • 先前研究:35% 的軟體開發者是兒時開始寫程式
  • 有沒有證據顯示資料科學家兒時開始的比例更高?
Python 中的假設檢定

定義

「假說」是對未知母體參數的敘述。

「假說檢定」是對兩個相互競爭的假說進行檢定。

  • 「虛無假說($H_{0}$)」是現有看法。

  • 「對立假說($H_{A}$)」是研究者提出的新挑戰觀點。

以本問題為例:

  • $H_{0}$:資料科學家兒時開始寫程式的比例為 35%
  • $H_{A}$:資料科學家兒時開始寫程式的比例大於 35%
1 「naught」在英式英語中指「零」。歷史因素使「H-naught」成為虛無假說的國際慣用發音。
Python 中的假設檢定

刑事審判 vs. 假說檢定

  • $H_{A}$ 與 $H_{0}$ 擇一為真(不會同時為真)。
  • 起初假定 $H_{0}$ 為真。
  • 檢定結論為「拒絕 $H_{0}$」或「無法拒絕 $H_{0}$」。
  • 若樣本證據對 $H_{A}$ 「顯著」,則拒絕 $H_{0}$;否則選擇 $H_{0}$。

「顯著水準」是用於假說檢定的「超越合理懷疑」。

Python 中的假設檢定

單尾與雙尾檢定

標準常態分配機率密度的密度圖,左右尾端以紅色標示。

假說檢定會檢查樣本統計量是否落在「虛無分配」的尾端。

檢定 尾端
對立假說「不同於」虛無 雙尾
對立假說「大於」虛無 右尾
對立假說「小於」虛無 左尾


$H_{A}$:資料科學家兒時開始寫程式的比例「大於」35%

這是「右尾」檢定。

Python 中的假設檢定

p 值

「p 值」:在虛無假說為真時,得到觀察結果的機率。

  • p 值大,對 $H_{0}$ 的支持度高。
    • 統計量很可能「不在」虛無分配的尾端。
  • p 值小,對 $H_{0}$ 不利的證據強。
    • 統計量很可能「落在」虛無分配的尾端。
  • 「p」在 p 值中 → probability(機率)。
  • 「小」指「接近 0」。
Python 中的假設檢定

計算 z 分數

prop_child_samp = (stack_overflow['age_first_code_cut'] == "child").mean()
0.39141972578505085
prop_child_hyp = 0.35
std_error = np.std(first_code_boot_distn, ddof=1)
0.010351057228878566
z_score = (prop_child_samp - prop_child_hyp) / std_error
4.001497129152506
Python 中的假設檢定

計算 p 值

  • norm.cdf()scipy.stats 的常態 CDF。
  • 左尾檢定 → 使用 norm.cdf()
  • 右尾檢定 → 使用 1 - norm.cdf()


from scipy.stats import norm
1 - norm.cdf(z_score, loc=0, scale=1)
3.1471479512323874e-05
Python 中的假設檢定

一起來練習吧!

Python 中的假設檢定

Preparing Video For Download...