詞向量(Embeddings)

Python 的 Natural Language Processing(NLP)

Fouad Trad

Machine Learning Engineer

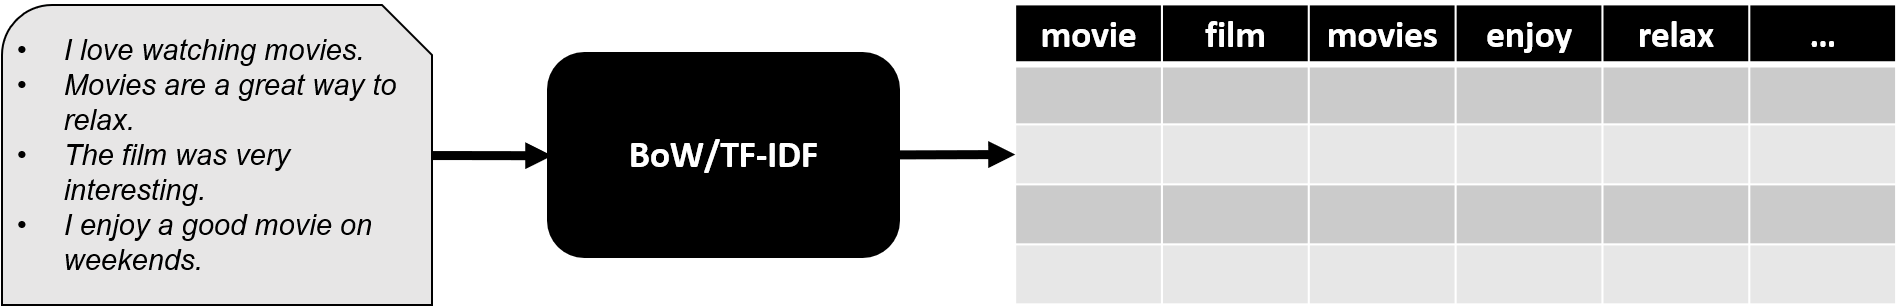
BoW 與 TF-IDF 的侷限

  • 將相似詞視為完全無關
  • 難以捕捉文字語意


顯示 BoW/TF-IDF 如何把多段文字的資料集轉成以獨特詞彙為特徵的結構化資料集的圖。

Python 的 Natural Language Processing(NLP)

詞向量(Embeddings)

顯示詞向量將一個單字轉成向量的圖。

  • 用向量表示單字並捕捉其語意
Python 的 Natural Language Processing(NLP)

詞向量(Embeddings)

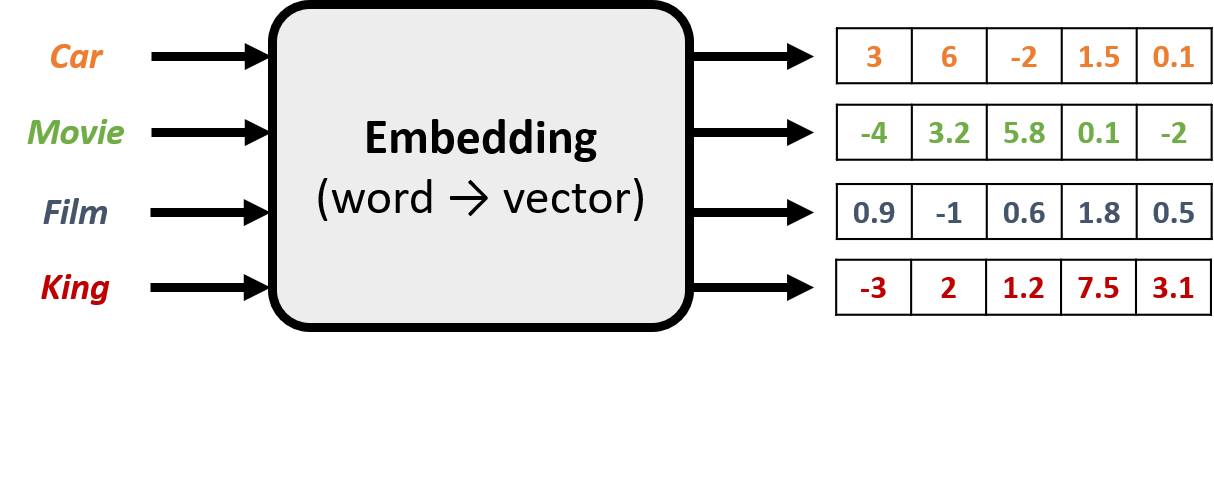
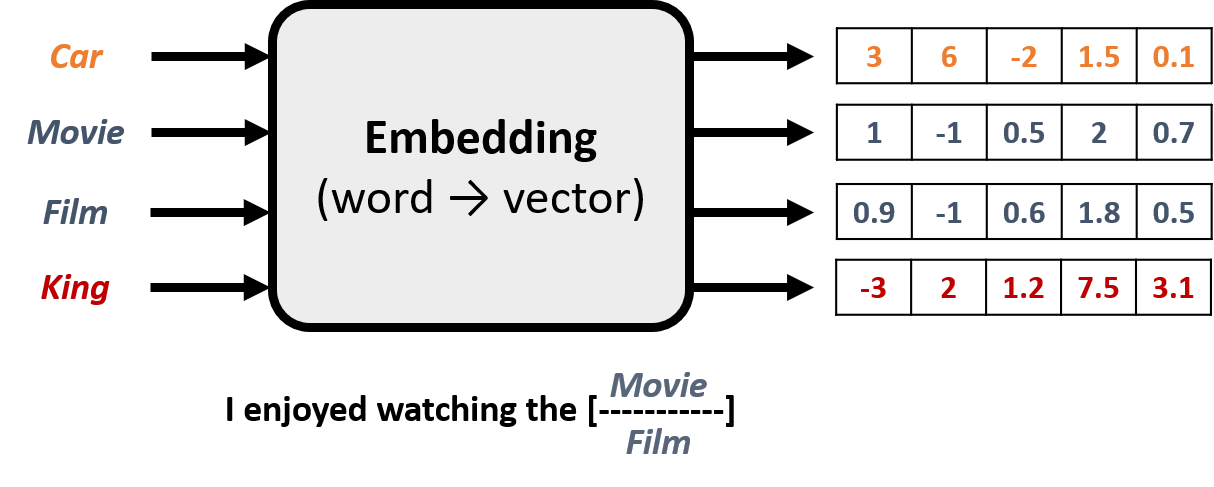
四個不同單字 car、movie、film、king 的詞向量示意圖。

  • 用向量表示單字並捕捉其語意
    • 先為每個詞隨機指派數值
Python 的 Natural Language Processing(NLP)

詞向量(Embeddings)

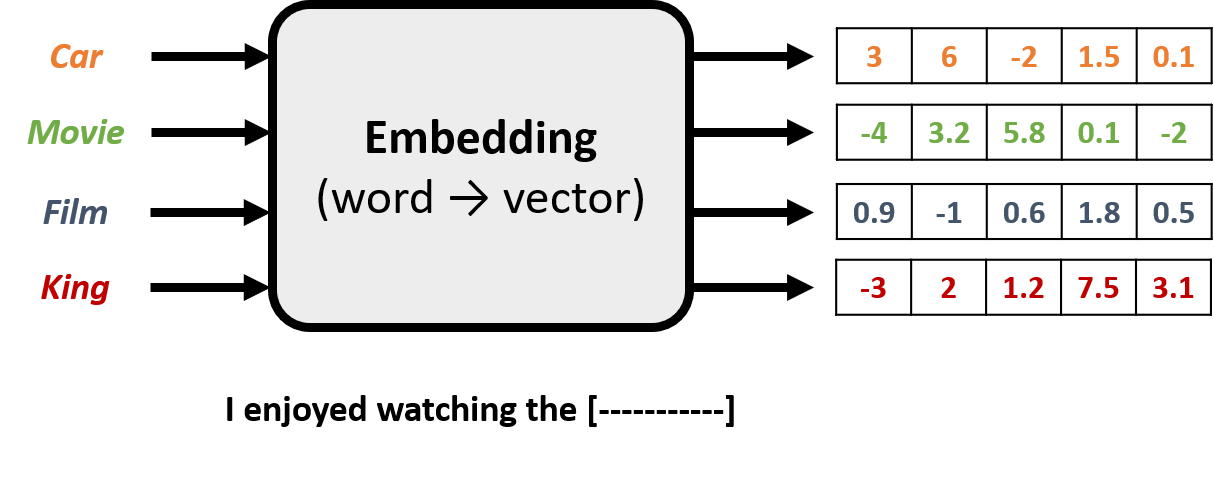
句子補全任務示意圖:將「I enjoyed watching the」用正確單字補完。

  • 用向量表示單字並捕捉其語意
    • 先為每個詞隨機指派數值
    • 透過預測句中遺漏詞來微調數值
Python 的 Natural Language Processing(NLP)

詞向量(Embeddings)

可用意義相近的兩個詞 movie 與 film 補全句子的圖。

  • 用向量表示單字並捕捉其語意
    • 先為每個詞隨機指派數值
    • 透過預測句中遺漏詞來微調數值
    • 出現在相似語境的詞會有相近的表示
Python 的 Natural Language Processing(NLP)

把詞向量想成單字的 GPS 座標

地圖上的 GPS 位置。

Python 的 Natural Language Processing(NLP)

Gensim

  • 提供常見的詞向量模型
    • Word2Vec
    • GloVe
word2vec-ruscorpora-300
word2vec-google-news-300
glove-wiki-gigaword-50
glove-wiki-gigaword-100
glove-wiki-gigaword-200
glove-wiki-gigaword-300
...


  Gensim 標誌。

Python 的 Natural Language Processing(NLP)

載入詞向量模型

import gensim.downloader as api

model = api.load('glove-wiki-gigaword-50')
print(type(model))
print(model['movie'])
<class 'gensim.models.keyedvectors.KeyedVectors'>

[ 0.30824 0.17223 -0.23339 0.023105 0.28522 0.23076 -0.41048 -1.0035 -0.2072 1.4327 -0.80684 0.68954 -0.43648 1.1069 1.6107 -0.31966 0.47744 0.79395 -0.84374 0.064509 0.90251 0.78609 0.29699 0.76057 0.433 -1.5032 -1.6423 0.30256 0.30771 -0.87057 2.4782 -0.025852 0.5013 -0.38593 -0.15633 0.45522 0.04901 -0.42599 -0.86402 -1.3076 -0.29576 1.209 -0.3127 -0.72462 -0.80801 0.082667 0.26738 -0.98177 -0.32147 0.99823 ]
Python 的 Natural Language Processing(NLP)

計算相似度

similarity = model.similarity("film", "movie")

print(similarity)
0.9310100078582764
Python 的 Natural Language Processing(NLP)

找出最相近的詞

similar_to_movie = model.most_similar('movie', topn=3)

print(similar_to_movie)
[('movies', 0.9322481155395508), 
 ('film', 0.9310100078582764), 
 ('films', 0.8937394618988037)]
Python 的 Natural Language Processing(NLP)

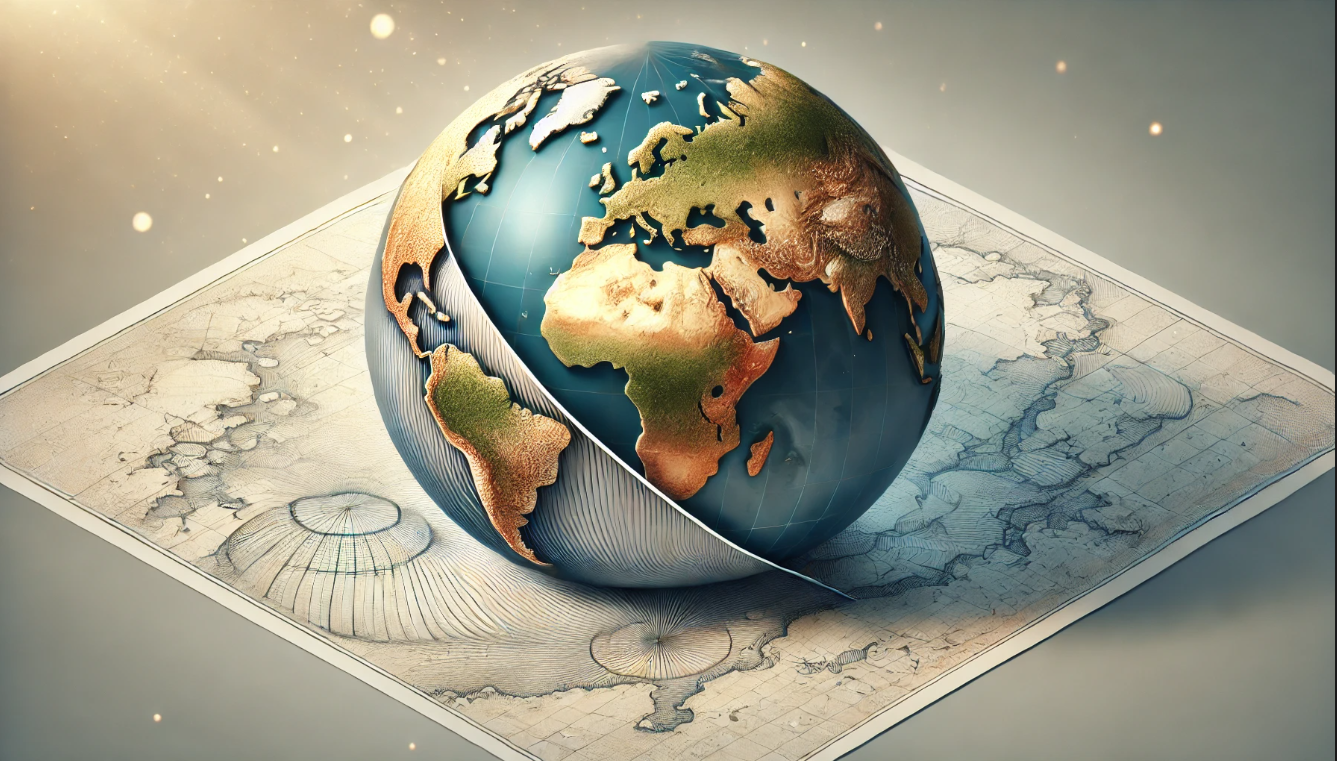
視覺化詞向量

  • 主成分分析(PCA):
    • 高維向量 → 2D 或 3D 向量

把 3D 地圖壓平成 2D 的比喻圖。

1 Image generated by DALL-E
Python 的 Natural Language Processing(NLP)

用 PCA 視覺化詞向量

from sklearn.decomposition import PCA

words = ["film", "movie", "dog", "cat", "car", "bus"]
word_vectors = [model[word] for word in words]
pca = PCA(n_components=2)
word_vectors_2d = pca.fit_transform(word_vectors)
plt.scatter(word_vectors_2d[:, 0], word_vectors_2d[:, 1])
for word, (x, y) in zip(words, word_vectors_2d): plt.annotate(word, (x, y))
plt.show()

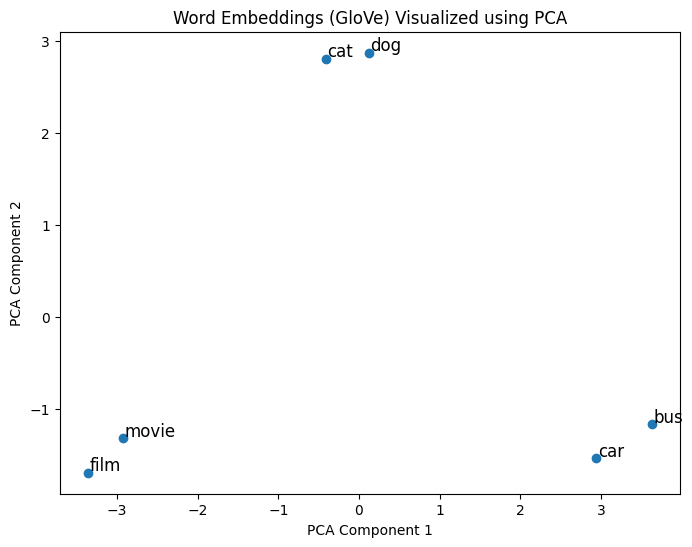
顯示在詞向量空間中,語意相近或相關的詞彼此距離很近的圖。

Python 的 Natural Language Processing(NLP)

詞向量模型比較

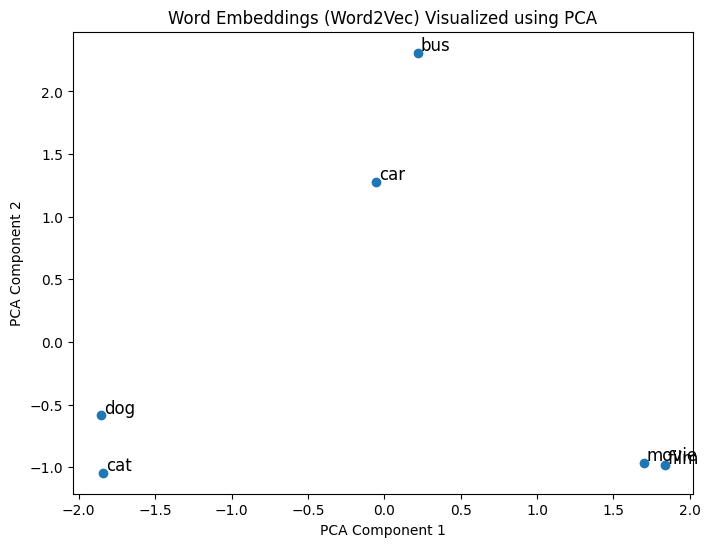
顯示 Word2Vec 模型中語意相近/相關的詞在詞向量空間中彼此接近,但與 GloVe 模型的位置不同的圖。

word2vec-google-news-300

顯示 GloVe 模型中語意相近/相關的詞在詞向量空間中彼此接近的圖。

glove-wiki-gigaword-50
Python 的 Natural Language Processing(NLP)

一起來練習吧!

Python 的 Natural Language Processing(NLP)

Preparing Video For Download...