使用 R-CNN 的物件偵測

使用 PyTorch 進行影像深度學習

Michal Oleszak

Machine Learning Engineer

以區域為基礎的 CNN 系列:R-CNN

R-CNN 系列:R-CNN、Fast R-CNN、Faster R-CNN
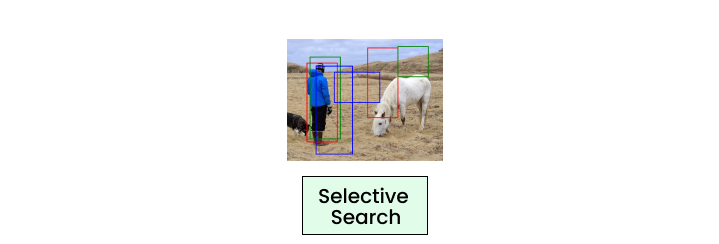
R-CNN

  • 模組 1:產生區域提案
1 出處:Jason Brownlee。2019。Deep Learning for Computer Vision。
使用 PyTorch 進行影像深度學習

以區域為基礎的 CNN 系列:R-CNN

R-CNN 系列:R-CNN、Fast R-CNN、Faster R-CNN
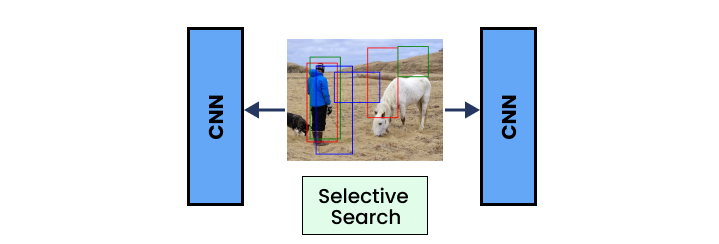
R-CNN

  • 模組 1:產生區域提案
  • 模組 2:特徵擷取(卷積層)
1 出處:Jason Brownlee。2019。Deep Learning for Computer Vision。
使用 PyTorch 進行影像深度學習

以區域為基礎的 CNN 系列:R-CNN

R-CNN 系列:R-CNN、Fast R-CNN、Faster R-CNN
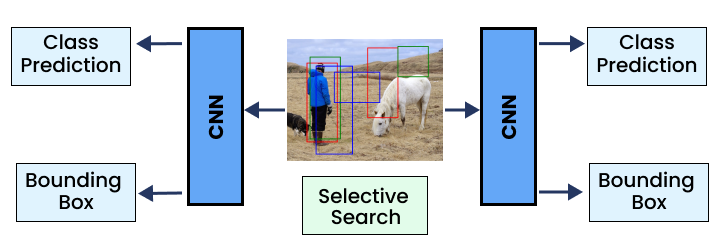
R-CNN

  • 模組 1:產生區域提案
  • 模組 2:特徵擷取(卷積層)
  • 模組 3:類別與邊界框預測
1 出處:Jason Brownlee。2019。Deep Learning for Computer Vision。
使用 PyTorch 進行影像深度學習

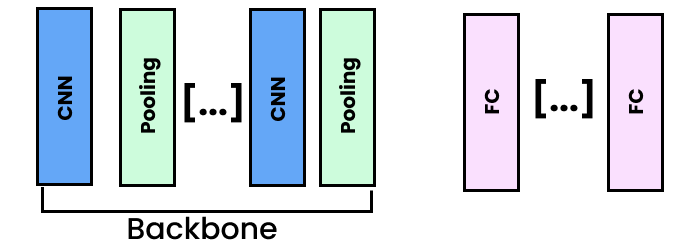
R-CNN:backbone

  • 卷積層:預先訓練模型
    • Backbone:負責特徵擷取的核心 CNN 架構

  backbone

  • 卷積層與池化層
  • 為區域提案與物件偵測擷取特徵
使用 PyTorch 進行影像深度學習

R-CNN:在 PyTorch 使用 backbone

import torch.nn as nn
from torchvision.models import vgg16,
    VGG16_Weights


vgg = vgg16(weights=VGG16_Weights.DEFAULT)

vgg model

使用 PyTorch 進行影像深度學習

R-CNN:在 PyTorch 使用 backbone

import torch.nn as nn
from torchvision.models import vgg16,
    VGG16_Weights


vgg = vgg16(weights=VGG16_Weights.DEFAULT)

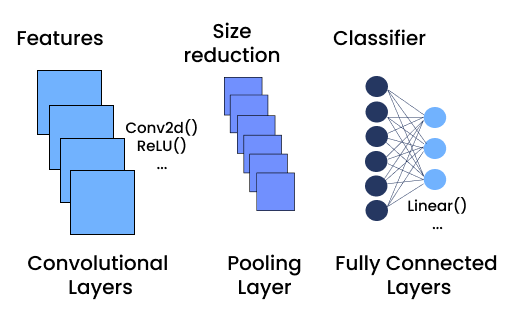
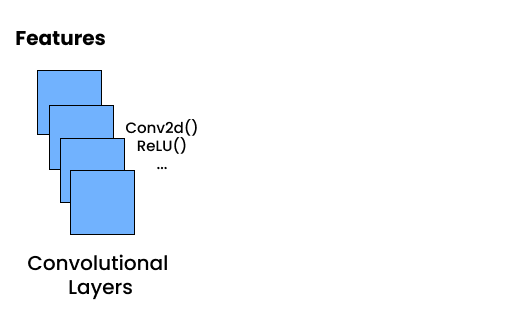
vgg model features

  • .features:僅含卷積層
使用 PyTorch 進行影像深度學習

R-CNN:在 PyTorch 使用 backbone

import torch.nn as nn
from torchvision.models import vgg16,
    VGG16_Weights


vgg = vgg16(weights=VGG16_Weights.DEFAULT)

vgg model

  • .features:僅含卷積層
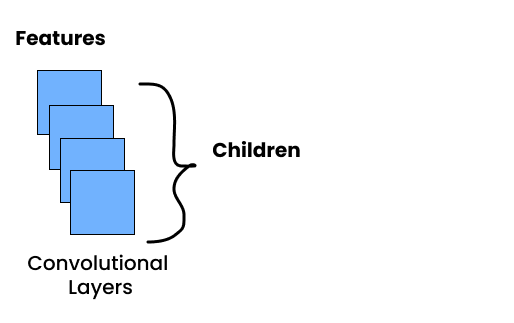
  • .children():區塊中的所有層
使用 PyTorch 進行影像深度學習

R-CNN:在 PyTorch 使用 backbone

import torch.nn as nn
from torchvision.models import vgg16,
    VGG16_Weights


vgg = vgg16(weights=VGG16_Weights.DEFAULT)
backbone = nn.Sequential( *list(vgg.features.children()) )
  • nn.Sequential(*list()):將所有子層以清單放入順序模組
    • *:將清單元素解包

vgg model

  • .features:僅含卷積層
  • .children():區塊中的所有層
使用 PyTorch 進行影像深度學習

R-CNN:分類器層

  • 取得 backbone 的輸出大小
input_dimension = nn.Sequential(*list(
    vgg_backbone.classifier.children())
)[0].in_features
  • 建立新的分類器
classifier = nn.Sequential(
    nn.Linear(input_dimension, 512),
    nn.ReLU(),
    nn.Linear(512, num_classes),
)
使用 PyTorch 進行影像深度學習

R-CNN:框回歸層

  • 位於 backbone 之上
  • 針對 4 個框座標輸出 4 值
box_regressor = nn.Sequential(
    nn.Linear(input_dimension, 32),
    nn.ReLU(),
    nn.Linear(32, 4),
)
使用 PyTorch 進行影像深度學習

整合:物件偵測模型

class ObjectDetectorCNN(nn.Module):
    def __init__(self):
        super(ObjectDetectorCNN, self).__init__()

vgg = vgg16(weights=VGG16_Weights.DEFAULT) self.backbone = nn.Sequential(*list(vgg.features.children()))
input_features = nn.Sequential(*list(vgg.classifier.children()))[0].in_features
self.classifier = nn.Sequential( nn.Linear(input_features, 512), nn.ReLU(), nn.Linear(512, 2), )
self.box_regressor = nn.Sequential( nn.Linear(input_features, 32), nn.ReLU(), nn.Linear(32, 4), )
使用 PyTorch 進行影像深度學習

整合:物件偵測模型

class ObjectDetector(nn.Module):
    (...)

    def forward(self, x):

features = self.backbone(x)
bboxes = self.regressor(features) classes = self.classifier(features) return bboxes, classes
使用 PyTorch 進行影像深度學習

執行物件辨識

  1. 載入並轉換影像
  2. 對影像呼叫 unsqueeze() 加上批次維度
  3. 將影像張量傳入模型
  4. 對輸出執行非極大值抑制(nms()
  5. 在影像上呼叫 draw_bounding_boxes()
使用 PyTorch 進行影像深度學習

一起來練習吧!

使用 PyTorch 進行影像深度學習

Preparing Video For Download...