使用 U-Net 的語意分割

使用 PyTorch 進行影像深度學習

Michal Oleszak

Machine Learning Engineer

語意分割

  • 不區分同類別的不同實例
  • 適用於醫學影像或衛星影像分析
  • 常見架構:U-Net
使用 PyTorch 進行影像深度學習

U-Net 架構

U-Net 架構示意圖

Encoder:

  • 卷積與池化層
  • 向下取樣:減少空間維度並增加深度
使用 PyTorch 進行影像深度學習

U-Net 架構

U-Net 架構示意圖

Decoder:

  • 與 encoder 對稱
  • 以轉置卷積上採樣特徵圖
使用 PyTorch 進行影像深度學習

U-Net 架構

U-Net 架構示意圖

跳接(skip connections):

  • 連結 encoder 與 decoder
  • 保留向下取樣時流失的細節
使用 PyTorch 進行影像深度學習

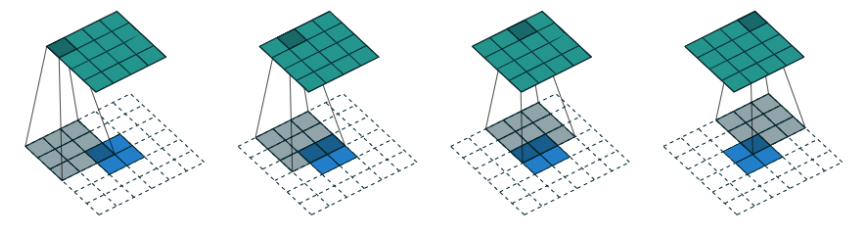
轉置卷積

轉置卷積示意圖

  • 在 decoder 中上採樣特徵圖:增加高度與寬度,同時減少深度
  • 轉置卷積流程:
    1. 在輸入特徵圖之間或周圍插入 0
    2. 對零填充的輸入執行一般卷積
使用 PyTorch 進行影像深度學習

PyTorch 的轉置卷積

import torch.nn as nn

upsample = nn.ConvTranspose2d(
    in_channels=in_channels,
    out_channels=out_channels,
    kernel_size=2,
    stride=2,
)
使用 PyTorch 進行影像深度學習

U-Net:層定義

class UNet(nn.Module):
    def __init__(self, in_channels, out_channels):
        super(UNet, self).__init__()


self.enc1 = self.conv_block(in_channels, 64) self.enc2 = self.conv_block(64, 128) self.enc3 = self.conv_block(128, 256) self.enc4 = self.conv_block(256, 512) self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
self.upconv3 = nn.ConvTranspose2d(512, 256, kernel_size=2, stride=2) self.upconv2 = nn.ConvTranspose2d(256, 128, kernel_size=2, stride=2) self.upconv1 = nn.ConvTranspose2d(128, 64, kernel_size=2, stride=2)
self.dec1 = self.conv_block(512, 256) self.dec2 = self.conv_block(256, 128) self.dec3 = self.conv_block(128, 64) self.out = nn.Conv2d(64, out_channels, kernel_size=1)
  • Encoder:
    • 卷積區塊
      def conv_block(self, in_channels, out_channels):
      return nn.Sequential(
        nn.Conv2d(in_channels, out_channels),
        nn.ReLU(inplace=True),
        nn.Conv2d(out_channels, out_channels),
        nn.ReLU(inplace=True)
      )
      
    • 池化層
  • Decoder:
    • 轉置卷積
    • 卷積區塊
使用 PyTorch 進行影像深度學習

U-Net:forward 方法

def forward(self, x):

x1 = self.enc1(x) x2 = self.enc2(self.pool(x1)) x3 = self.enc3(self.pool(x2)) x4 = self.enc4(self.pool(x3))
x = self.upconv3(x4)
x = torch.cat([x, x3], dim=1)
x = self.dec1(x)
x = self.upconv2(x) x = torch.cat([x, x2], dim=1) x = self.dec2(x) x = self.upconv1(x) x = torch.cat([x, x1], dim=1) x = self.dec3(x)
return self.out(x)
  • 將輸入通過 encoder 的卷積區塊與池化層
  • Decoder 與跳接:
    • 將編碼後的輸入通過轉置卷積
    • 與對應的 encoder 輸出做串接
    • 通過卷積區塊
    • 對所有 decoder 步驟重複以上流程
  • 回傳最後一個 decoder 步驟的輸出
使用 PyTorch 進行影像深度學習

執行推論

model = UNet()
model.eval()


image = Image.open("car.jpg") transform = transforms.Compose([transforms.ToTensor()]) image_tensor = transform(image).unsqueeze(0)
with torch.no_grad(): prediction = model(image_tensor).squeeze(0)
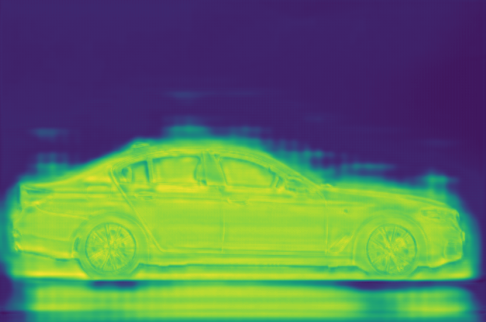
plt.imshow(prediction[1, :, :]) plt.show()

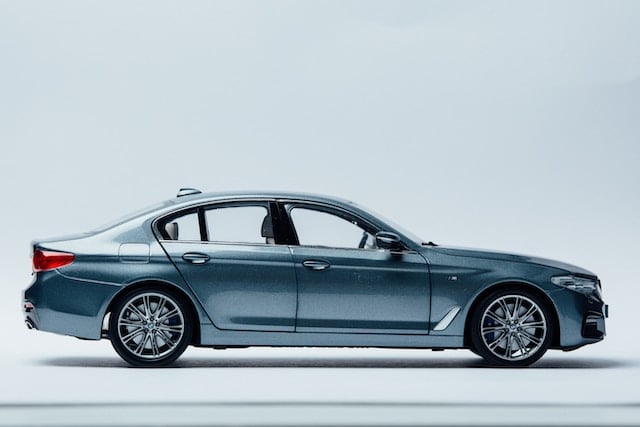
原始汽車影像

套上語意遮罩的汽車影像

使用 PyTorch 進行影像深度學習

一起來練習吧!

使用 PyTorch 進行影像深度學習

Preparing Video For Download...