使用 PySpark 的 Big Data 基礎
Upendra Devisetty
Science Analyst, CyVerse
Resilient Distributed Datasets
Resilient:能承受失敗
Distributed:跨多部機器
Datasets:分割資料的集合,例如陣列、資料表、tuples 等
將現有物件集合平行化
外部資料集:
HDFS 中的檔案
Amazon S3 bucket 中的物件
文字檔中的每一行
從現有 RDD 建立
parallelize()
numRDD = sc.parallelize([1,2,3,4])
helloRDD = sc.parallelize("Hello world")
type(helloRDD)
<class 'pyspark.rdd.PipelinedRDD'>
textFile()
fileRDD = sc.textFile("README.md")
type(fileRDD)
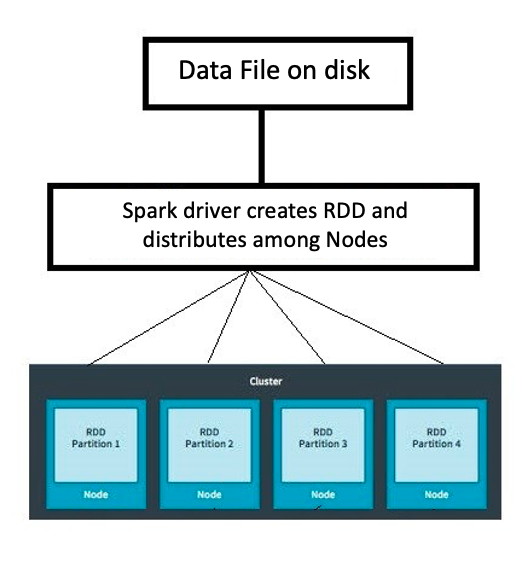
分割區是大型分散式資料集的邏輯切分
parallelize() 方法
numRDD = sc.parallelize(range(10), minPartitions = 6)
fileRDD = sc.textFile("README.md", minPartitions = 6)
getNumPartitions()