PySpark 中的 RDD 操作
使用 PySpark 的 Big Data 基礎

Upendra Devisetty
Science Analyst, CyVerse
PySpark 操作總覽
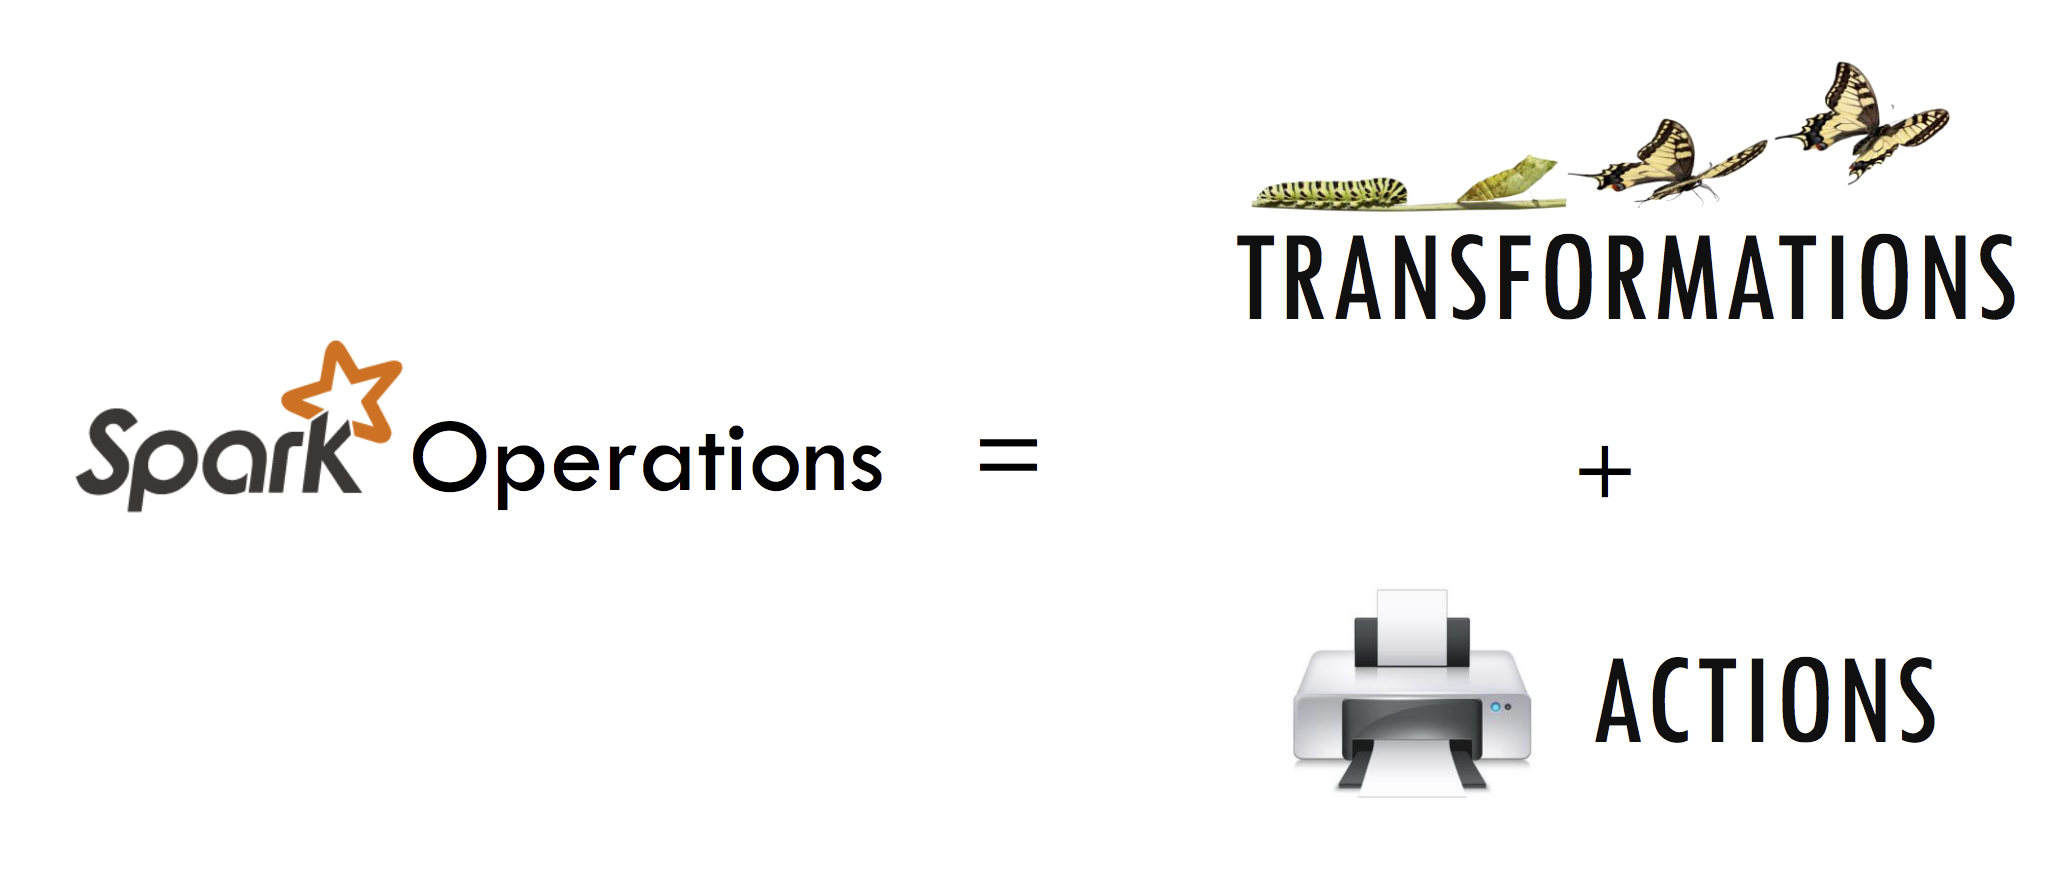
- 轉換(Transformations)會建立新的 RDD
- 動作(Actions)會對 RDD 執行計算
RDD 轉換(Transformations)
- 轉換採用延遲求值(Lazy evaluation)
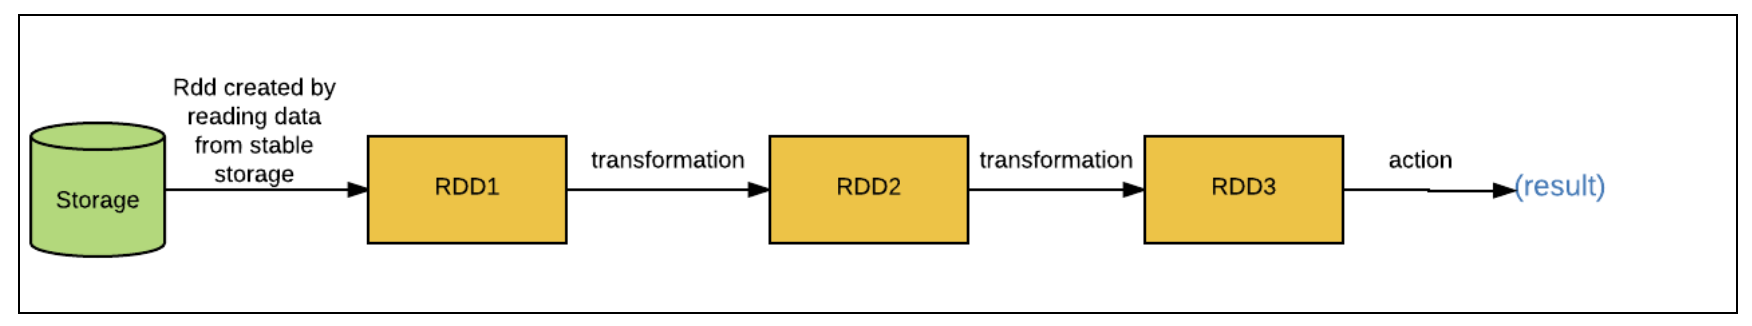
基本 RDD 轉換
map(),filter(),flatMap(), 與union()
map() 轉換
map()轉換會將函式套用到 RDD 的所有元素
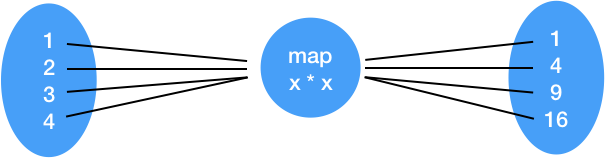
RDD = sc.parallelize([1,2,3,4])
RDD_map = RDD.map(lambda x: x * x)
filter() 轉換
filter轉換會回傳僅包含通過條件的元素之新 RDD
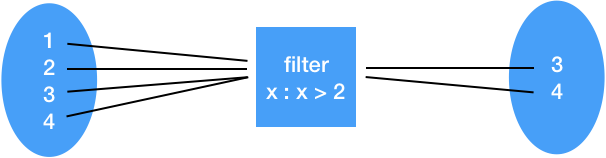
RDD = sc.parallelize([1,2,3,4])
RDD_filter = RDD.filter(lambda x: x > 2)
flatMap() 轉換
flatMap()轉換會為原始 RDD 的每個元素回傳多個值
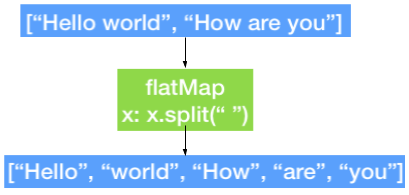
RDD = sc.parallelize(["hello world", "how are you"])
RDD_flatmap = RDD.flatMap(lambda x: x.split(" "))
union() 轉換
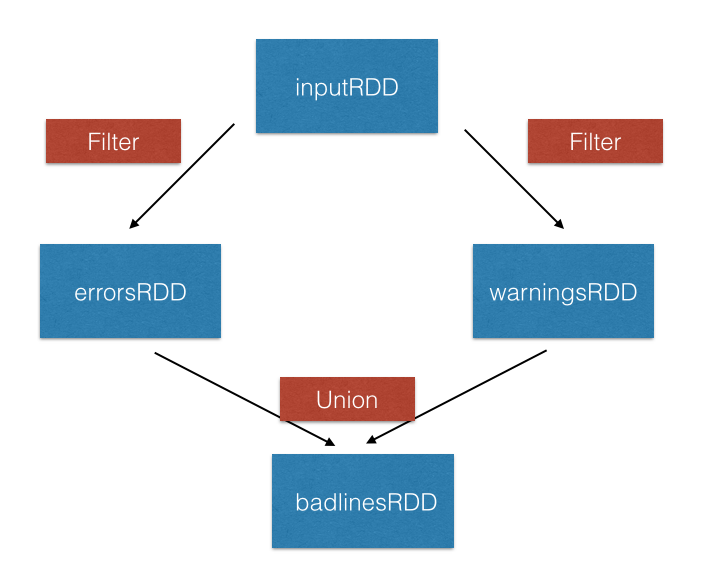
inputRDD = sc.textFile("logs.txt")
errorRDD = inputRDD.filter(lambda x: "error" in x.split())
warningsRDD = inputRDD.filter(lambda x: "warnings" in x.split())
combinedRDD = errorRDD.union(warningsRDD)

