編碼器 Transformer

Transformer Models with PyTorch

James Chapman

Curriculum Manager, DataCamp

原始的 Transformer
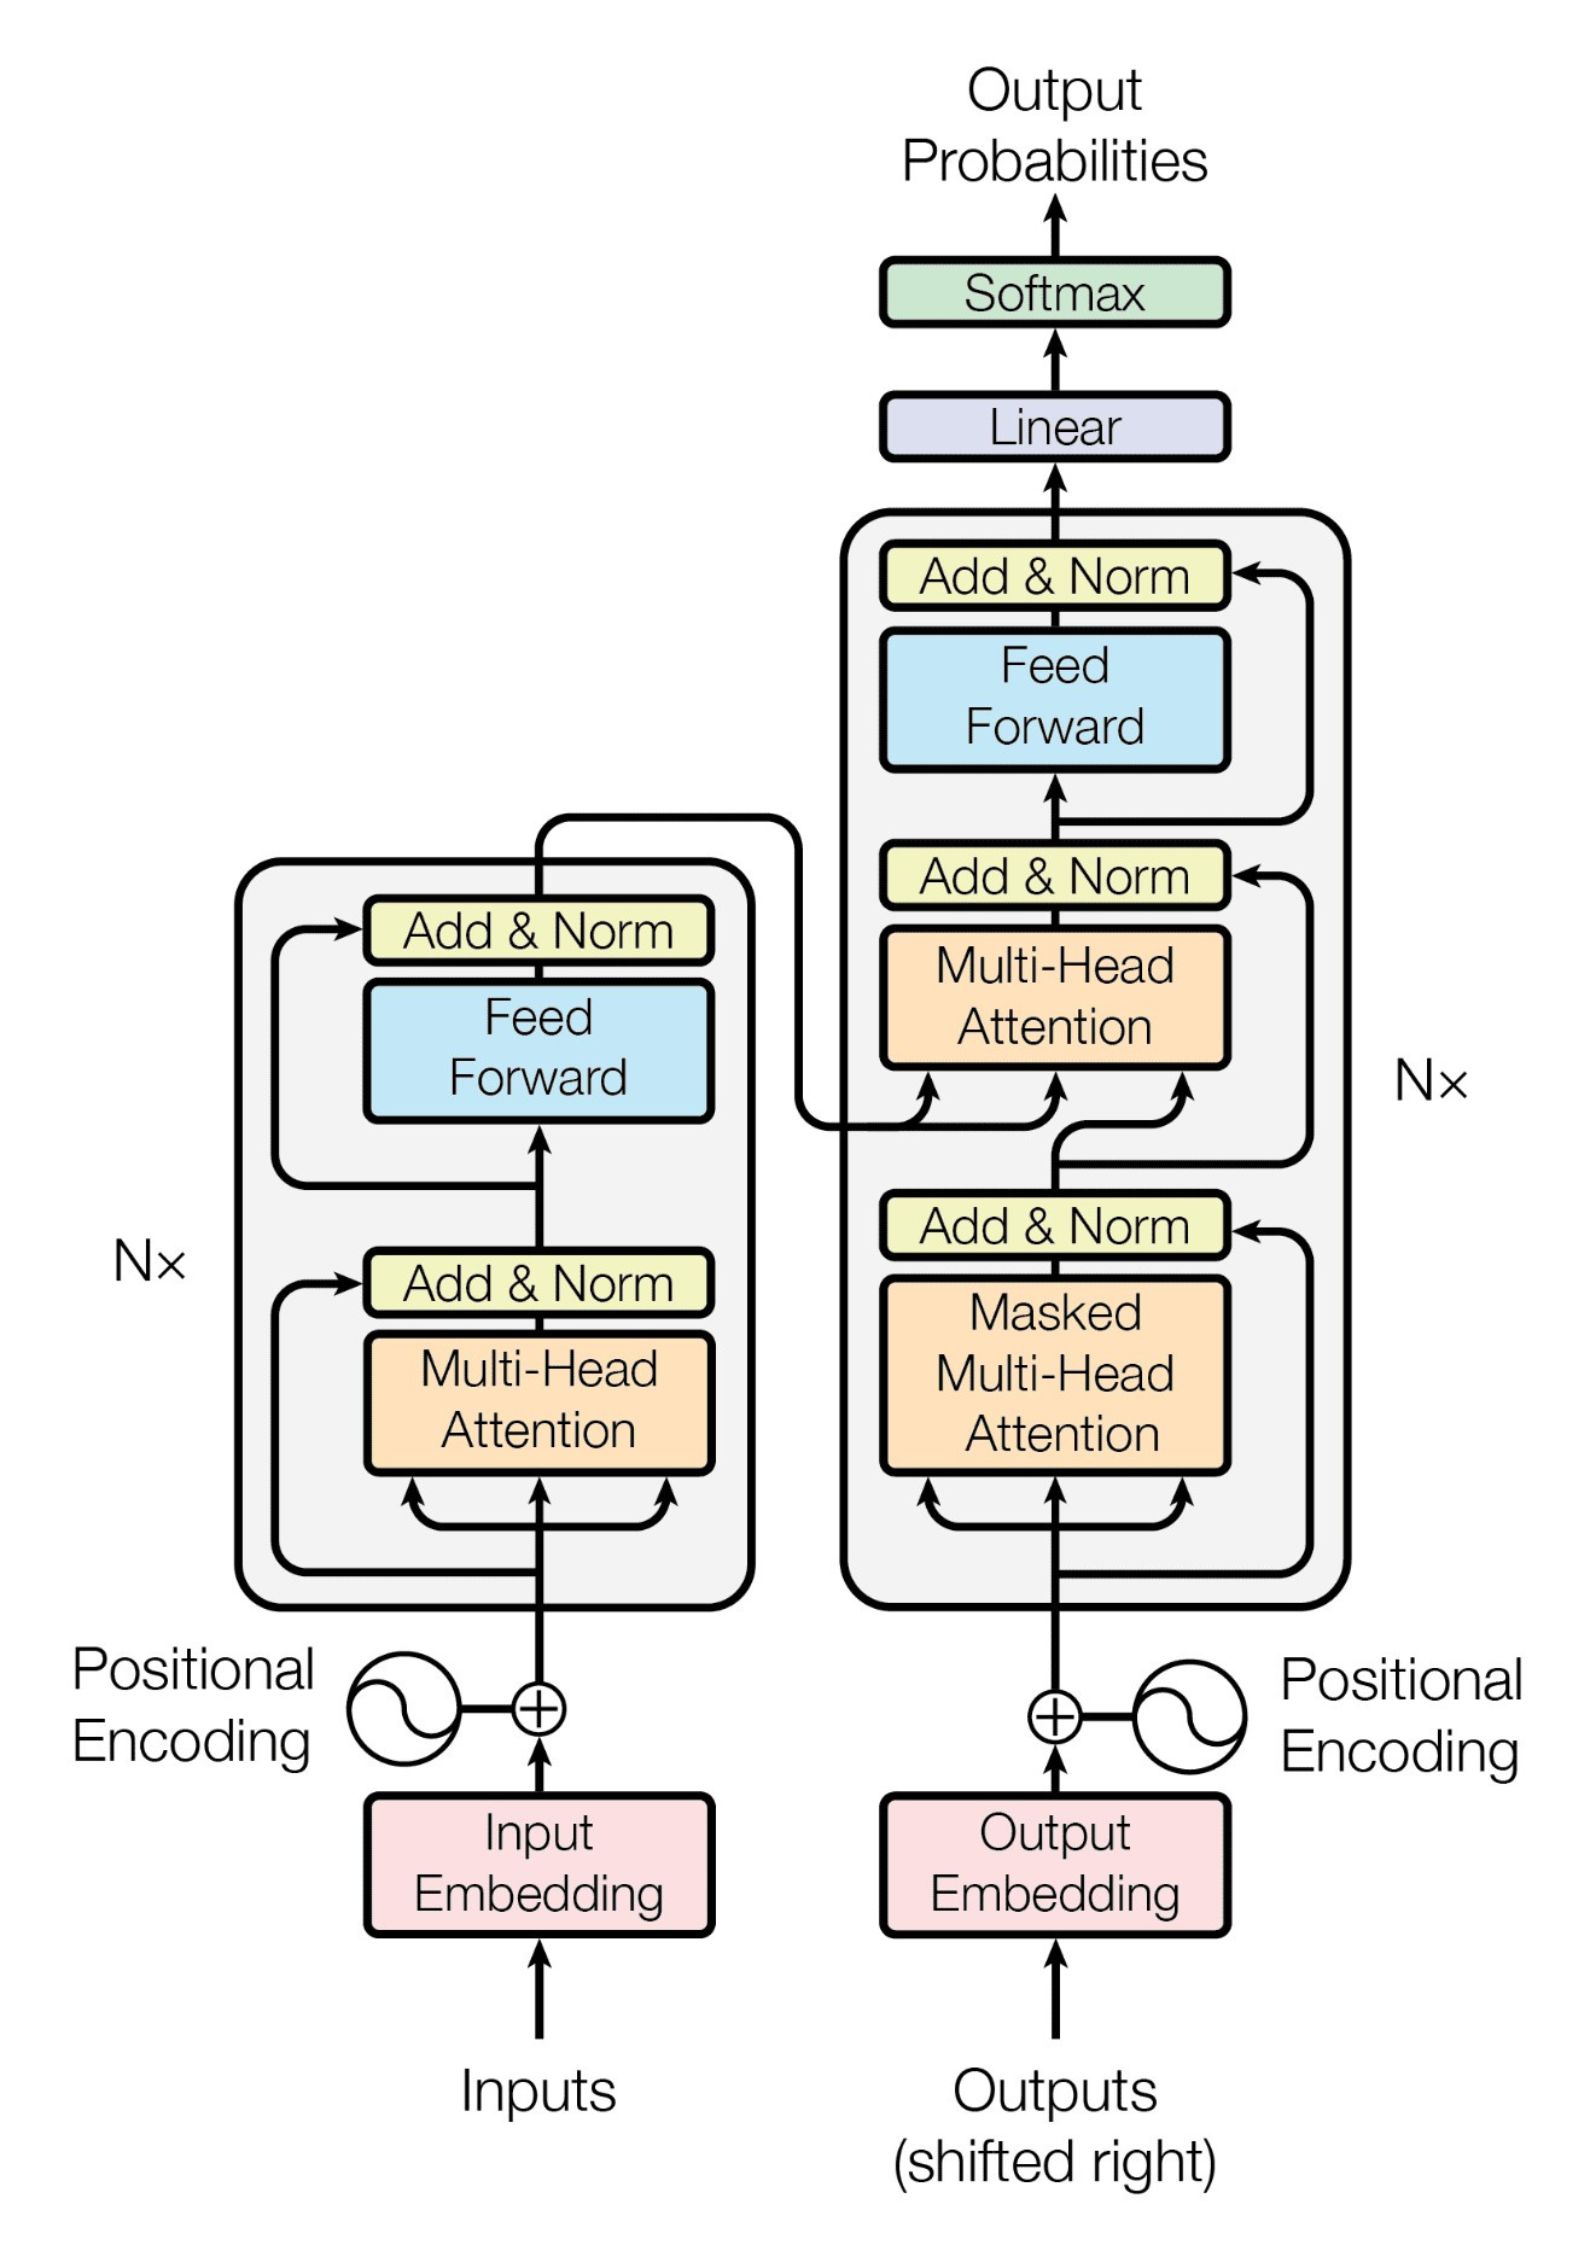
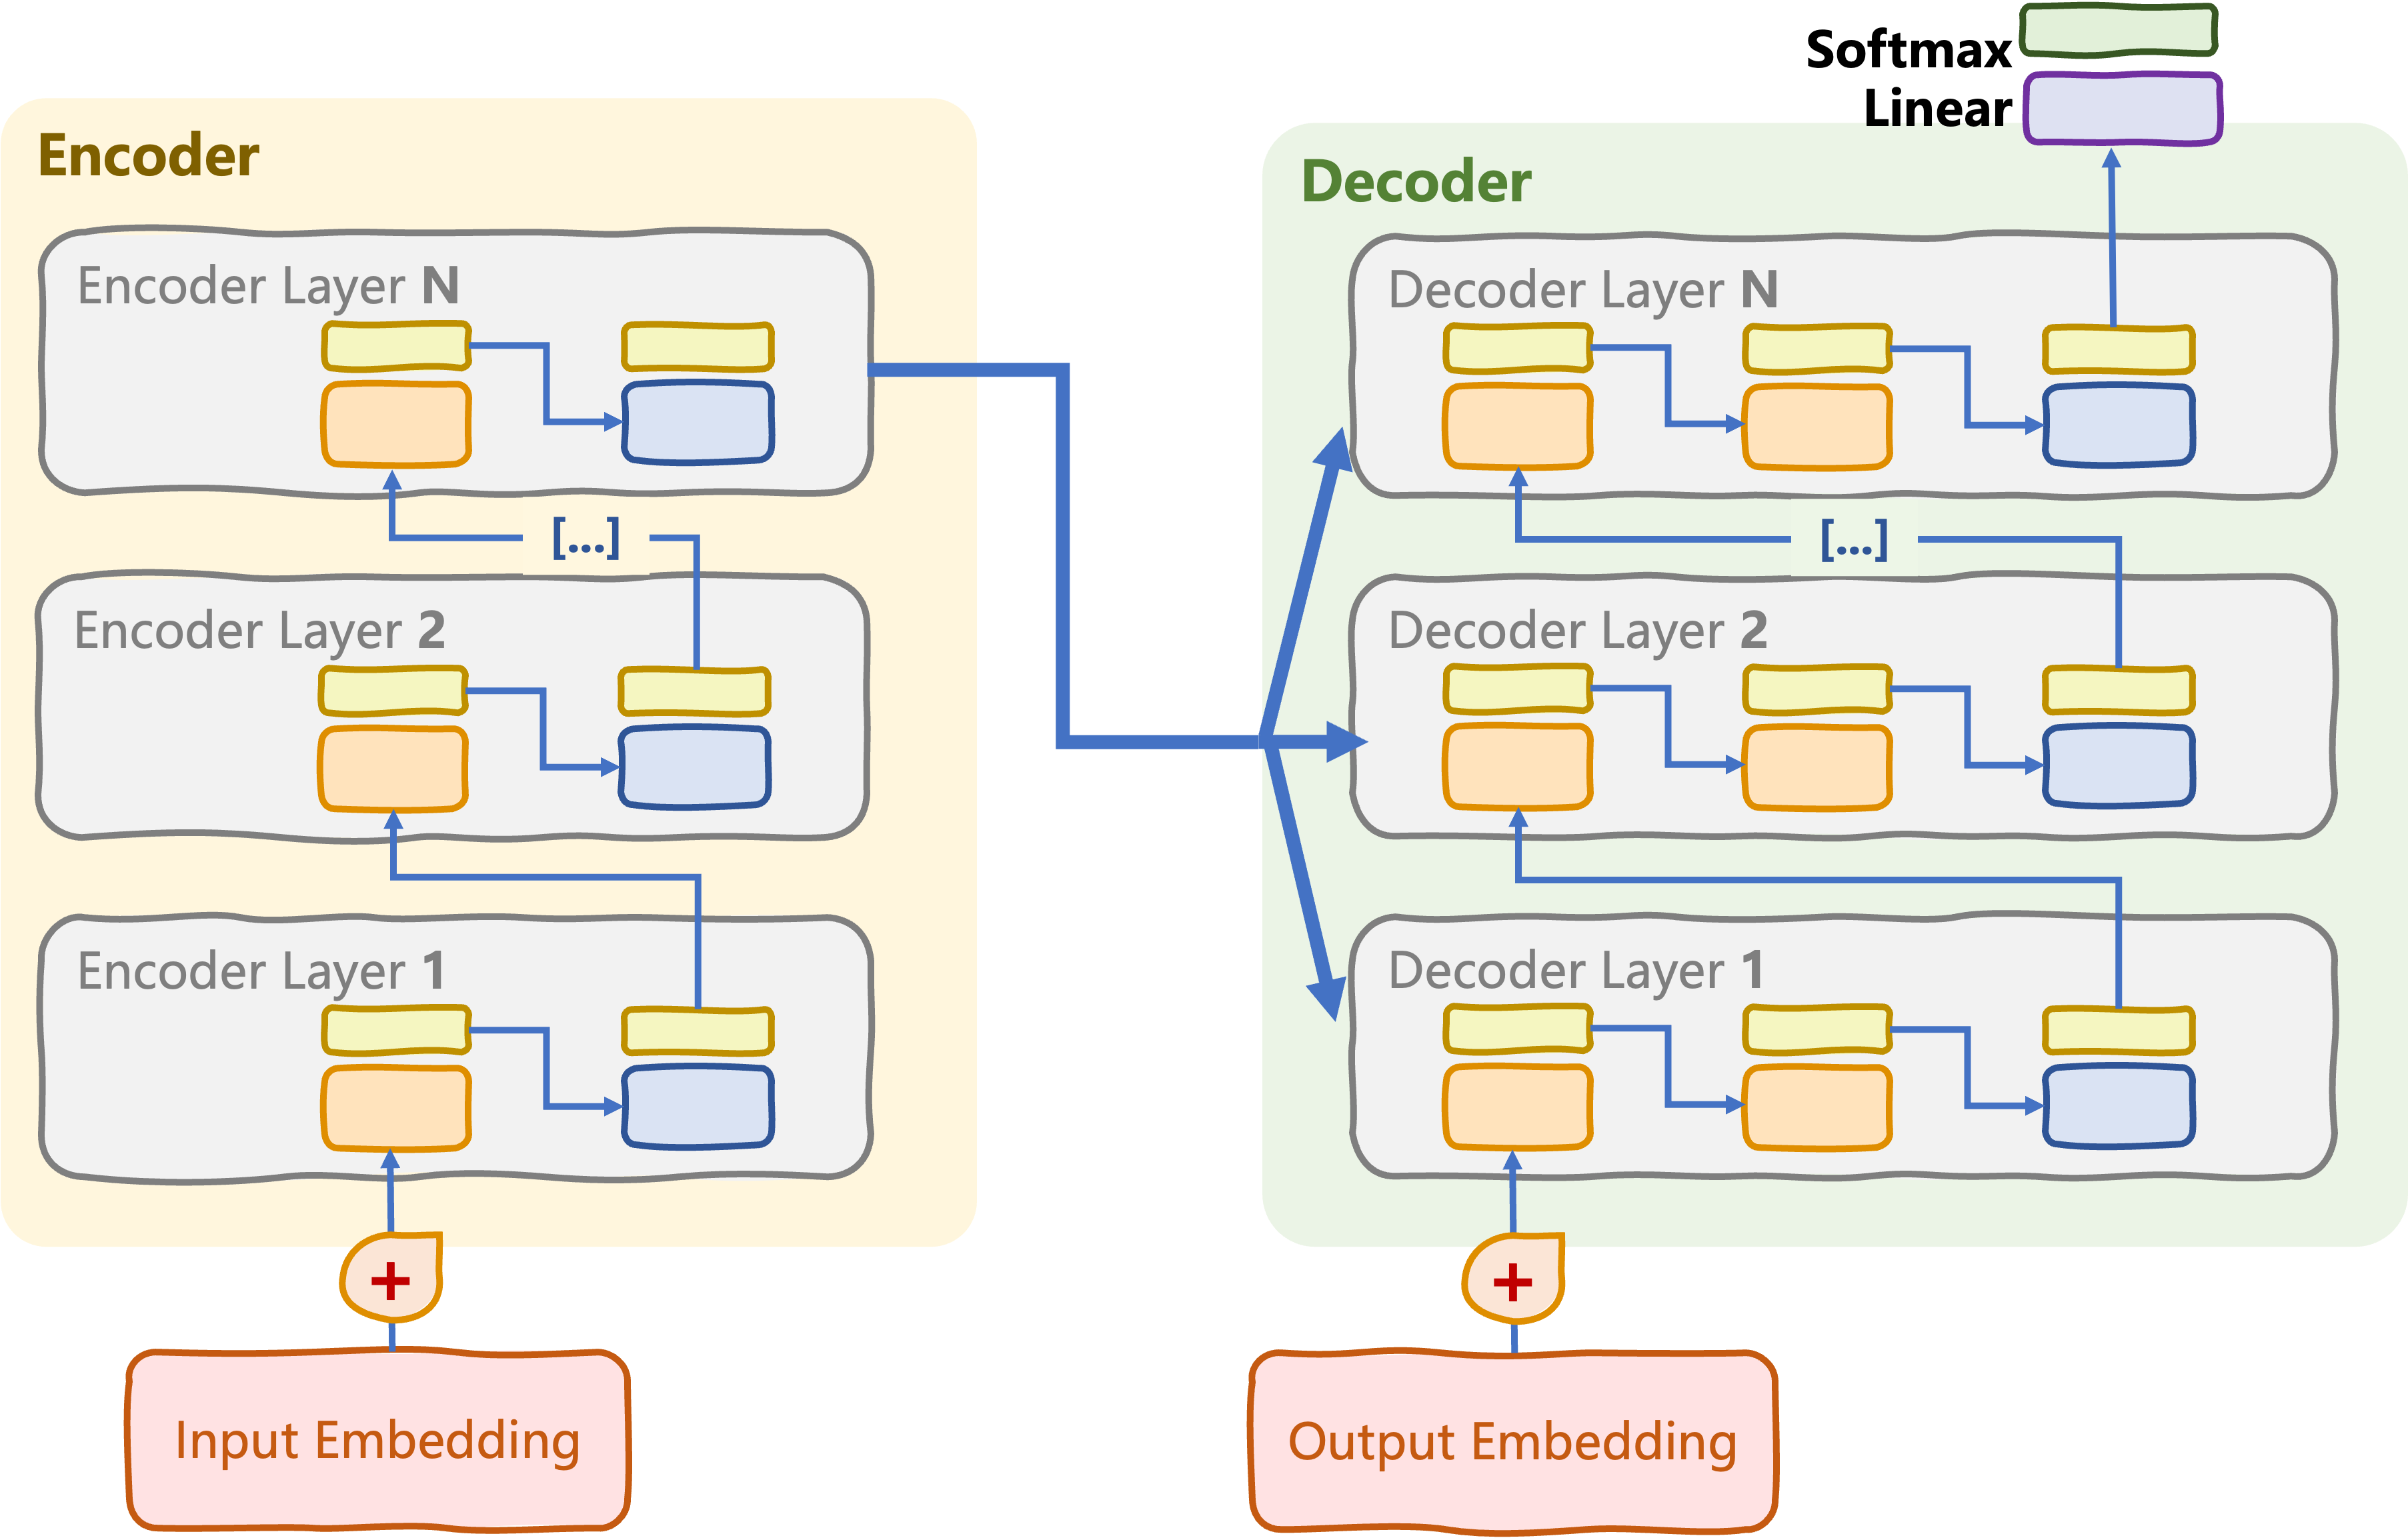
學術論文「Attention Is All You Need」中的 Transformer 架構。

Transformer Models with PyTorch

原始的 Transformer

原始 Transformer 架構

Transformer Models with PyTorch

僅編碼器的 Transformer

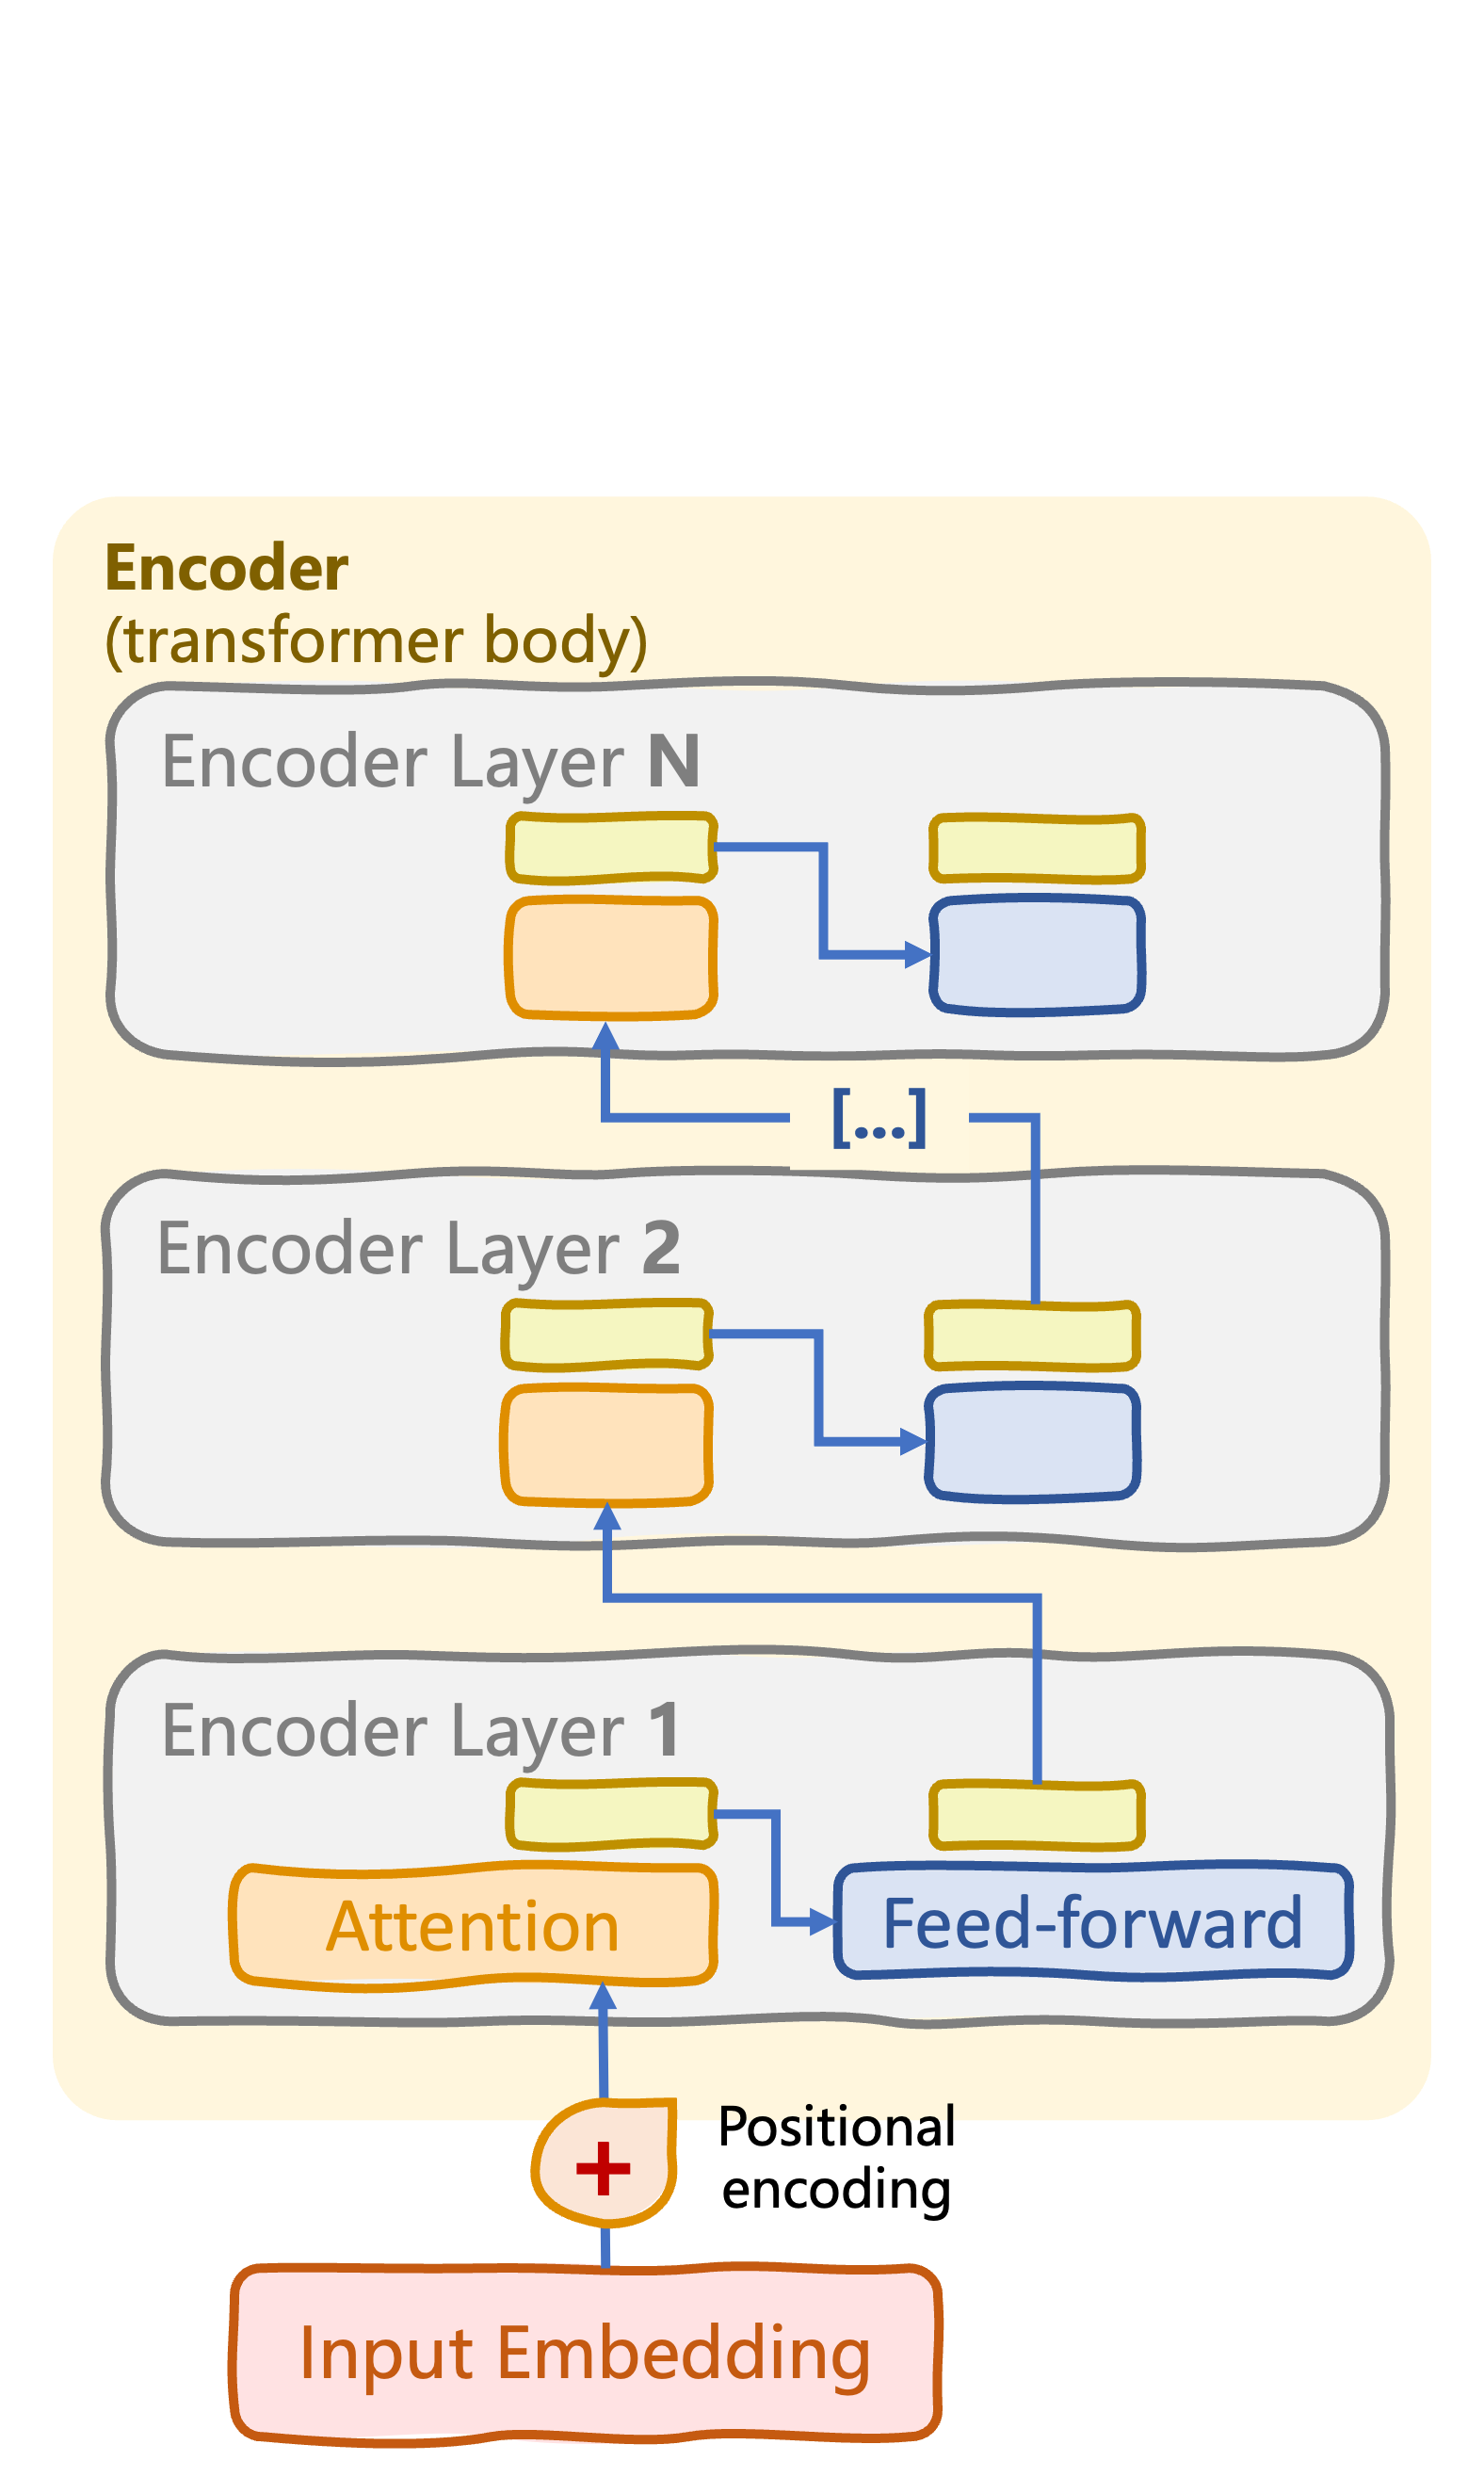
僅編碼器的 Transformer 架構

Transformer 主體:由 N 個編碼器層組成的編碼器堆疊

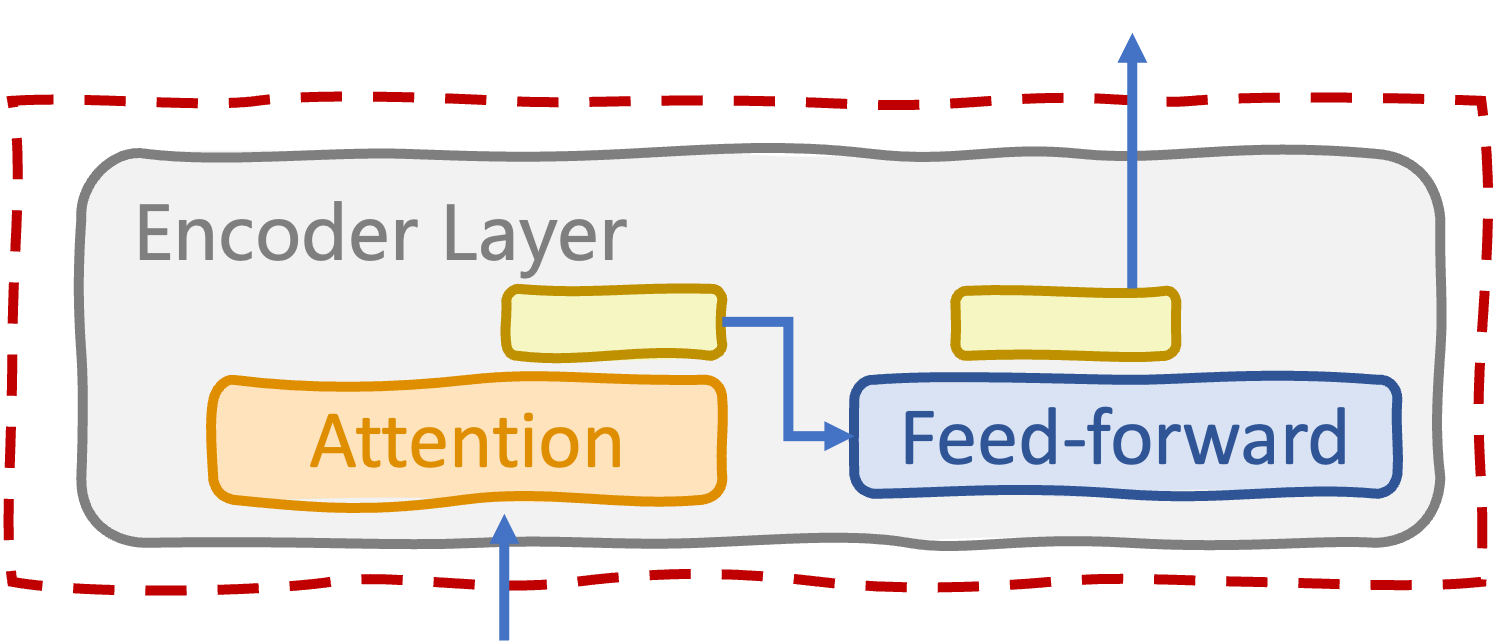
編碼器層

  • 多頭自注意力
  • 前饋(子)層
  • 層正規化、dropout

Transformer 頭

Transformer Models with PyTorch

僅編碼器的 Transformer

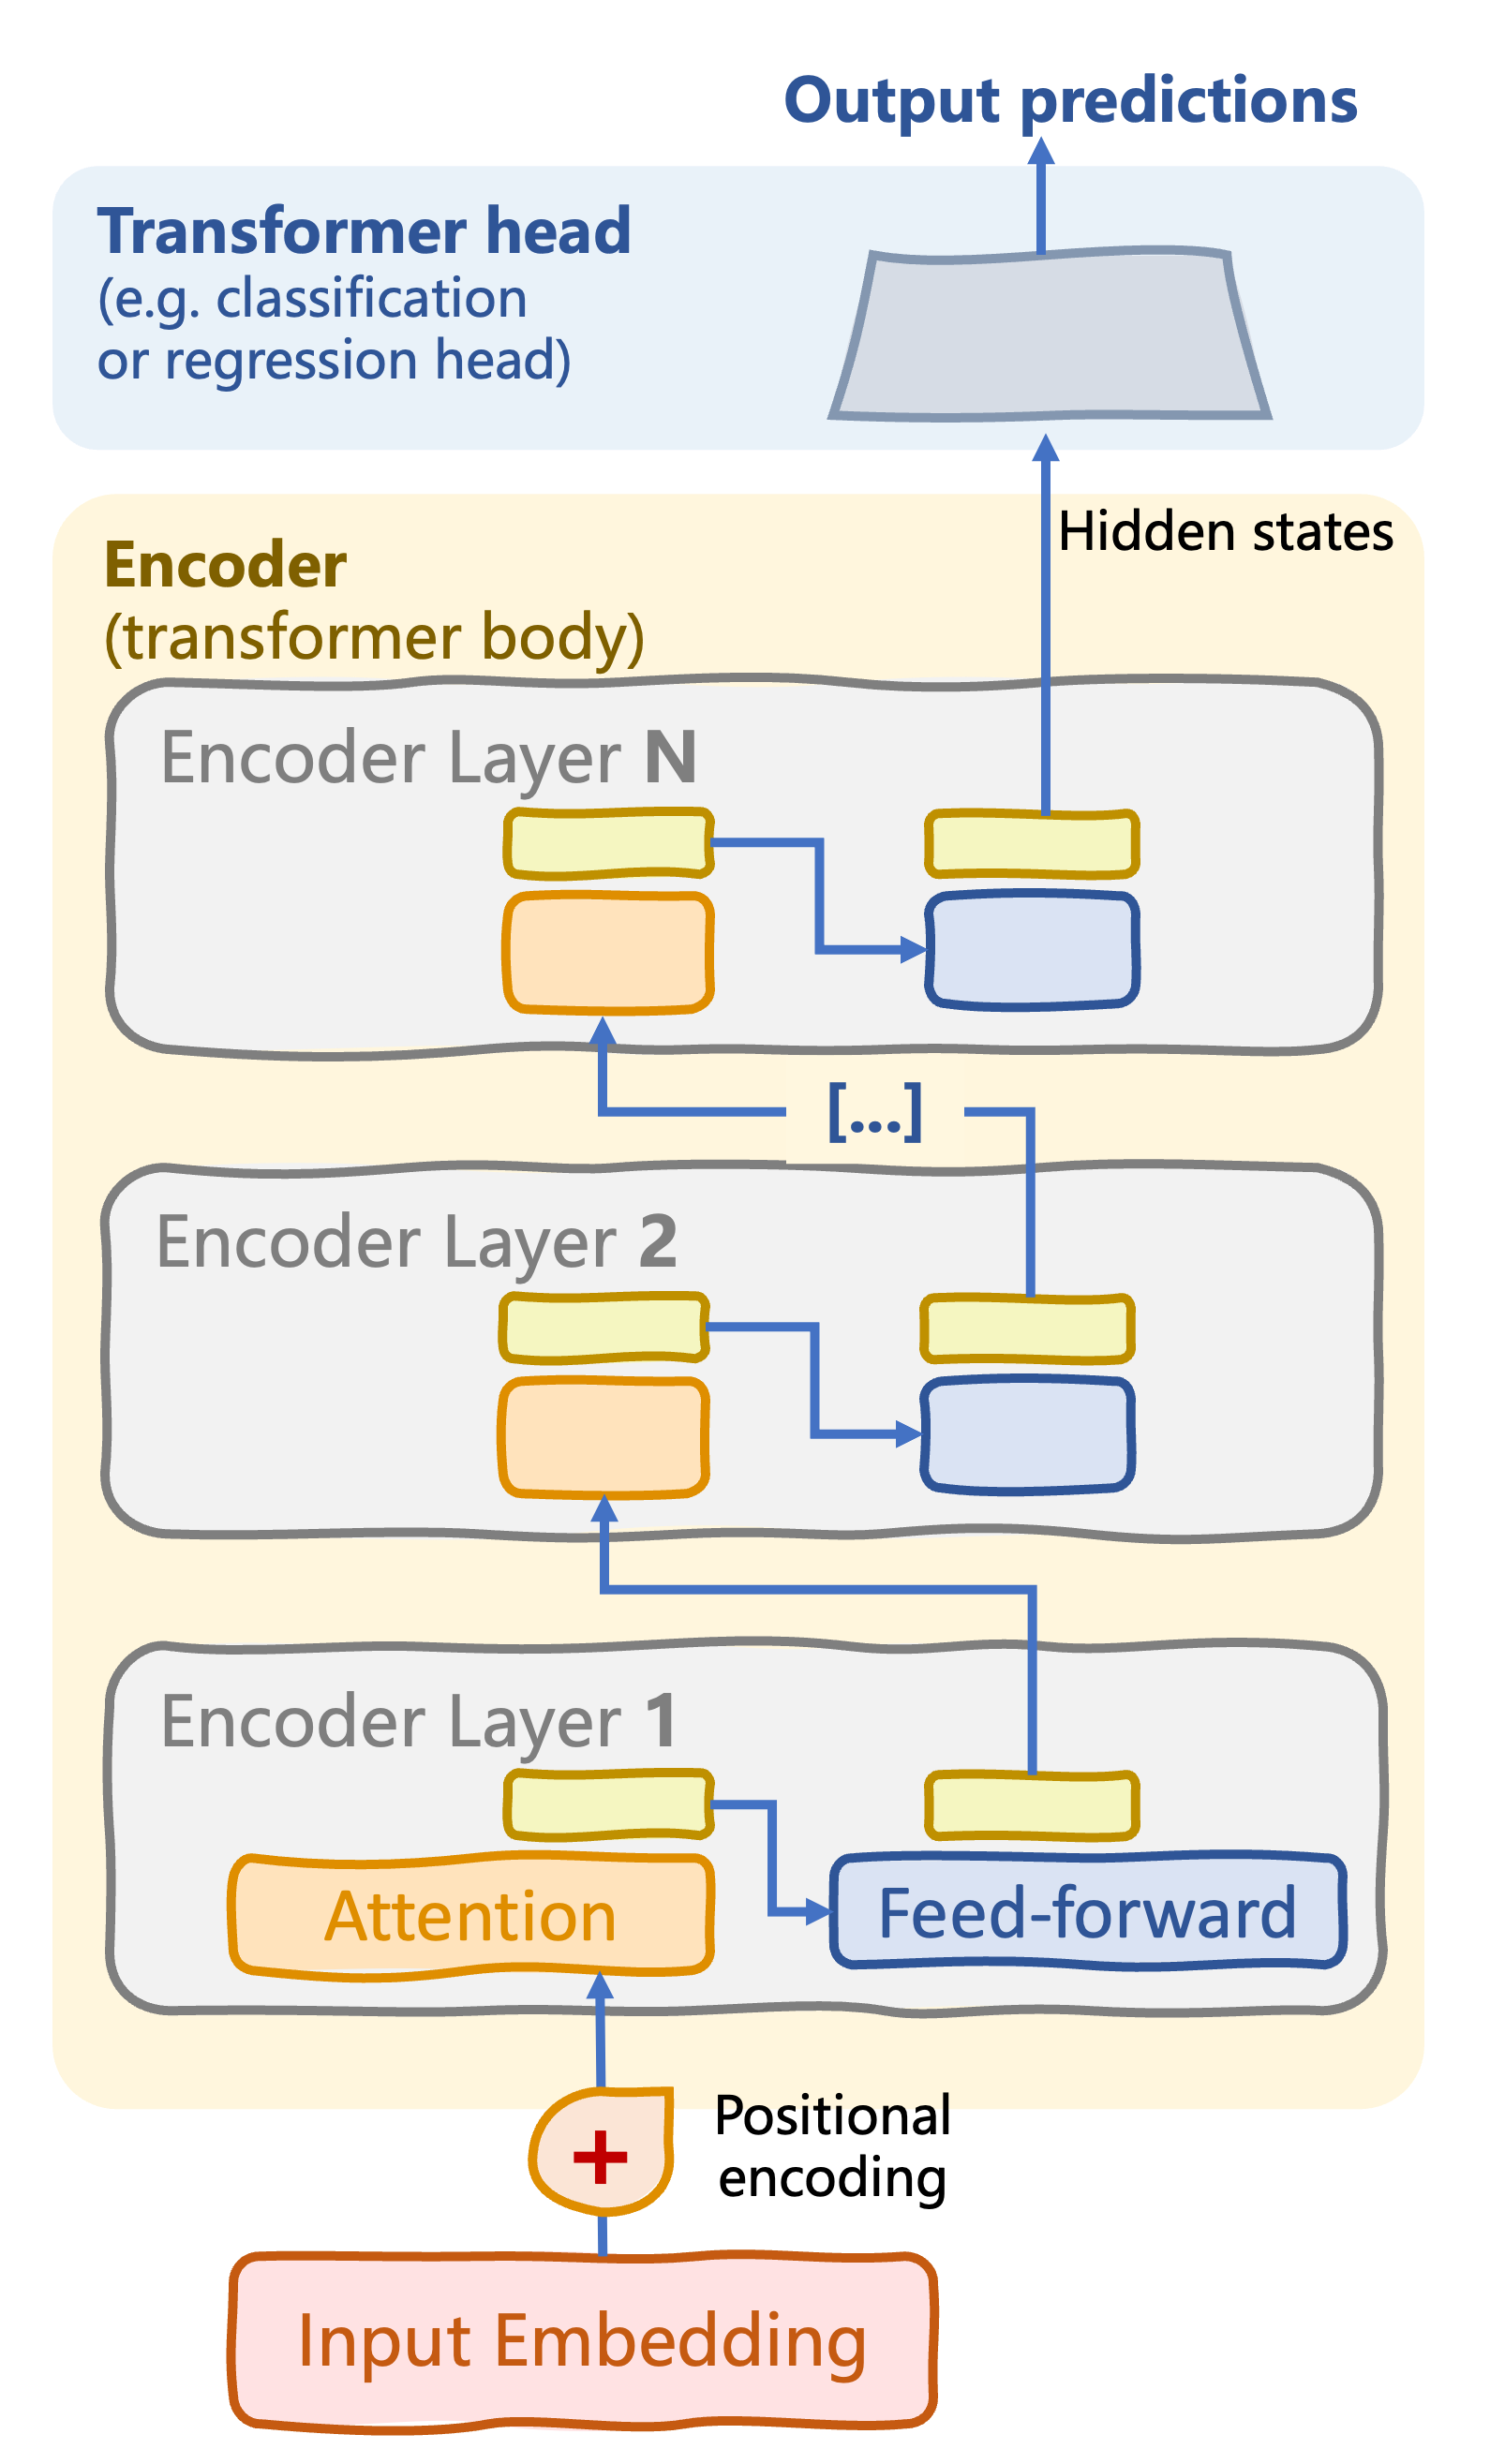
僅編碼器的 Transformer 架構

Transformer 主體:由 N 個編碼器層組成的編碼器堆疊

編碼器層

  • 多頭自注意力
  • 前饋(子)層
  • 層正規化、dropout

Transformer 頭:處理已編碼輸入以產生輸出預測

監督式任務:分類、迴歸

Transformer Models with PyTorch

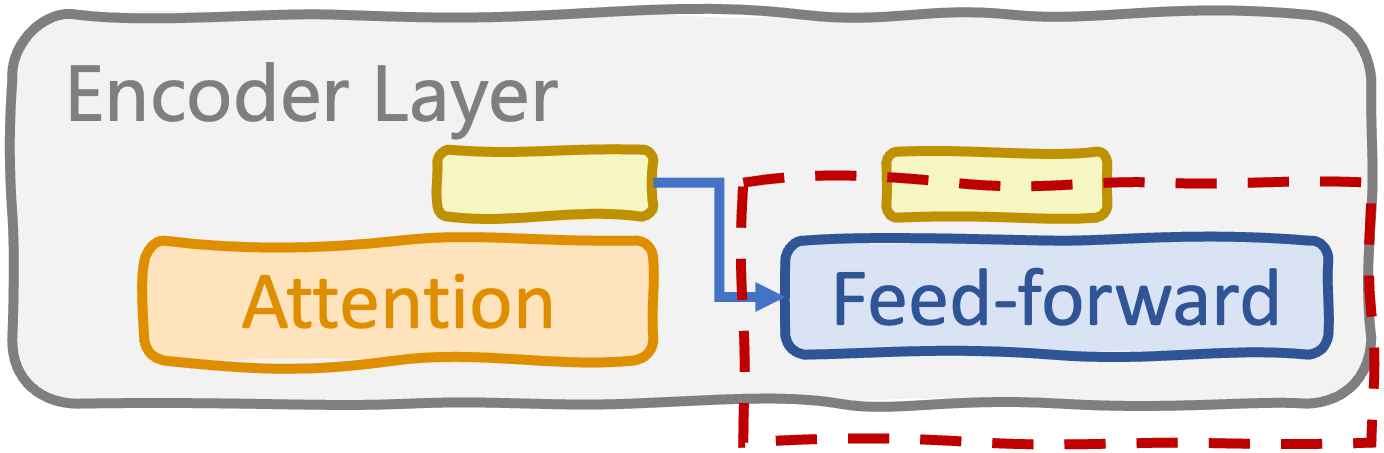
編碼器層中的前饋子層

注意力後的前饋子層

class FeedForwardSubLayer(nn.Module):
    def __init__(self, d_model, d_ff):
        super().__init__()
        self.fc1 = nn.Linear(d_model, d_ff)
        self.fc2 = nn.Linear(d_ff, d_model)
        self.relu = nn.ReLU()


def forward(self, x): return self.fc2(self.relu(self.fc1(x)))

2全連接層 + ReLU 啟用

  • d_ff:線性層之間的維度

  • forward():處理注意力輸出以擷取複雜的非線性模式

Transformer Models with PyTorch

編碼器層

class EncoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, dropout):
        super().__init__()
        self.self_attn = MultiHeadAttention(d_model, num_heads)
        self.ff_sublayer = FeedForwardSubLayer(d_model, d_ff)

self.norm1 = nn.LayerNorm(d_model) self.norm2 = nn.LayerNorm(d_model) self.dropout = nn.Dropout(dropout)
def forward(self, x, src_mask): attn_output = self.self_attn(x, x, x, src_mask) x = self.norm1(x + self.dropout(attn_output)) ff_output = self.ff_sublayer(x) x = self.norm2(x + self.dropout(ff_output)) return x

編碼器層

  • 多頭自注意力
  • 前饋子層
  • 層正規化與 dropout

forward()

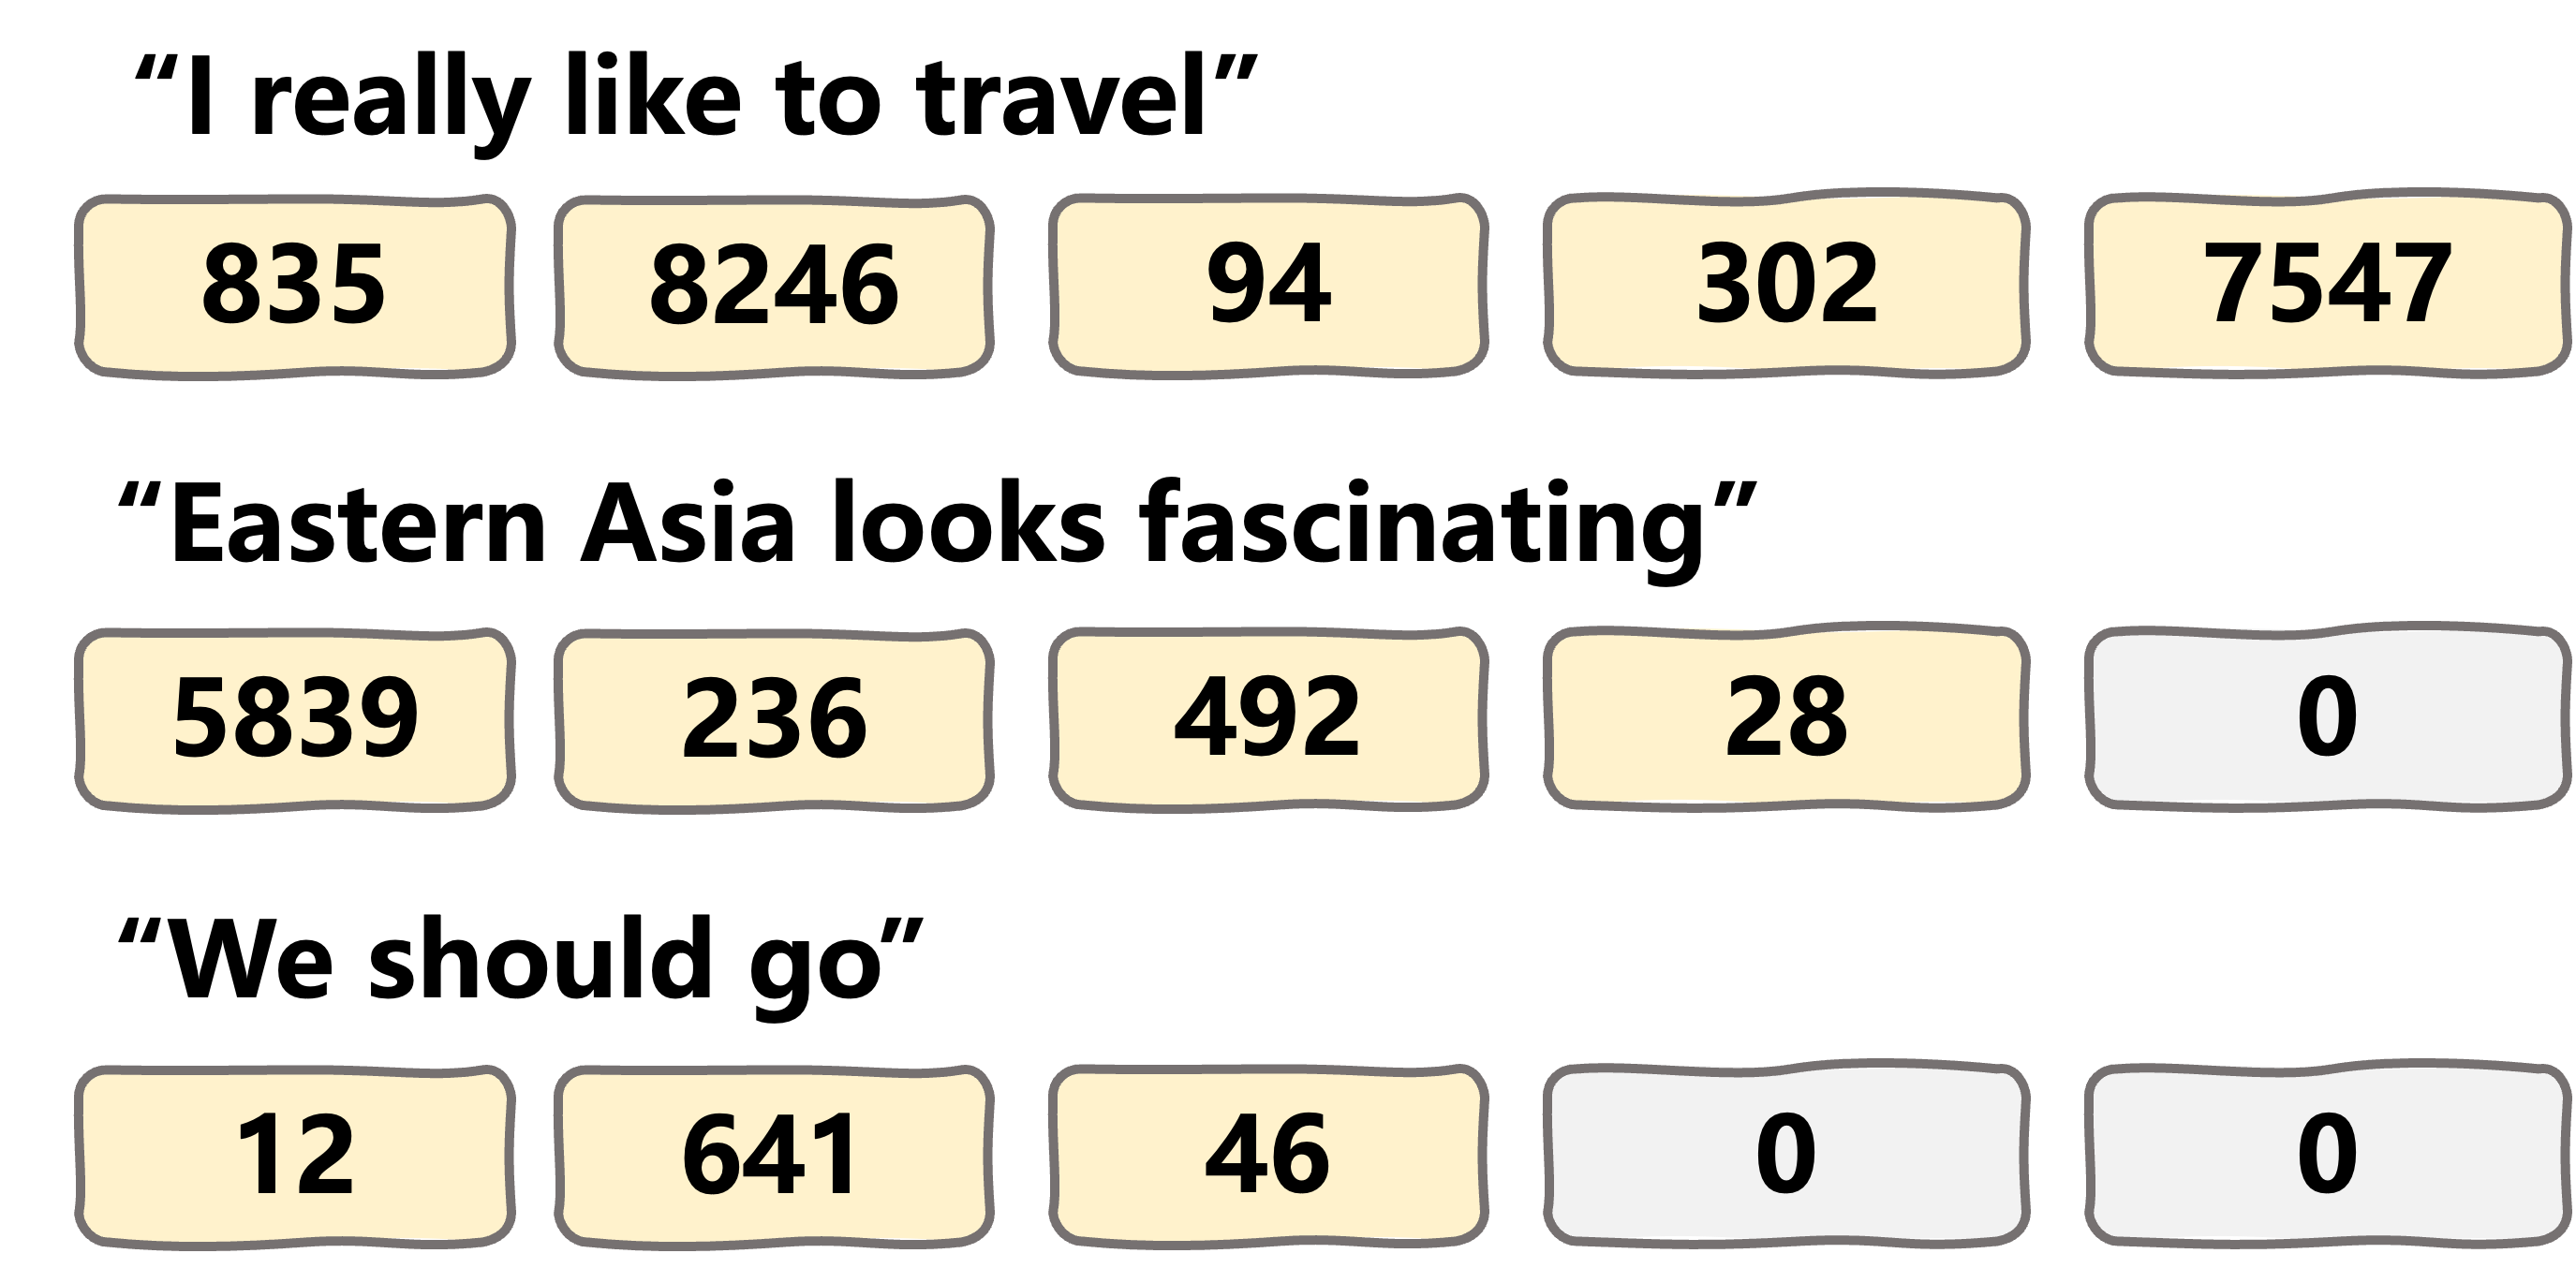
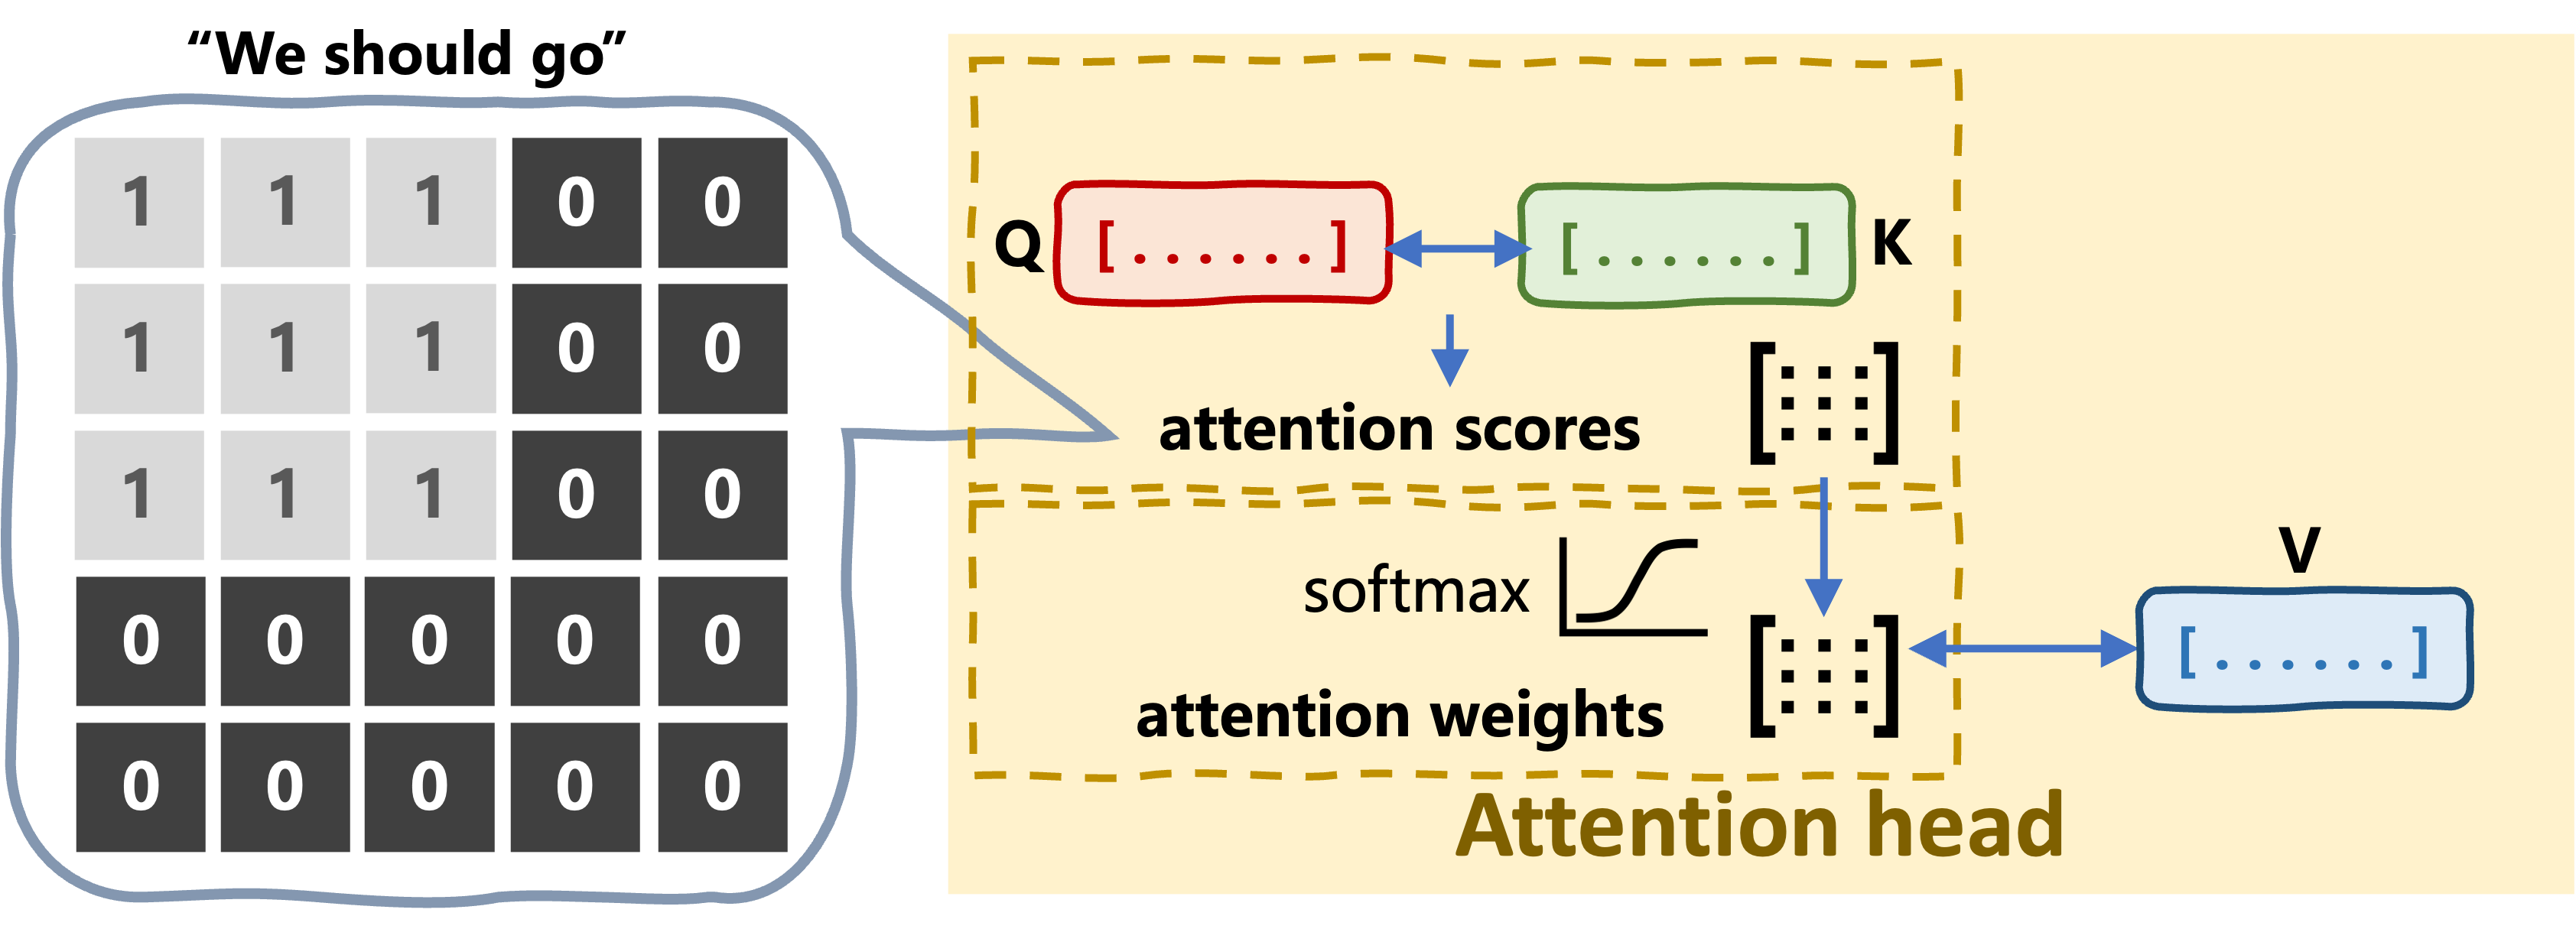
  • mask 可避免處理 padding 標記
Transformer Models with PyTorch

在注意力中套用遮罩

序列補齊(padding)

自注意力中的 padding 遮罩

Transformer Models with PyTorch

編碼器 Transformer 主體

class TransformerEncoder(nn.Module):
    def __init__(self, vocab_size, d_model, num_layers, num_heads, d_ff, dropout, max_seq_length):
        super().__init__()

self.embedding = InputEmbeddings(vocab_size, d_model)
self.positional_encoding = PositionalEncoding(d_model, max_seq_length)
self.layers = nn.ModuleList( [EncoderLayer(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)] )
def forward(self, x, src_mask): x = self.embedding(x) x = self.positional_encoding(x) for layer in self.layers: x = layer(x, src_mask) return x
Transformer Models with PyTorch

編碼器 Transformer 的頭

class ClassifierHead(nn.Module):
    def __init__(self, d_model, num_classes):
        super().__init__()
        self.fc = nn.Linear(d_model, num_classes)

    def forward(self, x):
        logits = self.fc(x)
        return F.log_softmax(logits, dim=-1)
class RegressionHead(nn.Module):
    def __init__(self, d_model, output_dim):
        super().__init__()
        self.fc = nn.Linear(d_model, output_dim)

    def forward(self, x):
        return self.fc(x)

分類頭

  • 任務:文字分類、情緒分析、NER、擷取式 QA 等
  • fc全連接線性層
    • 將編碼器隱藏狀態轉為 num_classes 的類別機率

迴歸頭

  • 任務:估計文本可讀性、語言複雜度等
    • 預測單一數值時,output_dim 為 1
Transformer Models with PyTorch

一起來練習吧!

Transformer Models with PyTorch

Preparing Video For Download...