用 PySpark 與 SQL 整形資料

在 Databricks 使用 Spark SQL 進行資料轉換

Disha Mukherjee

Lead Data Engineer

整形你的資料

path = "/Volumes/.../default/transactions.csv"
df = spark.read.csv(path, header=True, inferSchema=True)
df.show(5, truncate=False)
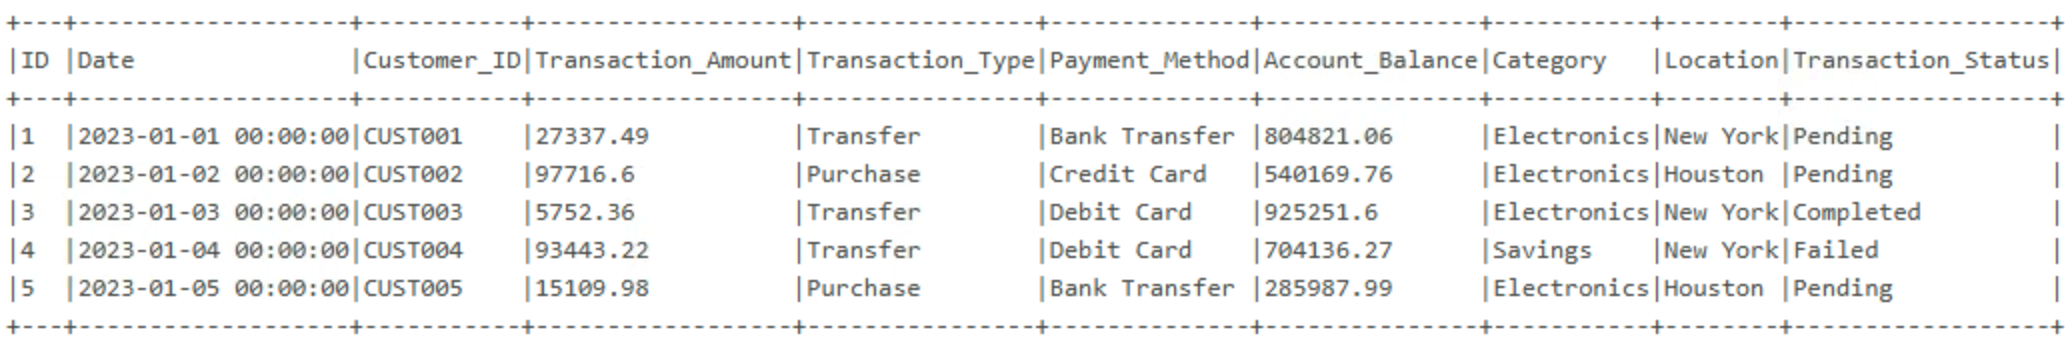
在 Databricks 預覽輸出

  • select() → 選欄
  • filter() → 選列
在 Databricks 使用 Spark SQL 進行資料轉換

選取欄位

df.select("ID", "Customer_ID", "Transaction_Amount", "Category").show(5)
+---+-----------+------------------+-----------+
| ID|Customer_ID|Transaction_Amount|   Category|
+---+-----------+------------------+-----------+
|  1|    CUST001|          27337.49|Electronics|
|  2|    CUST002|           97716.6|Electronics|
|  3|    CUST003|           5752.36|Electronics|
|  4|    CUST004|          93443.22|    Savings|
|  5|    CUST005|          15109.98|Electronics|
+---+-----------+------------------+-----------+
在 Databricks 使用 Spark SQL 進行資料轉換

篩選列

from pyspark.sql import functions as F


filtered_df = df.filter(F.col("Transaction_Status") == "Completed") filtered_df.show(5)
+---+-------------------+-----------+------------------+------------------+
| ID|               Date|Customer_ID|Transaction_Amount|Transaction_Status|
+---+-------------------+-----------+------------------+------------------+
|  3|2023-01-03 00:00:00|    CUST003|           5752.36|         Completed|
|  9|2023-01-09 00:00:00|    CUST009|          28959.12|         Completed|
| 10|2023-01-10 00:00:00|    CUST010|          72098.18|         Completed|
| 11|2023-01-11 00:00:00|    CUST011|          49771.05|         Completed|
| 20|2023-01-20 00:00:00|    CUST020|          69825.14|         Completed|
+---+-------------------+-----------+------------------+------------------+
在 Databricks 使用 Spark SQL 進行資料轉換

組合篩選條件

high_value_df = df.filter(

(F.col("Transaction_Amount") > 20000) &
(F.col("Transaction_Status") == "Completed")
) high_value_df.show(3)
+---+-------------------+-----------+------------------+------------------+
| ID|               Date|Customer_ID|Transaction_Amount|Transaction_Status|
+---+-------------------+-----------+------------------+------------------+
|  9|2023-01-09 00:00:00|    CUST009|          28959.12|         Completed|
| 10|2023-01-10 00:00:00|    CUST010|          72098.18|         Completed|
| 11|2023-01-11 00:00:00|    CUST011|          49771.05|         Completed|
+---+-------------------+-----------+------------------+------------------+
在 Databricks 使用 Spark SQL 進行資料轉換

用 Python 方法或 SQL


  • Python 方法select()filter()
    • 逐步建立轉換


$$

$$

  • SQL 查詢:標準 SQL 語法
    • 聚合與分組更易讀

Python 對比 SQL

在 Databricks 使用 Spark SQL 進行資料轉換

建立暫存檢視

$$

df.createOrReplaceTempView("transactions")


  • Temporary view = 指向 DataFrame 的名稱
  • 僅在目前 Spark 工作階段有效
在 Databricks 使用 Spark SQL 進行資料轉換

用 SQL 查詢

%sql
SELECT Category, COUNT(*) AS transaction_count

FROM transactions
WHERE Transaction_Status = 'Completed' GROUP BY Category ORDER BY transaction_count DESC
+-----------+-----------------+
|   Category|transaction_count|
+-----------+-----------------+
|   Clothing|             6764|
|     Dining|             6732|
|Electronics|             6640|
|    Savings|             6629|
|  Groceries|             6557|
+-----------+-----------------+
在 Databricks 使用 Spark SQL 進行資料轉換

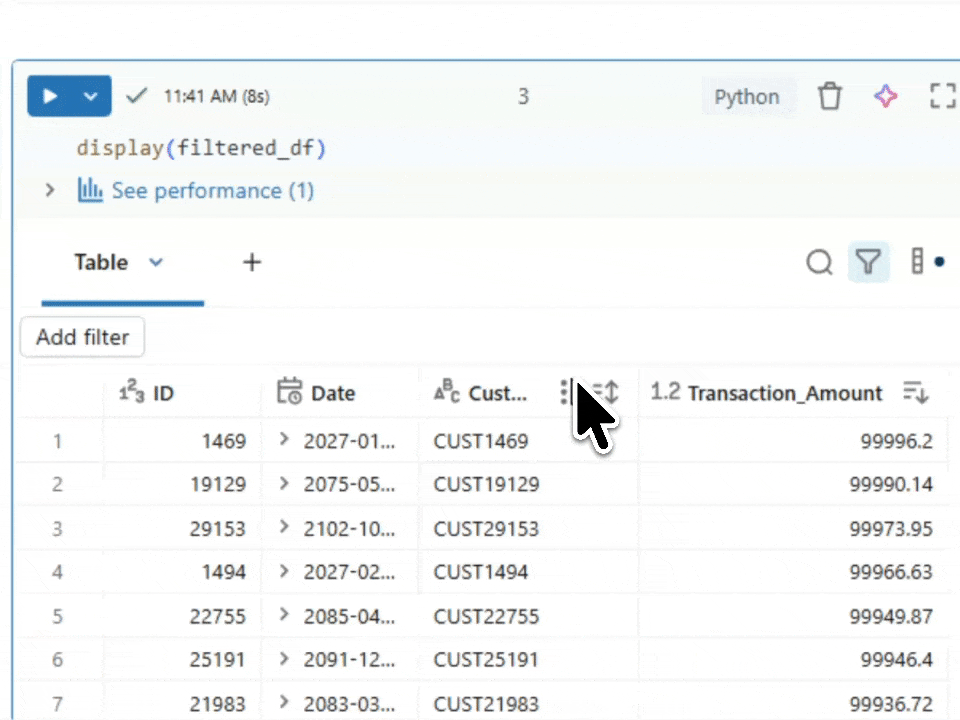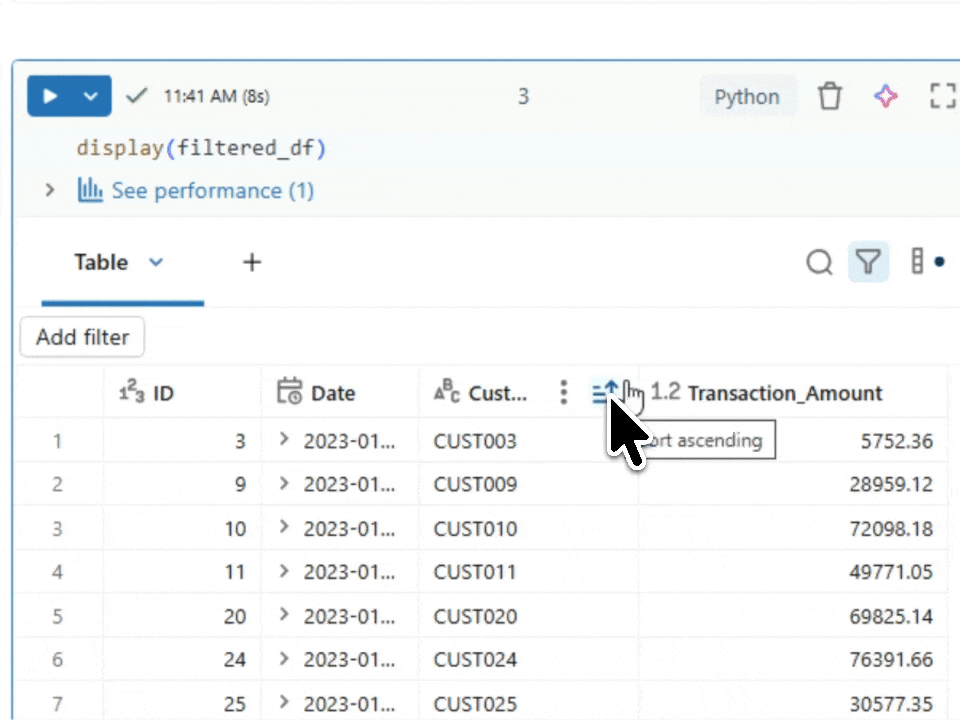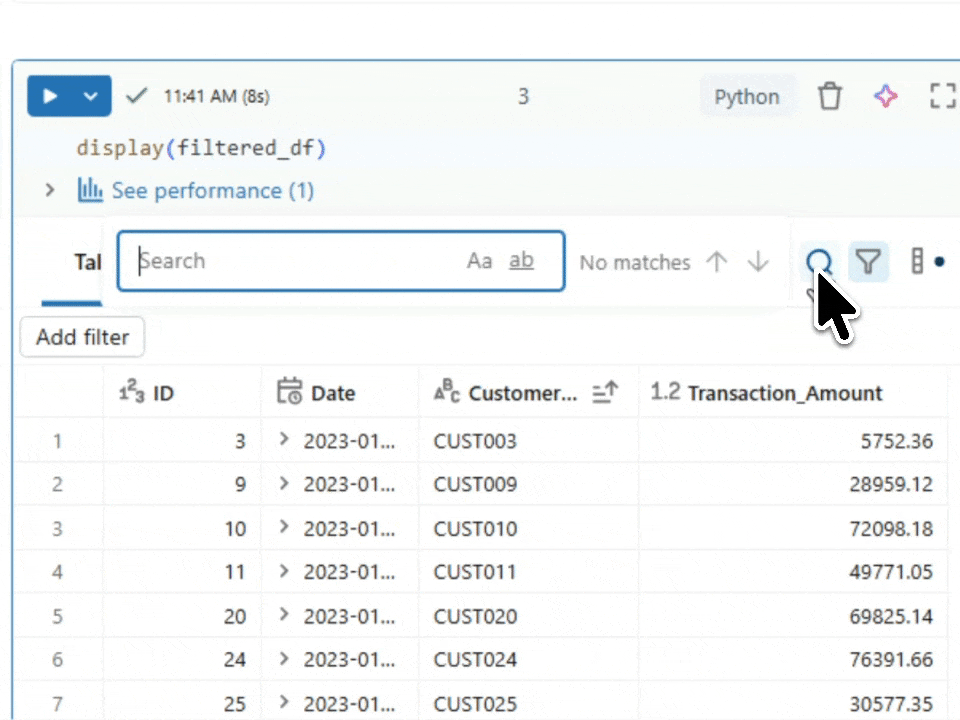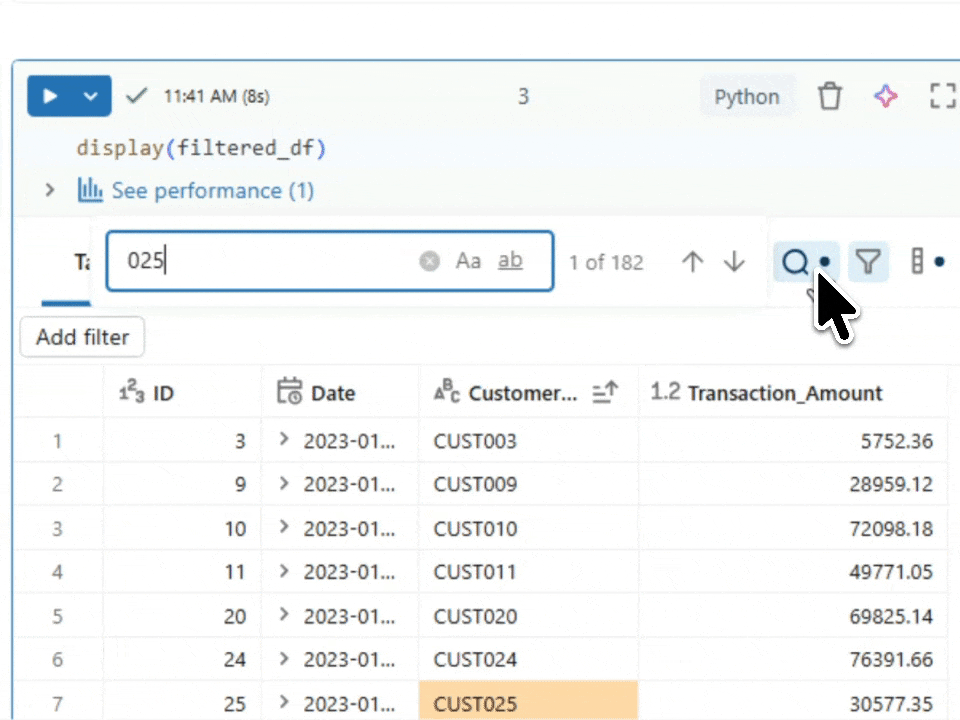
用 display() 驗證

display(filtered_df)

展示可互動表格,可排序與搜尋

$$

$$

$$

  • 排序、分頁瀏覽結果
  • 辨識 null 與離群值
在 Databricks 使用 Spark SQL 進行資料轉換

檢視查詢計畫

filtered_df.explain()
== Physical Plan ==
*(1) Filter (Transaction_Status = Completed)
+- FileScan csv [ID, Date, Customer_ID, ...]

$$

$$

  • 也可用於 SQL:EXPLAIN SELECT ...
  • 有助於排查效能問題
在 Databricks 使用 Spark SQL 進行資料轉換

閱讀 Spark 錯誤訊息

df.select("Account").show()
[UNRESOLVED_COLUMN.WITH_SUGGESTION] A column with name `Account` 
cannot be resolved. Did you mean one of the following? 
[`Date`, `Location`, `Customer_ID`, `Transaction_Amount`]
在 Databricks 使用 Spark SQL 進行資料轉換

一起來練習吧!

在 Databricks 使用 Spark SQL 進行資料轉換

Preparing Video For Download...