文件分群

Python 中的叢集分析

Shaumik Daityari

Business Analyst

文件分群:觀念

  1. 在處理前清理資料
  2. 判定文件中詞語的重要性(TF-IDF 矩陣)
  3. 對 TF-IDF 矩陣進行分群
  4. 找出每群的代表詞與文件
Python 中的叢集分析

清理與斷詞(tokenize)

  • 將文字分割為較小的 token,並清理資料以利處理
from nltk.tokenize import word_tokenize
import re

def remove_noise(text, stop_words = []):
    tokens = word_tokenize(text)

cleaned_tokens = [] for token in tokens: token = re.sub('[^A-Za-z0-9]+', '', token)
if len(token) > 1 and token.lower() not in stop_words: # Get lowercase cleaned_tokens.append(token.lower()) return cleaned_tokens
remove_noise("It is lovely weather we are having. I hope the weather continues.")
['lovely', 'weather', 'hope', 'weather', 'continues']
Python 中的叢集分析

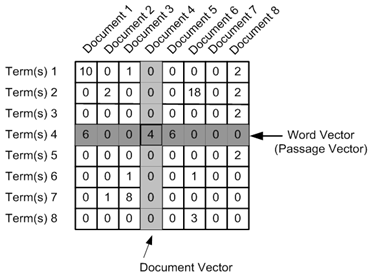
文件-詞語矩陣與稀疏矩陣

  • 建立文件-詞語矩陣
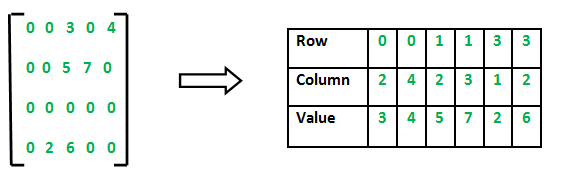
  • 矩陣中多數元素為 0

Source

  • 因此會得到稀疏矩陣

Source

Python 中的叢集分析

TF-IDF(詞頻-逆文件頻率)

  • 權重衡量:評估某字在一組文件中的重要性
from sklearn.feature_extraction.text import TfidfVectorizer

tfidf_vectorizer = TfidfVectorizer(max_df=0.8, max_features=50, min_df=0.2, tokenizer=remove_noise)
tfidf_matrix = tfidf_vectorizer.fit_transform(data)
Python 中的叢集分析

以稀疏矩陣進行分群

  • SciPy 的 kmeans() 不支援稀疏矩陣
  • 使用 .todense() 轉成一般矩陣
cluster_centers, distortion = kmeans(tfidf_matrix.todense(), num_clusters)
Python 中的叢集分析

各叢集的代表詞

  • 叢集中心:長度等於詞語數的列表
  • 叢集中心中的每個值代表其重要性
  • 建立字典並列印前幾個代表詞
terms = tfidf_vectorizer.get_feature_names_out()

for i in range(num_clusters):
    center_terms = dict(zip(terms, list(cluster_centers[i])))

sorted_terms = sorted(center_terms, key=center_terms.get, reverse=True)
print(sorted_terms[:3])
['room', 'hotel', 'staff']

['bad', 'location', 'breakfast']
Python 中的叢集分析

更多注意事項

  • 處理超連結、表情符號等
  • 正規化詞形(run、ran、running -> run)
  • .todense() 不適合超大型資料集
Python 中的叢集分析

下一步:練習!

Python 中的叢集分析

Preparing Video For Download...